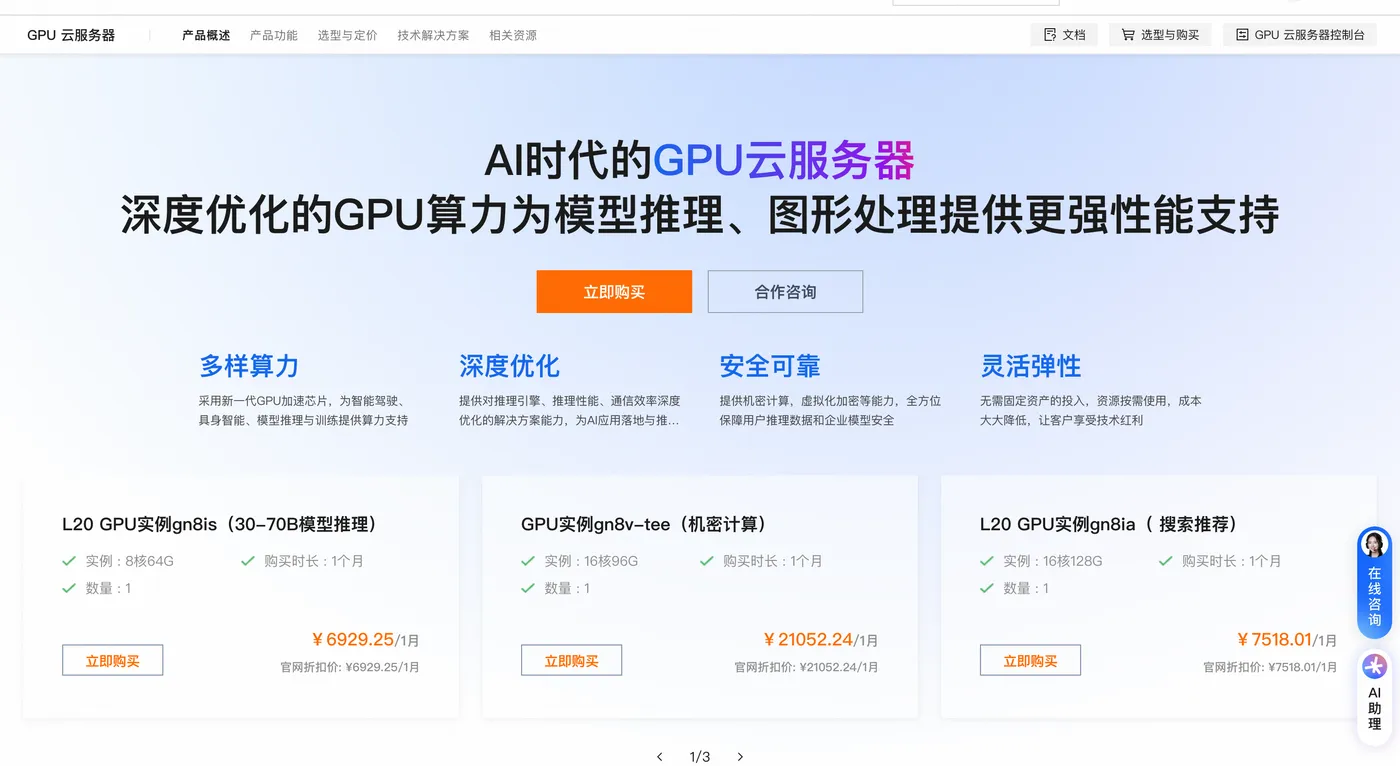
随着大模型推理、模型微调、AI视频生成、科学仿真、三维渲染等业务快速普及,普通CPU计算资源已经很难承载大规模并行浮点运算任务,GPU云服务器成为AI研发、高性能计算领域的核心基础设施。阿里云GPU云服务器依托第三代神龙计算架构,将高性能CPU与专业GPU加速硬件深度融合,实现算力资源即开即用、弹性伸缩,不需要投入高额硬件采购成本,就可以获取单卡至多卡集群的异构计算能力,覆盖从个人开发者小模型测试,到企业级千亿参数大模型训练的全场景算力需求。本文将完整梳理产品核心功能,区分不同规格族的定位差异,解析计费逻辑,附带完整的Linux实操命令,同时给出选型思路、落地建议与高频踩坑避坑要点,帮助使用者结合自身业务选择合适的GPU实例。
阿里云GPU云服务器,整体分为两大产品大类,分别是GPU计算型实例与GPU虚拟化型实例。GPU计算型实例搭载物理独享GPU硬件,整张显卡资源完全交付实例使用,显存、算力全部独占,不存在资源切分,适合大模型训练、大规模微调、高并发离线推理、科学计算等高算力消耗业务;GPU虚拟化型实例通过虚拟化技术将一张物理GPU切分为多份虚拟算力单元,多个业务共享同一张物理显卡,单实例可以获取部分显存与算力,大幅降低算力入门成本,适合轻量模型推理、AI演示Demo、云工作站、3D可视化、小型图像视频处理场景。两大类型下面划分数十套规格族,不同规格族支持的GPU芯片、CPU配比、内存大小、内网带宽、RDMA互联能力差异巨大,规格选错很容易出现显存不足、CPU内存配比失衡、网络瓶颈,造成算力浪费或者业务运行报错。
底层神龙架构是整套阿里云GPU云服务器,GPU实例的基础底座,通过芯片级硬件加速,把虚拟化带来的性能损耗压缩到极低水平,磁盘IO、网络转发性能大幅提升,加载大模型权重文件、读取海量数据集的时候读写延迟显著降低。多卡机型支持NVLINK高速互联,实例内部多张GPU之间数据传输不需要经过CPU内存中转,卡间通信带宽得到保障,在分布式训练场景能够有效减少通信等待开销。部分高端实例还支持RDMA远程直接内存访问,多台GPU服务器组成集群的时候,节点之间可以实现超高带宽数据交互,支撑大规模多机分布式训练任务,满足企业大模型研发的集群算力诉求。
网络层面,阿里云GPU云服务器,GPU实例全部运行在VPC私有网络环境,支持多弹性网卡配置,内网转发性能最高可达数千万PPS,内网带宽根据实例规格自动匹配,高规格多卡实例可以获得上百Gbit/s的内网带宽。公网带宽支持按固定带宽、按流量计费两种模式,对于数据集下载、模型权重拉取的业务,建议评估公网流量消耗,避免产生额外流量账单。实例可以无缝对接云上配套产品,NAS文件存储用来存放训练数据集与模型权重,ESSD高性能云盘保障高速随机读写,对象存储用来存放业务产出结果,完整的云产品生态可以快速搭建完整AI工作流,不需要自行搭建复杂存储系统。安全层面支持安全组访问管控,密钥登录,部分实例机型提供机密计算能力,对模型参数、训练数据做硬件层面加密保护,保障企业私有模型资产安全。
镜像生态方面,官方提供专门适配GPU的公共镜像,镜像内部预装好CUDA、cuDNN驱动组件,实例创建完成之后无需手动编译安装显卡驱动,开机即可直接调用GPU硬件,极大降低环境搭建门槛。同时支持自定义镜像,调试完成的AI运行环境可以制作镜像,后续批量创建GPU实例直接复用整套环境,适合集群部署、多实例复制场景。除了Linux系统镜像之外,也提供Windows GPU镜像,面向三维设计渲染、专业图形工作站业务,镜像内置vWS虚拟工作站授权,主流CAD、三维建模软件可以直接调用GPU图形加速能力,不需要额外购买软件许可。
配套工具套件是GPU实例的一大优势,平台提供cGPU算力隔离组件,可以在单张物理GPU内部实现显存、算力的细粒度切分,在容器环境下,不同任务之间显存资源互相隔离,避免某一个任务耗尽显存导致其他业务崩溃,非常适合推理服务多任务混部场景。FastGPU工具套件简化分布式训练部署流程,降低多机多卡训练的运维难度;AIACC推理加速引擎针对大模型推理做深度优化,在不修改模型代码的前提下,提升推理吞吐,降低单请求响应延迟,减少算力资源消耗,帮助企业降低线上推理服务成本。
接下来梳理规格族的业务定位,GPU计算型gn系列为物理独享显卡机型,gn8v系列面向千亿参数大模型推理、中小规模模型训练,支持1卡、2卡、4卡、8卡多种配置,显卡具备大容量显存,支持FP8高精度浮点运算,适配Qwen系列、DeepSeek系列大模型的本地部署;gn7i系列综合性价比突出,适合中等规模模型微调、离线数据处理;gn9gc属于超高规格机型,面向超大规模集群训练,单实例最多搭载8张高性能GPU,搭配超大CPU与内存配比,主要服务企业级AI研发项目。
GPU虚拟化vgn、sgn系列,代表机型vgn7i‑vws、sgn8ia,将物理显卡切分成多个虚拟GPU,单实例可以获取部分显存算力,硬件成本更低,适合个人开发者跑模型Demo、轻量API推理、云端图形工作站、视频转码业务。需要注意虚拟化机型存在算力上限,不适合大规模模型训练,只适合推理、演示类轻量任务,显存被切分,无法和物理卡实例同等对待,选型阶段需要区分清楚两类机型的差异,避免业务跑起来之后显存不足。
计费模式上 阿里云GPU云服务器 支持多种计费策略,分别适配不同使用周期的业务需求。包年包月属于预付费模式,适合7×24小时持续运行的线上推理服务、长期模型训练任务,购买周期越长,单位算力单价越低,适合项目周期明确的企业业务。按量付费按小时结算,先使用后扣费,适合临时测试、调参实验,任务跑完直接释放实例,不需要长期占用算力资源,减少闲置成本。抢占式实例拥有可观的价格折扣,但是算力资源存在被系统回收的风险,实例会被强制关机,适合可以随时中断重新执行的实验任务,线上生产业务不建议直接使用抢占式实例,防止业务中断。除此之外还可以搭配节省计划、预留实例券进一步降低长期使用的算力成本,实例费用主要包含vCPU、内存、GPU硬件资源,云盘、公网带宽会单独计费,不同地域相同规格的实例价格存在差异,最终价格以购买控制台页面为准。
很多新手拿到 阿里云GPU云服务器 实例之后,第一步需要确认显卡驱动是否正常识别,下面给出Linux系统下常用实操命令,方便开发者排查硬件状态、监控显存占用、调试AI业务。
登录GPU实例之后,首先执行nvidia‑smi查看显卡硬件信息、驱动版本、显存占用、GPU利用率,这是最基础的排查命令:
nvidia-smi
输出内容可以看到GPU卡号、显存总大小、已使用显存、GPU使用率,当运行大模型出现OOM显存溢出报错,优先通过这条命令确认显存占用情况。
持续实时监控GPU状态,每秒刷新一次输出,方便观察任务运行时显存变化:
watch -n 1 nvidia-smi
查看CUDA版本,确认环境是否匹配模型依赖:
nvcc -V
查看系统CPU内存整体资源,确认CPU、内存是否成为业务瓶颈:
free -h
top
查看磁盘空间,大模型权重文件体积巨大,需要确认云盘剩余空间足够存放模型:
df -h
如果使用cGPU组件做显存隔离,可以查看容器内部显存使用信息:
cat /proc/cgpu_km/0/meminfo
在多GPU环境下,可以通过环境变量指定程序使用某一张显卡,避免程序占用全部显卡资源:
export CUDA_VISIBLE_DEVICES=0
python model_infer.py
通过阿里云SDK可以用代码完成实例生命周期管理,下面Python示例,调用ECS API查询当前地域全部GPU类型实例规格,方便做自动化选型脚本,需要提前配置好AccessKey密钥:
from alibabacloud_ecs20140526.client import Client
from alibabacloud_tea_openapi import models as open_api_models

config = open_api_models.Config()
config.access_key_id = "你的AccessKeyID"
config.access_key_secret = "你的AccessKeySecret"
config.endpoint = 'ecs.cn‑hangzhou.aliyuncs.com'
client = Client(config)

resp = client.describe_instance_types({

    "InstanceCategory": "Compute‑optimized with GPU",
    "MinimumGPUAmount": 1
})
for item in resp.body.InstanceTypes.InstanceType:
    print(f"规格名称:{item.InstanceTypeId},GPU数量:{item.GPUAmount},GPU型号:{item.GPUSpec}")
很多使用者会困惑业务到底该选择物理GPU计算型,还是虚拟化GPU实例。如果业务是大模型微调、完整参数训练、高吞吐线上推理,必须选择gn系列物理独享GPU机型,完整显存和算力保障业务稳定运行;如果仅仅是跑Demo、简单测试、轻量并发推理,预算有限,虚拟化vgn/sgn系列可以大幅降低入门成本。同时还要关注CPU内存配比,很多人只关注GPU显存,忽略CPU内存,加载大模型、处理数据集过程会消耗大量主机内存,内存不足会直接导致程序被系统OOM Killer杀掉,一般建议主机内存至少为GPU总显存的1.5倍以上,处理海量数据集的业务,内存配比还需要进一步拉高。存储方面,大模型权重文件体积动辄几十GB到上百GB,务必配置足够容量的ESSD云盘,数据集规模巨大的场景,直接挂载NAS存储,实现多实例共享数据集文件。
接下来整理 阿里云GPU云服务器 实例高频踩坑避坑指南。第一,虚拟化实例显存是切分后的虚拟显存,不等于物理显卡完整显存,不要拿虚拟化机型跑大模型训练任务,会直接显存溢出报错。第二,务必选择GPU适配的公共镜像,如果使用普通自定义镜像,需要手动安装CUDA、显卡驱动,版本不匹配会出现显卡识别失败,业务无法调用GPU。第三,抢占式实例资源随时可能被回收,生产业务不要直接使用,仅用于非核心实验任务。第四,关注主机内存大小,很多AI任务失败并不是GPU显存不足,而是主机内存耗尽,进程被系统终止。第五,多卡分布式训练业务,优先选择支持NVLINK、RDMA的规格,否则卡间通信会成为性能瓶颈,训练速度大幅下降。第六,实例释放之后,本地磁盘数据全部丢失,模型权重、数据集建议存放NAS或者对象存储,不要只保存在实例本地磁盘。第七,公网下载大体积模型、数据集,会产生大量公网出网流量,预估流量开销,避免产生意料之外的账单。第八,GPU实例硬件资源特殊,部分地域机型库存紧张,如果控制台找不到目标规格,需要更换其他地域或者咨询确认库存情况。
常见问题汇总,nvidia‑smi命令执行报错,找不到显卡设备,优先确认镜像是否为GPU专用镜像,驱动是否正确安装;模型运行报OOM显存溢出,要么降低模型加载参数,切换更小参数量模型,要么更换显存更大的实例;训练速度很慢,需要分别排查GPU利用率、CPU内存、磁盘IO、内网通信,确认瓶颈所在;多卡任务只有单张显卡在工作,检查代码是否正确启用多卡分布式训练逻辑,确认CUDA_VISIBLE_DEVICES环境变量配置。
综合来看, 阿里云GPU云服务器 覆盖从轻量化测试到大规模集群训练的完整算力需求,把高门槛的异构计算资源变成可以按需取用的云上服务,省去硬件采购、机房运维、硬件故障维护的大量成本。对于个人开发者,可以使用虚拟化机型低成本上手AI模型部署;中小企业可以选择物理GPU实例搭建推理服务、开展模型微调;大型企业可以使用多卡集群机型完成大模型完整训练。选型的时候不要只看显卡型号,CPU内存配比、存储能力、网络能力同样会直接影响业务最终效果,结合业务场景选择计费方式,做好数据持久化,规避各类使用陷阱,就可以充分发挥GPU算力的价值。