
别再把 K8s 当“万能盒子”:CockroachDB、Vitess、Cassandra 到底怎么跑?
作者:Echo_Wish
很多人第一次在 Kubernetes 上部署数据库,脑子里想的都是一句话:
“数据库嘛,写个 Deployment,挂个 PVC,不就完事了?”如果只是跑个 MySQL 测试环境,这么干问题可能不大。
但当你面对 CockroachDB、Vitess、Cassandra 这种分布式数据库时,事情就完全不一样了。
因为这时候真正的问题已经不是:
“怎么把数据库跑起来?”
而是:
“Kubernetes 到底能不能把数据库跑稳?”
这篇文章就不绕弯子,我们直接拿 CockroachDB、Vitess、Cassandra 三个典型选手,看看它们在 K8s 上到底应该怎么玩。
一、先说一个很多人容易踩的坑
Kubernetes 很擅长管理:
- Pod
- Service
- Deployment
- StatefulSet
- ConfigMap
- Secret
- PVC
- 自动重启
- 服务发现
但 Kubernetes 并不懂数据库业务。
比如:
Pod 挂了
   ↓
K8s
   ↓
重新创建 Pod
   ↓
数据库恢复了吗?
K8s 的答案是:
“Pod 活了,我任务完成了。”
但数据库真正关心的是:
节点是否加入集群?
数据副本是否完整?
Leader 是否正常?
数据是否同步?
磁盘是否损坏?
节点是否应该重新加入?
集群是否满足 quorum?
所以我一直比较认同一个观点:
K8s 负责“容器活着”,数据库负责“数据活着”。
这两个概念千万不要混在一起。
二、为什么分布式数据库特别适合 StatefulSet?
如果你用过 Deployment,会发现它特别喜欢:
Pod A
Pod B
Pod C
哪个 Pod 死了,随便再拉一个。
但是数据库通常不是这么玩的。
例如 Cassandra:
cassandra-0
cassandra-1
cassandra-2
它们不是三个完全一样的无状态 Pod。
它们都有自己的数据。
所以我们通常使用:
kind: StatefulSet
而不是:
kind: Deployment
StatefulSet 最大的价值之一,就是给数据库提供稳定身份。
比如:
cassandra-0
cassandra-1
cassandra-2
即使:
cassandra-1
重启,它回来以后依然叫:
cassandra-1
同时还能绑定自己的:
PVC
于是就形成:
cassandra-0
   ↓
PVC-0

cassandra-1
   ↓
PVC-1

cassandra-2
   ↓
PVC-2
这才符合数据库的基本逻辑。
三、第一位选手:CockroachDB
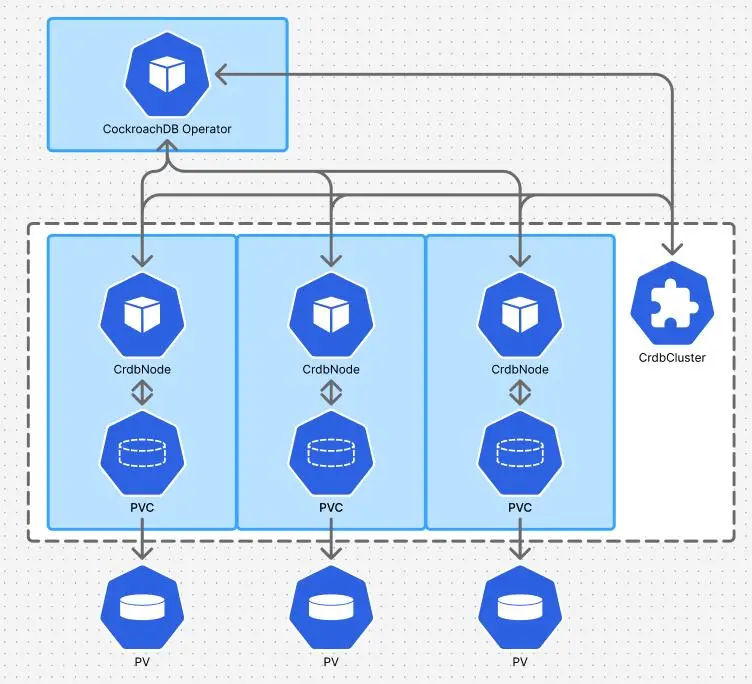
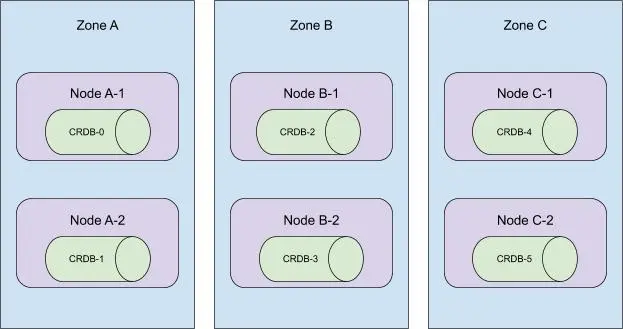
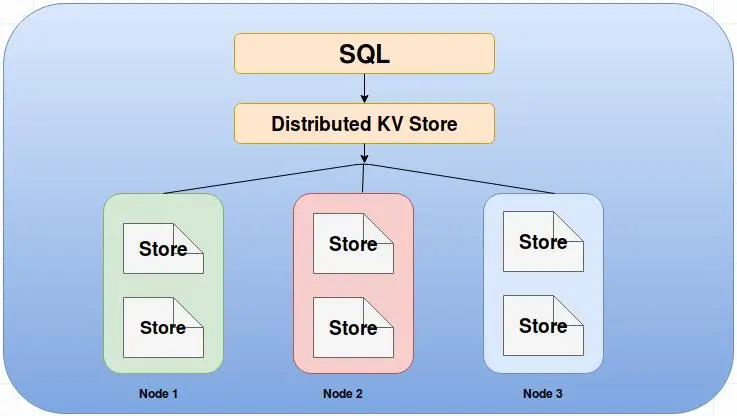
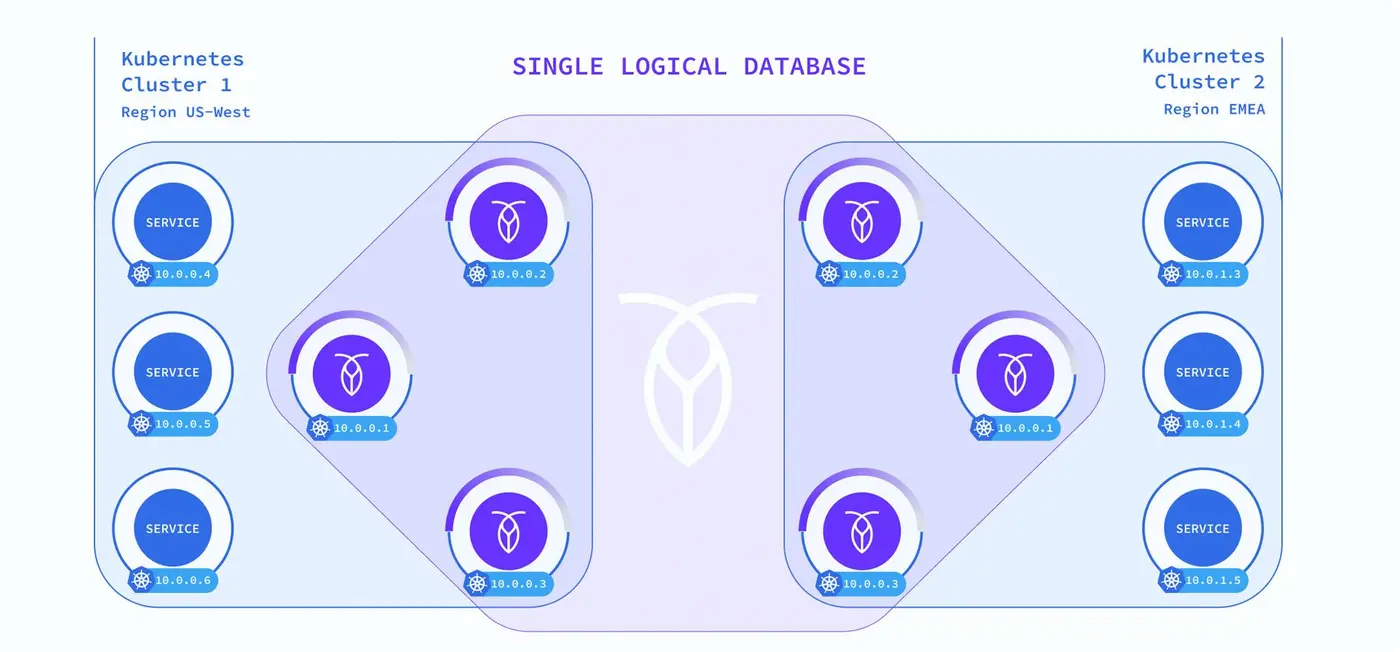
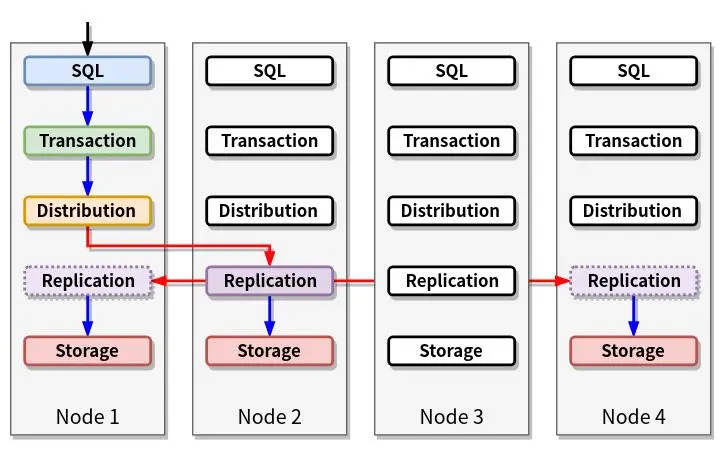
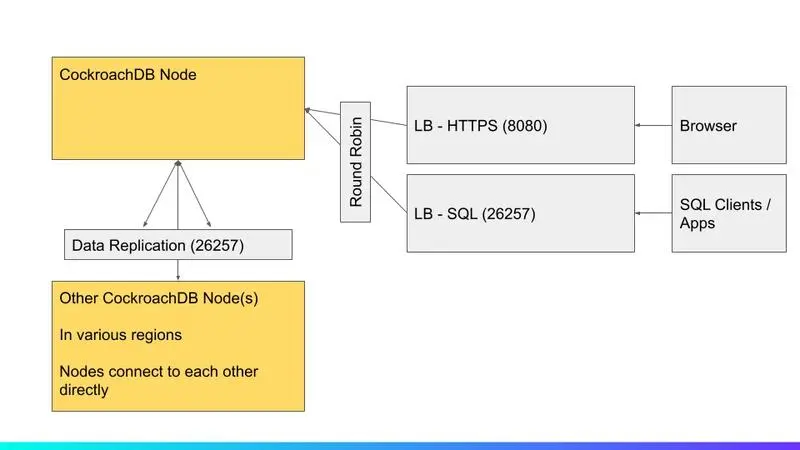
CockroachDB 的定位非常有意思。
你可以简单理解成:
“看起来像 PostgreSQL,骨子里是分布式数据库。”
它对开发人员比较友好,因为使用 SQL:
CREATE DATABASE shop;

CREATE TABLE orders (
    id UUID PRIMARY KEY,
    user_id UUID,
    amount DECIMAL
);
但是数据库内部已经不是传统单机数据库那套玩法了。
数据会被拆成多个 Range,然后通过 Raft 进行副本同步。
例如:
                CockroachDB
                     |
        +------------+------------+
        |            |            |
      Node1        Node2        Node3
        |            |            |
      Range A      Range A      Range A
      Range B      Range B      Range B
一个节点挂了:
Node1 ❌
只要副本数量和 quorum 仍然满足:
Node2 ✅
Node3 ✅
整个数据库依然可以继续工作。
四、CockroachDB 在 K8s 怎么部署?
最简单的实验环境可以直接使用 StatefulSet。
例如:
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: cockroachdb
spec:
  serviceName: cockroachdb
  replicas: 3
  selector:
    matchLabels:
      app: cockroachdb

  template:
    metadata:
      labels:
        app: cockroachdb

    spec:
      containers:
        - name: cockroachdb
          image: cockroachdb/cockroach:v25.2.0

          command:
            - "/cockroach/cockroach"

          args:
            - "start"
            - "--insecure"
            - "--join=cockroachdb-0.cockroachdb,cockroachdb-1.cockroachdb,cockroachdb-2.cockroachdb"
            - "--advertise-addr=$(POD_NAME)"

          env:
            - name: POD_NAME
              valueFrom:
                fieldRef:
                  fieldPath: metadata.name

          ports:
            - containerPort: 26257
            - containerPort: 8080

          volumeMounts:
            - name: data
              mountPath: /cockroach/cockroach-data

  volumeClaimTemplates:
    - metadata:
        name: data
      spec:
        accessModes:
          - ReadWriteOnce
        resources:
          requests:
            storage: 100Gi
然后:
kubectl apply -f cockroachdb.yaml
检查:
kubectl get pods
应该能看到:
cockroachdb-0
cockroachdb-1
cockroachdb-2
进入 Pod:
kubectl exec -it cockroachdb-0 -- ./cockroach sql --insecure
然后:
SHOW DATABASES;
就可以开始干活了。
五、但是,生产环境千万别直接照抄
上面的:
--insecure
只是为了方便演示。
生产环境你应该考虑:
TLS
RBAC
Secret
NetworkPolicy
备份
监控
资源限制
PodDisruptionBudget
TopologySpreadConstraints
尤其是:
TopologySpreadConstraints
这个东西非常重要。
你不能出现:
Node-A
 ├── cockroach-0
 ├── cockroach-1
 └── cockroach-2
然后 Node-A:
宕机
三个数据库一起没了。
真正合理的是:
K8s Node-A
 └── cockroach-0

K8s Node-B
 └── cockroach-1

K8s Node-C
 └── cockroach-2
分布式数据库最大的敌人,不是 Pod 挂掉,而是你把所有副本放到了同一个故障域。
六、第二位选手:Vitess
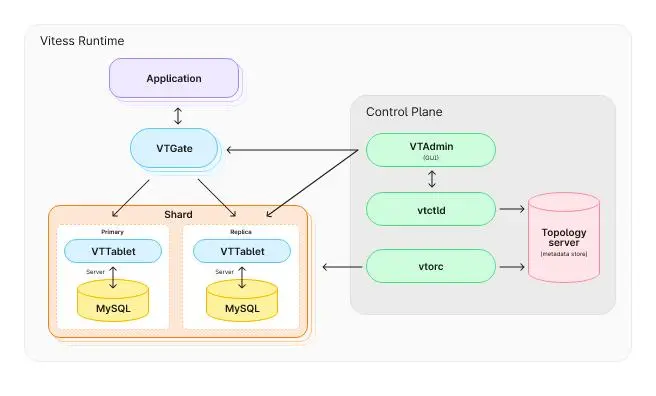
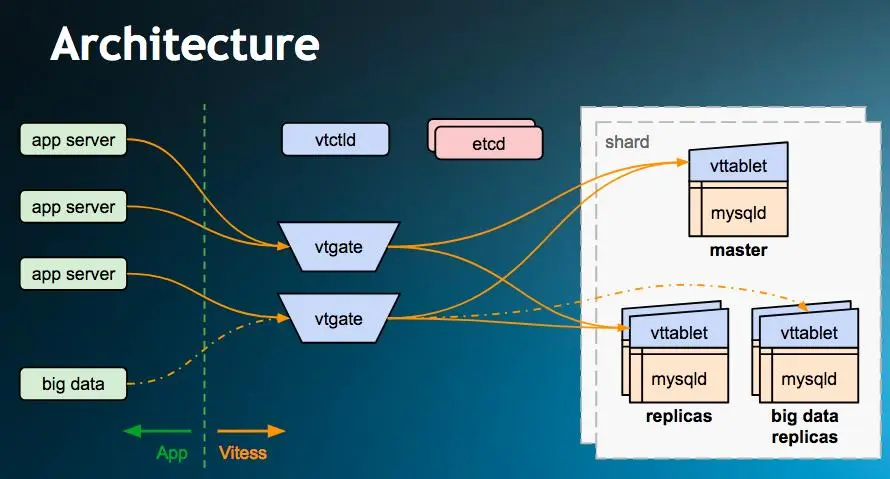
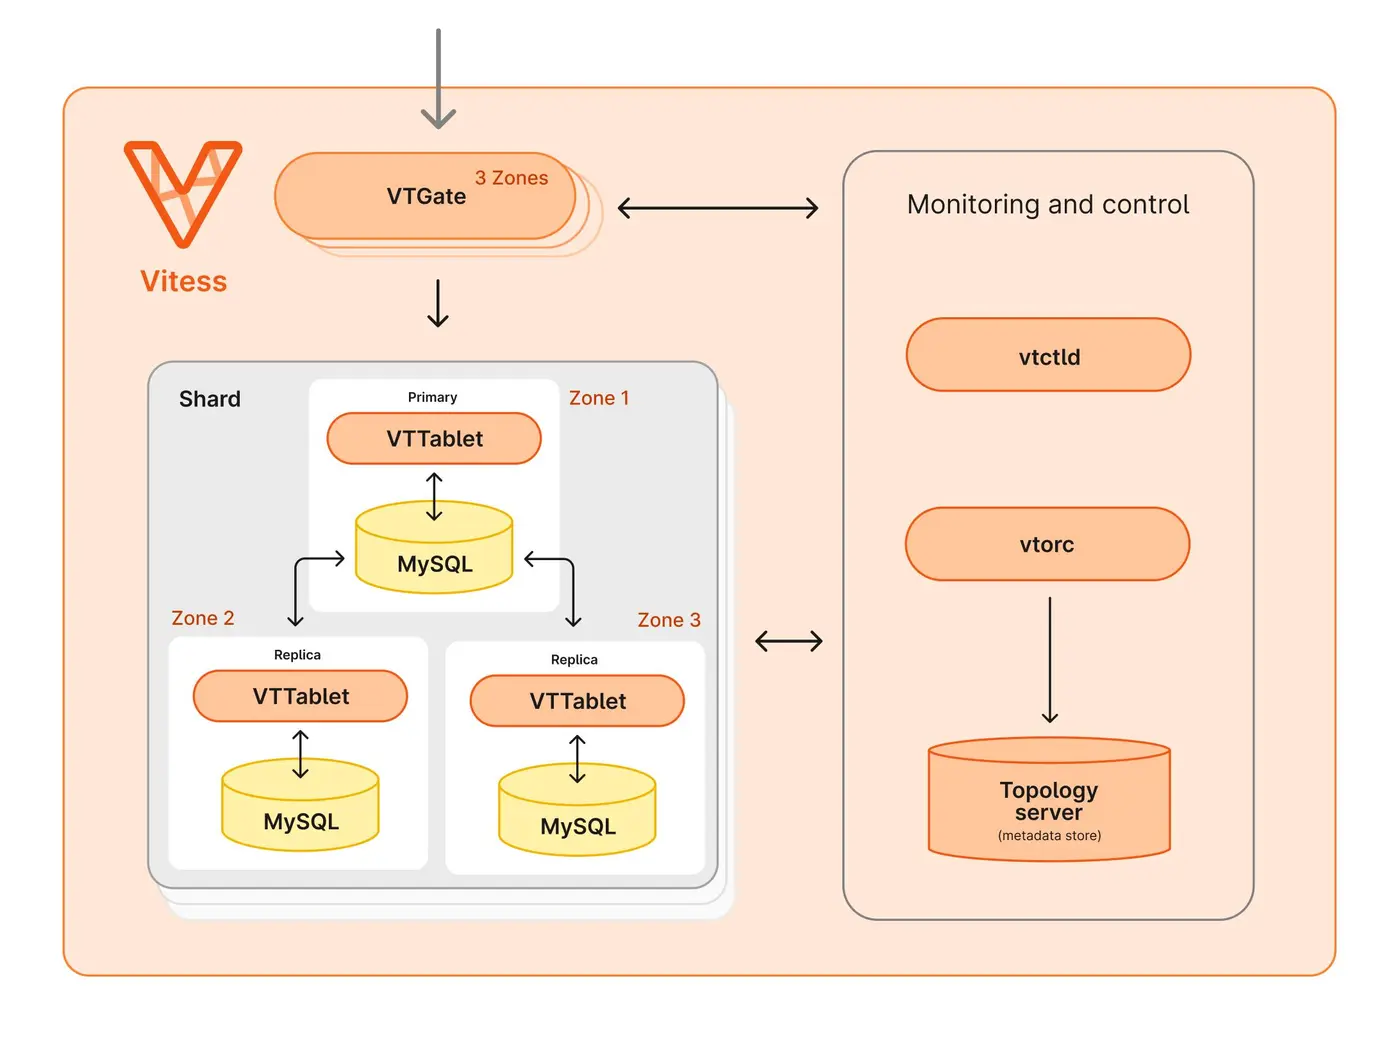
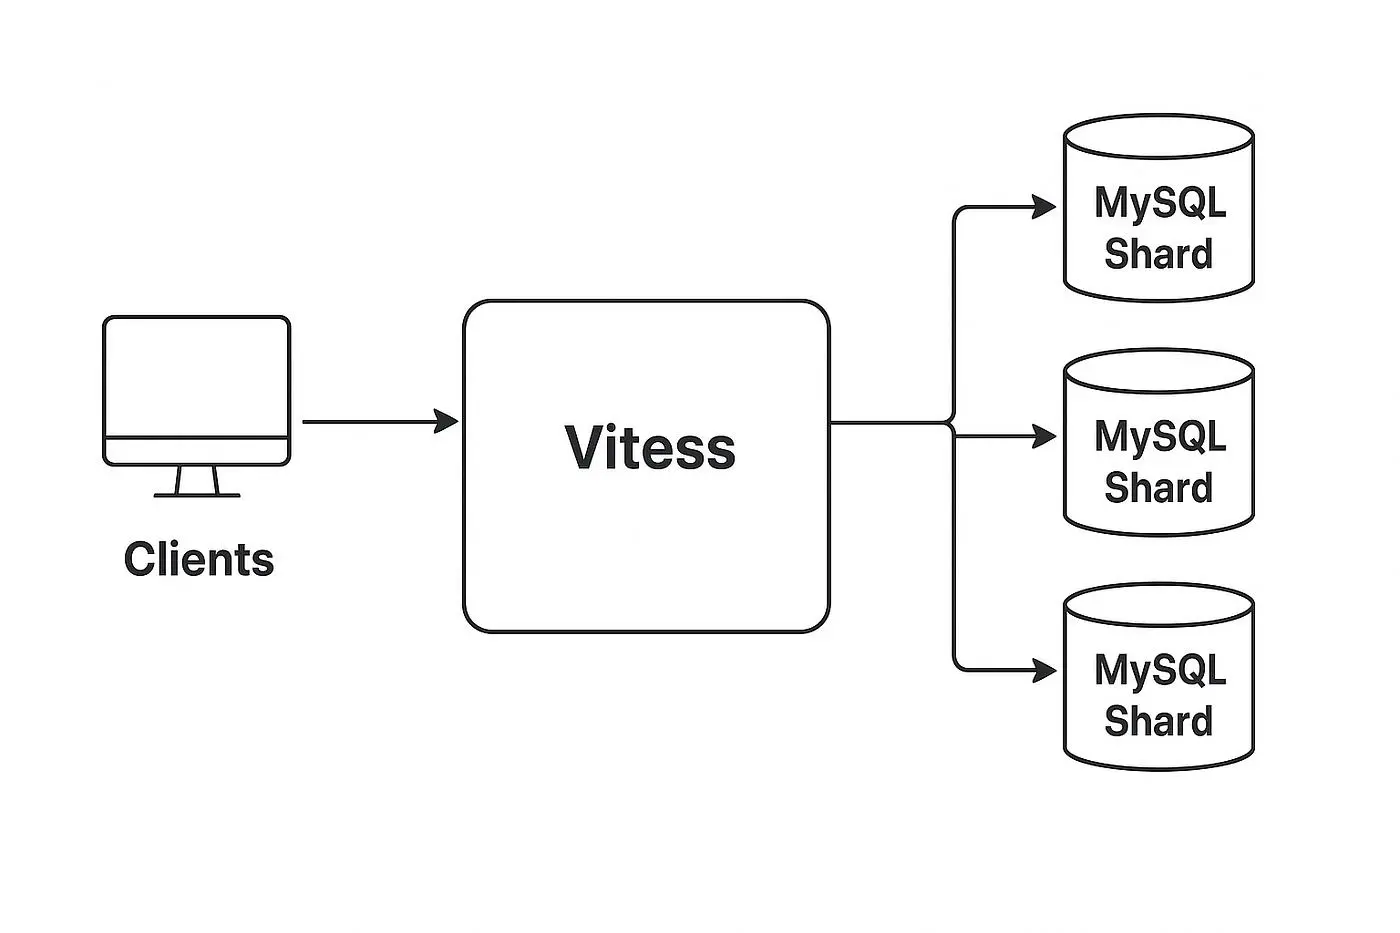
Vitess 和 CockroachDB 完全不是一路人。
如果说:
CockroachDB 是“重新设计了一套分布式数据库”。
那么:
Vitess 更像是“把 MySQL 改造成能够横向扩展的数据库平台”。
这也是 Vitess 特别有意思的地方。
假设你有一个巨大的 MySQL:
MySQL
  |
  +-- 10TB 数据
  +-- 100000 QPS
  +-- CPU 爆炸
怎么办?
Vitess 可以把数据库拆成:
                 Vitess
                    |
          +---------+---------+
          |         |         |
       shard-0   shard-1   shard-2
          |         |         |
        MySQL     MySQL     MySQL
例如:
user_id % 3
决定数据去哪。
user_id = 100
100 % 3 = 1
进入:
shard-1
这样就实现水平扩展。
七、Vitess 的核心不是 MySQL,而是“中间层”
Vitess 里面有几个特别重要的组件。
可以简单理解:
Application
     |
     v
   VTGate
     |
     +---------+
     |         |
  VTTablet  VTTablet
     |         |
   MySQL      MySQL
应用程序通常不直接访问 MySQL。
而是:
Application
     ↓
VTGate
     ↓
Shard
     ↓
MySQL
VTGate 会帮助你:
- 路由 SQL
- 找 Shard
- 连接池管理
- 故障切换
- 读写路由
所以应用侧甚至可以继续使用:
MySQL Driver
而不用把整个业务推翻重写。
这就是 Vitess 最大的吸引力。
八、Vitess 在 K8s 中尤其适合 Operator
如果自己手写 Vitess 的 StatefulSet,你很快就会发现:
“这玩意儿怎么这么多组件?”
所以生产环境更推荐使用 Vitess Operator 或官方生态提供的 Kubernetes 管理方式。
你最终管理的不是简单的:
Deployment
而更像是:
VitessCluster
然后由 Operator 帮你处理:
VTGate
VTTablet
MySQL
Topology
Backup
Failover
这就是 Kubernetes Operator 真正有价值的地方:
把数据库专家的运维经验,写成 Kubernetes Controller。
九、第三位选手:Cassandra
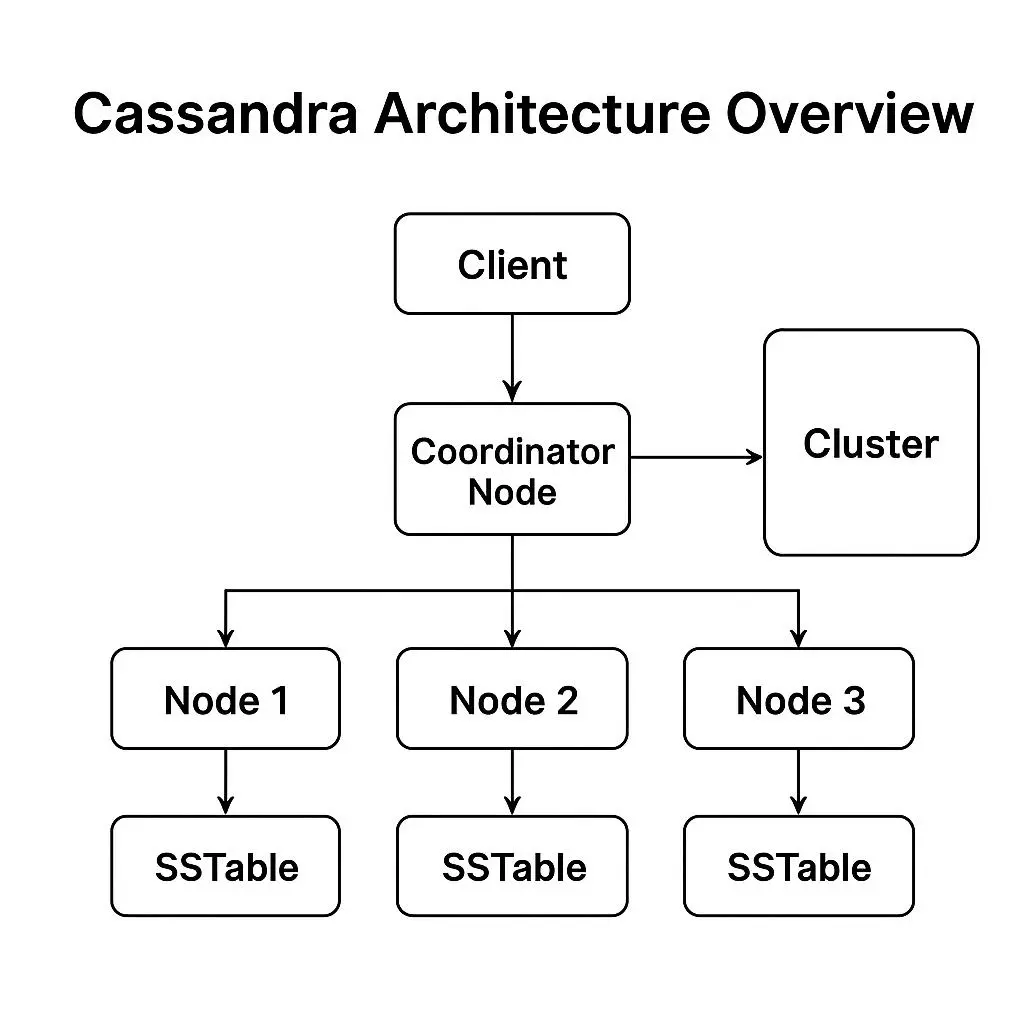
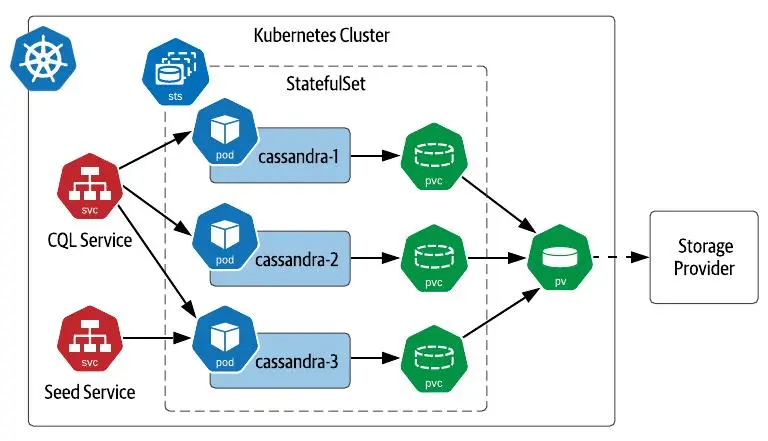
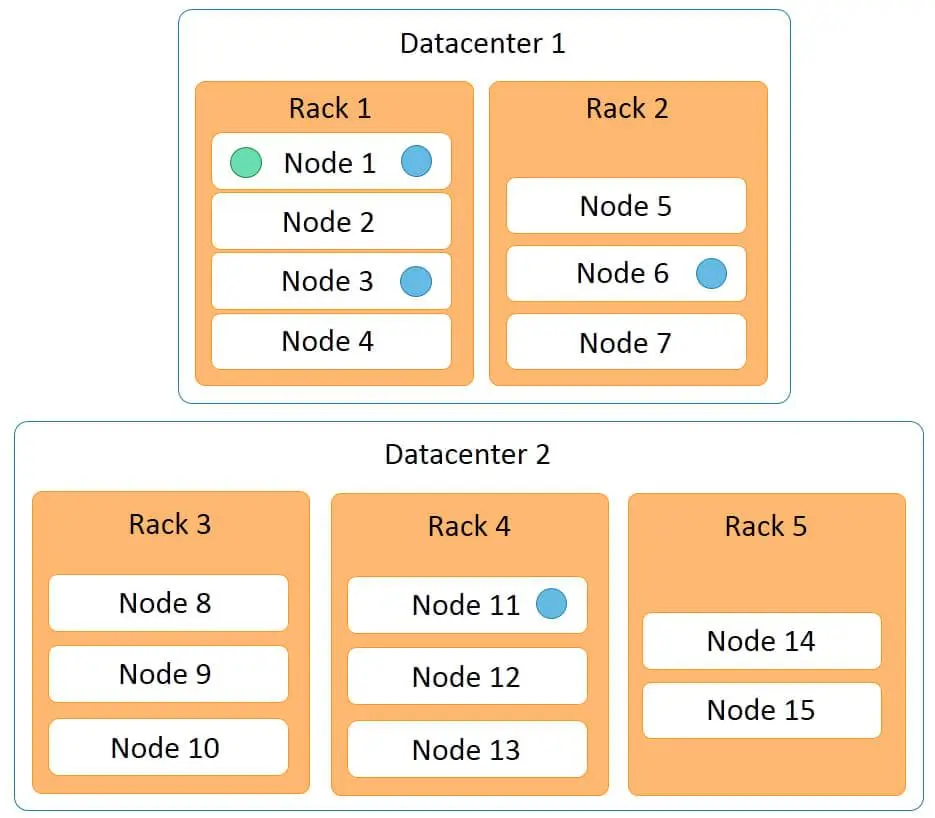
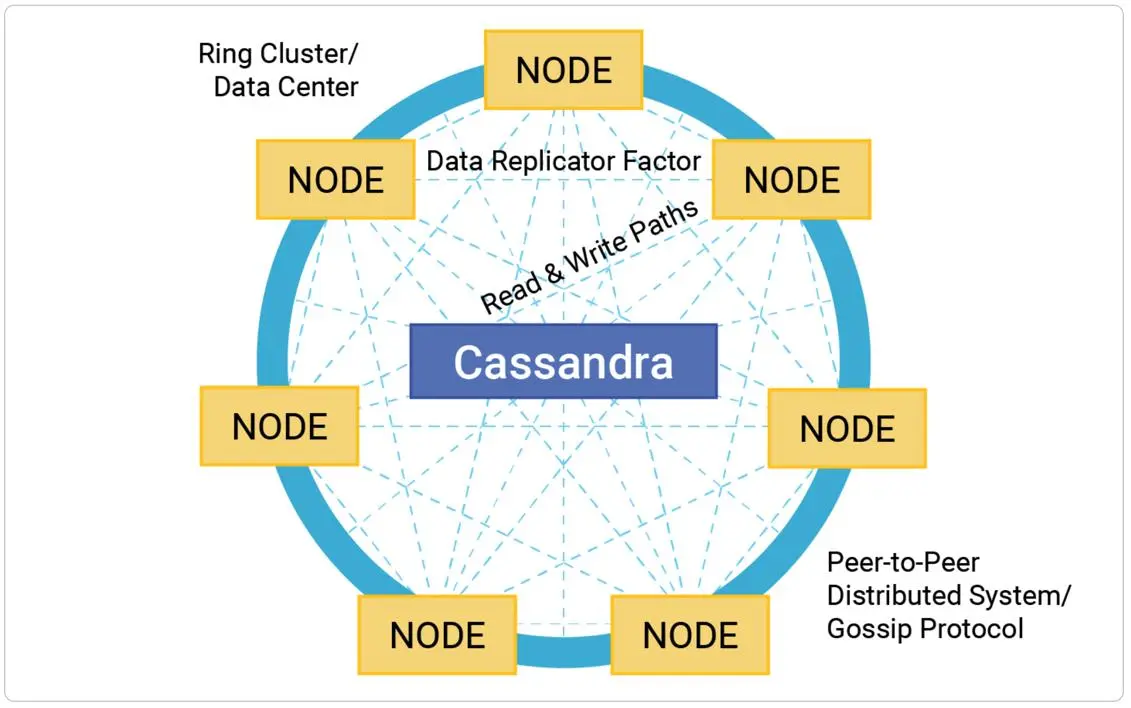
Cassandra 又是另一种思路。
它特别适合:
海量数据
高写入
高并发
多节点
多数据中心
例如:
IoT
日志
用户行为
时序数据
推荐系统
Cassandra 的核心特点之一就是:
没有传统意义上的单一 Master。
你可以把它理解成:
Node1 ←→ Node2
 ↑        ↓
 ↓        ↑
Node3 ←→ Node4
节点之间共同维护集群状态。
所以它非常适合横向扩展。
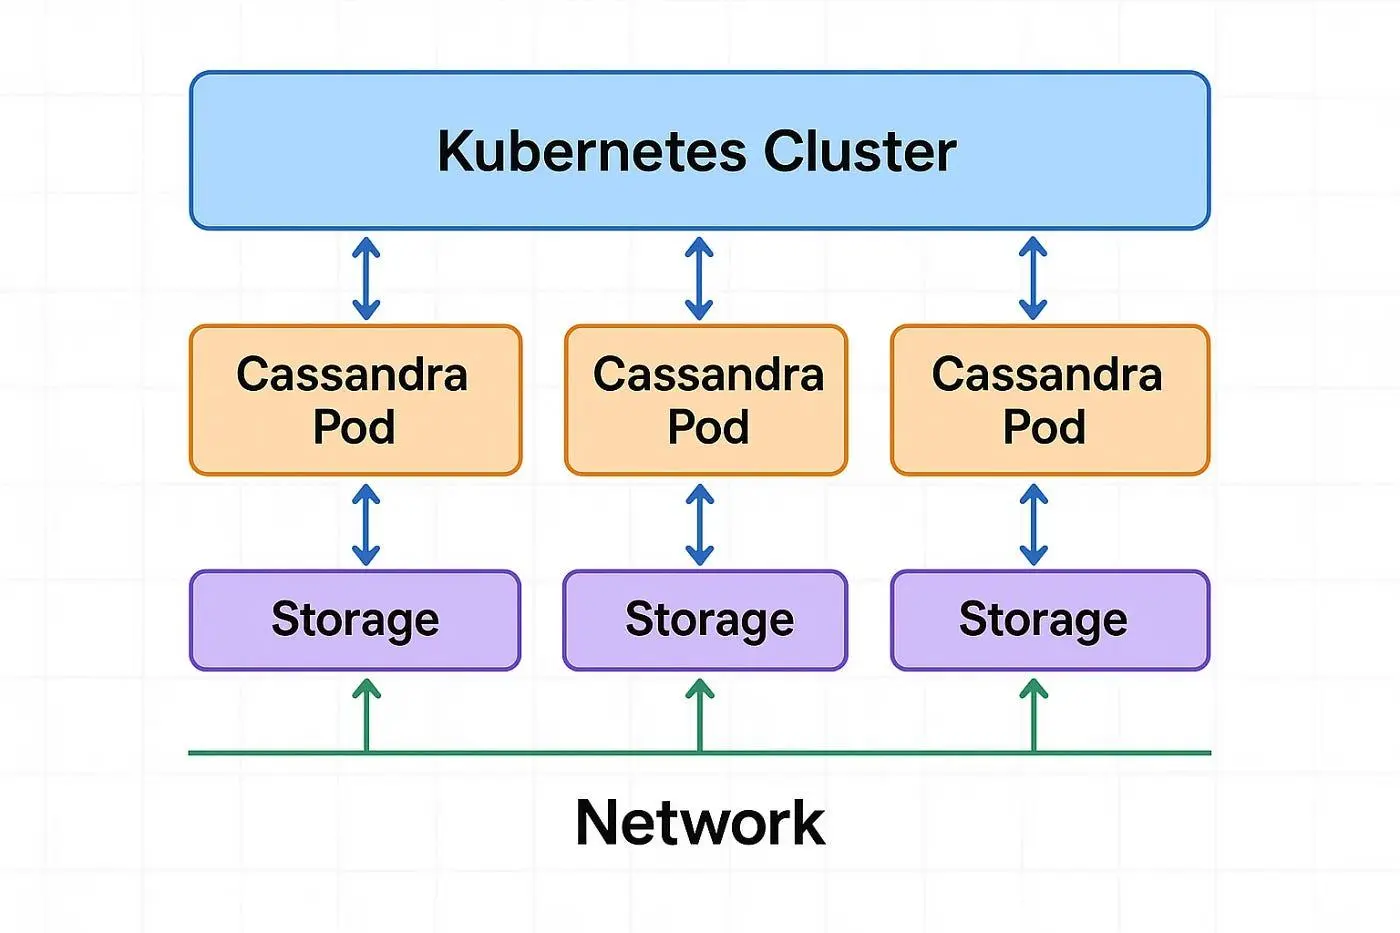
十、Cassandra 为什么特别适合 StatefulSet?
因为 Cassandra 非常依赖节点身份和数据目录。
典型结构:
cassandra-0
cassandra-1
cassandra-2
cassandra-3
每个节点:
Pod
 ↓
PVC
 ↓
SSTable
例如:
apiVersion: apps/v1
kind: StatefulSet
metadata:
  name: cassandra
spec:
  serviceName: cassandra
  replicas: 3

  selector:
    matchLabels:
      app: cassandra

  template:
    metadata:
      labels:
        app: cassandra

    spec:
      containers:
        - name: cassandra
          image: cassandra:5.0

          ports:
            - containerPort: 9042

          env:
            - name: CASSANDRA_CLUSTER_NAME
              value: "prod-cluster"

            - name: CASSANDRA_DC
              value: "dc1"

          volumeMounts:
            - name: data
              mountPath: /var/lib/cassandra

  volumeClaimTemplates:
    - metadata:
        name: data
      spec:
        accessModes:
          - ReadWriteOnce

        resources:
          requests:
            storage: 200Gi
部署:
kubectl apply -f cassandra.yaml
查看:
kubectl get pods -l app=cassandra
进入节点:
kubectl exec -it cassandra-0 -- cqlsh
查看集群:
nodetool status
你会看到类似:
Datacenter: dc1

Status=Up/Down
State=Normal/Leaving/Joining

UN  cassandra-0
UN  cassandra-1
UN  cassandra-2
十一、三个数据库到底有什么区别?
如果把它们放在一张桌子上:
| 数据库 | 核心定位 | 适合场景 |
|---|---|---|
| CockroachDB | 分布式 SQL | 金融、交易、SaaS |
| Vitess | MySQL 扩展平台 | 大型互联网业务 |
| Cassandra | 分布式 NoSQL | 海量写入、IoT、日志 |
更直白一点:
想要 SQL + 分布式?
考虑:
CockroachDB
已经有大量 MySQL?
考虑:
Vitess
数据量巨大、写入量恐怖?
考虑:
Cassandra
十二、真正生产环境,别只盯着 Pod
这是我觉得最容易被忽略的地方。
很多人的数据库监控是:
kubectl get pods
看到:
3/3 Running
然后:
“稳了。”
实际上可能:
Pod:Running
数据库:异常
例如:
PVC 磁盘快满
数据库副本不同步
Leader 频繁切换
GC 爆炸
网络延迟升高
K8s 全都可能告诉你:
Running
所以真正生产环境至少要建立:
Kubernetes
      ↓
Prometheus
      ↓
Grafana
      ↓
Database Metrics
例如监控:
CPU
Memory
Disk
Disk IO
Network
QPS
Latency
Replication
Compaction
Errors
Connections
数据库监控不能只看:
Pod Running
十三、还有一个非常容易被忽略的问题:备份
很多人觉得:
“我用了 3 副本,所以不用备份。”
这是一个非常危险的想法。
假设:
Node1
Node2
Node3
数据都有三份。
然后某个管理员:
kubectl delete pvc --all
你会发现:
三份数据
↓
一起没了
副本解决的是:
节点故障。
备份解决的是:
人为误删、逻辑错误、灾难恢复。
两者完全不是一个东西。
十四、我更建议这样设计
生产环境可以考虑:
                    Internet
                       |
                    Ingress
                       |
                    Service
                       |
              +--------+--------+
              |                 |
           App Pod           App Pod
              |                 |
              +--------+--------+
                       |
                    Database
                       |
        +--------------+--------------+
        |              |              |
      Node-A         Node-B         Node-C
        |              |              |
      DB-0           DB-1           DB-2
        |              |              |
      PVC-A          PVC-B          PVC-C
再往上:
Prometheus
    ↓
Grafana
旁边再放:
Backup
  ↓
Object Storage
例如:
S3 / MinIO / OSS
最终形成:
业务
 ↓
K8s
 ↓
分布式数据库
 ↓
PVC
 ↓
Backup
 ↓
对象存储
这才是比较完整的生产体系。
十五、最后聊聊:K8s 到底适不适合跑数据库?
我的观点非常明确:
适合,但绝不是“部署一个 StatefulSet 就完事”。
Kubernetes 最大的价值并不是:
kubectl apply
而是把:
部署
扩容
故障恢复
服务发现
配置管理
监控
滚动升级
资源隔离
这些东西统一起来。
但是数据库本身的:
数据一致性
副本
Leader
Quorum
分片
故障转移
备份
恢复
仍然需要数据库自己解决。
所以真正成熟的架构应该是:
Kubernetes
     +
Operator
     +
StatefulSet
     +
Persistent Volume
     +
Monitoring
     +
Backup
     +
Database Native HA
而不是:
Kubernetes
     +
PVC
     =
数据库高可用
这两个结论,看起来只差几个组件,实际上差的是整个运维思维。
写在最后
CockroachDB、Vitess、Cassandra,其实代表了三种完全不同的数据库发展路线:
CockroachDB
     ↓
重新设计分布式 SQL

Vitess
     ↓
让 MySQL 走向水平扩展

Cassandra
     ↓
为海量数据和高吞吐而生
而 Kubernetes 更像是一个“基础设施操作系统”。
它可以帮你管理这些数据库,但它不会替你理解数据库。
所以如果你准备把分布式数据库放进 K8s,我建议先问自己三个问题:
第一,我为什么需要分布式数据库?
第二,我到底需要分片,还是需要副本?
第三,如果整个 Kubernetes 集群明天没了,我的数据怎么回来?
尤其是第三个问题。
很多所谓的“高可用架构”,平时看起来一个比一个漂亮,真正遇到故障的时候才发现:
Pod 是自动拉起来了,但数据呢?
这才是 K8s 上跑数据库真正值得思考的地方。
我是 Echo_Wish,一个喜欢把复杂技术掰开揉碎聊给你听的运维人。
如果只记住今天的一句话,我希望是:
K8s 能帮你把数据库“跑起来”,但只有数据库架构、存储、备份和故障恢复体系,才能让它真正“跑得住”。
