GEO 内容架构,是把企业原本分散在产品页、PDF、参数表、案例和销售经验中的信息,重新组织为“客户问题 → 知识事实 → 证据 → 页面 → 实体关系”的一套内容工程。
它解决的不是“怎么多写几篇 AI 文章”,而是一个更基础的问题:
当生成式搜索需要回答某个具体问题时,你的网站有没有一组足够明确、真实、可验证的信息可以参与回答?
这和传统的“一个关键词对应一篇文章”并不完全相同。
Google 2026 年发布的生成式 AI Search 官方指南透露了两个值得关注的机制:一是生成式搜索会使用 RAG 从搜索索引中检索相关网页;二是会进行 Query fan-out,即针对原始问题同时生成多个相关查询,从不同角度寻找信息。
因此,一个更合理的 GEO 内容结构不是:
关键词
  ↓
生成文章
  ↓
继续生成文章
而是:
客户问题
   ↓
问题树
   ↓
知识原子
   ↓
事实与证据
   ↓
页面组合
   ↓
实体与内链网络
本文就以工业 B2B 网站为例,把这套架构拆开实现。 
为什么批量写100篇AI文章不等于GEO?
因为内容数量和有效信息量不是同一个指标。
假设一个 CNC 加工网站连续发布以下文章:
How to Choose a CNC Machining Supplier
10 Tips for Choosing a CNC Supplier
Best Ways to Select CNC Manufacturers
How to Find Reliable CNC Companies
Things to Know Before Choosing CNC Suppliers
标题不同,但正文可能都在重复:
- 看经验;
- 看设备;
- 看质量;
- 看价格;
- 看交期。
表面上有 5 个 URL,实际上只产生了一份高度同质的信息。
Google 在 2026 年的生成式 AI Search 指南中专门强调,应优先建设 unique、valuable、non-commodity content,即具有真实经验、独特数据和专业信息的非同质化内容,而不是重复互联网上已经普遍存在的知识。Google 同时明确提醒,不要为了覆盖 Query fan-out 的每一个变体而创建大量页面。
可以把两种内容方式做一个对比:
| 维度 | 批量AI文章 | GEO内容架构 |
| 基础单位 | 文章 | 事实与问题 |
| 选题来源 | 关键词 | 用户决策问题 |
| 内容目标 | 增加URL | 提供可验证信息 |
| 重复风险 | 高 | 较低 |
| 数据来源 | 常识改写 | 企业事实、标准、案例 |
| 页面关系 | 各写各的 | 共用知识与证据 |
| 更新方式 | 重写整篇 | 更新底层事实 |
| 是否强调证据 | 不一定 | 是 |
| 长期维护成本 | 容易持续增加 | 可以结构化控制 |
真正应该增加的不是页面数量,而是网站能够回答的问题数量和事实密度。
GEO的问题树应该怎么建立?
问题树就是按照客户决策过程,将一个宽泛主题拆成若干真实问题。
例如产品不是从:
CNC machining
CNC machining company
CNC machining supplier
CNC machining manufacturer
开始,而是从采购决策过程开始。
以 CNC 铝合金零件为例,可以拆成 6 个问题层级:
| 阶段 | 用户真正关心什么 | 示例问题 |
| 认知 | 这个工艺是什么 | What is CNC milling? |
| 参数 | 能做到什么 | What tolerance can CNC milling achieve? |
| 选材 | 应该选择什么材料 | 6061 or 7075 for CNC parts? |
| 成本 | 为什么报价不同 | What affects CNC machining cost? |
| 风险 | 什么容易出问题 | Why do thin-wall parts deform? |
| 供应商评估 | 怎么判断厂家能力 | How to evaluate a CNC supplier? |
假设每个阶段整理 8 个核心问题,那么:
6 × 8 = 48 个核心问题
再给每个问题准备 2—3 种自然语言表达,就可以得到约:
48 × 3 = 144 个 Prompt 变体
需要强调:144 个 Prompt 不等于建设 144 个页面。
这是 GEO 内容架构最容易出现的误区。
一个问题应该对应一个页面吗?
通常不应该。
Google 已明确表示,没有必要为了用户可能提出的每一种查询或 fan-out 查询分别创建页面,因为搜索系统能够理解没有完全词面匹配的相关内容。
更合理的方法是按“主题完整性”聚合。
例如下面 8 个问题:
What tolerance can CNC milling achieve?
What is normal CNC tolerance?
Can CNC machining achieve ±0.01 mm?
What affects CNC machining tolerance?
Does part size affect CNC accuracy?
Do thin walls reduce machining accuracy?
How is CNC tolerance inspected?
What tolerance should buyers specify?
不需要生成 8 篇文章。
可以建设一个:
/cnc-machining-tolerance-guide/
页面结构为:
# CNC Machining Tolerance Guide
## What tolerance can CNC milling normally achieve?
## What factors affect CNC machining accuracy?
## Can thin-wall parts hold ±0.01 mm tolerance?
## How should CNC tolerances be specified on drawings?
## How are finished dimensions inspected?
## When is tighter tolerance unnecessary?
此时一个页面覆盖的是一个完整问题簇,而不是一个关键词。
什么是GEO里的“知识原子”?
知识原子,可以理解为能够独立表达、验证和复用的一条最小知识单元。
它不是 Google 官方的排名概念,而是一种内容工程方法。
在现有外贸 B2B GEO 方法资料中,知识可以拆成 Definition、Fact、Principle、Method、Process、Standard、Evidence、Case、Comparison、FAQ、Data 等不同类型,用于进一步组合成产品页、解决方案页、采购指南等内容。
例如,不应该把下面整段文字当作一个不可拆分的内容:
我们能够加工6061-T6和7075-T6铝合金,部分关键尺寸可以控制在±0.01 mm,同时配备CMM检测设备。
可以拆成:
| atom_id | 类型 | 属性 | 值 |
| A001 | Material | material | 6061-T6 |
| A002 | Material | material | 7075-T6 |
| A003 | Capability | tolerance | ±0.01 mm |
| A004 | Equipment | inspection | CMM |
| A005 | Process | process | CNC milling |
这样,同一个事实就可以被多种页面复用。
例如:
A001 + A003
→ 6061 tolerance FAQ
A001 + A002
→ 6061 vs 7075 comparison
A003 + A004
→ quality control page
A001 + A003 + A004
→ product capability page
这比每篇文章重新让 AI“自由发挥”更容易控制事实一致性。
知识原子应该保存哪些字段?
如果要真正工程化,不建议只保存一段文本。
至少可以保存 10 个字段:
{
  "atom_id": "CNC-TOL-001",
  "entity": "CNC milling",
  "property": "critical_dimension_tolerance",
  "value": "±0.01 mm",
  "unit": "mm",
  "scope": "selected dimensions under appropriate geometry and fixturing",
  "evidence_type": "inspection_record",
  "evidence_source": "CMM inspection report",
  "last_verified": "2026-07-15",
  "status": "verified"
}
这里最关键的字段不是 value,而是:
scope
evidence_source
last_verified
status
因为很多 B2B 内容错误就发生在“范围丢失”。
例如:
真实事实:
部分结构合理的关键尺寸可以做到 ±0.01 mm
错误改写:
Our machining tolerance is ±0.01 mm.
后一句把一个有条件的制造能力,扩大成了所有产品的统一能力。
在 AI 批量生成过程中,这类错误尤其常见。
为什么知识原子必须绑定证据?
因为事实和宣传语最大的区别就是能不能验证。
例如:
“拥有优秀的质量控制能力。”
几乎没有办法直接验证。
而:
“关键尺寸使用 CMM 检测,并按照图纸中的 GD&T 要求生成检测记录。”
至少包含:
检测对象:关键尺寸
检测设备:CMM
检测依据:drawing / GD&T
输出结果:inspection record
可以建立一个简单的证据模型:
Claim
  ↓
Fact
  ↓
Evidence
  ↓
Source
  ↓
Verification date
例如:
Claim:
支持高精度加工
Fact:
某类关键尺寸目标公差 ±0.01 mm
Evidence:
CMM dimensional inspection
Source:
Inspection Report QC-2026-071
Date:
2026-07-18
这种结构不仅方便内容生成,也方便后期纠错。
什么样的证据更适合放进GEO内容?
证据并不是越多越好,而是应该与结论直接对应。
例如:
| 结论 | 较弱证据 | 较强证据 |
| 加工精度高 | “先进设备” | 公差范围 + 检测方法 |
| 品质稳定 | “严格质检” | 检验流程 + 缺陷标准 |
| 熟悉某行业 | “经验丰富” | 项目案例 + 材料 + 工况 |
| 交期稳定 | “快速交付” | 标准Lead Time + 计算条件 |
| 支持定制 | “支持OEM” | 文件格式 + MOQ + 工艺边界 |
| 符合标准 | “国际品质” | ISO/ASTM/DIN具体编号 |
以材料表达为例:
弱:
High-quality stainless steel
更明确:
ASTM A240 Type 316L stainless steel
弱:
High precision
更明确:
Selected critical dimensions: ±0.01 mm
Inspection method: CMM
当然,所有数字都必须来自真实资料。
不能为了 GEO 增加“数据感”而制造数字。
怎样给证据设计一个简单评分?
内部内容管理时,可以给证据设置一个简单的 0—3 分质量等级。
这不是搜索引擎评分标准,而是用于控制内容质量的内部方法。
例如:
| 分数 | 定义 | 示例 |
| 0 | 无证据 | “品质领先” |
| 1 | 描述性信息 | “使用CMM检测” |
| 2 | 有明确参数 | “关键尺寸使用CMM检测” |
| 3 | 参数+来源+日期 | “QC-2026-071报告,2026-07-18” |
假设一个页面有 12 个核心结论:
3分证据:5条
2分证据:4条
1分证据:2条
0分证据:1条
可以计算内部 Evidence Coverage:
至少达到2分的结论
= 5 + 4
= 9
Evidence Coverage
= 9 / 12
= 75%
这个 75% 不是“AI 引用概率”,只是团队内部检查页面事实完整度的指标。
这样比主观判断“文章看起来很专业”更容易执行。
企业资料应该怎样变成页面?
可以把过程分成四层。
Raw Data
企业原始资料
     ↓
Knowledge Atoms
知识原子
     ↓
Topic Clusters
问题主题组
     ↓
Pages
正式页面
例如企业提供:
设备清单.xlsx
质量检测流程.pdf
6061加工案例.docx
客户常见问题.xlsx
产品参数表.xlsx
第一步不是直接让 AI 写文章,而是先提取:
材料
设备
加工能力
检测方式
公差
交期
MOQ
标准
案例
缺陷
应用行业
采购限制
假设整理得到:
事实原子:72条
标准原子:18条
案例原子:12条
流程原子:15条
对比原子:9条
合计:
72 + 18 + 12 + 15 + 9
= 126 个知识原子
然后再判断这些知识能够覆盖多少客户问题。
而不是反过来,为了完成“本月30篇文章”的指标制造内容。
产品页、FAQ和技术文章应该怎么分工?
不同页面承担的任务应该不同。
| 页面类型 | 主要解决什么 | 推荐信息 |
| Product | 产品是什么 | 参数、材料、规格、能力 |
| Solution | 如何解决场景问题 | 工况、方案、流程 |
| Guide | 如何做决策 | 方法、标准、风险 |
| Comparison | 如何选择 | 差异、优缺点、条件 |
| Case | 有没有真实经验 | 背景、方法、数据、结果 |
| FAQ | 快速回答具体问题 | 明确答案、条件、例外 |
| About | 企业是谁 | 实体、能力、资质、地址 |
这七类页面不应该互相复制。
例如“±0.01 mm”这个知识原子可以出现多次,但表达任务应该不同:
Product
→ 我们哪些产品可以做到?
Guide
→ 什么情况下需要 ±0.01 mm?
FAQ
→ ±0.01 mm 是否适合所有 CNC 零件?
Case
→ 某项目如何验证 ±0.01 mm?
Comparison
→ ±0.01 mm 与 ±0.05 mm 对成本有什么影响?
这才叫复用知识,而不是复制内容。
FAQ在2026年还值得做吗?
值得做,但不要把 FAQ 的价值等同于 FAQ 富媒体搜索结果。
Google 在 2026 年 5 月 7 日停止了 FAQ rich result 在 Google Search 中的展示,并在 5 月 8 日更新官方文档说明该功能已经弃用。
因此现在做 FAQ,不应该再以“获得 FAQ 富摘要”为主要理由。
FAQ 更实际的价值是:
- 明确回答客户具体问题;
- 补充产品页放不下的条件与边界;
- 建立问题与实体之间的语义关系;
- 为销售、客服和内容团队复用;
- 为 AI 检索提供直接的问题答案。
换句话说:
FAQ 应该作为内容结构,而不是 Schema 技巧。
FAQ应该独立建100个页面吗?
通常不应该。
例如:
Can you machine 6061 aluminum?
Can you machine 7075 aluminum?
Can you machine 2024 aluminum?
Can you machine 5052 aluminum?
如果每一个问题都只有 100 字左右,而且模板完全相同,拆成 4 个页面未必有价值。
更合理的是建设:
/aluminum-cnc-machining/
然后组织成:
## Which aluminum grades are suitable for CNC machining?
### When should 6061-T6 be used?
### When should 7075-T6 be used?
### How does 2024 compare with 6061?
### Is 5052 suitable for CNC milling?
Google 2026 年的生成式搜索指南也明确反对为了覆盖每一种搜索问题而大规模制造近似页面。
所以:
问题树用于发现内容缺口,不等于“一问题一 URL”。
Schema应该放在内容架构的哪一层?
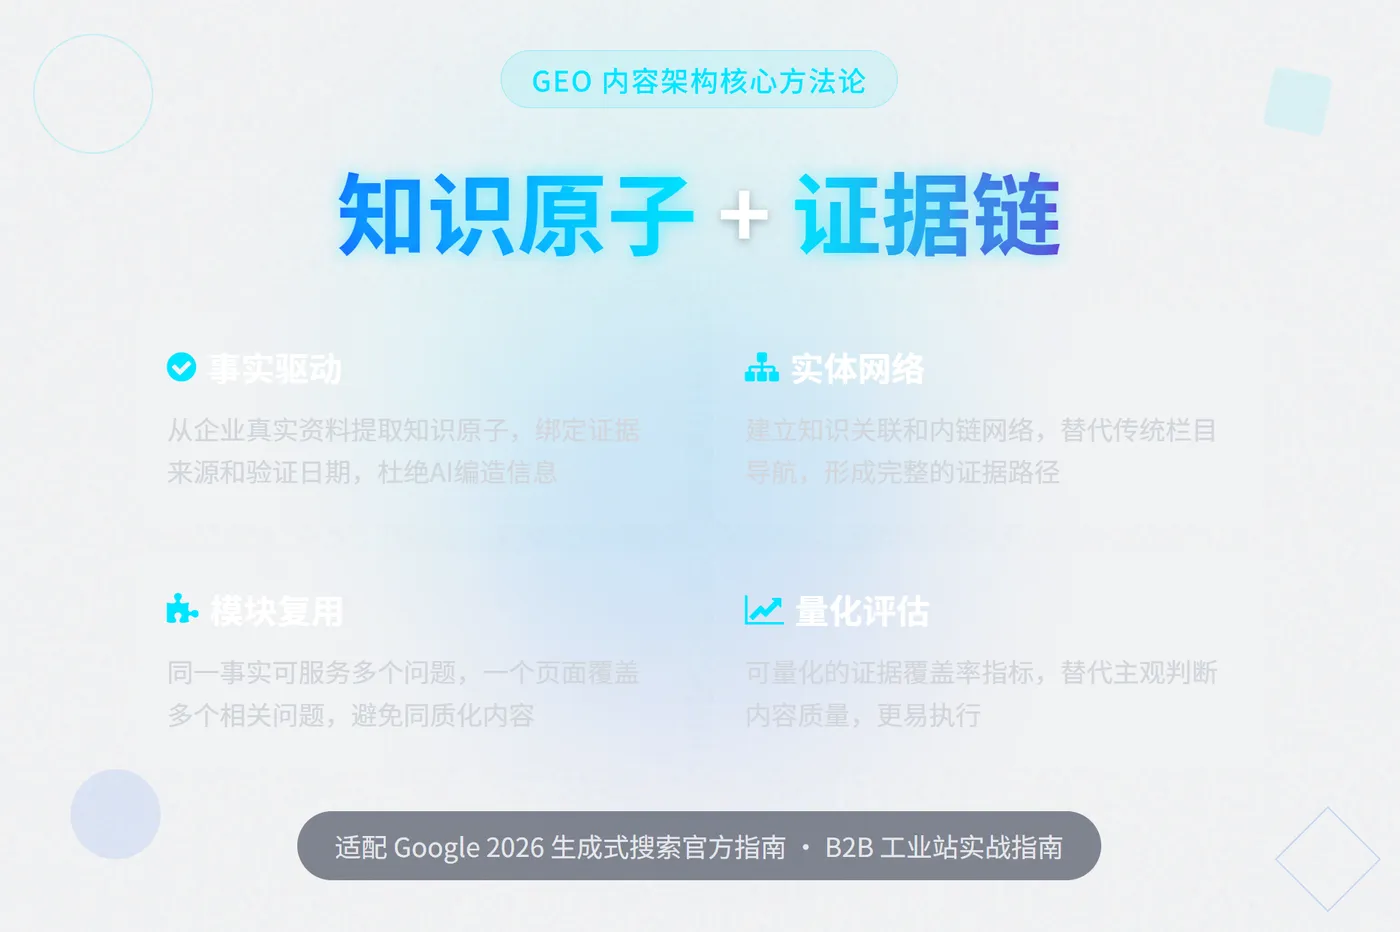
Schema 更适合作为实体和页面信息的机器可读补充,而不是内容本身。
例如 Google 推荐企业可以通过 Organization 描述:
name
alternateName
url
logo
address
telephone
其中部分字段可以帮助 Google 对组织实体进行消歧。
产品页则可以使用 Product。
Google 官方说明,Product structured data 可以帮助搜索系统理解价格、库存、评价、配送等产品信息;对于存在多个型号、材料、尺寸等变体的商品,还可以使用 ProductGroup 和 hasVariant 建立变体关系。
例如:
{
  "@context": "https://schema.org",
  "@type": "Product",
  "@id": "https://example.com/product/al-housing#product",
  "name": "CNC Machined Aluminum Housing",
  "sku": "AL-HSG-6061",
  "material": "6061-T6 Aluminum",
  "manufacturer": {
    "@id": "https://example.com/#organization"
  }
}
这里 manufacturer 通过统一 @id 指向企业实体。
这比每个页面单独创建一个没有关系的 Organization 节点更清晰。
但需要注意:
Google 明确说明,即使结构化数据完全正确,也不保证产生对应搜索展示。
所以 Schema 的定位应该是:
降低信息歧义,而不是制造排名。
内部链接应该怎么从“栏目导航”升级成“知识网络”?
传统网站常见结构是:
Home
├── Products
├── About Us
├── News
└── Contact
这只是导航结构。
真正的知识关系可能是:
6061-T6
   ↓
CNC Milling
   ↓
Tolerance
   ↓
Surface Finish
   ↓
CMM Inspection
   ↓
Industrial Housing Case
于是一个产品页可以链接:
6061-T6 Aluminum Housing
    ├── 6061 vs 7075
    ├── CNC tolerance guide
    ├── Surface finish guide
    ├── CMM inspection guide
    └── Housing machining case
这些链接的目的不是单纯“增加内链数量”,而是帮助用户继续验证一个结论。
例如:
Product 页面说可以做到某个公差。
用户下一步自然会问:
怎么验证?
于是链接到 Inspection 页面。
再下一步:
有没有做过类似项目?
于是链接到 Case 页面。
这就是一条完整的证据路径。
怎么用代码检查问题覆盖是否完整?
如果已经建立 Prompt 和知识原子,可以做一个很简单的覆盖检查。
例如建立:
prompts = {
    "P001": {"topic": "tolerance", "atoms": ["A001", "A003"]},
    "P002": {"topic": "material", "atoms": ["A001", "A002"]},
    "P003": {"topic": "inspection", "atoms": ["A003", "A004"]},
    "P004": {"topic": "lead_time", "atoms": ["A010", "A011"]}
}
published_atoms = {
    "A001",
    "A002",
    "A003",
    "A004",
    "A010"
}
for prompt_id, item in prompts.items():
    required = set(item["atoms"])
    missing = required - published_atoms
    coverage = (
        len(required - missing)
        / len(required)
        * 100
    )
    print(
        prompt_id,
        item["topic"],
        f"{coverage:.0f}%",
        "missing:",
        sorted(missing)
    )
输出:
P001 tolerance 100% missing: []
P002 material 100% missing: []
P003 inspection 100% missing: []
P004 lead_time 50% missing: ['A011']
这样就能发现:
不是“还缺一篇文章”,而是 P004 缺少 A011 这条事实。
这两种诊断方式差别很大。
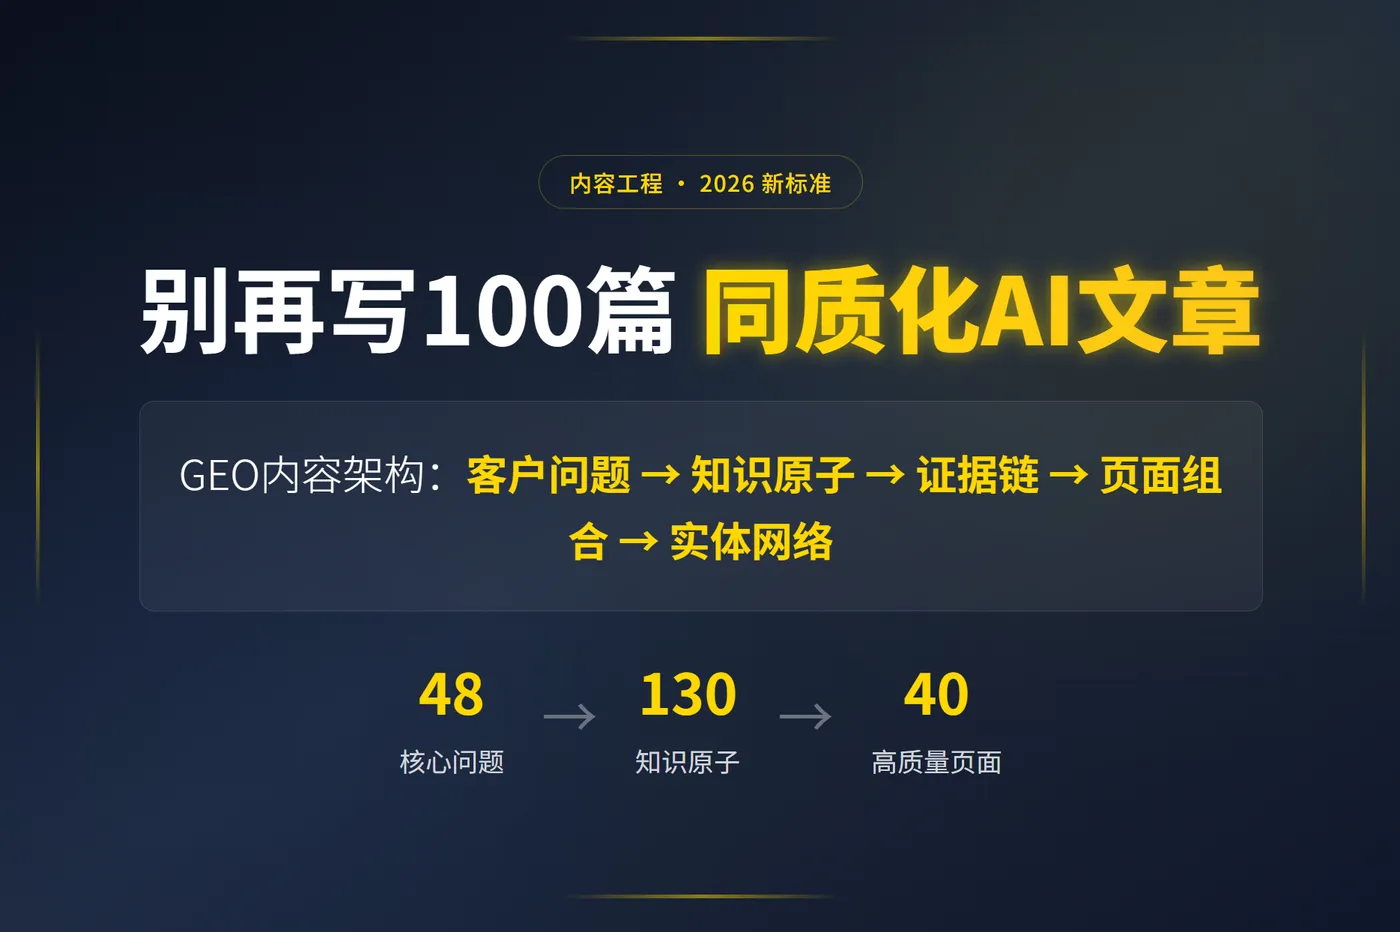
一个小型GEO内容库应该有多复杂?
不需要一开始就建设大型知识图谱。
以一个单产品线 B2B 网站为例,可以先做一个最小版本:
核心问题:48个
Prompt变体:144个
知识原子:
事实      60
标准      15
流程      15
证据      20
案例      10
对比      10
----------------
合计     130条
页面可以控制在:
核心产品页       8
解决方案页       6
采购/技术指南   10
对比页面         6
案例页面         6
FAQ主题页面      4
-----------------
合计            40个页面
这只是一个架构示例,不是 GEO 行业标准。
重点是:
144 Prompt
≠ 144 Pages
而可能是:
144 Prompts
→ 48 Core Questions
→ 130 Knowledge Atoms
→ 40 Pages
一个事实可以服务多个问题,一个页面也可以覆盖多个相关问题。
怎么判断一个页面是不是“同质化内容”?
发布前可以问 5 个问题:
| 检查项 | 是 | 否 |
| 有没有企业自己的数据? | ✓ | |
| 有没有明确适用条件? | ✓ | |
| 有没有真实案例或经验? | ✓ | |
| 有没有可以验证的来源? | ✓ | |
| 删除公司名称后,还和网上100篇文章一样吗? | ✓ |
最后一项尤其重要。
例如:
“选择供应商时,应考虑质量、价格、服务和交期。”
这几乎任何公司都可以写。
而:
“对于壁厚低于1.5 mm的6061-T6壳体,我们会先评估装夹变形风险,再决定是否采用分阶段粗精加工。”
这才开始具备真实经验信息。
Google 2026 年官方指南所谓的 non-commodity content,核心也正是这种区别:不要只是重新总结已有常识,而应该加入一手经验、独特观点和真正有用的信息。
GEO内容生产流程应该怎么改?
传统 AI 内容生产经常是:
关键词
↓
Prompt
↓
AI写文章
↓
发布
更适合 GEO 的流程是:
用户问题
↓
判断搜索意图
↓
匹配已有知识原子
↓
发现事实缺口
↓
补企业资料/标准/案例
↓
验证证据
↓
组合页面
↓
人工技术审核
↓
发布
↓
监测问题覆盖
最关键的一步其实是:
如果缺少事实,就停止生成。
例如系统发现用户的问题是:
What is your typical lead time for 7075 CNC parts?
但知识库中不存在经过验证的 Lead Time 数据。
此时正确结果应该是:
Missing fact:
7075 CNC machining lead time
而不是让模型自动补一句:
“通常为7—14天。”
对于工业、制造、技术类 GEO 来说,拒绝编造信息也是内容系统能力的一部分。
FAQ:GEO内容架构还有哪些常见问题?
知识原子越小越好吗?
不是。
如果把:
±
0.01
mm
拆成三个事实,就失去了语义。
一个知识原子至少应该能够独立表达一个明确事实。
例如:
selected critical dimension tolerance = ±0.01 mm
才是完整单元。
一条知识原子可以出现在多个页面吗?
可以。
事实复用和文字复制不是同一件事。
例如同一个材料标准可以同时服务产品页、FAQ、案例和对比文章,只要不同页面解决不同问题。
GEO一定要做知识图谱吗?
不一定。
对于几十到几百个页面的网站,关系型数据库、JSON、Notion 或普通 CMS 字段就可以建立第一版知识关系。
不要为了“知识图谱”这个概念增加不必要的工程复杂度。
FAQ Schema取消展示后还要写FAQ吗?
可以继续写。
2026 年 5 月取消的是 Google Search 的 FAQ rich result 展示,不等于用户不再问问题,也不等于 FAQ 内容本身失去价值。
应该把 FAQ 看成信息结构,而不是富摘要技巧。
一个问题到底应该独立成页还是放进现有文章?
判断三个条件:
问题是否有独立搜索意图?
是否有足够独立的信息与证据?
用户是否需要单独访问它解决问题?
三个答案大部分为“是”,才考虑独立页面。
否则更适合成为现有页面的一个章节。
GEO是不是要求把文章切成很多小段?
不是。
Google 2026 年官方指南已经明确提醒,不必为了所谓 GEO 而追求特殊的 content chunking 技巧。
章节清晰的主要价值仍然是帮助用户阅读,也有助于机器理解内容结构,但并不存在一个公开的“最佳 Chunk 字数”。
因此“每段必须100字”“每个答案必须50—80词”等规则,不应该当作搜索引擎官方标准。
GEO最应该先建文章库还是知识库?
对于拥有大量产品参数、标准、工艺和案例的 B2B 网站,建议先整理知识库。
原因很简单:
文章错误
通常来自
底层事实不完整
如果企业自己都没有整理清楚材料、参数、能力边界、标准和案例,让 AI 连续生成 100 篇文章,只会把信息不一致扩大 100 次。
GEO内容架构最终应该解决什么问题?
GEO 内容建设最终不是比谁拥有更多 URL,而是比谁拥有更完整、更可信、更容易组合的信息资产。
可以把整个架构压缩成:
用户提出问题
      ↓
建立问题树
      ↓
识别所需事实
      ↓
调用知识原子
      ↓
绑定真实证据
      ↓
组合成页面
      ↓
建立实体和内链关系
      ↓
搜索与生成式系统检索
2024 年发表在 KDD 的原始 GEO 研究已经指出,生成式引擎中的内容可见性可以通过不同内容策略发生显著变化,其实验中最高提升约 40%,但效果会随领域而明显不同,因此并不存在一套适用于所有行业的固定优化公式。
到了 2026 年,Google 给出的官方方向也更加明确:生成式搜索仍建立在搜索索引和质量系统之上,网站应该优先建设独特、有经验依据、非同质化的内容,而不是追逐所谓 GEO 快捷技巧。
所以,对于开发者和内容团队,更值得投入的不是:
“怎么让 AI 再生成 100 篇文章?”
而是:
“当用户提出 100 个采购和技术问题时,我们到底拥有多少条经过验证的事实,可以稳定地回答这些问题?”
当这个问题能够用数据回答时,GEO 才真正从“AI 写作”进入了内容工程阶段。