
如果你是第一次使用 AiWork,建议先掌握这 10 个高频技巧。它们能帮助你更快把模糊想法变成可执行任务,让 AI 真正参与到研发、文档、评审和日常协作中。
10 个技巧速览
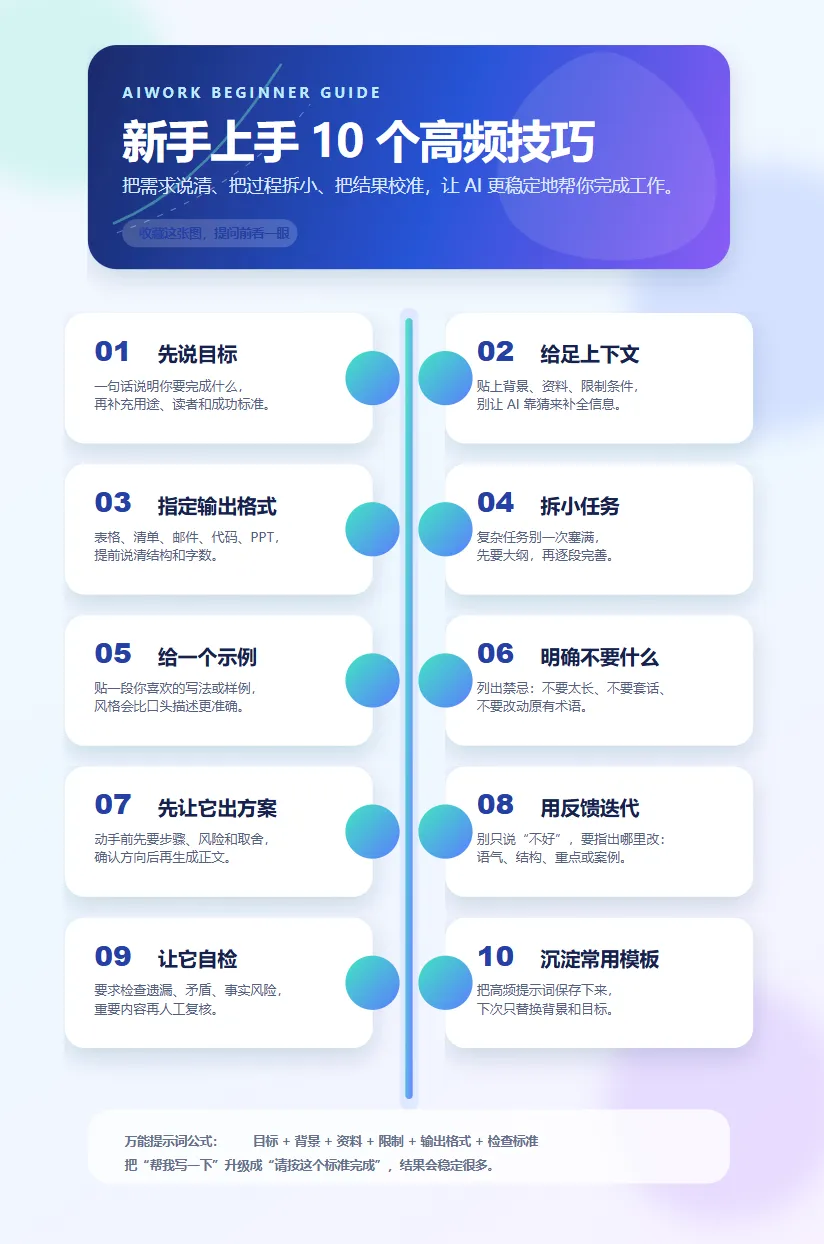
注:本案例以AiWork桌面端为工作端。
1. 清晰表达:把需求说成任务
很多新手第一次使用,会直接说:
帮我优化一下这个页面。
这类表达看似省事,但 AiWork 很难判断你想优化什么:性能、样式、交互,还是某个具体 Bug。
更推荐把需求说成一个工程任务,讲清楚三件事:
- 做什么:目标或问题是什么;
- 有什么:相关文件、日志、限制条件是什么;
- 怎么样:期望结果、输出格式、验收方式是什么。
不推荐
帮我优化一下这个页面。
问题是目标不明确。
推荐
请修复用户列表页筛选后分页不重置的问题。
相关文件:src/pages/UserList/index.tsx
现象:第 5 页切换筛选条件后,接口仍请求pageNum=5。
期望:筛选变化后pageNum重置为 1。
限制:不改接口、不改样式,只做最小修改。
验收:补充测试,并输出验证命令。
2. 小步快跑:一次只推进一件事
复杂任务不要一次性全丢,任务越大,越应该拆成几个可确认的小步骤:
- 先理解现状;
- 再制定方案;
- 小范围修改;
- 最后验证结果。
这样每一步都能校准方向,发现偏差也更容易及时拉回来。
不推荐
帮我把登录、权限、菜单、接口拦截都重构一下,顺便补测试。
问题是范围太大,风险不可控,也很难 Review。
推荐
第 1 轮:请先阅读登录相关代码,总结当前流程,不要修改。
第 2 轮:列出重构方案、风险点和拟修改文件,等我确认。
第 3 轮:先只修复 Token 过期后没有跳转登录页的问题。
第 4 轮:补充回归测试,并运行相关检查。
3. 多轮调整:第一版不是终版
第一版输出只是起点,不一定就是最终答案。
如果结果不符合预期,不要只说“不行”“重写”。更有效的方式是指出:
- 哪里不对;
- 为什么不对;
- 希望怎么改;
- 还有哪些限制要补充。
不推荐 |
更推荐 |
不对,重写 |
这个实现改动太大,请只做最小修复 |
太啰嗦 |
请压缩到 200 字以内,用列表输出 |
不像我们项目 |
请参考现有 |
再专业点 |
请以资深前端工程师视角重新评估 |
推荐示例
这个实现改动太大了。请保持现有组件结构,只修复
pageNum没有重置的问题,不要顺手重构。输出时只说明修改点和验证命令。
4. 先看再改:真实文件任务要控风险
只要任务涉及真实文件、配置、批量替换或外部写入,就不要一上来直接动手。
更稳的方式是:先让它列清单、说明影响范围,再确认是否执行。
风险级别 |
示例 |
建议 |
低风险 |
读取文件、生成摘要、运行只读检查 |
可直接执行 |
中风险 |
新建文件、批量格式化、移动文件 |
先列清单 |
高风险 |
删除文件、发布上线、推送远端、修改配置 |
必须人工确认 |
不推荐
把项目里所有旧接口都替换成新接口。
问题是可能误改无关模块,影响范围不可控。
推荐
请先扫描项目中使用
getUserList的位置,只列出文件路径、调用位置和可能影响范围,不要修改。等我确认后,再按模块逐个迁移。
5. 设定角色
当任务需要专业判断时,可以给 AiWork 一个明确角色。角色越清楚,它的关注点就越稳定。
场景 |
推荐角色 |
需求拆解 |
产品经理 |
技术方案 |
架构师 / 技术负责人 |
Bug 定位 |
资深研发工程师 |
测试补齐 |
测试工程师 |
安全检查 |
安全专家 |
代码评审 |
Code Reviewer |
不推荐
帮我看看这段代码有没有问题。
问题是关注点太泛,输出容易散。
推荐
请以 Code Reviewer 的视角审查这次改动,重点关注:逻辑缺陷、兼容性风险、性能问题和测试覆盖。请按 Blocker / Major / Minor 分级输出。
6. 提供样例:一个例子胜过十句要求
如果你希望 AiWork 按团队风格输出,最有效的方法不是反复描述“专业一点”“像我们平时那样”,而是直接给它一个已有样例。
样例就是锚点,能更稳定地模仿结构、语气和格式。
不推荐
帮我写得像我们团队平时的测试风格。
“团队风格”太抽象。
推荐
请参考
UserList.test.tsx中已有用例的组织方式,为“筛选后分页重置”补充测试。要求:使用相同的 render 工具、相同的 mock service 方式,不引入新测试库,用例命名风格保持一致。
适合提供的样例
样例类型 |
用途 |
已有代码 |
保持编码风格 |
测试用例 |
保持测试写法 |
README |
保持文档结构 |
PR 描述 |
保持提交说明风格 |
复盘模板 |
保持业务表达方式 |
7. 多任务隔离:一个目标一个上下文
长对话里最容易混入过期信息和无关约束。写周报、修 Bug、做 Review、生成文档,最好拆成不同任务。
一个目标对应一个上下文,输出会更稳定。
不推荐
继续在这个会话里,顺便帮我写周报、修 Bug,再 Review 一下代码。
问题是上下文混杂,容易前后约束冲突。
推荐
这是一个新的 Bug 修复任务。背景如下:……
相关文件:……
错误日志:……
请只处理这个 Bug,不要处理周报和 Review。
如果一个会话已经很长,也可以先压缩上下文:
请用 10 条以内总结当前任务:目标、已完成内容、未解决问题、关键限制和下一步计划。
8. 节省 Token:少给噪音,多给线索
节省 Token 不是少说话,而是少给无效信息。
相比粘贴完整项目或完整 CI 日志,更应该提供:
- 失败命令;
- 失败用例;
- 关键错误;
- 相关文件路径;
- 期望输出格式。
少做 |
多做 |
粘贴完整项目 |
给相关文件路径 |
粘贴完整 CI 日志 |
给失败命令、用例名、关键错误 |
一个会话聊所有事 |
一个目标一个任务 |
反复解释历史 |
先生成摘要再继续 |
让它猜格式 |
给模板或样例 |
输出长篇解释 |
要求只给结论、命令、风险 |
推荐示例
CI 失败,请定位原因。
失败命令:npm test -- UserList
失败用例:should reset pageNum when filter changes
关键日志:Expected 1, received 5
相关文件:src/pages/UserList/index.tsx、src/pages/UserList/UserList.test.tsx
请先分析原因,再做最小修复。
9. 自动化重复工作:规则明确就交给 AI
AiWork 很适合处理重复性高、规则明确、结果可检查的任务,比如:
自动化场景 |
示例 |
提交前检查 |
跑测试、查 console、查敏感信息 |
周报生成 |
汇总本周提交和需求进展 |
文档同步 |
根据接口变更生成说明 |
质量巡检 |
检查 TODO、重复代码、过期依赖 |
Review 辅助 |
根据 diff 生成风险清单 |
但高风险操作不要自动放开,例如删除、发布、推送等,都应该保留人工确认。
不推荐
以后所有事情你都自动处理,改完直接提交。
问题是授权过大,容易出现不可控写入或错误提交。
推荐
请在提交前执行检查:查看本次改动文件、运行相关单测、检查
console.log/ 敏感信息 / 无关格式化,并输出 PR 摘要和风险点。注意:只检查和生成摘要,不要提交、推送或发布。
10. 学会“偷懒”:把机械劳动交给 AiWork
真正的提效,不是把所有判断都交给 AI,而是把重复执行交给 AI,把判断和决策留给自己。
这些任务很适合先交给 AiWork 做一版:
- 测试模板;
- 日志整理;
- PR 摘要;
- 类型生成;
- 文档初稿;
- 变更说明。
不推荐
帮我随便写点测试,能过就行。
问题是目标和标准都太低,容易生成无效测试。
推荐
请为
price.ts生成单元测试,覆盖正常价格、价格为 0、null/undefined、小数精度和非法输入。要求:不修改业务逻辑;如果发现疑似 Bug,先说明原因,等我确认。
最后:推荐上手顺序
如果你刚开始使用,可以按这个顺序练习:
- 先学会清晰提需求;
- 再学会分步推进;
- 通过多轮反馈校准结果;
- 用角色和样例提升质量;
- 涉及真实改动时先控风险;
- 规则明确的重复任务再逐步自动化。
记住这 6 个字:
说清楚,慢慢放。
先把任务、上下文、边界和验收说清楚;等 AiWork 的执行方式稳定后,再逐步把更多重复工作交给它。这样既能提升效率,也能把风险控制在可接受范围内。
