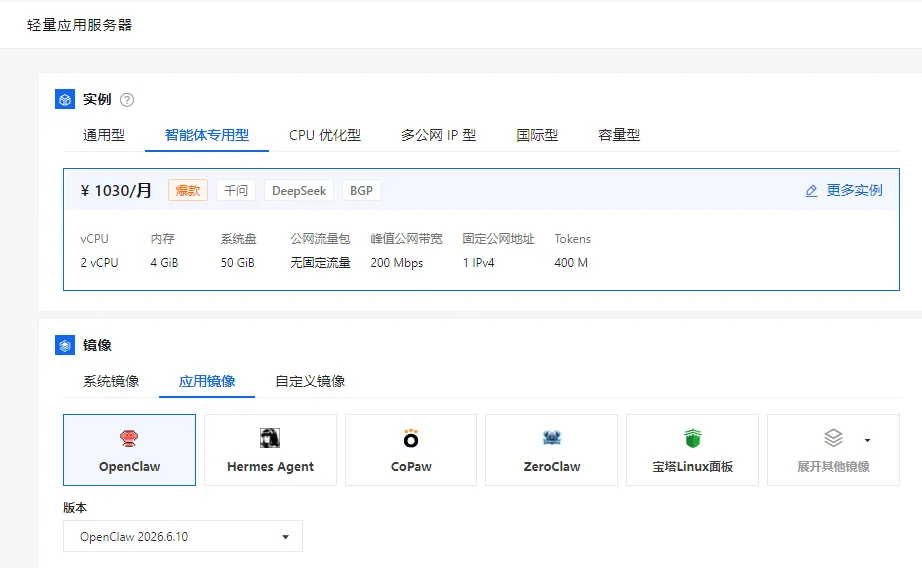
智能体专用型规格族是面向中小企业及开发者Agent场景的规格族,在云服务器资源基础上打包预付费Tokens资源。下面为大家介绍该规格族的适用场景、在售实例规格、Tokens资源的计费计量方式以及使用限制,供您在购买前做规格选型参考。
一、阿里云轻量应用服务器智能体专用型规格族是什么?
阿里云轻量应用服务器智能体专用型规格族是专为中小企业及开发者部署 AI 智能体(Agent)应用场景设计的新型服务器套餐。该规格族在传统轻量应用服务器的计算、存储、网络资源基础上,打包预付费 Tokens 资源,实现“算力 + AI 能力”一体化交付。
其核心特点包括:
- 开箱即用:预集成主流 AI Agent 应用镜像(如 OpenClaw、Hermes Agent、Dify、MaxKB 等),用户可一键部署专属 AI 助手;
- 统一计费:套餐内包含固定额度的 Tokens,避免模型调用产生额外费用,成本可控;
- 深度优化:针对 LLM 推理、工具调用、记忆检索等 Agent 典型负载进行资源配比优化;
- 地域覆盖广:目前在中国内地 12 个地域(含杭州、北京、上海、深圳、成都、广州等)全面售卖。
该规格族提供两种性能等级:
- 2 vCPU 版本:适用于个人开发者或轻量级 Agent 应用,在业务高峰期可能出现计算性能波动;
- ≥4 vCPU 版本:面向企业级场景,保障对整个超线程的独占占用,提供稳定高性能。
智能体专用型规格族专注于中小企业及开发者的Agent场景,在轻量应用服务器的计算、存储、网络资源之上,打包预付费的Tokens资源,具备以下特点:
- 简单:套餐内包含Tokens资源,无二次消费;与热门AI应用深度集成,提供应用镜像与面板,开箱即用。
- 便宜:将匹配中小企业及开发者需求的vCPU、内存、云盘、公网与Tokens打包定价。
二、智能体专用型使用限制
- 当前仅在中国站的中国内地地域售卖。
- 不支持挂载数据盘。
- 暂不支持升配。
- Tokens资源包用尽后,平台将自动停止模型服务(限流为0),以避免产生套餐以外的Tokens费用,用量在下一个计费周期重置。高峰期资源争抢和滥用模型工具,会对RPM(每分钟调用次数)和TPM(每分钟消耗Token数)进行限流,智能体专用型不适合应用于对模型性能有强保障诉求的场景。
- 模型:为优化智能体专用型资源利用,将根据模型迭代升级情况不定期下线历史模型。自下线通知发布之日起,将逐步缩减待下线模型的RPM(每分钟调用次数)和TPM(每分钟消耗Token数)。自模型正式下线之日起,停止支持模型推理服务,已创建的调用该模型的应用和服务将无法返回结果。
- 退订:云服务器按剩余时长退还残值,Tokens资源按剩余用量退还残值;对于五天无理由退订场景,如果Tokens资源已有消耗,则不支持退订。
三、智能体专用型包含实例规格
智能体专用型规格族包含的实例规格及指标数据如下表所示。
| 实例规格 | vCPU | 内存(GiB) | 系统盘容量(GiB) | 公网流量包 | 峰值公网带宽(Mbps) | 公网线路类型 | 固定公网地址 | Tokens(M) |
|---|---|---|---|---|---|---|---|---|
| swas.as.c2m05s20b1t100.linux | 2 | 0.5 | 20 | 无固定流量(不收取流量费用) | 最高200 | BGP | 1个IPv4 | 100 |
| swas.as.c2m2s40b1t200.linux | 2 | 2 | 40 | 无固定流量(不收取流量费用) | 最高200 | BGP | 1个IPv4 | 200 |
| swas.as.c2m4s50b1t400.linux | 2 | 4 | 50 | 无固定流量(不收取流量费用) | 最高200 | BGP | 1个IPv4 | 400 |
| swas.ad.c4m8s180b1t800.linux | 4 | 8 | 180 | 无固定流量(不收取流量费用) | 最高200 | BGP | 1个IPv4 | 800 |
| swas.ad.c4m16s240b1t800.linux | 4 | 16 | 240 | 无固定流量(不收取流量费用) | 最高200 | BGP | 1个IPv4 | 800 |
| swas.ad.c8m16s300b1t1600.linux | 8 | 16 | 300 | 无固定流量(不收取流量费用) | 最高200 | BGP | 1个IPv4 | 1600 |
| swas.ad.c8m32s360b1t1600.linux | 8 | 32 | 360 | 无固定流量(不收取流量费用) | 最高200 | BGP | 1个IPv4 | 1600 |
| swas.ad.c16m32s420b1t3200.linux | 16 | 32 | 420 | 无固定流量(不收取流量费用) | 最高200 | BGP | 1个IPv4 | 3200 |
| swas.ad.c16m64s480b1t3200.linux | 16 | 64 | 480 | 无固定流量(不收取流量费用) | 最高200 | BGP | 1个IPv4 | 3200 |
说明:智能体专用型(2 vCPU)不适合应用于对计算性能有强保障诉求的场景,当阿里云在业务高峰期出现资源争抢时,计算性能会发生一定的波动;智能体专用型(≥4 vCPUs)适合对计算性能有强保障诉求的企业级场景,始终能保证对整个超线程的占用,从而提供始终如一的高性能。智能体专用型规格族目前仅在中国站的中国内地地域售卖,支持的地域包括华东1(杭州)、华北2(北京)、华东2(上海)、华南1(深圳)、西南1(成都)、华北1(青岛)、华北3(张家口)、华北5(呼和浩特)、华北6(乌兰察布)、华南3(广州)、华中1(武汉-本地地域)、华南2(河源)。
二、智能体专用型与通用型、CPU优化型、多公网IP型等规格族有何区别?
阿里云轻量应用服务器提供多种规格族以适配不同业务需求,其核心差异如下:
| 规格族类型 | 核心定位 | 资源特点 | 典型用途 |
|---|---|---|---|
| 智能体专用型 | AI Agent 部署 | 打包预付费 Tokens + 计算资源,支持 Agentic OS 镜像 | 自建 AI 助手、编码机器人、知识库问答系统 |
| 通用型 | 均衡负载 | CPU/内存比例均衡,适合 Web 应用、博客、小型电商 | WordPress、Discuz、静态网站 |
| CPU优化型 | 高计算负载 | 高主频 CPU,适合编译、数据分析等任务 | 开发测试、轻量数据处理 |
| 多公网IP型 | 多站点隔离 | 单实例绑定多个公网 IP,便于多域名独立管理 | 多站托管、SEO 分站部署 |
关键区别在于:
智能体专用型是唯一内置 Tokens 资源的规格族,专为调用大模型 API 的场景设计;而其他规格族仅提供基础 IaaS 能力,若需使用 AI 模型,需额外购买 Token Plan 或百炼服务,并自行集成。
此外,智能体专用型默认搭载 Alibaba Cloud Linux 4 LTS Agentic 版系统镜像,预装推理框架与 Agent 运行时环境,显著降低部署门槛。
三、轻量应用服务器智能体专用型主要适用场景及优势解析
典型场景包括云端专属AI助理(如OpenClaw、Hermes Agent、ZeroClaw等个人助理,Claude Code、OpenCode等编码助理)以及基于Dify等搭建的自建AI应用。
典型适用场景
个人专属 AI 助手部署
使用 OpenClaw、ZeroClaw 等镜像,快速搭建具备记忆、工具调用能力的私人助理,用于日程管理、知识整理、写作辅助等。开发者编码助手
部署 Claude Code、OpenCode 等编码 Agent,结合本地 IDE 实现智能补全、错误诊断、文档生成。企业知识库问答系统
基于 Dify 或 MaxKB 构建 RAG 应用,将内部文档、FAQ 接入大模型,实现精准语义问答。轻量级 AI SaaS 应用
初创团队可基于智能体专用型快速验证 AI 产品原型,如客服机器人、营销文案生成器等。
核心产品优势
- 成本透明:Tokens 与服务器资源打包定价,无隐性调用费用,避免“跑飞账单”风险;
- 极速上线:应用镜像预集成 Agent 框架,5 分钟内完成部署,无需手动配置模型 API、向量库、前端界面;
- 运维简化:支持通过 Workbench AI Agent 模式 以自然语言执行运维操作(如“安装 Docker”“检查 GPU”),大幅降低命令行门槛;
- 安全可靠:默认接入云安全中心,提供防病毒、防勒索、合规检查等基础防护;
- 弹性扩展:未来可平滑迁移至 ECS 或搭配轻量负载均衡,应对业务增长。
重要提醒:智能体专用型 不适用于高并发在线服务或实时性要求极高的生产环境。若需 SLA 保障或弹性扩缩容,建议选用 ECS + 百炼组合方案。
四、Tokens资源
支持的模型
智能体专用型实例的Tokens资源当前支持以下模型版本,模型采用默认配置:
- qwen3.7-plus
- deepseek-v4-flash
计费与计量
- 售卖方式:Tokens资源包与云服务器强捆绑,采用预付费方式,随实例一同购买,不支持单独购买Tokens。
- 计量方式:Tokens不区分输入、缓存和输出,不区分单次请求的输入Token阶梯,不收取模型工具调用费用。计量单位为M(百万Tokens)。
- 额度用尽:当Tokens资源包用尽后,模型服务将不可用,直到下一个计费周期重置用量。
用量查询与通知
- 用量查询:您可以查询Tokens资源包的已使用量和总量。
- 用量通知:当Tokens资源包使用量达到50%、80%、100%三个阈值时,通过短信、邮件、站内信、Webhook四个通路向您发送通知。
API接入
- API Key:每台云服务器带一个独立的API Key,支持重置、禁用。
- Base URL:
五、阿里云轻量应用服务器智能体专用型最新活动信息
目前阿里云围绕智能体场景推出多项组合优惠,活动详情可参考:https://www.aliyun.com/daily-act/ecs/activity_selection
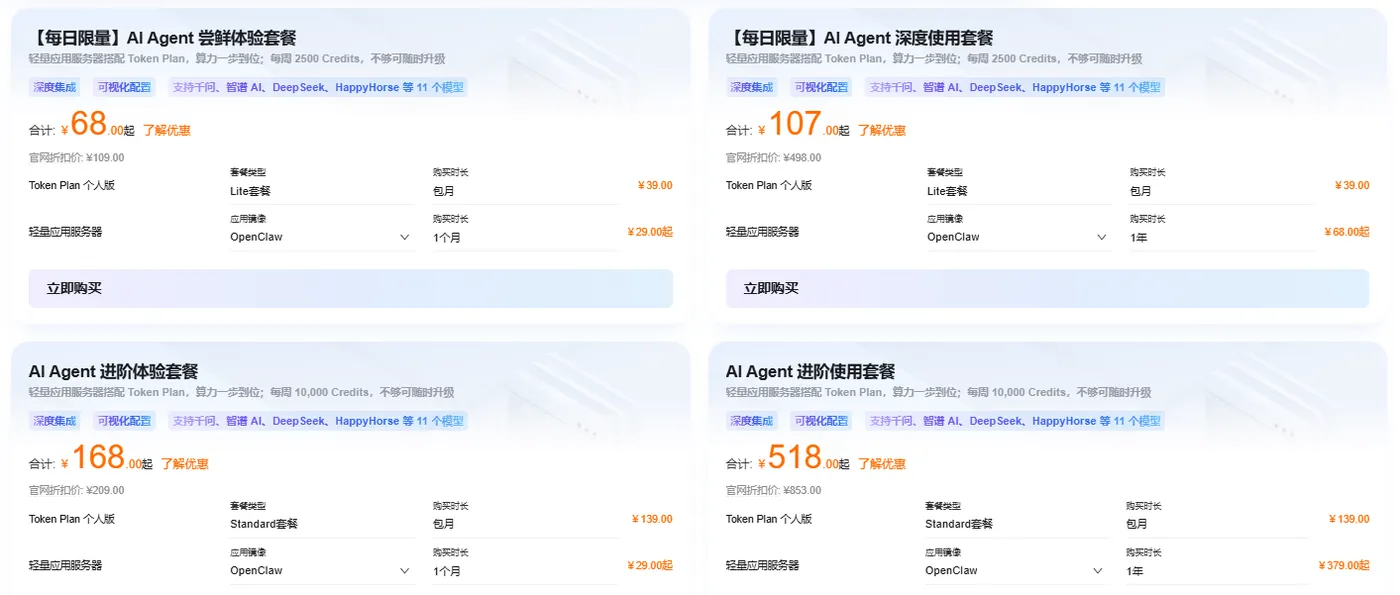
1. Agent 应用包(智能体专用型套餐)
- 内容:包含轻量应用服务器(2 vCPU / ≥4 vCPU)+ 预付费 Tokens 资源 + Agent 应用镜像(如 Dify、OpenClaw);
- 优势:一站式解决算力、模型、应用三层需求,适合零基础用户快速启动 AI 项目;
- 价格策略:按月/季/年订阅,年付享最高 7 折优惠,具体价格以控制台实时显示为准。
2. Agent 组合购:灵活搭配服务器与 Token Plan
阿里云支持用户分开选购轻量服务器与 Token Plan,实现更灵活的资源配置:
1、Agent应用开发包:2核2G,2亿Token/月,包月活动价262.5元/月(5折),包季活动价236.25 元/月(4.5折)Agent应用生产包:2核4G,4亿Token/月,包月活动价515元/月(5折),包季活动价463.5 元/月(4.5折)
2、Agent应用规模包:4核8G,8亿Token/月,包月活动价1160元/月(5折),包季活动价1044 元/月(4.5折)
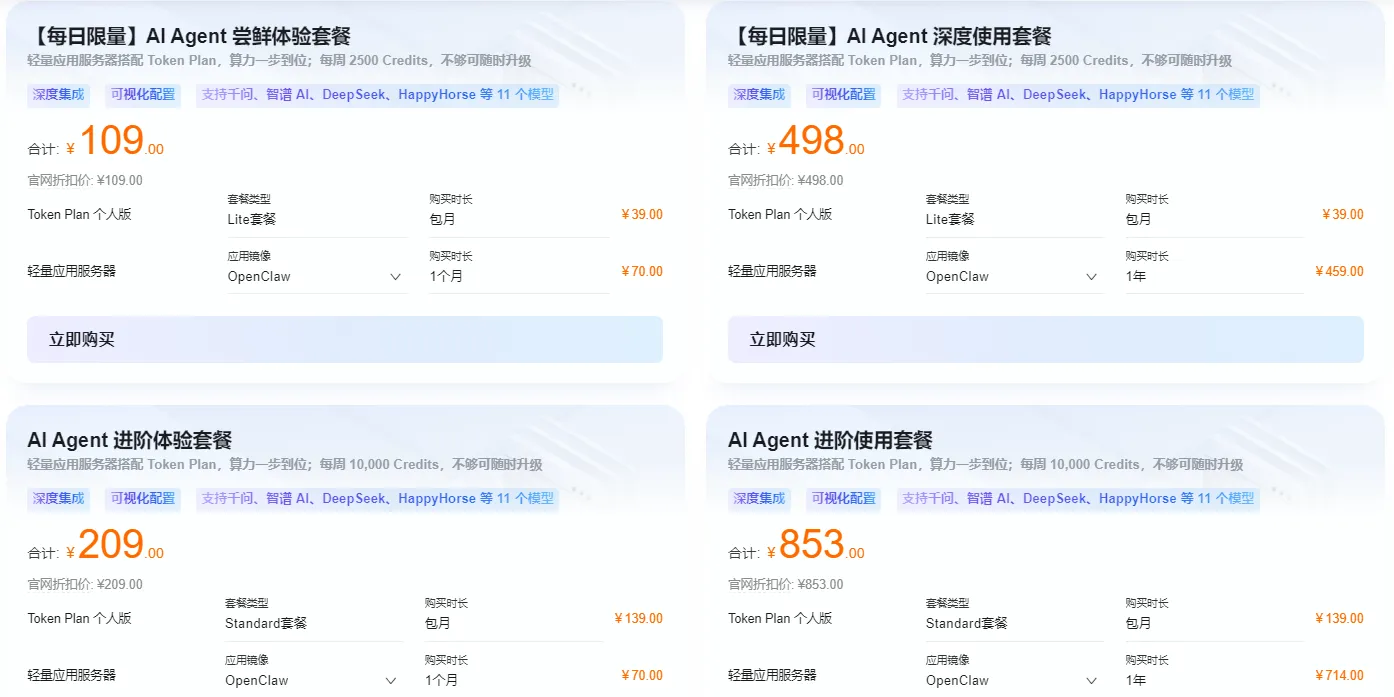
友情提示:购买之前,别忘了先领优惠券:https://t.aliyun.com/U/a23cv1 领了之后再买活动中的云产品,可以享受折上折。
综合来看,阿里云轻量应用服务器智能体专用型规格族,为个人开发者和中小企业的AI Agent落地提供了一条低门槛、高可控的轻量化路径。它把算力资源和预付费Tokens打包成一体化套餐,搭配预装的主流Agent应用镜像,让用户不用在多平台之间来回切换配置,几分钟就能完成专属AI助手的部署,全程成本透明可控。