大家好,我是晚安code。
学 Java 异步编程绕不开两个类:CompletableFuture 和 ForkJoin。我一开始先碰上 CompletableFuture,觉得「回调真香」;学到 ForkJoin,又觉得「分治好强」。可这俩都姓 Future,看着都在给并发提速,到底啥区别?好家伙,并发这条线是真学不完。

今天我把它们放一起讲:一个管「等」,一个管「算」。看完你就能分清什么时候该用哪个,代码都是能直接跑的示例。先收藏,我们开始。
一、为什么两个类都姓 Future
CompletableFuture 和 ForkJoin 都源自同一个接口:Future。这不是巧合,而是同一棵并发树上的两个分支——想搞懂 Java 异步编程,第一步就是认清它们共同的根。
Future:对「将来某个时刻才就绪的结果」建模的接口。你可以理解为一张「远期订单的存根」——结果还没到,但你手里已经有个凭据,可以等它、问它、取它。
早期的 Java 用 Future 做异步,但接口太简陋:想拿结果只能 get() 阻塞等,等到花儿都谢了。JDK 后来干脆做了两件大事,各自长出一条主线——
CompletableFuture:Java 8 引入的异步编程工具,实现了 CompletionStage 和 Future 两个接口,用回调把「结果还没好」和「结果好了怎么处理」彻底解耦。你可以理解为「外卖平台的实时订单」——出餐了自动通知你,不用在店门口干等。
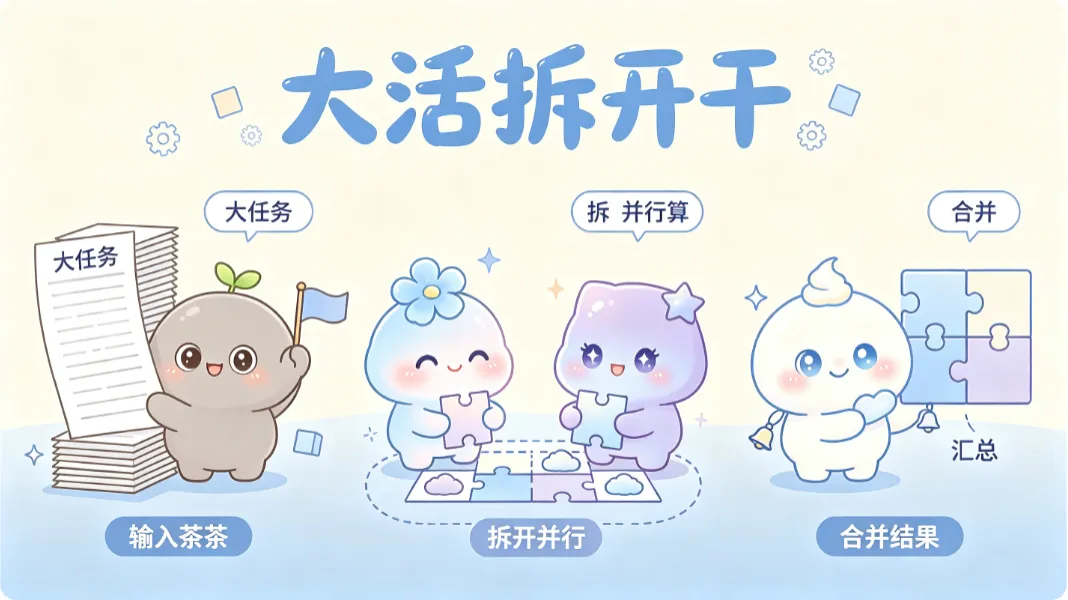
ForkJoin 框架:JDK 7 引入的并行计算框架,把大任务递归拆成小任务并行执行,再合并结果(分治思想)。你可以理解为「组长把大活拆给全组,各自算完汇总」。
两条主线分工非常清晰:CompletableFuture 优化的是「等」——结果没就绪,我不阻塞、挂回调;ForkJoin 优化的是「算」——任务太大,我拆成小块并行算。看这张对比图,一眼记住:
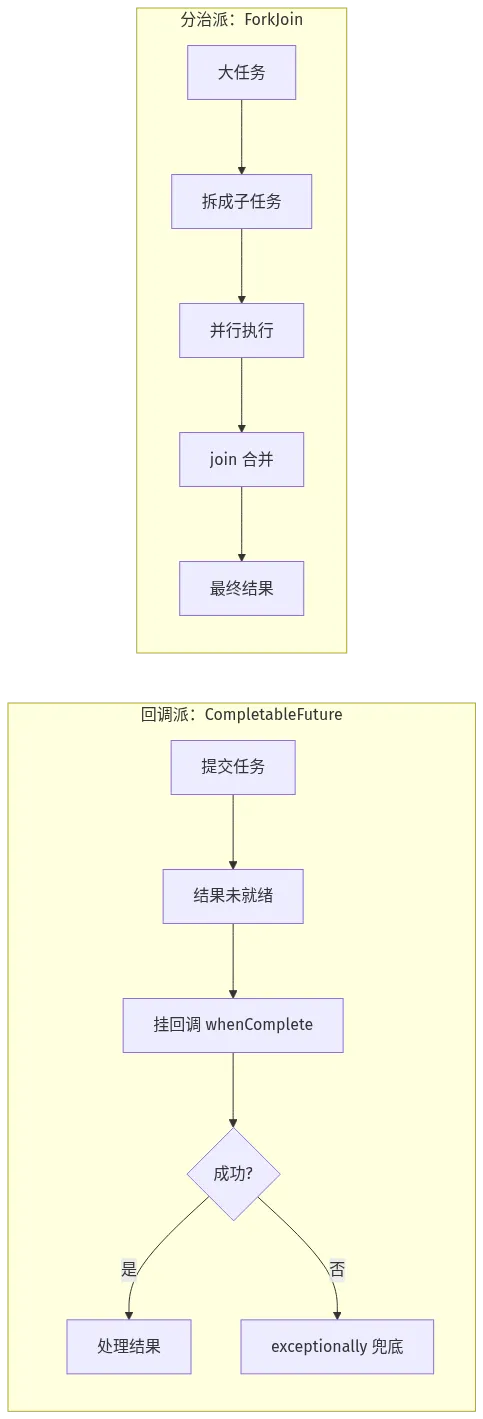
(图 1:Java 异步编程两大流派。以 JDK 8+ 为例,2026 年 8 月整理。)
二、CompletableFuture:结果没就绪,我选择不等
CompletableFuture 解决的核心问题,是「异步回调」——把提交任务和执行后的处理拆成两件事,结果好了自动回调,全程不阻塞主线程。
提交任务有两个入口:runAsync 和 supplyAsync。区别就一句话——有没有返回值。runAsync 干完就算完,返回 Void;supplyAsync 能返回一个结果,方便后面挂回调。下面这段是 runAsync 的用法(模拟发一条通知):
// runAsync:无返回值,跑完就行(模拟发一条通知)
CompletableFuture<Void> notify = CompletableFuture.runAsync(() -> {

    try {

        TimeUnit.SECONDS.sleep(2);            // 模拟耗时操作
    } catch (InterruptedException e) {

        Thread.currentThread().interrupt();
    }
    System.out.println(Thread.currentThread().getName() + " 通知已发送");
});
System.out.println("主线程先去干别的…");
notify.get();  // 阻塞拿结果
想要「真不阻塞 + 有返回值」,就看 supplyAsync 配合两个回调方法:whenComplete 无论成功失败都会回调,参数 t 是结果、u 是异常;exceptionally 在出错时给一个兜底值。
CompletableFuture<Integer> order = CompletableFuture.supplyAsync(() -> {

    System.out.println(Thread.currentThread().getName() + " 计算订单金额");
    return 200;                              // 模拟算出金额
});

Integer amount = order
    .whenComplete((val, err) -> {
               // 成功失败都会回调
        System.out.println("回调收到值 => " + val);
        System.out.println("回调收到异常 => " + err);
    })
    .exceptionally(e -> {
                       // 异常时给兜底值
        System.out.println("订单出错:" + e.getMessage());
        return -1;
    })
    .get();
System.out.println("最终金额:" + amount);
(代码适用于 JDK 8+,2026 年 8 月本地实测通过。)
第一次跑这段代码,我盯着控制台愣了半天:whenComplete 里明明没打印异常,get() 也没抛,怎么最后拿到的是 -1?后来才明白,exceptionally 返回的兜底值要走 get() 才能取到,异常在回调这一层就被「消化」掉了。这个坑,我替你踩过了。

图注建议:
来源:用户自生图(即梦/豆包/Midjourney)后替换为 PNG

可能有人会问:runAsync 和 supplyAsync 到底选哪个?
一句话:要返回值、想挂回调,用
supplyAsync;只是「跑个后台任务、不关心结果」,用runAsync就够了,省得多余包装。
三、ForkJoin:任务太大,就拆开并行算
如果说 CompletableFuture 在时间上做文章,ForkJoin 就是在空间上做文章。它的主场很明确:大数据量 + 计算密集——单线程算不动,就用分治拆成小块并行算,最后合并。
分治的核心就三步:拆(fork)→ 并行算 → 合(join)。以「计算 1 到 1 亿的累加」为例,任务会像这样一层层裂开,裂到足够小就直接算,结果再逐层并回去:

(图 2:ForkJoin 分治求和示意。)
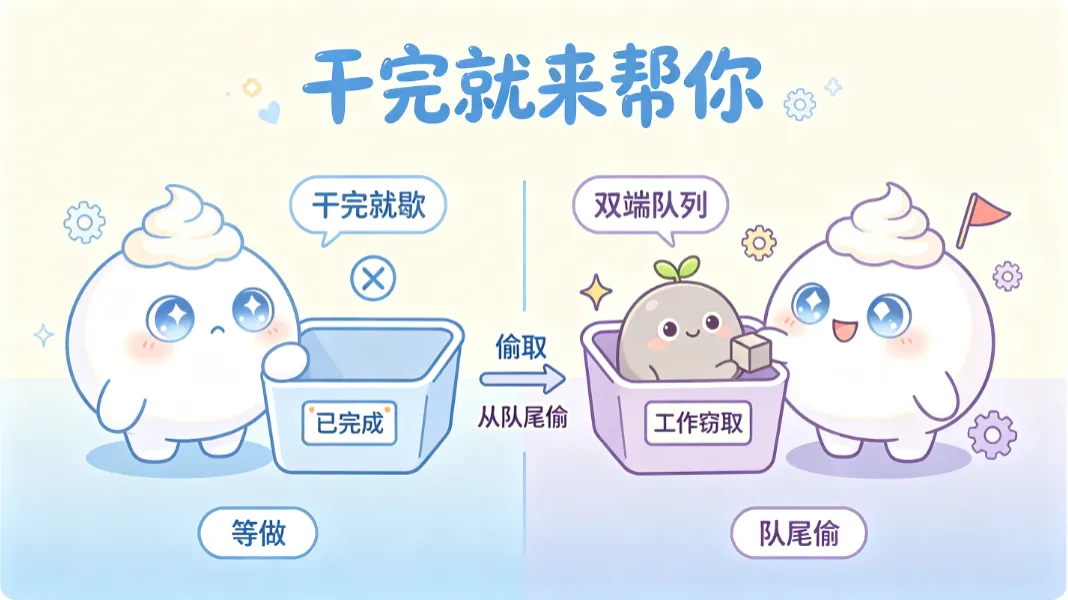
ForkJoin 能高效跑起来,靠的是一个机制:工作窃取(Work Stealing)。
工作窃取(Work Stealing):ForkJoinPool 的调度机制——每个线程维护自己的双端队列,任务从队头取;线程空闲时,从别的线程队列的队尾偷任务来执行。你可以理解为「同事干完自己的活,跑来帮你分担」。
我第一次看到「窃取」两个字,心里嘀咕:这不是明抢吗?后来才懂,双端队列队尾存的是还没被处理的任务,从队尾偷,不影响另一个线程从队头干活——两个线程各拿各的,谁也不堵谁。
要自己实现一个 ForkJoin 任务,得继承 RecursiveTask(有返回值)或 RecursiveAction(无返回值),重写 compute() 定义「怎么拆、怎么合」:
RecursiveTask:ForkJoin 框架里「有返回值的递归任务」抽象类,重写 compute() 写拆分与合并逻辑。你可以理解为「一张带薪分活的工单」。
任务类长这样(注意右半区间从 mid + 1 开始,否则中间值会被算两遍):
public class SumTask extends RecursiveTask<Long> {

    private final long start, end;
    private static final long THRESHOLD = 10_000L;
    public SumTask(long start, long end) {

        this.start = start; this.end = end;
    }
    @Override
    protected Long compute() {

        if (end - start <= THRESHOLD) {

            long sum = 0;
            for (long i = start; i <= end; i++) sum += i;
            return sum;
        }
        long mid = (start + end) / 2;
        SumTask left = new SumTask(start, mid);
        SumTask right = new SumTask(mid + 1, end);
        left.fork(); right.fork();
        return left.join() + right.join();
    }
}
再补一个入口跑起来(记得 import java.util.concurrent.*;):
import java.util.concurrent.ForkJoinPool;

long result = ForkJoinPool.commonPool()
        .invoke(new SumTask(1L, 100_000_000L));   // 1 到 1 亿
System.out.println("1+2+...+100000000 = " + result);
验证一下:1 到 1 亿的累加,套公式 n*(n+1)/2 算出来正好是 5000000050000000,分治没算错。
两个细节值得注意:
- 拆分时右区间从
mid + 1开始——我第一次抄笔记里的写法(start, mid)和(mid, end),对账怎么都对不上,就是中间值被加了两次。 fork()只是把任务压进队列,真正出结果靠join()阻塞等;拆太碎反而慢,阈值THRESHOLD要按数据量调,别照搬默认值。
四、一张对比表收尾:Java 异步编程该选哪个
两条主线各自服务的场景完全不同,别混着用。
| 对比项 | CompletableFuture | ForkJoin |
|---|---|---|
| 核心解决的问题 | 结果没就绪时怎么「不等」 | 任务太大怎么「拆着算」 |
| 适合场景 | IO 密集、异步回调、任务编排 | CPU 密集、大批量计算 |
| 关键机制 | 回调(whenComplete / exceptionally) | 分治 + 工作窃取 |
| 有无返回值 | 都可以,回调链处理 | 递归子任务,join 合并 |
| 典型入口 | supplyAsync / runAsync | ForkJoinPool + RecursiveTask |
可能有人会问:这俩能混着用吗?
能,而且经常一起出现——比如 ForkJoin 算完一批数据,每个结果再用 CompletableFuture 异步落库。但各自的「主场」别搞反:小任务、IO 等待多,用 CompletableFuture;计算量巨大、能拆成独立子问题,才轮到 ForkJoin。
我的态度很明确:日常业务里,异步回调用得远比 fork/join 多;ForkJoin 是为大数据量计算的场景准备的,别为了炫技去拆一个几万次的循环——拆任务、偷任务都有开销,数据量小的时候,一个普通 for 循环反而是最快的。
一句话总结:CompletableFuture 管「不等」,ForkJoin 管「拆算」,它俩不是竞品,是 Java 异步编程一左一右两条腿。搞清楚了,面试问起来也不虚。
我是晚安code,持续分享编程干货。觉得有用的话记得点赞收藏和关注~也欢迎在评论区聊聊:你学 CompletableFuture 和 ForkJoin 时踩过什么坑?Java 异步编程里更常用哪一个?