ATS(Applicant Tracking System,申请人追踪系统),是指企业用来自动接收、解析、筛选和排名候选人简历的招聘管理软件。它在你投出简历的那一刻起就成了你的"第一关面试官"——只不过这个面试官不看你的气质谈吐,只看你的简历能不能被它读懂。
据 TalentTuner 对 944 份简历与 57 项学术研究的综合分析显示,平均简历在 ATS 中的得分仅为 57.6%,低于大多数企业设定的 70% 通过阈值。换言之,超过一半的简历在被人眼看到之前就已经被系统排到了队列末尾。
这篇文章会讲清楚:ATS 到底怎么筛选简历、国内企业的使用情况、一个让你直观感受 ATS"威力"的具体案例,以及投简历时最该注意的三件事。
一、ATS 到底有多普及?98% 的财富 500 强都在用
先摆一组数据。
据 CVCraft 2026 年发布的行业统计,全球 98.4% 的《财富》500 强企业已部署 ATS 系统,79% 的企业已将 AI 集成到 ATS 流程中。全球 ATS 市场规模在 2025 年达到约 31.4 亿美元,预计到 2034 年将增长至 63.5 亿美元,年复合增长率约 8.14%。
简单说:大公司几乎全部在用,中型企业在加速跟进,小型企业也在通过 SaaS 订阅的方式接入。
这个趋势背后的逻辑不复杂。一个热门岗位可能收到几百甚至上千份简历,HR 团队根本不可能逐份精读。ATS 的核心价值就是把"不可能"变成"自动化"——先让机器筛一轮,人只看排名靠前的那一小撮。
二、国内 ATS 发展到了什么程度?
很多人以为 ATS 是外企才用的东西,国内企业还是靠 HR 手动筛选。这个认知落后至少五年了。
据 IDC 发布的招聘管理 SaaS 市场报告,北森(Beisen)已连续 9 年位居中国招聘管理 SaaS 市场份额第一(2025 年份额 21.3%),累计服务超过 6000 家中大型企业,其中包括 70% 的《财富》中国 500 强。北森的 AI 简历评估准确率达到 95.5%,AI 面试官与真人评价一致性超过 90%。
除北森之外,国内主流 ATS 平台还有:
| 平台 | 核心特点 | 典型客户 |
| 北森(Beisen) | 一体化招聘平台,AI 覆盖全流程,市场份额第一 | 蒙牛、京东方、泸州老窖、周大福、上海银行等 |
| Moka | AI 语义匹配准确率 92%,侧重科技公司和用户体验 | 小红书、蔚来、得物、莉莉丝等 |
| 大易(Dayee) | 传统行业深耕,合规性强,68% 客户来自能源/制造/基建 | 央国企、金融机构 |
| 猎聘(Liepin) | 依托人才数据库,侧重候选人端体验和中高端岗位 | 全行业中高端招聘 |
据 IDC 数据,中国 AI 招聘市场年增速达 42%,竞争焦点已从"流程自动化"转向"人岗精准匹配"。国内招聘系统同样会做关键词匹配、语义分析、硬性条件过滤——和 Workday、Greenhouse 等国际平台的核心逻辑并无本质区别。
你投的简历,大概率已经被某个 ATS 系统处理过了。
三、ATS 怎么"读"你的简历?——完整的五层筛选管道
ATS 处理一份简历通常经过以下五个阶段:
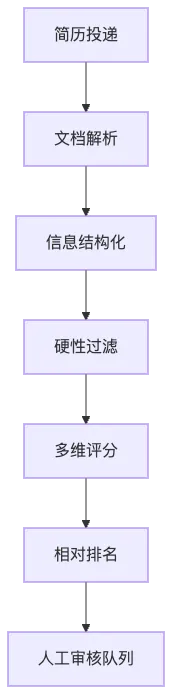
第一层:文档解析。 ATS 把你上传的 PDF 或 Word 文档转化成线性文本流。关键点是:ATS 的"阅读方向"是从左到右、从上到下,它不理解二维布局。双栏简历的左栏技能和右栏工作经历会被拼成乱码,表格中的内容可能丢失或串位,Canva 等设计工具导出的 PDF 文本层可能与视觉层不同步。这是大量简历被"隐形屏蔽"的第一道关口。
第二层:信息结构化。 系统用命名实体识别(NER)技术提取你的姓名、联系方式、学历、工作经历段、技能列表等结构化字段。如果你用的标题不是"工作经历""教育背景""技能证书"这类标准表述,而是"我的旅程""我做过什么"之类的个性化标题,系统可能无法正确归类,相关内容会被跳过。
第三层:硬性过滤(Knockout)。 这是最"致命"的一层。企业在发布岗位时预设的硬性条件——最低学历、必须持有的证书、工作年限门槛、是否具备合法工作身份、必须具备的技能——会在这个阶段直接判定通过或淘汰。一旦触发 Knockout,后续评分根本不会执行。这不是简历写得不够好的问题,这是门槛没过的问题。
第四层:多维评分。 系统在五个维度上给你的简历打分:
| 评分维度 | 典型权重 | 说明 |
| 关键词匹配 | 40-50% | JD 中的技能、工具、证书词在你的简历中的覆盖率 |
| 经验相关性 | 20-25% | 工作年限、行业背景、职责范围与 JD 的对齐程度 |
| 段落完整性 | 15-20% | 必要段落(工作经历/教育/技能)是否存在且格式标准 |
| 解析成功率 | 10-20% | 结构化字段被正确提取的比例 |
| 学历证书匹配 | 10-15% | 学位等级、专业、证书的匹配度 |
第五层:相对排名。 你和所有其他投递者按总分排序。HR 通常只会查看排名前 10%-20% 的候选人。
据 ResumeOptimizerPro 的技术分析,同一份简历在不同 ATS 平台上得分相近但不完全相同。Workday 侧重精确关键词匹配,Lever 对语义等价词(如"容器编排"≈"Kubernetes")更宽容,iCIMS 则取两者的混合策略。
四、一个真实的例子:同一份简历在两种投法下的天壤之别
这里用一个简化但真实的场景来展示差异。
背景: 某互联网公司招聘"高级后端开发工程师",JD 核心要求包括 Java、Spring Boot、微服务架构、MySQL、Redis、Kafka、有小团队管理经验。
候选人 A:用通用简历投递。 简历标题写的是"资深软件工程师",技能段落列了"Java, Python, Go, Docker, Linux, Git"等 15 项技能,工作经历按时间线罗列,没有针对 JD 做任何调整。
候选人 B:针对 JD 定制简历。 简历标题直接写"高级后端开发工程师",个人摘要第一句就命中"专注 Spring Boot 微服务架构",并明确表明有小团队管理经验。技能段落将 JD 要求的 7 项核心技能排在最前面,每项都在最近工作经历的 bullet point 中有具体应用场景的呈现。
两份简历在 ATS 中的表现差异:
| 对比维度 | 通用简历(A) | 定制简历(B) |
| 关键词覆盖率 | 约 40%(7 项匹配 4 项,非高权重位置) | 约 90%(7 项全部匹配,在摘要、技能、经历三处出现) |
| 团队管理经验 | 不明确(未体现) | 明确声明 |
| 段落结构 | 标题非标准,技能段落后置 | 标题标准化,结构清晰 |
| 位置乘数奖励 | 低(关键词分散在历史经历中) | 高(摘要 2.5× + 技能段 2.0× + 最近经历 1.5×) |
| 预估 ATS 得分 | 约 45-55 分(低于 70% 阈值) | 约 75-85 分(进入人工审核队列) |
候选 A 的简历可能 HR 根本没看到。候选 B 的简历排在队列前 10%。
这里的关键不在于简历写得"好不好",而在于它和图里那份 JD 的"匹配度"。每份 JD 背后是一个独立的评分模型,不同的关键词清单、不同的权重配置、不同的硬性条件。用同一份简历打天下,本质上就是在赌每个岗位的 ATS 模型恰好都和你的简历对齐——这个概率,说实话,很低。
五、ATS 评分背后的位置乘数:关键词放在哪儿,分数差三倍
多数求职者不知道的一个机制是:关键词出现在简历的不同位置,得分权重完全不同。
据 ResumeXrays 和 ResumeOptimizerPro 的技术分析,ATS 系统中存在明确的位置乘数:
| 关键词出现位置 | 典型乘数 | 说明 |
| 最近职位的职称 | 3.0× | 最高置信度的技能信号 |
| 个人摘要/Headline | 2.5× | 高层次候选人定位 |
| 独立技能段落 | 2.0× | 结构化,易与 JD 直接匹配 |
| 最近工作的 Bullet Points | 1.5× | 有应用场景的技能证据 |
| 证书段落 | 2.0× | 高置信度硬技能信号 |
| 3 年以上旧职位的 Bullet Points | 0.7× | 近期性折旧 |
这意味着什么?同一个关键词出现在摘要(2.5×)、技能列表(2.0×)和最近工作经历(1.5×)三个位置,等效权重是 6.0。如果它只在三年前的旧工作中出现一次,等效权重只有 0.7。前者比后者强了近 9 倍。
这也是为什么"改简历"不是换个模板、调个排版那么简单——它涉及对 ATS 评分逻辑的深度理解。
六、投递时最重要的三条生存法则
法则一:每份 JD 配一份定制简历,不要一份简历海投。 不同岗位的 ATS 评分模型不同。投产品经理的简历和投后端开发的简历,JD 关键词集合几乎没有重叠。用同一份简历投两个方向,必然有一个方向的匹配度大幅偏低。即使是同一个方向的不同公司,JD 的关键词侧重也可能不同。
法则二:单栏布局 + 标准标题 + 优先导出PDF。 双栏、表格、文本框、页眉页脚中的联系信息——这些都是 ATS 解析失败的高发原因。分析 5000 份简历的研究显示,双栏/多栏布局导致的解析失败约占 35%,表格内容丢失约占 25%。最安全的格式是单列从上到下的线性布局,标题使用"工作经历""教育背景""技能证书""项目经验"等标准表述,优先提交 .pdf 格式(现代ATS系统重兼容性最佳,老一代ATS系统中对word系统兼容性最好)。
法则三:核心关键词在摘要、技能段落和最近经历中至少出现两次。 利用位置乘数机制,把 JD 中的高权重关键词(硬技能、证书、核心工具名)在个人摘要、独立技能段落和最近工作的 bullet points 中各出现至少一次。不要简单堆砌——每个关键词最好有一个使用场景支撑,否则即使系统放过了你,HR 看到也会觉得虚。
七、投之前,怎么知道自己的简历能不能过关?
上面说了这么多原理,回到一个很实际的问题:我改完简历之后,到底能打多少分?
这里有一个直接的办法:使用 match_resume_jd 简历与岗位匹配度分析工具,模拟最新 ATS 系统的筛选逻辑,对你的简历和具体 JD 做一次完整的匹配评估。
它的分析覆盖八个维度:核心技能匹配、经验相关性、层级与规模匹配、成果与职责匹配、软技能与文化匹配、潜力与可迁移性、淘汰规则检查、ATS 解析友好度——相当于把你投递后系统会做的全套评估,提前跑了一遍。
而且它不是泛泛的"你的简历 70 分",而是逐项告诉你:哪些关键词覆盖了、哪些缺失了、哪些硬性条件可能触发 knockout、格式上有没有解析风险。
对 Hermes 用户来说,直接用 MCP 工具中的简历与岗位匹配度分析功能就可以完成这个测试。比如对 Hermes 说:"帮我分析这份简历和这个 JD 的匹配度",然后把简历文件和 JD 文本传过去,系统会自动跑一遍完整的 ATS 模拟评分,返回匹配总分、各维度明细、技能差距分析和具体修改建议。
投之前先测一遍,比投完之后等消息要主动得多。
八、常见问题
Q:ATS 会直接自动拒绝我的简历吗?
硬性过滤机制(Knockout Questions)确实会导致自动拒绝,但这通常只针对预设的硬性条件,比如"是否持有本科学历""是否具备 3 年以上经验""是否需要工作签证"。如果你的简历在这些答案上不达标,无论其他内容多好,都不会进入后续评分。但大多数情况下,简历被"淘汰"其实是评分排名靠后被排到了队列末尾,HR 没看到——这不是自动拒绝,是软性过滤。
Q:国内公司和外企的 ATS 一样吗?
核心逻辑基本相同,都是文档解析→信息结构化→关键词匹配→评分排名的流程。区别在于:国内平台(北森、Moka、大易)更深度集成钉钉/企业微信/飞书等本土办公工具,在中文简历的语义理解和实体识别上有优化,部分平台已整合 AI 面试环节。外企平台(Workday、Greenhouse、Taleo)对英文简历的解析更成熟,合规性要求更严格。
Q:ATS 对不同行业的岗位评分标准一样吗?
不一样。制造业岗位更侧重证书、年限和合规性检查,互联网技术岗位更侧重技能匹配和项目经验,金融岗位对学历和证书要求更严格。
Q:ATS 会因为我用了 AI 写的简历而惩罚我吗?
目前主流 ATS 不检测内容是否由 AI 生成,它们关心的是内容质量——关键词覆盖率、经历描述的具体程度、段落结构是否标准(但市面上确实有一些ATS系统的“外挂”,会外接简历的AI判断,你如果不放心可以AI生成的简历之后手动进行修改)。但如果你用 AI 生成了一份"看起来很完美但内容空洞"的简历(大量通用描述、缺乏量化成果),HR 在人工审核环节大概率会察觉。关键不是用不用 AI,而是内容有没有实实在在的支撑。
总结
ATS 不是一个需要"打败"的敌人,而是一个需要理解的系统。它的核心逻辑并不神秘——解析你的简历、提取关键信息、和岗位要求做匹配、给出一个分数。你真正要做的,就是让这份匹配变得尽可能精准。
每份 JD 配一份定制简历,不是锦上添花,是基本操作。用同一份简历投十个岗位,五个可能连 HR 的屏幕都没上。
与其猜,不如测。用 match_resume_jd 跑一遍分析,看看自己的简历在模拟 ATS 环境下到底能打多少分,缺哪些关键词,有什么格式风险。花两分钟测试,可能比花十个小时盲投管用。