一个简单的agentic loop就是一个
while
循环,LLM 在其中决定做什么、执行工具、观察结果、再做决定。
这模式能用是可以用的不过有个最大的问题,就是费钱:

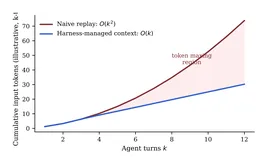
一个三 agent 查询要是用 agentic loop那么7 次 LLM 调用,4.2 秒,0.12 美元。如果用 orchestrator的话 2 次 LLM 调用,1.1 秒只要0.03 美元。同样的 agent同样的答案,却便宜 70%。
循环每转一圈就是一次 LLM 调用。每次调用多花 300-800ms 延迟和钱。简单的"调 check_greeting,再调 handle_hi",两次 LLM 路由没问题,但是
- 为单个答案并行调三个 agent
- 执行顺序计划,步骤 2 依赖步骤 1
- 在生产中扛每秒几百个请求
agentic loop 就撑不住了。LLM 卡在每次决策的关键路径上,每次决策都会延迟。
所以最简单的方法就是,让 LLM 只规划一次然后不靠它执行
Orchestrator 模式只需要两次调用,不是十次
整个架构三步:
 User Query
    ↓
[STEP 1: ROUTE]     ← 一次 LLM 调用:"哪些 agent 来处理?"
    ↓
[STEP 2: EXECUTE]   ← 无 LLM:确定性调用 agent
    ↓
[STEP 3: SYNTHESIZE] ← 一次 LLM 调用:"把结果写成好答案"
    ↓
 Final Answer
LLM 两请求——一次定计划,一次写答案。中间全是应用代码在跑。没有循环,也没有不确定性,没有"LLM 会不会又调一个工具?"这样的问题。
一个处理三种查询类型的 orchestrator大概如下:

- 单 agent——"当前系统指标?"→ 路由到一个 agent
- 并行扇出——"给我指标和趋势分析"→ 同时调两个 agent
- 顺序 DAG——"检查异常,有则拉配置"→ 按依赖顺序调 agent
同样的 agent同样的工具,但 LLM 只做一次路由决策,剩下全是应用执行。
Agent 注册表作为发现协议
Agent 用一个简单的字典注册能力。不需要发现协议——你自己部署的 agent,你知道它们能做什么:
 REGISTRY = {
    "data_agent__get_report": {
        "agent": "Data Agent",
        "description": "Fetch the latest report for a given entity",
        "execute": get_report,
    },
    "analytics_agent__get_trends": {
        "agent": "Analytics Agent",
        "description": "Get historical trends and anomaly detection",
        "execute": get_trends,
    },
    "config_agent__check_config": {
        "agent": "Config Agent",
        "description": "Check system configuration for a given component",
        "execute": check_config,
    },
 }
线上部署时注册表放在 Redis 或数据库里,agent 通过 HTTP POST 注册。模式一样——技能名到执行函数的查找表。
LLM 把 agent 看成工具定义(JSON schema),但关键在第四个元工具:
 {
    "name": "plan_execution",
    "description": "Use this ONLY when the query requires sequential steps "
                   "where a later step DEPENDS on the result of an earlier step.",
    "parameters": {
        "properties": { "reason": {"type": "string"} },
        "required": ["reason"]
    },
 }
plan_execution 不调任何 agent——它什么都不做。它是一个信号不是函数。LLM 选中它时,orchestrator 知道该切到顺序模式了。一次 LLM 调用、一组工具选择、三种执行策略——单 agent、并行、顺序——全由返回的工具决定。
第一步:一次 LLM 调用统管的路由器
路由器用 temperature=0.0(确定性)做一次 LLM 调用。LLM 唯一的工作是选工具。明确告诉它不要回答问题。
 SYSTEM_PROMPT = """You are a query router. Your ONLY job is to decide which tool(s) to call.

Rules:
- If the query needs ONE agent, call that one tool.
- If the query needs MULTIPLE INDEPENDENT agents, call all of them.
- If the query needs steps IN ORDER, call plan_execution.

 Do NOT answer the user's question — just pick tools."""
单次调用:
 response = client.chat.completions.create(
     model=deployment,
     messages=[{"role": "system", "content": SYSTEM_PROMPT},
               {"role": "user", "content": query}],
     tools=TOOL_DEFINITIONS,
     tool_choice="auto",
     temperature=0.0,
 )
整个路由逻辑非常简单
 tool_names = [tc.function.name for tc in reply.tool_calls]

 if "plan_execution" in tool_names:   → mode = "sequential"
 elif len(tool_names) == 1:            → mode = "single"
 else:                                 → mode = "parallel"
LLM 返回结构化的工具调用,一个工具→单 agent。多个工具→并行。plan_execution 元工具→顺序。一次调用,三种策略。
第二步:不需要 LLM的执行器
这是 orchestrator 真正省成本的地方。执行器是纯 Python——没有 LLM、没有不确定性、没有延迟炸弹。三种模式:
Single——直接跑 agent:
result = REGISTRY[tool_name]["execute"]()
Parallel——同时跑所有 agent:
 with concurrent.futures.ThreadPoolExecutor() as pool:
     futures = {name: pool.submit(REGISTRY[name]["execute"]) for name in tool_names}
     results = {name: f.result() for name, f in futures.items()}
Sequential——按顺序跑,传递上下文:
 for step in plan:
     results[step["tool"]] = REGISTRY[step["tool"]]["execute"]()
零 LLM 消耗,所以线上部署时换成 asyncio.gather 加 HTTP 调用就行。
路由之后系统就和其他微服务编排没区别。延迟可预测,调试直来直去,可观测性用标准工具就够。"AI"被压到两层(路由和合成)里,中间全是确定性的执行,也方便调试。
第三步:润色答案的合成器
Agent 输出的是 JSON,用户要的是自然语言。再来一次 LLM 调用把数据转成响应:
 response = client.chat.completions.create(
     model=deployment,
     messages=[
         {"role": "system", "content": "Summarize the agent results into a clear, helpful answer."},
         {"role": "user", "content": f"User asked: {query}\nResults: {json.dumps(results)}"},
     ],
     temperature=0.7,
 )
注意路由用 0.0、合成用 0.7是因为路由要精确,合成要可读。不同的工作所以需要不同参数。
三种查询,三种模式
完整管道就三个函数调用:
 decision = route_query(client, deployment, query)       # LLM 调用 1
 results  = execute(decision)                            # 无 LLM
 answer   = synthesize(client, deployment, query, results)  # LLM 调用 2
查询 1——Single:"当前系统指标?"→ 路由器选 data_agent__get_report → 执行器调它 → 合成器写摘要。
查询 2——Parallel:"给我指标和趋势分析"→ 路由器选两个 agent → 执行器同时调 → 合成器合并结果。
查询 3——Sequential:"检查异常,有则拉配置"→ 路由器选 plan_execution → 执行器先跑 analytics 再跑 config → 合成器解释链条。
同一个管道,三种执行策略,始终是两次 LLM 调用。

总结
Agentic loop 把 LLM 同时当大脑和手——每步既决策又执行。Orchestrator 把两者拆开:
- LLM = 大脑 → 定计划(一次调用)
- 应用 = 手 → 执行计划(确定性)
- LLM = 嘴 → 解释结果(一次调用)
这套分离就是 orchestrator 能扩的原因。"大脑"(路由)可以缓存——相同查询在 temperature=0.0 下始终走相同路由。"手"(执行)就是 HTTP 调用。"嘴"(合成)是唯一的创造步骤。线上场景里,API 消费者如果要原始 JSON,连合成那一步都能省——压到每个请求一次 LLM 调用。
所以Agentic loop 适合前期的探索工作,而Orchestrator 适合生产。
https://avoid.overfit.cn/post/8c270e259b2a4172ac95d38d9ab68211
by Amogh Ubale