大模型时代,断言还管用吗?AI 系统测试的结构性变革

简介: 本文探讨AI系统测试的范式变革:大模型、RAG与Agent等新型系统具有概率性、黑盒性与非确定性,使传统“输入→输出→断言”模式失效。测试需从功能验证转向质量评估,构建分层模型与量化指标体系,测试工程师正升级为概率系统评测体系的设计者。

概率性 · 黑盒性 · 非确定性 · 从功能验证到质量评估

在传统软件测试中,有一个几乎不被质疑的逻辑:

输入确定 → 输出确定 → 断言成立。

但当测试对象变成大模型系统、RAG 应用、Agent 系统时——

这个逻辑开始松动。

问题不是断言错了。

问题是:

系统本身已经不是“确定性系统”。

测试工程正在经历一次结构性变革。

目录
AI 系统测试为什么是一个新问题
传统软件测试的确定性结构
AI 系统的结构性差异
断言思维为何天然失效
AI 系统的三大核心特征
大模型系统的测试分层模型
AI 测试的评测指标体系
从功能测试到概率系统评估

  1. AI 系统测试为什么是一个新问题
    当前企业系统越来越多接入:

大模型能力
RAG 知识检索
Agent 决策逻辑
MCP 工具调用
测试对象已经不再是单一规则系统。

而是:

规则系统 + 概率模型 + 检索系统 + 工具执行链路。

测试复杂度不是线性增加,而是结构升级。

  1. 传统软件测试的确定性结构
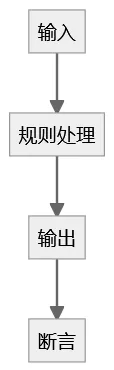
    传统系统的结构非常清晰:

14ef0d21-e26c-415d-8b1c-55f8317a9a92.png

特征:

输入结构化
规则可追溯
输出可预测
断言明确
测试人员的核心能力:

验证规则是否正确实现。

  1. AI 系统的结构性差异
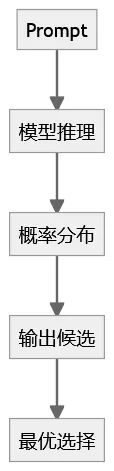
    AI 系统结构更接近:

40bc3e7d-8eae-491a-9dcc-ba64ce67de2f.png

区别在于:

输出来自概率分布
同样输入可能多种结果
推理路径不可解释
这不是异常,这是设计本身。

  1. 断言思维为何天然失效
    在传统系统中:

assert actual == expected

在大模型系统中:

expected 可能不是唯一。

例如:

输入:“写一首唐诗。”

测试难点:

内容是否符合唐诗体裁?
是否押韵?
是否符合平仄?
是否真实存在?
断言逻辑不再是“等于判断”。

而是:

质量判断。

这就是结构变化带来的根本影响。

  1. AI 系统的三大核心特征
    1)概率性
    模型输出是概率分布中的一个结果。

多次运行可能不同。

2)黑盒性
内部决策路径不可解释。

测试只能基于输入输出分析。

3)非确定性
相同输入,在不同温度、不同上下文下可能产生不同输出。

这三个特征直接打破传统测试假设。

  1. 大模型系统的测试分层模型
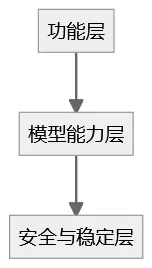
    如果从工程视角看,AI 系统测试可以分三层。

935e860f-c1a7-48a8-9bd0-66afbfc37960.png

第一层:功能层
接口是否可用
参数是否传递正确
工具调用是否成功
这一层仍然可以用传统方法测试。

第二层:模型能力层
意图识别准确率
语义理解正确率
RAG 检索命中率
幻觉率统计
这一层必须引入数据集测试。

第三层:安全与稳定层
Prompt 注入测试
越权访问测试
长上下文稳定性
输出合规性
这一层属于 AI 专项测试。

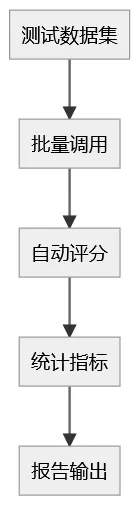
  1. AI 测试的评测指标体系
    如果没有指标,只是体验式测试。

建议至少建立:

准确率(Accuracy)
一致率(Consistency Rate)
幻觉率(Hallucination Rate)
意图识别成功率
RAG 命中率
输出稳定波动率
示意:
c887967f-d3e6-4434-90fd-bc07f5ee5b5c.png

AI 测试的核心不是单次执行。

而是统计。

  1. 从功能测试到概率系统评估
    传统测试工程关注:

规则正确性。

AI 测试工程关注:

概率系统质量。

测试角色从:

断言编写者

转变为:

评测体系设计者。

这意味着测试工程的能力重心改变:

数据集构建能力
评测框架设计能力
指标建模能力
风险识别能力
这不是工具升级。

这是思维升级。

结语
大模型时代,断言没有消失。

它只是从“相等判断”变成“质量评估”。

测试对象从规则系统变为概率系统。

如果测试方法不升级, 测试结论就会失真。

未来真正有竞争力的测试工程师,不是最会写断言的人。

而是:

最理解概率系统结构的人。
相关文章
|
8月前
|
机器学习/深度学习 人工智能 自然语言处理
AI系统测试 vs 传统软件测试:当“断言思维”失效,测试工程师该如何转型?
本文探讨AI系统测试的本质变革:当产品本身是大模型等概率系统时,传统基于确定性因果的测试方法已失效。文章剖析了因果断裂、断言失灵等核心挑战,指出测试需从“验证输出是否等于预期”转向“评估质量是否满足约束”,并提出多样本回归、Prompt稳定性、幻觉检测等新方向。
|
9月前
|
监控 测试技术 持续交付
大模型测试怎么做?从模型评估、幻觉检测到 RAG 系统测试全指南
本指南系统讲解大模型测试全流程:涵盖多维度评估(私有评测集构建、指标选择)、幻觉检测(事实核查、一致性与对抗测试)、RAG分层验证(检索/生成/端到端),以及持续集成实践与避坑指南,助力团队落地可靠评估体系。
|
人工智能 JavaScript 开发工具
DeepSeek Harness 本地安装与使用指南
DeepSeek Harness(DSH)是DeepSeek AI开源的Agent运行框架,支持本地文件操作、命令执行与工具调用。基于Cordis插件架构,具备高扩展性与强可控性,适合开发者搭建可控Agent环境或开展模型基准测试。当前为开发者预览版,需Node.js环境,推荐先用`npx @deepseek-ai/dsh web`快速体验。
8941 17
|
2月前
|
机器学习/深度学习 人工智能 自然语言处理
2026测试Skill大爆发:从“会写脚本”到“会设计智能体”
2026年测试行业正经历结构性变革:手工测试需求降47%,全栈测开增340%。“熟悉MCP协议”“具备Skill封装与工程化能力”已成硬性门槛,而非加分项。测试核心正从“写脚本”跃迁为“设计智能体”——验证对象由功能转向AI决策能力,底层资产从用例库升级为可复用Skill库。
|
8月前
|
人工智能 安全 测试技术
AI智能体的测试流程
AI智能体测试重在验证“受控随机性”与“逻辑链完整性”,区别于传统确定性测试。涵盖单元(提示鲁棒性、工具调用、RAG)、推理链、性能成本、黄金集回归、安全红队及UAT/A/B六大维度,确保智能体可靠、安全、高效落地。(239字)
|
9月前
|
缓存 自然语言处理 搜索推荐
大模型上线前,我们到底该怎么测?一份来自一线的检查清单
本文分享大模型对话功能上线前的实战测试经验,直击“无标准答案、状态无限、结果不可复现、判断主观”四大难点,提炼出覆盖功能、性能、安全、体验的六类测试清单及红黄绿三色上线准入标准,助力同行少踩坑、稳上线。
|
3月前
|
人工智能 供应链 测试技术
大厂不要“点点点”的人了——2026秋招测试岗JD已经彻底重构,你的技能跟上了吗?
2026秋招测试岗已巨变:告别“点点点”,转向“建系统+控风险+懂AI”。手工测试需求降47%,全栈测开岗暴增340%。大厂面试直问Agent兜底、RAG验证、质量门禁设计——你不是找Bug的人,而是用代码和工程能力守护质量的开发者。
|
4月前
|
人工智能 监控 Java
全栈测开岗位需求暴增340%:2026秋招最硬核的“版本答案"
2026年测试行业正经历颠覆性变革:AI已覆盖80%回归测试,手工测试岗需求骤降47%。传统“黑盒测试”能力贬值,全栈测开(懂后端+AI+Agent)成新刚需,薪资溢价30%-50%。核心转变是从“验证功能”到“验证AI系统能力”,需掌握Skill封装、MCP协议与Agent验证体系。
|
4月前
|
人工智能 前端开发 算法
别再只盯着Java八股文!大模型时代,测试岗面试题已经彻底变了
2026年测试面试已巨变:告别Java八股与LeetCode,转向AI工程能力实战。大厂聚焦Agent异常处理、Harness驾驭工程、大模型幻觉测试等真场景问题,考察候选人对AI系统的设计、落地与质量保障能力——不会建测试Agent,就难进一线团队。
|
人工智能 自然语言处理 测试技术
从人工到AI驱动:天猫测试全流程自动化变革实践
天猫技术质量团队探索AI在测试全流程的落地应用,覆盖需求解析、用例生成、数据构造、执行验证等核心环节。通过AI+自然语言驱动,实现测试自动化、可溯化与可管理化,在用例生成、数据构造和执行校验中显著提效,推动测试体系从人工迈向AI全流程自动化,提升效率40%以上,用例覆盖超70%,并构建行业级知识资产沉淀平台。
从人工到AI驱动:天猫测试全流程自动化变革实践

热门文章

最新文章