线程池初始化严禁使用Executors

简介: 阿里巴巴代码规范禁止使用Executors创建线程池,因易导致OOM。推荐手动创建ThreadPoolExecutor,合理设置参数,避免资源耗尽风险。

// 创建一个单线程化的Executor[因为数量固定,可能会堆积大量请求,导致OOM]
private static ExecutorService singleThreadExecutor = Executors.newSingleThreadExecutor();

// 创建一个固定数目线程的线程池[因为数量固定,可能会堆积大量请求,导致OOM]
private static ExecutorService fixedThreadPool = Executors.newFixedThreadPool(10);

// 创建一个可执行命令的单线程Executor[可能会创建大量的线程,导致OOM]
private static ExecutorService singleThreadScheduledExecutor = Executors.newSingleThreadScheduledExecutor();

// 创建一个可缓存的线程池(60S存活时间)[可能会创建大量的线程,导致OOM]
private static ExecutorService cachedThreadPool = Executors.newCachedThreadPool();使用线程池时候,我们可能会使用四个场景,这在alibaba代码规范中都是明令禁止的

相关文章
|
存储 数据安全/隐私保护
云盘企业版和个人版的区别
云盘企业版和个人版的区别
730 3
|
存储 关系型数据库 数据库
聊多版本并发控制(MVCC)
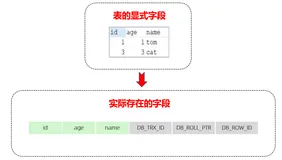
MVCC是数据库并发控制技术,用于减少读写冲突。它维护数据的多个版本,使事务能读旧数据而写新数据,无需锁定记录。当前读获取最新版本,加锁防止修改;快照读不加锁,根据读取时的读视图(readview)决定读哪个版本。InnoDB通过隐藏字段(DB_TRX_ID, DB_ROLL_PTR)和undo log存储版本,readview记录活跃事务ID。读已提交每次读取都创建新视图,可重复读则在整个事务中复用一个视图,确保一致性。MVCC通过undo log版本链和readview规则决定事务可见性,实现了非阻塞并发读。
2095 5
聊多版本并发控制(MVCC)
|
4月前
|
算法 Oracle Java
【JVM虚拟机】垃圾回收GC:垃圾收集器:CMS:核心原理、回收流程、优缺点、废弃原因(附《思维导图》+《面试高频考点清单》)
CMS是JDK 1.5推出的首个并发低延迟GC,专注老年代回收,以“最短STW”为目标,适用于Web交互系统。其采用三色标记+增量更新实现并发标记与清除,虽停顿短但存在CPU占用高、内存碎片、并发模式失败等固有缺陷,终被G1取代。
|
6月前
|
存储 人工智能 自然语言处理
企业级数字员工落地:侠客工坊从端侧视觉推理到云原生数据治理的架构思考
本文介绍“侠客工坊”端云协同架构:以事件驱动解耦云端与海量移动端,通过轻量化视觉模型实现端侧自治;采用原生事件驱动保障合规安全;构建冷热分层数据治理体系,500TB多模态数据高效归档至OSS深冷存储,为B2B企业打造高可用、强合规的数字员工基础设施。
757 1
|
API 开发工具 开发者
客流类API实测:门店到访客群画像数据
本文介绍了一个实用的API——“门店到访客群画像分布”,适用于线下实体门店进行客群画像分析。该API支持多种画像维度,如性别、年龄、职业、消费偏好等,帮助商家深入了解顾客特征,提升运营效率。文章详细说明了API的参数配置、响应数据、接入流程,并附有Python调用示例,便于开发者快速集成。适合零售、餐饮等行业从业者使用。
客流类API实测:门店到访客群画像数据
|
10月前
|
前端开发 开发者
withCredentials 属性
跨域请求中若需发送Cookie,服务器须设置Access-Control-Allow-Credentials: true,并明确指定Access-Control-Allow-Origin为具体域名,不能为星号。前端需在XMLHttpRequest中显式设置withCredentials = true,否则浏览器不会携带Cookie。注意,Cookie遵循同源策略,仅服务器域名下的Cookie可被上传,前端无法通过document.cookie读取跨域Cookie。
|
10月前
|
存储 NoSQL 物联网
MongoDB应用场景
MongoDB适用于社交、游戏、物流、物联网及直播等场景,因其支持海量数据存储、高频读写操作。用户信息、动态、日志等低事务性、高并发数据可高效存取,尤其适合用嵌套结构与地理位置索引优化查询,是大规模非结构化数据存储的理想选择。(238字)
|
缓存 Java 数据库连接
Mybatis一级缓存、二级缓存详讲
本文介绍了MyBatis中的查询缓存机制,包括一级缓存和二级缓存。一级缓存基于同一个SqlSession对象,重复查询相同数据时可直接从缓存中获取,减少数据库访问。执行`commit`操作会清空SqlSession缓存。二级缓存作用于同一namespace下的Mapper对象,支持数据共享,需手动开启并实现序列化接口。二级缓存通过将数据存储到硬盘文件中实现持久化,为优化性能,通常在关闭Session时批量写入缓存。文章还说明了缓存的使用场景及注意事项。
1214 7
Mybatis一级缓存、二级缓存详讲
|
SQL 关系型数据库 MySQL
MySQL EXPLAIN该如何分析?
本文将详细介绍MySQL中`EXPLAIN`关键字的工作原理及结果字段解析,帮助优化查询性能。`EXPLAIN`可显示查询SQL的执行计划,其结果包括`id`、`select_type`、`table`等字段。通过具体示例和优化建议,帮助你理解和应用`EXPLAIN`,提升数据库查询效率。
990 1
|
API Docker 容器
jumpserver API调试
jumpserver API调试

热门文章

最新文章