在内卷潮流的席卷下,身为算法小白的我不得不问自己,是否得踏上征程,征服这座巍巍高山。
从零开始,终点不知何方,取决于自己可以坚持多久。
希望你可以和我一样,克服恐惧,哪怕毫无基础,哪怕天生愚钝,依然选择直面困难。
分类
- 递归
- 二叉树
前言
前两篇文章我们学习了在已有二叉树的情况下,遍历二叉树节点。
二叉树的遍历是二叉树里面最简单的算法了吧,特别是递归遍历。
今天我们来学习,如何通过遍历出的二叉树节点,反向生成二叉树。
二叉树的生成
我们在前面的文章分析了二叉树的遍历,分别有
- 前序遍历
- 中序遍历
- 后序遍历
- 层次遍历
我们现在通过我们遍历的结果来生成二叉树。
首先要知道的是,通过单一的遍历结果是无法生成二叉树的,必须通过两个以上的遍历顺序。
以前序遍历举例子,我们可以知道第一个是根节点,但是后面的部分到底属于左子树还是右子树就无法得知了。
我们下面的示例还是使用我们之前文章的例子

前序遍历+中序遍历=二叉树
- 前序遍历:
A -> B -> D -> E -> C -> F -> G - 中序遍历:
D -> B -> E -> A -> F -> C -> G
const preorderList = ['A', 'B', 'D', 'E', 'C', 'F', 'G']
const inOrderList = ['D', 'B', 'E', 'A', 'F', 'C', 'G']
class Node {
  constructor(data) {
    this.data = data;
  }
}
const buildTree = (preOrder, inOrder) => {
  // 前序的第一个节点即根节点
  const data = preOrder[0]
  const node = new Node(data)
  // 根据中序可以很方便得到左右子树及各自中序
  const rootInOrder = inOrder.indexOf(data)
  const leftInOrder = inOrder.slice(0, rootInOrder)
  const rightInOrder = inOrder.slice(rootInOrder + 1, inOrder.length)
  // 观察前序和中序的特点
  // 可以发现左子树的前序和右子树前序的分界点在中序根节点的上一个节点
  let lastLeftInOrder = rootInOrder - 1;
  let leftPreOrder = []
  let rightPreOrder = []
  // 通过分界点可以很快得到左右子树前序
  if (lastLeftInOrder >= 0) {
    const lastLeftPreOrder = preOrder.indexOf(inOrder[lastLeftInOrder])
    leftPreOrder = preOrder.slice(1, lastLeftPreOrder + 1)
    rightPreOrder = preOrder.slice(lastLeftPreOrder + 1, preOrder.length)
  }
  // 通过左右子树的序列递归构建左右子节点
  node.left = leftPreOrder.length ? buildTree(leftPreOrder, leftInOrder) : null
  node.right = rightPreOrder.length ? buildTree(rightPreOrder, rightInOrder) : null
  return node
}
复制代码
算法解析的过程在代码中应该注释的算比较清楚的了,主要原理就是通过递归分别构建根节点及左右子节点。中序是个很关键的序列,我们可以通过其分析出左右子树。
中序遍历+后序遍历=二叉树
- 中序遍历:
D -> B -> E -> A -> F -> C -> G - 后序遍历:
D -> E -> B -> F -> G -> C -> A
const inOrderList = ['D', 'B', 'E', 'A', 'F', 'C', 'G']
const postorderList = ['D', 'E', 'B', 'F', 'G', 'C', 'A']
class Node {
  constructor(data) {
    this.data = data;
  }
}
const buildTree = (inOrder, postOrder) => {
  // 根据后序得到根节点
  const data = postOrder[postOrder.length - 1]
  const node = new Node(data)
  // 观察前序和中序的特点
  // 可以发现左子树的前序和右子树前序的分界点在中序根节点的下一个节点
  const rootInOrder = inOrder.indexOf(data)
  const leftInOrder = inOrder.slice(0, rootInOrder)
  const rightInOrder = inOrder.slice(rootInOrder + 1, inOrder.length)
  // 通过分界点可以很快得到左右子树后序
  let firstRighttInOrder = rootInOrder + 1;
  let leftPostOrder = []
  let rightPostOrder = []
  // 通过左右子树的序列递归构建左右子节点
  if (firstRighttInOrder < inOrder.length) {
    const firstRighttPostOrder = postOrder.indexOf(inOrder[firstRighttInOrder])
    leftPostOrder = postOrder.slice(0, firstRighttPostOrder)
    rightPostOrder = postOrder.slice(firstRighttPostOrder, postOrder.length - 1)
  }
  node.left = leftPostOrder.length ? buildTree2(leftInOrder, leftPostOrder) : null
  node.right = rightPostOrder.length ? buildTree2(rightInOrder, rightPostOrder) : null
  return node
}
复制代码
原理和前一个算法差不多,都是通过前序或者后序来确定根节点,再分别确定左右子树序列,通过递归生成左右子节点。
前序遍历+后序遍历=?
通过前序和后序是无法生成唯一二叉树的,我们在前面通过两种序列组合生成二叉树的关键都在于通过前后序来确定根节点,再通过中序序列来确定左右子树。
如果仅提供前后序列的话,我们只能确定根节点,而无法区分左右子树。
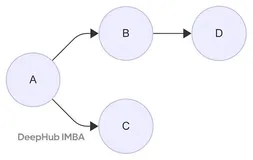
举个例子,下面的两个树的前后遍历序列是完全相同的


中序遍历+层次遍历=?
层次遍历可以确定根节点,中序遍历可以确定左右子树,所以中序遍历和层次遍历组合应该是可以构建唯一树的。
但是层次遍历有个特点,其左右子树并不是连续的,所以无法找到其临界点来分离左右子树,只能通过中序遍历得到的左右子树来筛选了。
因为没有看到相关的题,今天就先不实现了
总结
通过递归实现了二叉树的构建,其关键点在于通过当前序列分析出左节点和右节点的序列,以此实现递归构建节点。