
一、前言
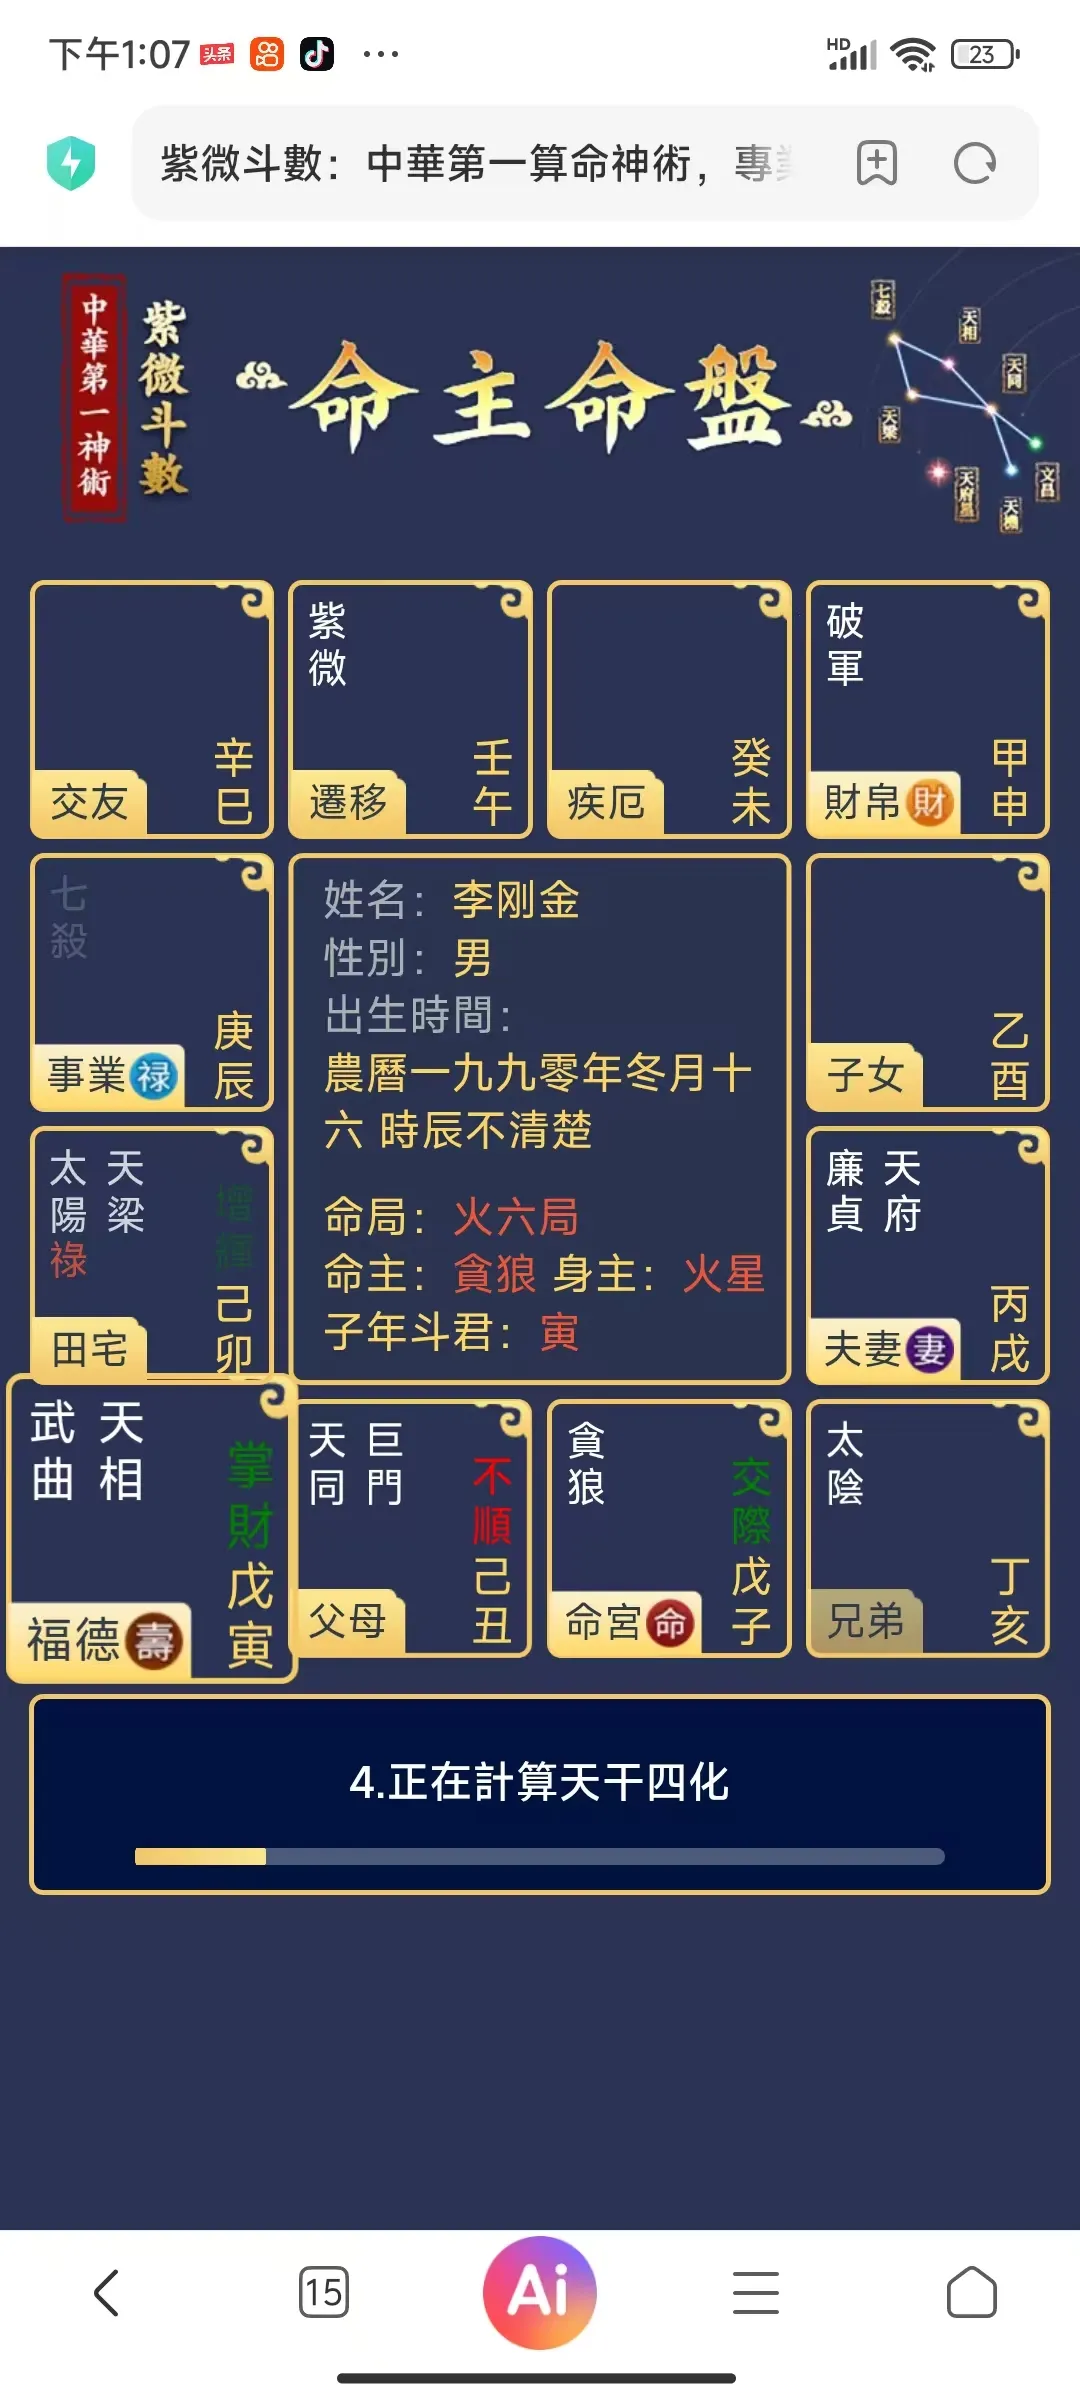
在紫微斗数软件开发过程中,排盘结果属于结构化程度比较特殊的数据,既有生辰、性别、流派这类简单字段,又包含十二宫、星曜、四化、格局、解读文案等多层嵌套内容。很多开发者一开始直接把整张盘的 JSON 丢进数据库,上线之后才发现查询、索引、扩容都出现麻烦。
排盘数据的存储选型,直接影响接口响应速度、历史命盘管理、多端同步以及用户隐私合规。本文结合自研紫微斗数项目的落地经验,对比几种主流存储方案,讲清楚各自适合的场景、优缺点以及踩坑点。
二、先理清排盘数据的特点
一次排盘输出的数据,不是简单的单行记录。一条完整命盘包含基础信息和嵌套集合,基础信息适合做条件筛选,星曜、宫位明细属于大段嵌套数据。同时业务上有两种使用场景,一种是临时测算,用完即走,不需要长期保存;另一种是登录用户保存历史命盘,支持回看、对比、二次解读。
另外生辰信息属于敏感数据,存储方案还要考虑数据脱敏、备份、删除的便利性,不能只追求读写速度忽略合规风险。
三、几种存储方案对比
第一种方案是 MySQL 关系型存储,拆表设计。把用户基础信息、生辰参数存在主表,十二宫、星曜明细拆成子表,通过盘 ID 关联。它的优势是事务稳定、支持精准条件查询,方便按用户、生辰范围筛选历史命盘,数据权限管控简单。缺点是拆表之后查询需要关联,每次读取完整命盘要多次查询,开发工作量更大,后续新增字段、新增星曜属性的时候,表结构变更比较麻烦。适合需要严格管理用户历史命盘、做后台统计、订单绑定的业务版本。
第二种方案是 MongoDB 文档存储,单文档存储完整命盘 JSON。一条记录就是一张完整命盘,不需要拆表,新增属性不用改表结构,开发效率很高,读取的时候一次拿到全部盘数据,非常贴合排盘接口直接返回 JSON 的场景。缺点是复杂多条件筛选的性能不如 MySQL,索引设计如果不合理,海量历史盘场景下查询会慢慢变慢,同时文档体积不受控,长期积累容易出现单文档过大的问题。适合快速迭代、频繁新增解读字段、多流派并行开发的项目。
第三种方案是 Redis 缓存存储,只做临时结果存储。不做长期持久化,以生辰 + 流派组合作为 key,缓存排盘结果,设置过期时间。它的优势是读取速度极快,专门用来扛高并发,减少重复计算。但它不适合当做历史数据持久存储,服务重启、key 过期之后数据就丢失,一般只作为上层加速组件,不能单独作为主存储。
第四种方案是混合存储,也是我们最终落地的方案。MySQL 存用户档案、盘基础索引信息,MongoDB 存放完整的排盘 JSON 文档,Redis 负责热点命盘缓存。查询的时候先查缓存,缓存未命中再从 MySQL 拿到文档 ID,去 MongoDB 读取完整命盘,兼顾查询能力、开发效率和访问性能。
四、选型判断思路
如果只是简单工具,不需要保存用户历史命盘,只做即时测算,优先 Redis 缓存,计算完缓存一段时间,不落地持久化,架构最简单。 如果是面向从业者的版本,需要大量保存客户命盘、支持检索、导出、台账管理,优先 MySQL 拆表方案,数据可控性更强。 如果迭代速度快,规则引擎持续新增解读字段,不想频繁改表结构,优先 MongoDB 文档方案。 用户量大、并发高,同时要留存历史数据,就采用 MySQL+MongoDB+Redis 的混合架构。
五、核心代码示例
// 混合存储写入逻辑,保存排盘结果
public String savePanResult(PanResultDTO panDto, Long userId) {
    String docId = mongoTemplate.insert(panDto).getId();
    PanIndex index = new PanIndex(userId, panDto.getBirthInfo(), docId);
    panIndexMapper.insert(index);
    redisTemplate.opsForValue().set(getPanKey(panDto), panDto, 24, TimeUnit.HOURS);
    return docId;
}
// 读取命盘,缓存优先
public PanResultDTO getPanResult(String birthKey, Long userId) {
    String cacheKey = getPanKey(birthKey);
    PanResultDTO cacheData = redisTemplate.opsForValue().get(cacheKey);
    if(cacheData != null) return cacheData;
    PanIndex index = panIndexMapper.selectByBirth(userId, birthKey);
    return mongoTemplate.findById(index.getDocId(), PanResultDTO.class);
}
六、落地踩坑点
第一个坑,直接把超大 JSON 塞进 MySQL 的 text 字段,看似省事,但是无法建立内部字段索引,想要按宫位、星曜条件筛选完全做不到,后期想做后台检索功能基本无法改造。 第二个坑,MongoDB 不做索引,直接全表扫描查询历史命盘,用户量上来之后接口响应越来越慢,需要提前基于用户 ID、生辰维度建立复合索引。 第三个坑,敏感数据处理,不管哪种存储,生辰时间都要做脱敏,数据库备份也要单独管控,不能明文长期随意留存。 第四个坑,缓存和底层存储数据不一致,当规则引擎、排盘算法更新之后,旧缓存的命盘结果和新算法结果不一致,需要增加版本号到缓存 key 里面,算法升级之后自动失效旧缓存。
七、总结
紫微斗数排盘数据,没有绝对最好的存储方案,只有匹配业务目标的方案。关系型数据库胜在可控、可检索,文档数据库胜在灵活、开发快,Redis 胜在高速减负。
我们最终采用混合存储,用 MySQL 做索引与权限管理,MongoDB 承载灵活的命盘文档,Redis 承接热点流量,平衡了开发效率、查询性能和长期数据管理需求。后续还会基于这套存储结构,增加历史命盘对比、批量导出的后台功能。
八、互动
如果你也在做命理测算类后端存储设计,在历史命盘归档、敏感数据存储、海量数据清理方面有不同方案,欢迎一起交流。
