
一、前言
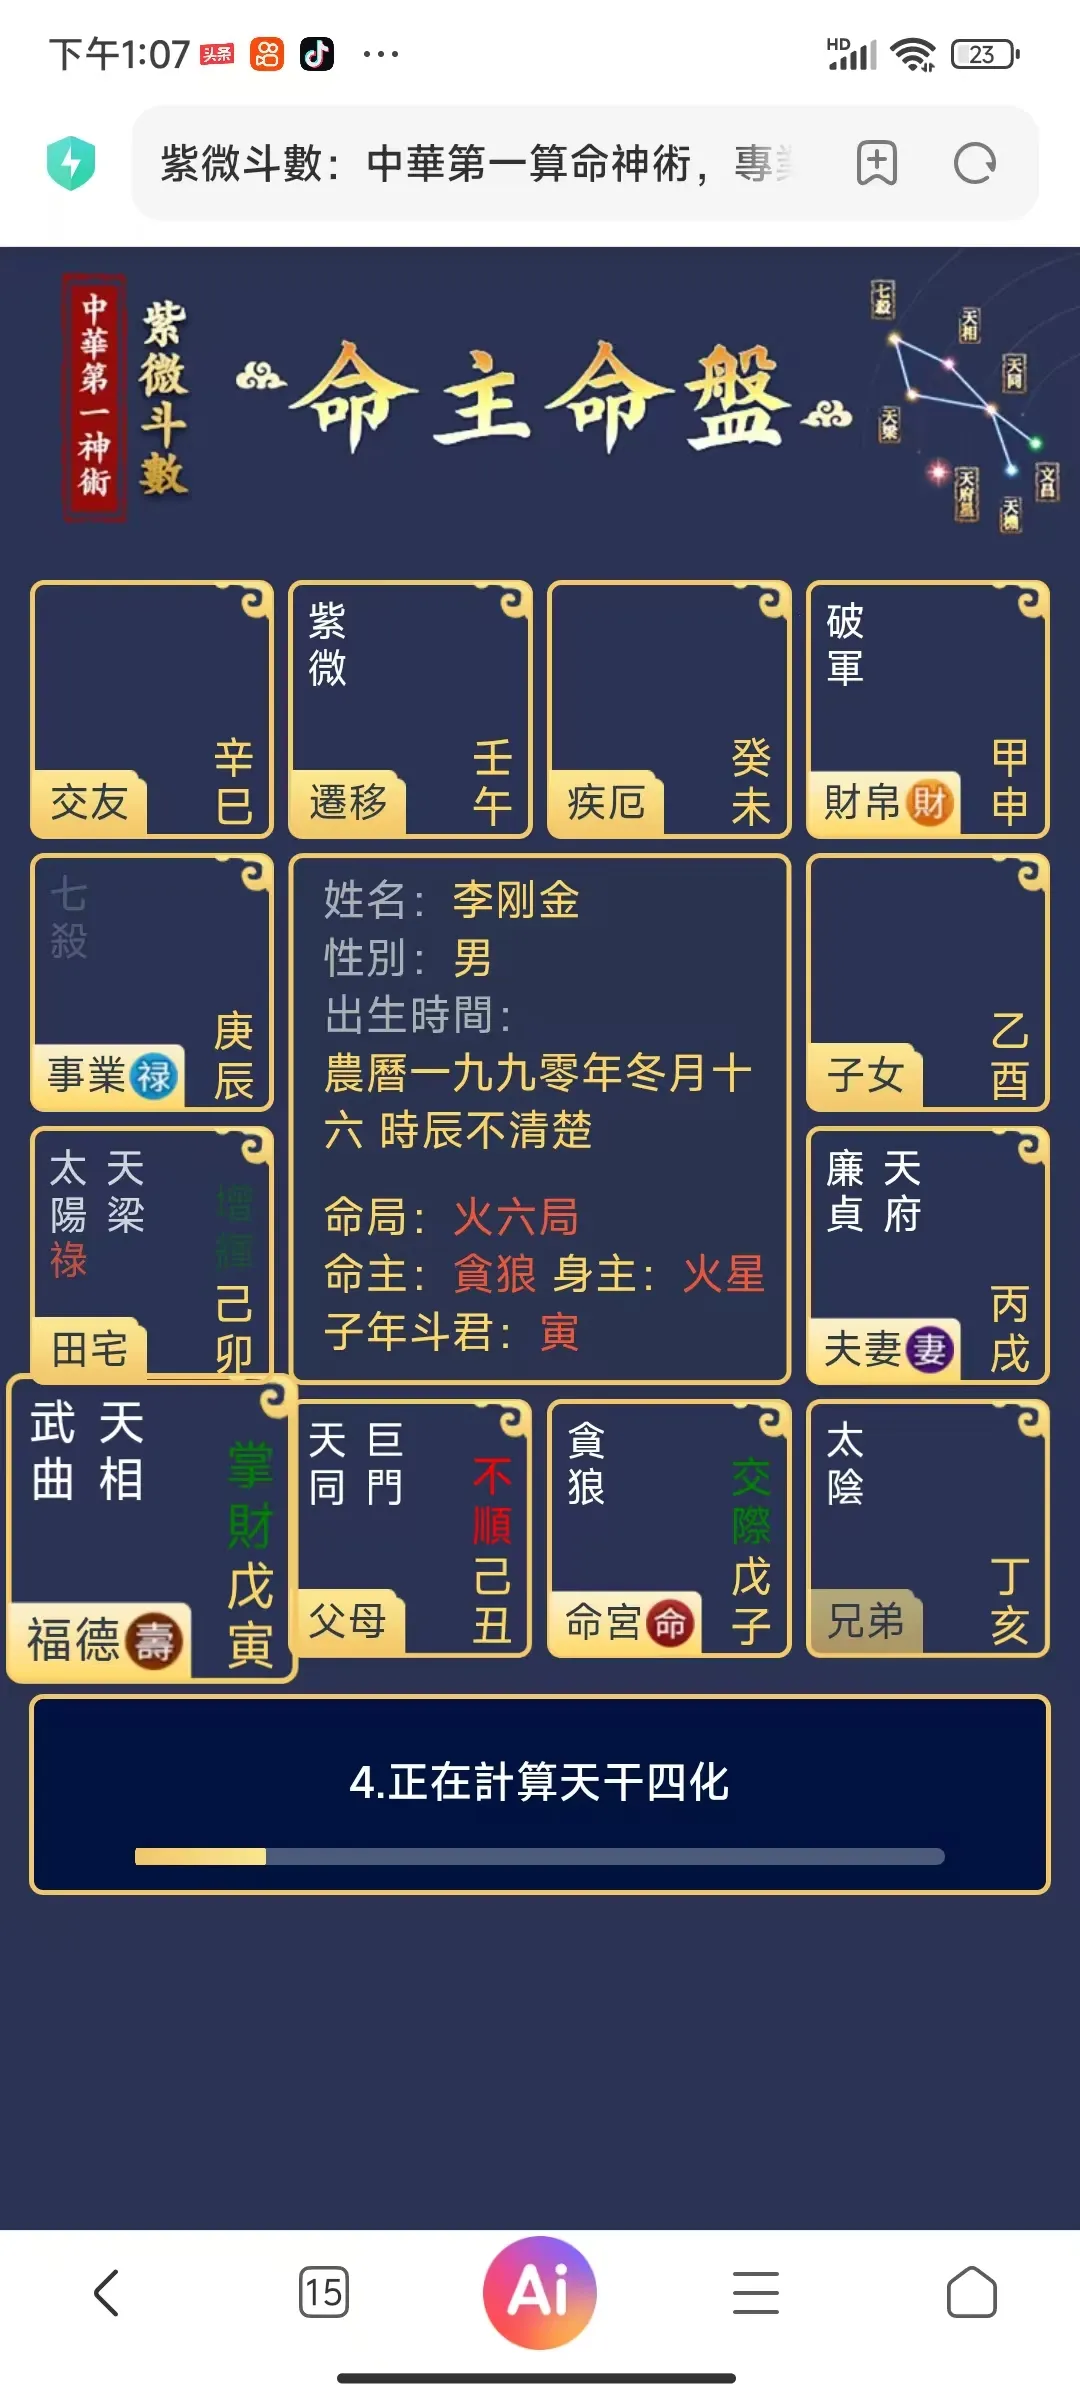
前面自研紫微斗数相关工具的时候,先后落地了排盘计算、公历农历转换、安星、宫位生成等底层模块。 一张单纯的星盘,只能展示星曜、四化、宫位信息,想要实现主动解读,而不是简单读取星曜静态字典释义,就需要独立搭建一套规则引擎。
很多同类测算工具做法比较粗暴:直接堆砌大量 if else 判断硬编码解读逻辑。短期开发速度快,但紫微斗数的组合维度极多,星曜、四化、宫位、煞星、格局互相叠加,规则数量很容易上千。后续更换流派、新增格局、调整解读话术时,代码会快速臃肿腐烂,维护成本居高不下。
本文分享紫微斗数解读模块的规则引擎设计方案,将命理业务规则与核心代码解耦,适合国学测算类软件开发同学参考。
二、业务需求梳理:什么是紫微 “主动解读”
先区分两种解读模式:
- 静态释义:单颗星曜独立介绍,例如 “紫微为帝星,主尊贵”,本质是查表,不需要引擎参与;
- 主动解读:输入完整命盘数据,自动识别各类组合条件,匹配格局、吉凶、星曜互动关系,输出结构化断语。
主动解读需要同时做多维度条件判断:
- 宫位:命宫、财帛、官禄、迁移、福德等
- 星曜关系:同宫、对宫、三合、夹拱
- 四化:化禄、化权、化科、化忌落宫以及搭配星曜
- 煞星:擎羊、陀罗、火星、铃星、空劫组合影响
- 格局判定:识别杀破狼、机月同梁、紫府同宫等经典格局
- 流派配置:不同流派判定标准不一样,解读侧重点存在差异
输出内容也要求结构化:格局总论、重点宫位分析、四化点评、风险提示分开,而不是一段杂乱无章的文字。
三、为什么不推荐硬编码 if-else
原型阶段我尝试过直接写判断,很快暴露出几个痛点:
- 规则量级爆炸:单宫组合就上百种,跨宫联动规则更多,if 嵌套层级很深,可读性差;
- 规则不透明:命理师输出的规则文档,很难和代码逻辑一一对应,修改一句结论就要改代码、重新发布;
- 多流派兼容困难:同一组星盘组合,不同流派吉凶判定不一样,硬编码很难做到动态切换;
- 运营门槛高:命理顾问想要新增一条断语,必须依赖开发改代码;
- 缺少权重机制:多条规则同时命中时,无法控制展示优先级,结论容易互相冲突。
核心思路:把命理规则抽离为配置数据,由独立规则引擎统一匹配调度。
四、规则引擎整体架构设计
整体四层结构,和底层排盘模块完全解耦:
排盘输出层 → 盘数据标准化层 → 规则引擎匹配层 → 解读结果组装层
- 排盘输出层:上游模块输出标准 JSON 命盘数据(宫位、星曜、四化、煞星、干支、格局标记等);
- 盘数据标准化层:统一字段、清洗数据、打上标记,为引擎条件判断提供标准输入;
- 规则引擎匹配层:加载规则库,按条件匹配命盘,收集全部命中规则;
- 解读结果组装层:按权重排序、冲突处理,合并内容,输出结构化解读文案。
规则数据结构设计(示例)
单条规则存放在数据库或者 JSON 配置文件中:
{
  "ruleId": "R001",
  "ruleName": "杀破狼格局",
  "ruleType": "pattern",
  "weight": 90,
  "enable": true,
  "flow": "default",
  "condition": {
    "palace": "命宫",
    "starAnd": ["七杀", "破军", "贪狼"],
    "mustIn": "三合"
  },
  "result": {
    "title": "杀破狼格局",
    "content": "命宫三合杀破狼,开创变动之格,一生多机遇也多波折..."
  }
}
- weight:权重,数值越大优先级越高,多条命中优先展示;
- flow:流派标识,支持规则灰度、流派一键切换;
- condition:条件表达式,支持并且、或者、排除、同宫、对宫、三合等逻辑;
- result:输出文案,支持简单占位符。
原子判断能力:
- 指定宫位包含 / 不包含某星曜
- 星曜满足同宫 / 对宫 / 三合 / 夹拱关系
- 四化落入指定宫位
- 是否存在指定煞星
- AND、OR 复合条件组合
五、引擎匹配执行流程
- 接收上游标准化命盘 JSON;
- 根据用户选中流派,过滤启用的规则列表;
- 逐条解析条件表达式,基于命盘上下文求值判断;
- 收集所有命中规则;
- 按权重降序排序;
- 冲突处理:配置互斥分组,互斥规则同时命中时按权重取舍;
- 分类分组:格局类、命宫总论、财帛官禄、四化点评、煞星提醒;
- 文案组装,输出结构化解读数据给到前端。
优化要点: 不要无脑全量遍历上万条规则。增加规则索引,优先判定格局大类,再加载对应宫位相关规则,减少计算开销。
六、开发踩坑难点
6.1 规则冲突问题
紫微很多星曜组合本身具备两面性:吉星同宫带煞,吉中藏凶。 引擎不能简单命中就输出。 方案:
- 设置规则互斥组、叠加标记;
- 支持规则叠加模式,多条命中可以合并描述,不互相覆盖;
- 文案模板增加修饰语,例如:本为吉格,但是带陀罗,吉性打折。
6.2 规则粒度平衡
规则太粗:解读内容空泛,和网上通用模板没有差别; 规则太细:星曜组合无穷无尽,规则库维护量爆炸。 采用分层设计:
- 高层:格局级大规则(杀破狼、机月同梁等);
- 中层:宫位 + 星曜基础组合;
- 底层:四化、煞星修饰规则(用来修饰上层结论)。 修饰型规则不单独输出,附加到主规则上,控制规则总量。
6.3 命理规则版本管理
命理师会持续调整断语、新增判定条件。 规则需要做版本记录:每次修改记录版本号、操作人,支持回滚。线上先灰度测试,再全量发布,避免一次改动造成全部解读结果出错。
6.4 性能优化
单张命盘匹配几百条规则压力很小;批量测算场景下增加缓存:根据生辰 + 时区 + 流派生成盘指纹,缓存解读结果,避免重复匹配。
七、核心伪代码参考(Java)
// 简化示意:规则匹配核心逻辑
public List<InterpretItem> matchRule(ZiWeiPan pan, String flowCode){
    // 1.加载当前流派可用规则
    List<Rule> ruleList = ruleRepository.getEnableRuleByFlow(flowCode);
    List<InterpretItem> hitList = new ArrayList<>();
    for(Rule rule : ruleList){
        // 解析条件表达式,基于命盘上下文计算
        boolean isHit = conditionParser.parse(rule.getCondition()).eval(pan);
        if(isHit){
            InterpretItem item = buildItem(rule);
            hitList.add(item);
        }
    }
    // 权重排序 + 冲突过滤
    return conflictHandler.handle(hitList);
}
项目落地推荐:使用轻量表达式引擎 QLExpress、Aviator,不用自研表达式解析器,节省大量开发工作量。
八、配套后台管理设计
为降低长期维护成本,配套开发规则管理后台:
- 规则增删改查、启用停用;
- 可视化条件配置,下拉选择宫位、星曜、关系,不用手写 JSON;
- 单规则调试:输入生辰单独测试这条规则命中效果;
- 命中日志统计:清理长期无法命中的无效规则。
搭建后台之后,命理顾问提需求,开发只需要扩展原子判断能力,不用反复修改业务判断代码。
九、总结
紫微斗数主动解读模块,难点不在于文案撰写,而是如何把偏经验化、组合化的命理知识,转化成一套可维护、可扩展、支持多流派切换的规则体系。
规则引擎带来的价值:
- 业务规则和代码解耦,新增、修改解读逻辑无需重新发版;
- 多流派并存,一键切换判定口径;
- 结构化输出解读,H5、小程序等多端可以复用同一套服务;
- 方便持续沉淀迭代命理知识库。
排盘是骨架,解读引擎才是测算工具的大脑。后续计划在这套引擎之上,继续做解读文案个性化、轻重版本话术切换。
十、互动
如果你也在开发紫微、八字这类国学测算工具,欢迎一起交流规则引擎选型、表达式设计以及规则冲突处理方案。
