
技术笔记记得越多,查找时未必越方便。
一条 Docker 命令可能放在项目 README 里,一份 Nginx 配置可能藏在旧文件夹中,解决报错时留下的记录,又只有当时的自己能看懂。过了一段时间,即使搜索到了关键词,也得重新判断:这条操作适用于哪个版本?是在容器里执行,还是在宿主机上执行?前置条件是什么?
我想围绕这个问题,设计一个个人知识库问答助手。它的任务很具体:根据已有的技术资料回答问题,给出可核对的来源;资料不足时,明确说明无法确认。我对这个助手的要求有三个:能够通过自然语言查找资料,能够区分不同操作的适用条件,在资料不足时明确说明无法确认。
方案选择:应用部署在 ECS,模型通过 API 调用
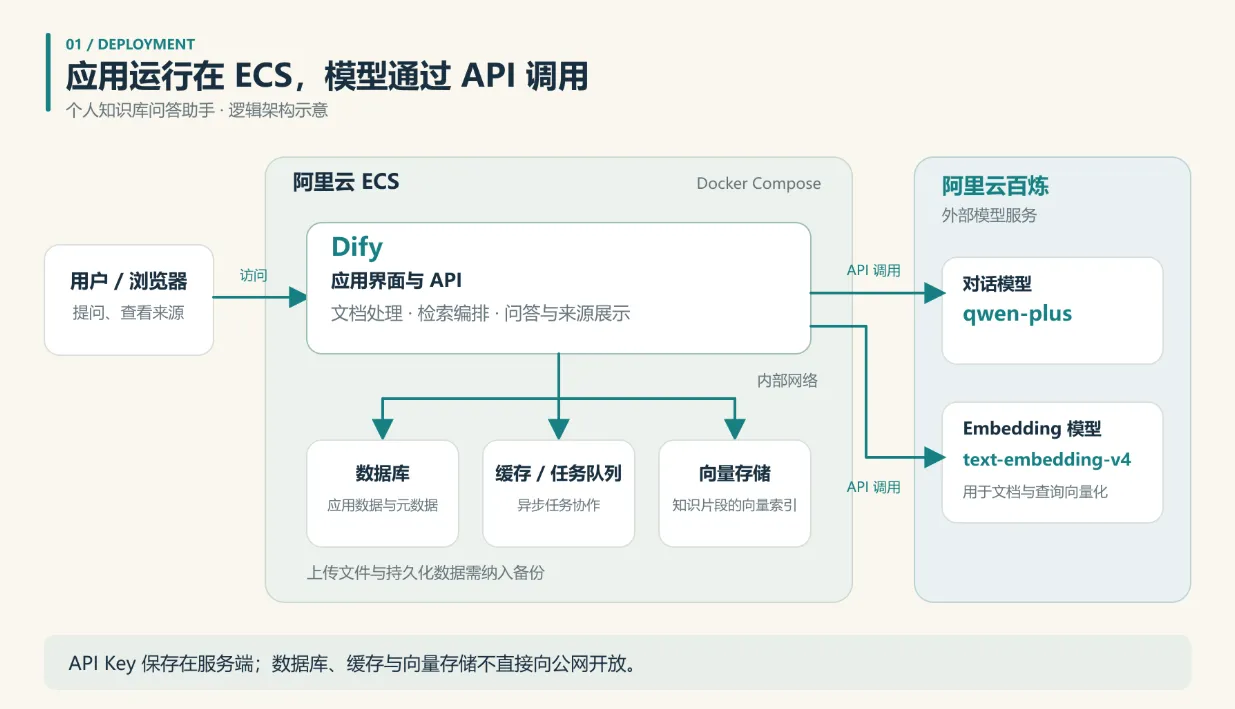
这套方案采用阿里云 ECS、Dify 和阿里云百炼。ECS 运行应用及其依赖服务,Dify 负责文档处理、检索和问答流程,模型能力通过百炼 API 调用。阿里云已经提供了 Dify 接入百炼的配置说明,包含对话模型和知识库相关模型的接入方式
环境设置如下:
| 项目 | 配置 |
|---|---|
| 云服务器 | 阿里云 ECS,4 vCPU、8 GiB 内存 |
| 操作系统 | Ubuntu 22.04 LTS |
| 系统盘 | 80 GiB ESSD 云盘 |
| 公网带宽 | 5 Mbps |
| 部署方式 | Docker Compose |
| 对话模型 | 通义千问 qwen-plus |
| Embedding 模型 | text-embedding-v4 |
| 知识库资料 | 12 份 Markdown、6 份文本型 PDF |
| 测试范围 | 个人使用及小规模并发访问 |
这里选择 4 核、8 GiB,是为了给应用服务、数据库、缓存和文档处理留出一定余量。
部署过程:先确认服务状态,再接入模型
准备好 Docker 和 Docker Compose 后,我获取 Dify 的发行版代码,并记录版本标签。进入部署目录,复制环境配置文件:
cd dify/docker
cp .env.example .env
随后按部署说明修改密码、服务地址等配置,检查配置能否正确解析,再启动服务:
docker compose config --quiet
docker compose up -d
docker compose ps
我将初始化入口的访问来源限制为自己的公网 IP,完成管理员配置后,再准备正式访问入口。数据库、缓存和向量存储不直接向公网开放。模型接入时,我在 Dify 中安装通义千问模型供应商插件,配置百炼 API Key,并分别测试对话和文本向量化调用。这两项测试需要分开进行。聊天能够返回答案,只能说明对话模型调用成功,不能证明文档入库所需的向量模型也已经配置正确。
一次排查:页面正常,不代表文档入库正常
一个案例中,存在如下问题:应用页面可以打开,对话测试也正常,但上传文档后,部分任务一直没有完成。我先检查容器状态,确认后台任务服务没有持续重启;随后查看任务日志,发现问题发生在调用向量模型的阶段。继续核对后,我发现向量模型使用的凭证与地域设置不匹配。修正配置并重新验证调用后,再重试失败任务,文档才完成索引。
这个过程让我把检查顺序整理成了三步:先确认应用服务是否正常,再确认后台任务是否执行,最后检查外部模型调用。这样可以避免看到入库失败,就直接怀疑服务器内存不足。
检索调优:先看找到了什么,再看回答了什么
第一轮测试时,我按照默认思路导入全部资料。随后发现,问“容器中如何配置反向代理”时,系统可能同时检索出宿主机部署笔记。两份资料都包含 Nginx 配置,但使用条件不同。如果模型把其中的操作拼接起来,答案即使语句通顺,也未必能够直接执行。为此,我先整理文档,在标题和正文中补充部署环境、适用版本和前置条件。涉及命令的记录,尽量把命令、解释和验证方法放在一起。例如,单独保存一条“修改配置后重启服务”的操作,价值有限。只有写清配置文件位置、为什么修改、适用于什么环境,以及修改后如何检查,检索结果才有足够的上下文。
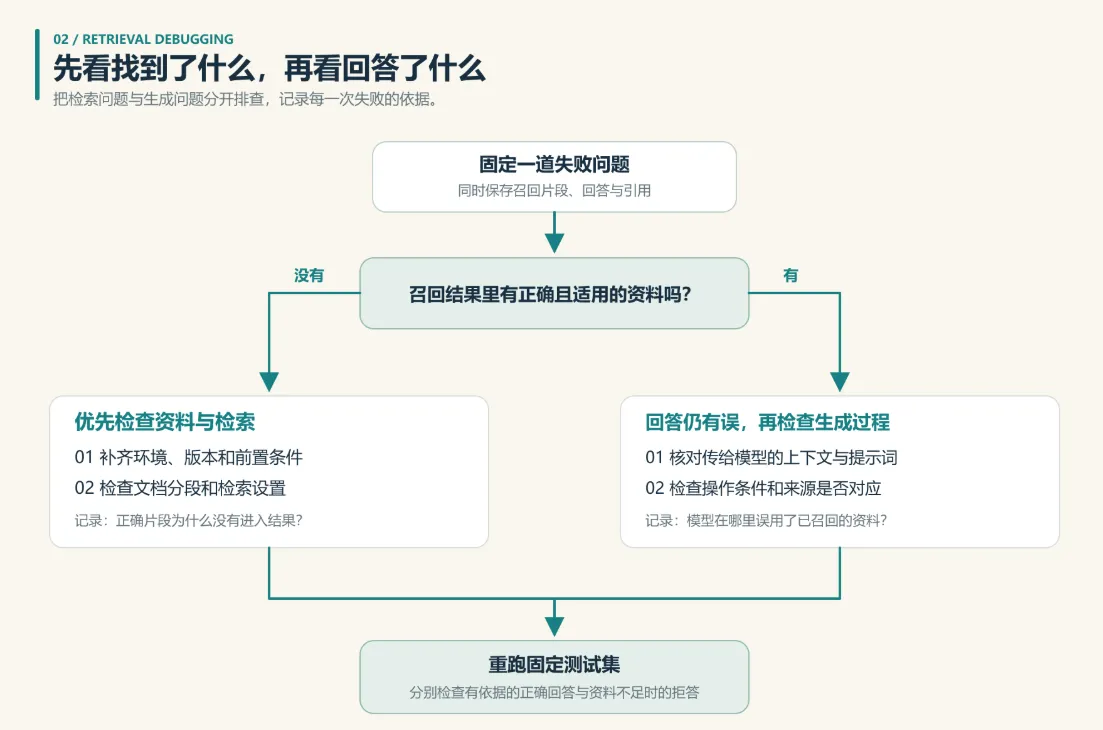
接着,逐题查看召回内容。如果相关资料根本没有进入检索结果,就优先处理文档结构和检索设置;如果已经召回正确内容,回答仍然有误,再检查提示词和模型输出。
这种排查方式让我避免把所有问题都归结为模型能力。
效果验证:把正确回答和正确拒答一起统计
为了比较调整前后的效果,我设计了 30 道测试题,其中包括 15 道单文档问题、10 道需要结合多个片段的问题,以及 5 道知识库中没有答案的问题。最后一类问题用于检查系统是否会在缺少依据时继续生成操作建议。例如,资料没有记录某次故障的实际原因,就不应仅凭常见原因给出确定结论。
| 指标 | 初始方案 | 整理资料并调整后 |
|---|---|---|
| 25 道有答案问题中,回答正确且有依据的题数 | 17 | 22 |
| 5 道无答案问题中,正确拒答的题数 | 2 | 4 |
| 端到端响应时间中位数 | 4.8 秒 | 4.5 秒 |
| 完整导入 18 份文档的耗时 | 约 7 分钟 | 约 8 分钟 |
在这个示例中,主要收益体现在回答质量,而不是速度。整理后的资料保留了更多必要信息,入库时间略有增加,但问答时更容易区分操作条件。响应时间的小幅变化不足以证明服务器性能得到提升,因为它还会受到网络、模型输出长度和服务端负载影响。
运行与维护:关注资源,也关注数据能否恢复
运行期间,我使用以下命令观察资源占用:
docker stats --no-stream
free -h
df -h
观察时,我会区分文档入库和日常问答两个阶段。文档处理期间的短时资源增长,与服务空闲时持续异常占用,需要采用不同的排查方式。成本记录也分成两部分:ECS、磁盘等基础资源费用,以及对话和向量化产生的模型调用费用。
另外,我把数据库、上传文件和向量索引都纳入备份范围。仅保存一份应用配置,不能保证服务器故障后就能恢复完整知识库。
目前,这个项目的完成状态是:能够导入文本资料,完成单轮知识问答,并核对检索来源;对于扫描件识别、复杂表格和文档间版本冲突,仍需进一步处理。
下一步我希望先完善失败案例记录。每次回答错误,都保存问题、召回片段、模型输出和人工判断,再决定应当修改资料、检索流程还是提示词,不断持续改进知识库助手。

