大模型行业已经从简单问答阶段,逐步走向复杂长链路自主任务时代。除了对话生成能力之外,市场更加看重模型处理超长文档、图文视频混合素材、自主拆解工程任务、多智能体协同完成工作流的综合实力。通义千问Qwen3.8‑Max作为系列新一代旗舰大模型,采用2.4万亿总参数的稀疏MoE混合专家架构,原生支持100万Token超长上下文以及文本、图像、视频一体化多模态输入,同时具备全栈代码工程能力、双模式推理、长周期智能体执行、隐式缓存降本等众多新特性。它不再只是单纯的聊天工具,而是一套可以处理复杂工程、办公自动化、科研分析的全能AI基座。本文将从底层技术架构、核心能力、各类使用入口、API代码调用、业务场景实战、常见踩坑以及订阅计费方案完整展开,附带可直接复制运行的Python代码,帮助普通用户与开发者快速吃透这款旗舰模型,完成从简单对话到复杂长周期任务的落地。
一、Qwen3.8‑Max核心架构与关键技术突破
1. 2.4万亿MoE稀疏混合专家架构,兼顾性能与推理成本
Qwen3.8‑Max采用稀疏混合专家MoE架构,总参数量达到2.4万亿,属于规模第一梯队的大模型。该架构最大的亮点就是稀疏激活机制,在执行推理的时候,并不会加载全部的2.4万亿参数,仅激活约95B规模的核心专家参数参与运算。依靠这套机制,模型既拥有超大参数带来的强大理解与生成能力,又可以控制算力消耗,实现超大参数规模、较快推理速度、可控调用成本三者之间的平衡。详情👉访问阿里云百炼大模型服务平台页面 了解。
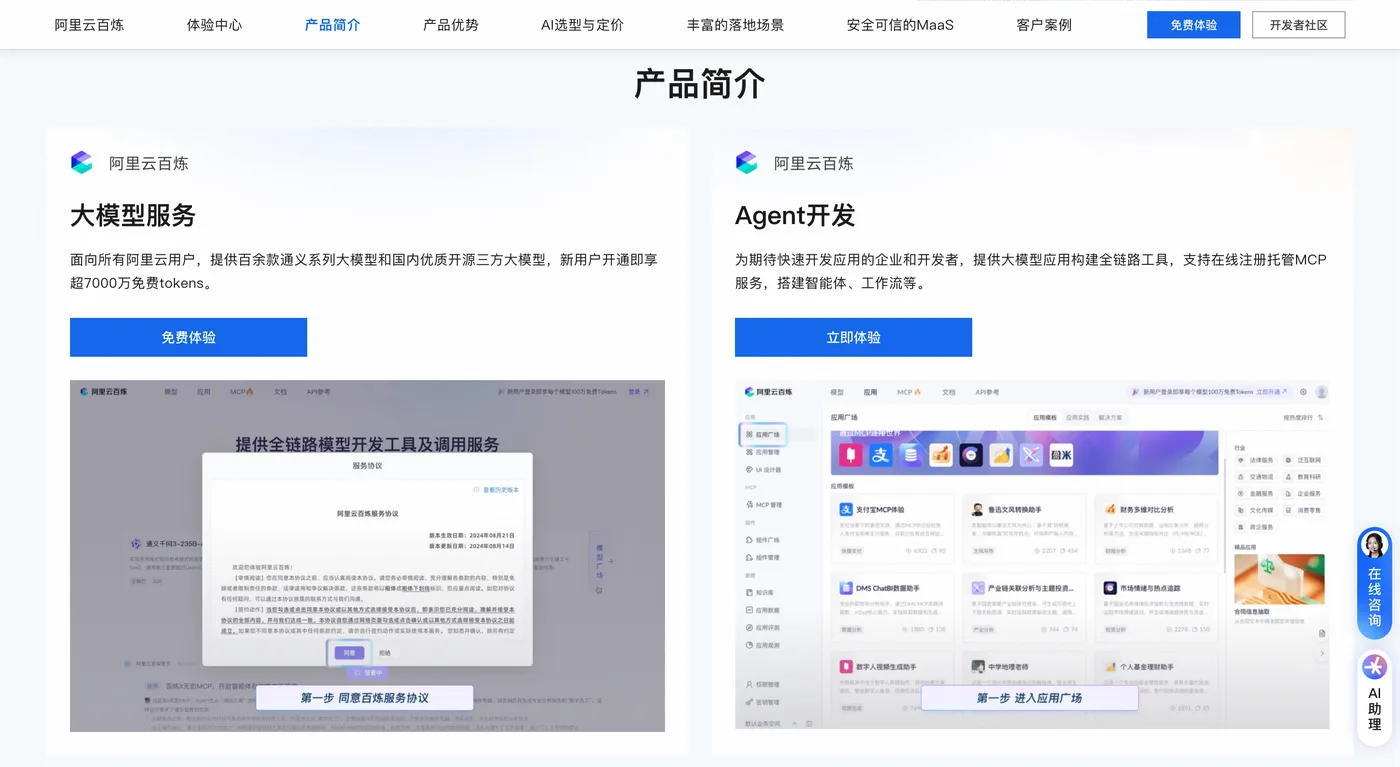
对比上一代Qwen3.7‑Max,架构层面完成三处重要升级。第一,混合注意力机制优化,长文本理解、跨段落上下文关联能力提升40%;第二,专家路由算法迭代优化,面对复杂任务时专家模块匹配精准度提升25%;第三,推理引擎底层重构,推理速度较上代提升30%,同时整体Token消耗降低30%。这套优化让模型既可以处理百万Token规模的超长输入,又不会出现响应速度严重下滑,适配个人日常使用、脚本自动化、企业级大型工程等不同规模的业务。
2. 原生支持100万Token超长上下文窗口
模型原生最高支持100万Token上下文窗口,标准模式默认128K,用户可以一键开启拓展至1M Token。换算成中文文本,100万Token大约等同于75万字内容,可以一次性摄入300页PDF合同、一整年完整财务报表、百万行规模项目源代码、整本图书,甚至是100小时时长的视频字幕文本。传统大模型处理超长资料,需要人为切割文档分段输入,很容易造成上下文割裂、关键信息丢失、逻辑断裂等问题,而Qwen3.8‑Max支持完整素材一次性送入模型,实现全局理解。
超长上下文带来三大业务价值。第一,无需人为拆分文档,完整保留全部上下文逻辑;第二,依托全局信息做推理判断,长文本场景事实幻觉错误率下降60%,输出可信度大幅提升;第三,支持长程逻辑追踪,能够捕捉跨章节、跨子模块之间的关联逻辑,十分适合法律合同审核、科研文献梳理、大型项目代码重构这类需要全局视角的业务。详情👉访问阿里云百炼大模型服务平台页面 了解。
3. 原生多模态融合能力,文本图像视频文档一体化解析
Qwen3.8‑Max实现原生多模态处理,不需要额外外挂第三方插件或者独立模型,就可以同时处理文本、图像、视频、PDF、Word、Excel等多种格式素材,实现跨模态信息深度融合理解。
- 图像理解:支持高分辨率图片解析,可以识别图表、截图、设计图纸、手写文字、工程图纸;
- 视频处理:解析长视频内容,生成内容摘要、提取关键帧,识别画面人物、场景,输出结构化内容;
- 文档解析:直接读取PDF、Word、Excel,提取文本、表格、图片,完成总结、数据提取、格式转换。
多模态能力让模型从单纯的文本处理工具升级成全格式信息处理中枢,用户直接上传截图、报表、视频,不用手动转换格式,大幅降低信息处理的前置工作量。
二、Qwen3.8‑Max五大核心功能详解
1. 深度思考/极速响应双推理模式自由切换
模型内置两套推理模式,使用者可以根据任务的精度、延迟需求自由切换,平衡输出质量和响应速度。
- 深度思考模式(xhigh,默认):逐层拆解目标任务,自主校验逻辑,多轮迭代优化,适配复杂逻辑推理、代码开发、法律文书分析、科研论证等高精度任务,会输出完整思考过程,结果严谨,但响应耗时相对更长。
- 极速快速模式(low):精简推理链路,减少内部迭代步骤,适合简单问答、批量摘要、日常对话,响应速度提升50%,Token消耗降低30%,适配高并发低延迟业务场景。详情👉访问阿里云百炼大模型服务平台页面 了解。
切换方式:Web端对话设置面板选择推理模式;API调用通过reasoning_effort参数进行配置。
2. 全栈工程级代码能力,端到端完成软件开发
Qwen3.8‑Max内置覆盖127种编程语言的语法树解析器,代码能力得到显著增强。
- 完整项目一键生成:通过自然语言描述需求,直接输出完整项目,包含架构设计、多份代码文件、依赖清单、测试用例、README文档;
- 仓库级代码重构:读取百万行级别项目源码,识别冗余代码、潜在Bug,完成跨文件、跨模块的重构迭代;
- 专业调试诊断:读取报错日志,定位故障根源,输出可落地修复方案;
- 长周期智能体编程:官方实测中,模型自主运行长达16天,完成oh‑my‑cli自进化智能体框架开发,产出265次代码提交,达到同级主流智能体框架水准。
3. 复杂逻辑推理与MCP多智能体协同
依托MCP多智能体协作协议,模型具备强大复杂推理与长周期任务执行能力。在GPQA Diamond评测拿到92.6分,IF Bench达到82.8分,在数学、金融、法律、医疗等专业领域表现优秀。
- 自主任务拆解:接收复杂业务目标,自动拆解为多个子任务,生成执行计划,分步协同执行;
- 闭环自适应学习:执行任务过程校验输出结果,发现偏差自动调整策略,形成执行‑反馈‑优化闭环,长程任务完成率提升40%;
- 多智能体分工协作:调度多个子智能体分工处理跨领域复杂工程,例如根据UI截图直接生成前后端完整项目加上数据库设计。
4. 视觉输入‑校验‑迭代闭环
模型的视觉能力不止是看懂图片,还构建起一套完整闭环链路。解析图像、视频内容之后,可以基于视觉信息进行创作,生成图像、前端代码、设计方案;生成完成后再通过视觉反馈校验输出效果,识别布局、样式、动画偏差,自动迭代修正,实现“生成‑观察‑修正‑完善”的全链路视觉创作。
5. 隐式上下文缓存,降低重复任务Token开销
内置隐式缓存功能,自动识别重复的上下文前缀,比如固定系统提示词、重复长文档头部内容、固定对话前置片段。缓存命中之后,输入Token计费仅为正常价格的10%,每百万Token仅需1.5元。缓存不需要手动开启,模型自动识别复用,兼顾便捷性和使用成本,适合大量重复模板类任务、长会话业务。
三、多渠道使用入口与Python API实操代码
1. Web网页端
普通用户零门槛体验,打开网页登录账号,模型列表选择Qwen3.8‑Max‑Preview,对话框输入文字,也可以点击加号上传图片、视频、各类文档,直接发起对话。免费版本存在每日对话次数限制,适合体验和简单测试,高频使用建议订阅对应套餐。
2. 桌面客户端
支持Windows、macOS客户端,登录账号之后选用该模型,支持窗口快捷唤起、多会话并行管理,适合本地高频办公、代码调试场景。
3. API开发者接入实战
开发者可以通过DashScope API接入模型,完成业务集成、批量任务、自动化工作流。
第一步,前往百炼平台的API密钥管理页面,创建以sk‑开头的API密钥,妥善保存。
安装SDK依赖包:
pip install dashscope
配置环境变量,Linux/macOS终端:
export DASHSCOPE_API_KEY="你的API Key"
Windows PowerShell:
$env:DASHSCOPE_API_KEY="你的API Key"
基础文本对话调用示例:
import os
import dashscope

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

messages = [
    {
   "role":"system","content":"你是专业Python开发助手,输出代码注释完整,可直接运行"},
    {
   "role":"user","content":"编写多线程爬虫,抓取网页全部图片保存本地,增加异常捕获逻辑"}
]

response = dashscope.Generation.call(
    model="qwen3.8-max",
    messages=messages,
    reasoning_effort="xhigh"
)

print("模型输出结果:")
print(response.output.text)
多模态图文调用示例,传入UI截图生成前端代码:
import os
import dashscope

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

messages = [
    {

        "role":"user",
        "content":[
            {
   "image":"https://example.com/ui_demo.png"},
            {
   "text":"根据这张UI截图,生成响应式HTML+CSS代码,使用Tailwind CSS"}
        ]
    }
]

resp = dashscope.MultiModalConversation.call(
    model="qwen3.8-max",
    messages=messages
)

print("生成前端代码:")
print(resp.output.choices[0].message.content[0]["text"])
百万Token超长上下文文档分析示例:
import os
import dashscope

dashscope.api_key = os.getenv("DASHSCOPE_API_KEY")

# 读取本地长文档文本
with open("annual_report.txt","r",encoding="utf‑8") as f:
    long_text = f.read()

msg = [{

    "role":"user",
    "content":f"阅读这份年度报告,提炼核心财务指标、业务亮点与潜在风险,分点输出,控制在500字以内:{long_text}"
}]

res = dashscope.Generation.call(
    model="qwen3.8-max",
    messages=msg,
    max_tokens=1000000
)

print(res.output.text)
四、典型业务场景实战
场景一:长文档审查(合同、科研论文)
将PDF文档转为文本或者直接上传原文档,下发指令提取合同付款条款、违约风险点;或者解析论文提取研究方法、创新点。依靠百万Token上下文完整读取全部内容,不用人工切割文档,输出结构化要点,后续继续追问修改建议,大幅压缩人工阅读的时间成本。
场景二:端到端完整项目开发
直接用自然语言描述项目需求,模型输出完整项目架构、代码文件、依赖清单、测试案例。代码运行出现报错,直接把报错日志交给模型自动调试迭代。例如开发数据分析工具,实现csv读取、数据清洗、绘图、PDF报表导出,从需求描述得到可以直接运行的工程代码。
场景三:多模态办公处理
上传UI截图直接生成前端代码;上传财务报表截图,提取数据,生成数据分析和matplotlib绘图代码;解析PDF报表,自动整理数据表格,完成汇总统计。无需手动录入数据,多模态能力简化大量办公重复操作。
场景四:长周期智能体科研工程任务
下发指令复现一篇AI论文,模型自动拆解任务:环境搭建、代码实现、实验调试、结果分析、输出复现报告。依靠长程智能体能力,多轮调用工具,自主完成整套复杂科研任务,官方实测完整流程可以持续上百小时,无需人工介入。
五、高效使用技巧与避坑指南
实用使用技巧
- 按需切换推理模式:简单摘要、普通对话使用
low极速模式;复杂推理、代码开发、法律分析使用xhigh深度思考模式,兼顾效率与成本。 - 长文档直接上传完整素材,尽量不要手动切割,发挥百万Token上下文的能力,减少信息丢失。
- 尽量多模态混合输入,文本搭配图片、文档,给到模型完整信息,提升输出准确度。
- 重复模板类任务,利用隐式缓存降低Token开销,减少调用成本。
- 使用结构化提示词,明确输出格式、字数、约束条件,例如分点输出、代码增加注释,提升输出匹配度。
常见问题处理
- 长文档处理响应缓慢:输入Token数量巨大,算力消耗高属于正常现象。可以先用极速模式生成文档摘要,再针对摘要做精细化深度分析。
- 多模态图片/PDF识别失败:图片使用JPG、PNG格式,分辨率不要超过4K;PDF需要是可复制文本版本,扫描版PDF需要提前OCR转换成文本。
- API调用报错:核对API Key正确性,确认账号完成实名认证,没有欠费;模型名称为
qwen3.8‑max,注意拼写。 - 生成代码无法直接运行:把完整报错信息全部交给模型调试;提示明确Python、第三方库版本限制,减少版本不兼容问题。
- Token消耗过高:精简输入,剔除无关冗余内容;优先极速模式;长对话定期清理历史上下文,只保留关键信息;重复任务利用隐式缓存。
六、订阅与计费方案
Qwen3.8‑Max提供两套订阅方案,适配个人、开发者、团队不同规模业务。
- Token Plan通用订阅:按照Credits额度计费,多款大模型共用额度。个人Lite版39元每月起,团队版150元每月起。计费标准输入12元/百万Token,输出36元/百万Token,缓存命中后输入仅1.5元/百万Token。适合全场景业务、批量任务、智能体开发。
- Coding Plan代码专属订阅:面向代码开发场景,Pro版200元每月,每月提供大量请求额度,内置多款代码向模型,适配个人开发者、编程项目。
七、全文总结
Qwen3.8‑Max作为通义千问系列的新一代旗舰大模型,凭借2.4万亿参数MoE稀疏架构、原生100万Token超长上下文、文本图像视频原生多模态、双推理模式、全栈工程级代码能力、MCP多智能体协同、隐式缓存降本等一系列能力,把大模型的能力边界从简单问答拓展到复杂长周期自主任务。详情👉访问阿里云百炼大模型服务平台页面 了解。
普通使用者可以通过网页、桌面客户端快速上手体验;开发者通过DashScope API,借助Python代码快速把模型能力集成进自有业务系统。实际落地的时候,要合理选择推理模式,用好百万上下文与多模态输入,利用隐式缓存控制调用成本,区分Token Plan和Coding Plan两套订阅方案。同时认清能力边界,超大复杂任务建议做适当拆分,处理扫描类PDF、图片素材时注意素材格式,规避识别失败的问题。
不管是个人处理文档、编写代码,还是科研机构做论文复现、企业搭建AI自动化业务,Qwen3.8‑Max都可以作为高性能的AI基座,把大量重复、复杂的脑力工作交给AI处理,让人力聚焦创意、决策等高价值工作,推动办公、研发、科研的效率升级。