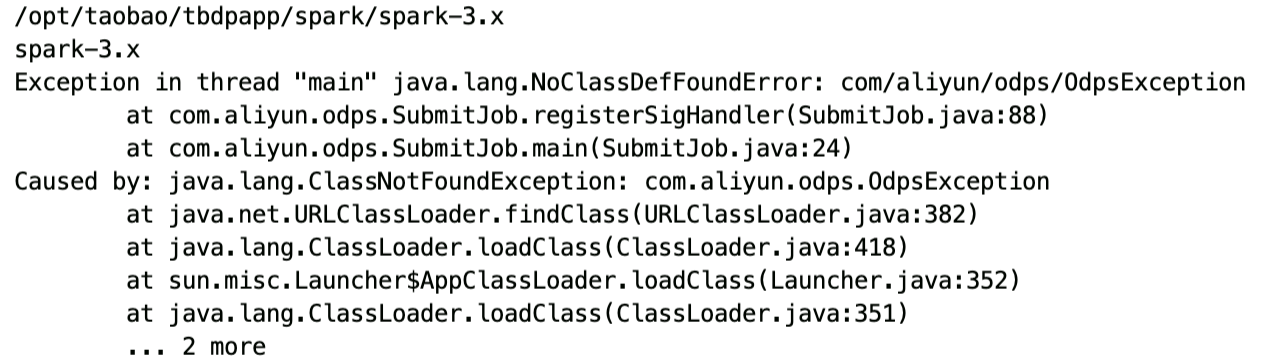
DataWorks当选用Spak3.x时,报错?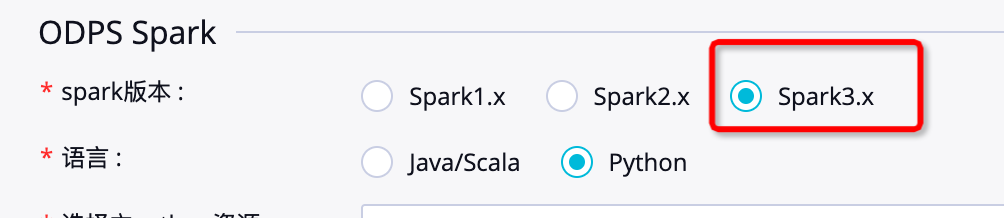
版权声明:本文内容由阿里云实名注册用户自发贡献,版权归原作者所有,阿里云开发者社区不拥有其著作权,亦不承担相应法律责任。具体规则请查看《阿里云开发者社区用户服务协议》和《阿里云开发者社区知识产权保护指引》。如果您发现本社区中有涉嫌抄袭的内容,填写侵权投诉表单进行举报,一经查实,本社区将立刻删除涉嫌侵权内容。
代码逻辑兼容性:确保Spark作业的逻辑与Spark 3.x版本兼容。查阅Apache Spark的官方文档,了解版本变更对作业逻辑的影响。
当DataWorks选用Spark 3.x版本时遇到报错,可以通过以下步骤进行排查和解决:
一、定位错误原因
查看错误日志:
仔细阅读DataWorks控制台中的错误日志,找出具体的错误信息。
错误信息通常会包含错误代码、错误描述等关键信息,这些信息有助于定位问题所在。
分类错误类型:
语法错误:如缺少括号、拼写错误等。
类型错误:如将字符串与整数相加。
依赖错误:如缺少必要的库或版本不兼容。
配置错误:如配置文件中的设置不正确。
资源限制:如内存不足或磁盘空间不足。
二、检查作业兼容性
代码逻辑兼容性:确保Spark作业的逻辑与Spark 3.x版本兼容。查阅Apache Spark的官方文档,了解版本变更对作业逻辑的影响。
依赖库兼容性:检查所有依赖的库是否与Spark 3.x版本兼容,并确保库版本是最新的。如果发现有不兼容的库,需要进行更新或替换。
三、检查资源配置
Executor数量与内存大小:检查是否已为Spark作业配置了足够的资源,如Executor的数量和内存大小。这些配置需要在ODPS Spark节点的配置项中逐条指定,并根据实际作业需求进行合理设定。
并行度设置:调整作业的并行度设置,以优化资源使用并减少报错的可能性。
四、调试与修复
使用调试工具:
利用DataWorks中的调试工具来运行和测试Spark作业,这有助于更好地理解错误发生的上下文。
除了DataWorks控制台中的错误日志外,还可以查阅Spark作业的日志文件,通常可以在任务详情页找到日志链接。
搜索解决方案:
如果错误信息不足以解决问题,可以尝试在Apache Spark社区、Stack Overflow或GitHub等平台搜索相关讨论和解决方案。
也可以查阅DataWorks的官方文档或帮助文档,以获取更详细的指导。
提交工单:
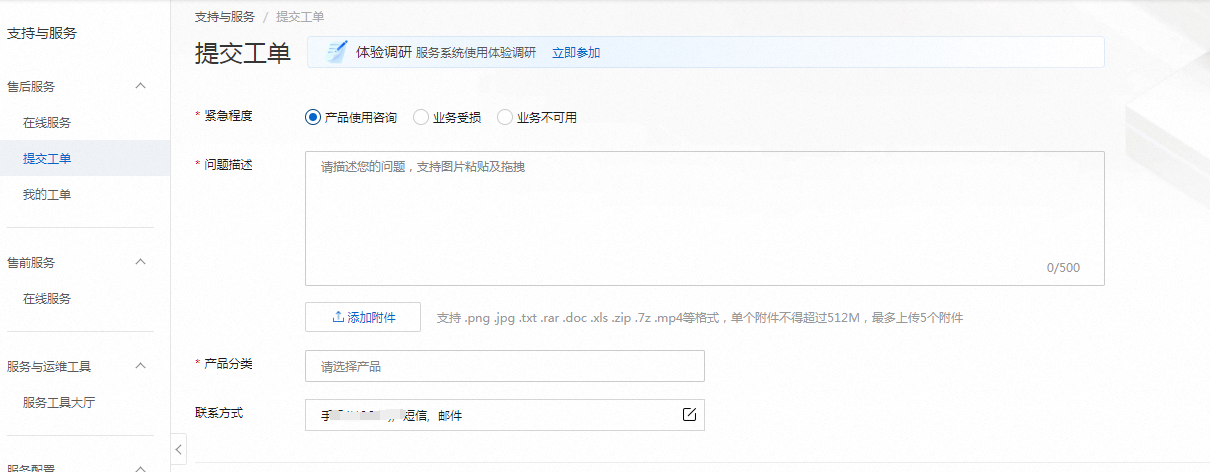
如果以上步骤均无法解决问题,建议提交工单联系技术支持人员。在提交工单时,提供详细的错误信息和复现步骤,以便技术支持人员更好地理解和解决问题。
五、常见错误及解决示例
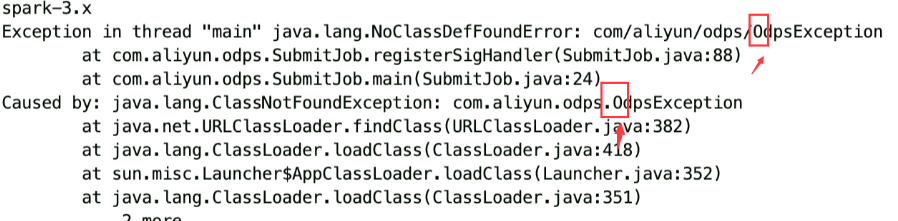
ClassNotFoundException:
检查所有依赖的JAR包是否已正确添加到项目中。
确保所有必需的类都在类路径中,并检查spark.jars配置项是否包含了所有必需的JAR包。
如果使用Maven或Gradle等构建工具,请确保依赖管理配置正确。
资源限制错误:
增加Executor的数量或内存大小,以满足作业的资源需求。
优化作业逻辑,减少资源消耗。
六、总结
当DataWorks选用Spark 3.x版本时遇到报错,首先需要通过查看错误日志和分类错误类型来定位问题所在。然后检查作业的兼容性和资源配置,确保所有设置都是正确的。接下来使用调试工具进行调试和修复,并在必要时搜索解决方案或提交工单联系技术支持人员。通过以上步骤,可以逐步排除错误并找到解决方案。
当您在DataWorks中选择使用Spark 3.x版本并遇到报错时,可以按照以下步骤进行排查和解
确认报错详情:首先,仔细查看报错信息,了解具体的错误描述,这有助于定位问题。
检查依赖与环境:确认您的任务是否依赖于特定的Python库或其他资源,这些依赖是否与Spark 3.x兼容。根据业务需求,正确配置Python环境,如使用PyODPS 2节点或PyODPS 3节点,并确保所有必要的库已打包并上传至DataWorks作为MaxCompute资源
自定义Python环境:如果默认Python环境不满足需求,按照文档指引自定义Python环境,包括本地准备环境、打包并上传至DataWorks。
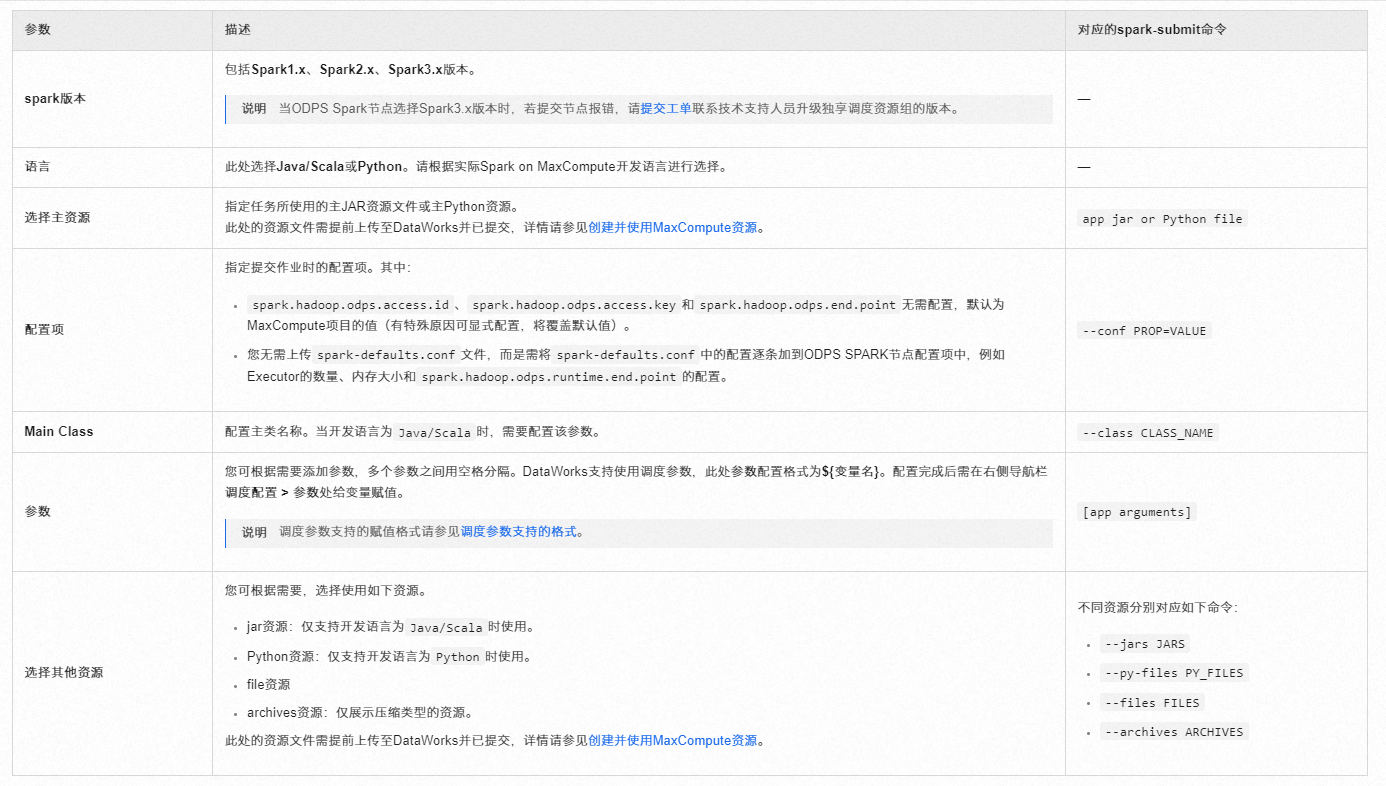
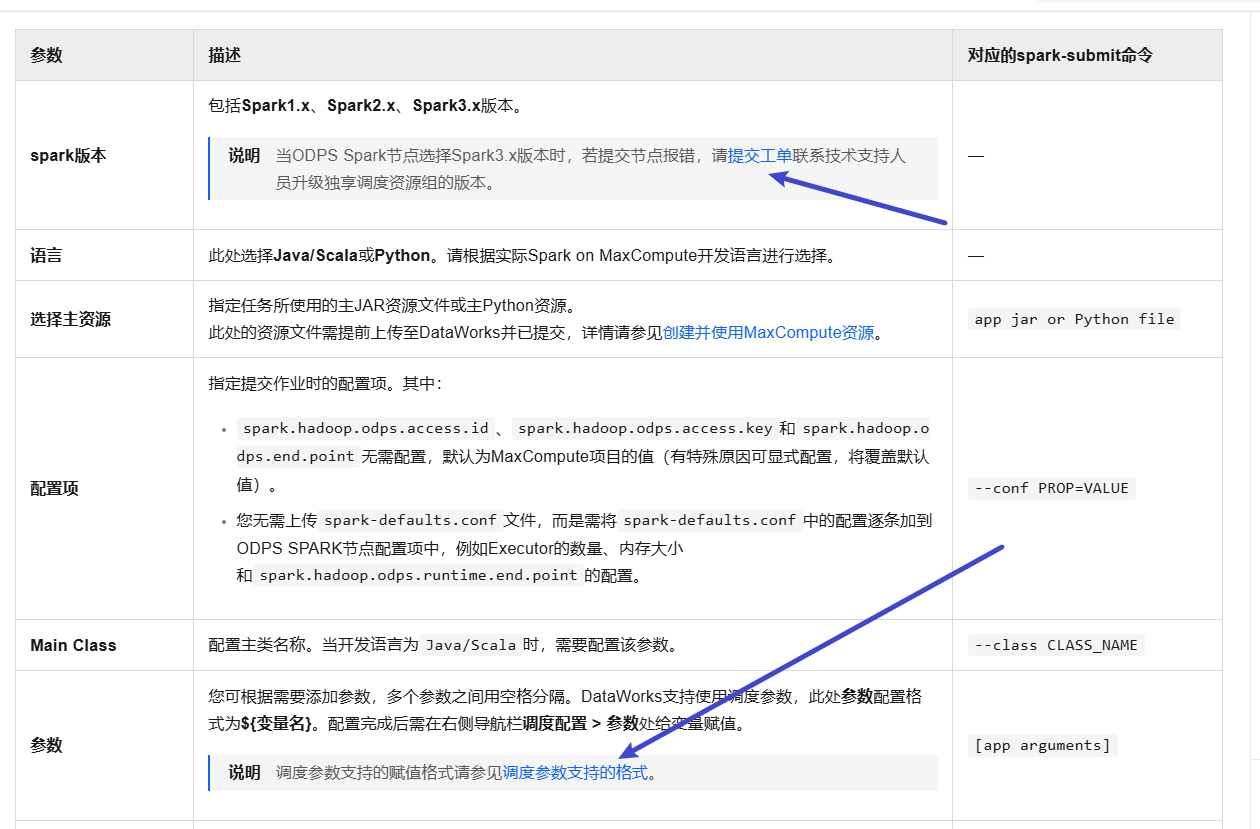
配置项检查:在ODPS Spark节点的配置中,确保所有必要的spark-defaults.conf配置项已逐条添加至任务配置中,例如Executor数量、内存大小等<。注意,无需上传spark-defaults.conf文件本身。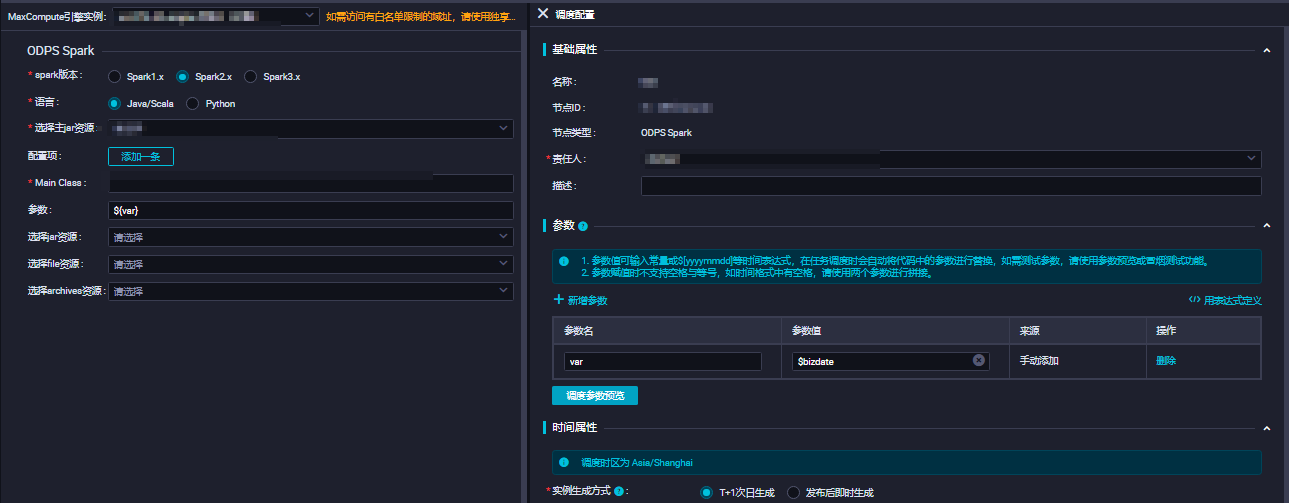
通过上述步骤,您可以系统地诊断和解决在DataWorks中使用Spark 3.x时遇到的报错问题。
相关链接
https://help.aliyun.com/zh/dataworks/user-guide/create-an-odps-spark-node
当在 DataWorks 中选用 Spark 3.x 时报错,您可以采取以下步骤来解决:
1. 查看错误日志:
仔细分析错误日志中的详细信息,确定报错的具体类型和相关的提示。这可能会指出是配置问题、依赖冲突还是其他特定的错误原因。
例如,如果错误日志中提到缺少某个依赖库,您就知道需要添加相应的依赖。
2. 检查配置参数:
确认 DataWorks 中与 Spark 3.x 相关的配置参数是否正确设置。包括内存分配、并行度、资源限制等。
比如说,如果内存分配不足,可能导致任务失败并报错。
3. 版本兼容性:
确保您使用的 DataWorks 版本与 Spark 3.x 兼容。有时,不同版本之间可能存在不兼容的情况。
例如,某些较旧的 DataWorks 版本可能对 Spark 3.x 的某些新特性支持不完善。
4. 依赖库版本:
检查项目中依赖的其他库的版本是否与 Spark 3.x 兼容。不兼容的依赖库版本可能引发错误。
比如,某些库的特定版本可能与 Spark 3.x 的某些模块存在冲突。
5. 网络和环境问题:
检查网络连接是否稳定,以及运行环境是否正常。不稳定的网络或异常的环境可能导致数据传输或计算出现问题。
6. 社区和文档:
在相关的技术社区、论坛或官方文档中搜索类似的报错信息,看看其他用户是否遇到过相同的问题以及他们是如何解决的。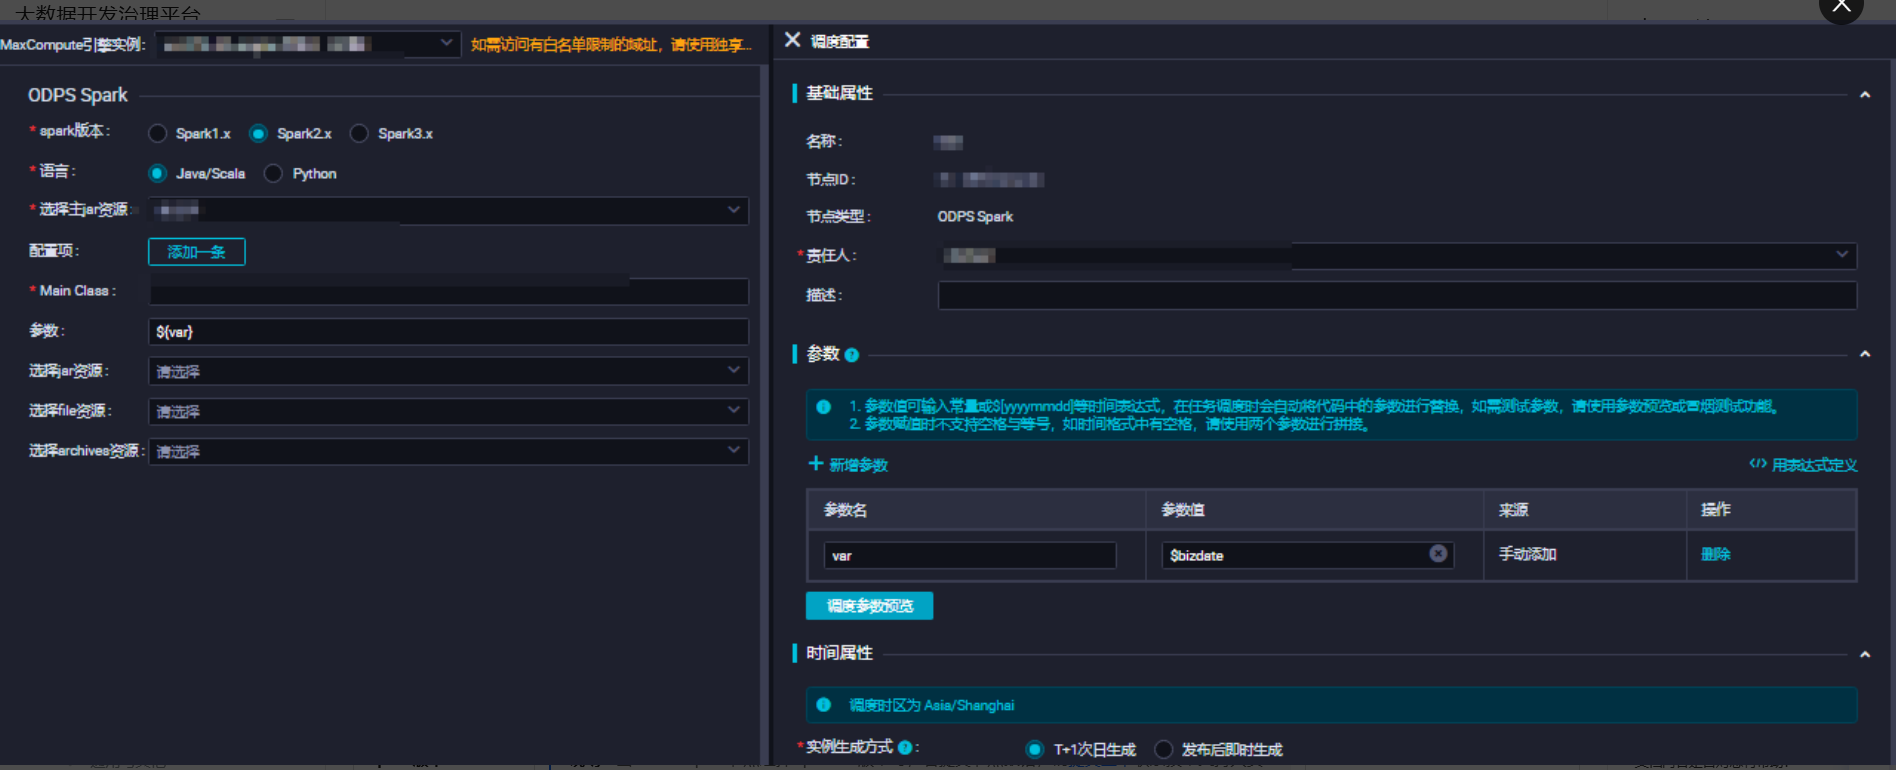
当DataWorks选用Spark 3.x时遇到报错,可能是由于多种原因导致的。针对这种情况,可以采取以下步骤来解决问题:
看看你Spark作业与选定的Spark 3.x版本兼容,包括代码逻辑、依赖库等,检查是否正确配置了Executor的数量、内存大小等资源参数,这些配置需按照实际作业需求合理设定,并在ODPS Spark节点的配置项中逐一指定,避免因资源不足引发错误
当您在使用DataWorks时选择Spark 3.x版本执行任务出现报错时,解决这类问题通常涉及几个步骤:定位错误原因、理解错误信息、调试和修复。下面是一些常见的步骤和建议来帮助您解决这类问题:
首先,仔细阅读DataWorks控制台中的错误日志,找出具体的错误信息。错误信息通常会提供一些线索,帮助您定位问题所在。常见的错误类型包括:
确保您的任务代码与所选的Spark版本兼容。例如,某些功能可能在Spark 3.x中已被弃用或移除。您可以通过以下方式检查兼容性:
确保所有依赖的库都与Spark 3.x兼容,并且版本是最新的。例如,如果您的代码依赖于Pandas,则需要确保Pandas版本与Spark 3.x兼容。
有时错误可能源于配置问题。检查您的Spark配置,确保所有设置都是正确的。例如,内存分配、并行度等设置可能需要调整。
使用DataWorks中的调试工具来运行和测试您的任务。这可以帮助您更好地理解错误发生的上下文。
除了DataWorks控制台中的错误日志之外,您还可以查阅Spark作业的日志文件。在DataWorks中,通常可以在任务详情页找到日志链接。
如果错误信息不足以解决问题,可以尝试搜索Apache Spark社区、Stack Overflow 或者 GitHub 等平台上的相关讨论。您也可以查阅官方文档或DataWorks的帮助文档。
如果您需要进一步的帮助,请提供更具体的错误信息和代码片段。这将有助于更准确地定位问题。
假设您遇到了一个典型的错误:“ClassNotFoundException”,这通常表示Spark无法找到所需的类。解决此问题的一般步骤如下:
检查依赖:
检查类路径:
查看 Spark 配置:
spark.jars 配置项是否包含了所有必需的JAR包。调试:
查阅文档:
当您在DataWorks中使用Spark 3.x版本遇到报错时,检查兼容性与资源配置
确保您的作业与Spark 3.x版本兼容,包括代码逻辑、依赖库等。同时,检查是否已为Spark作业配置了足够的资源,如Executor数量、内存大小等,这些配置需在ODPS Spark节点的配置项中逐条指定
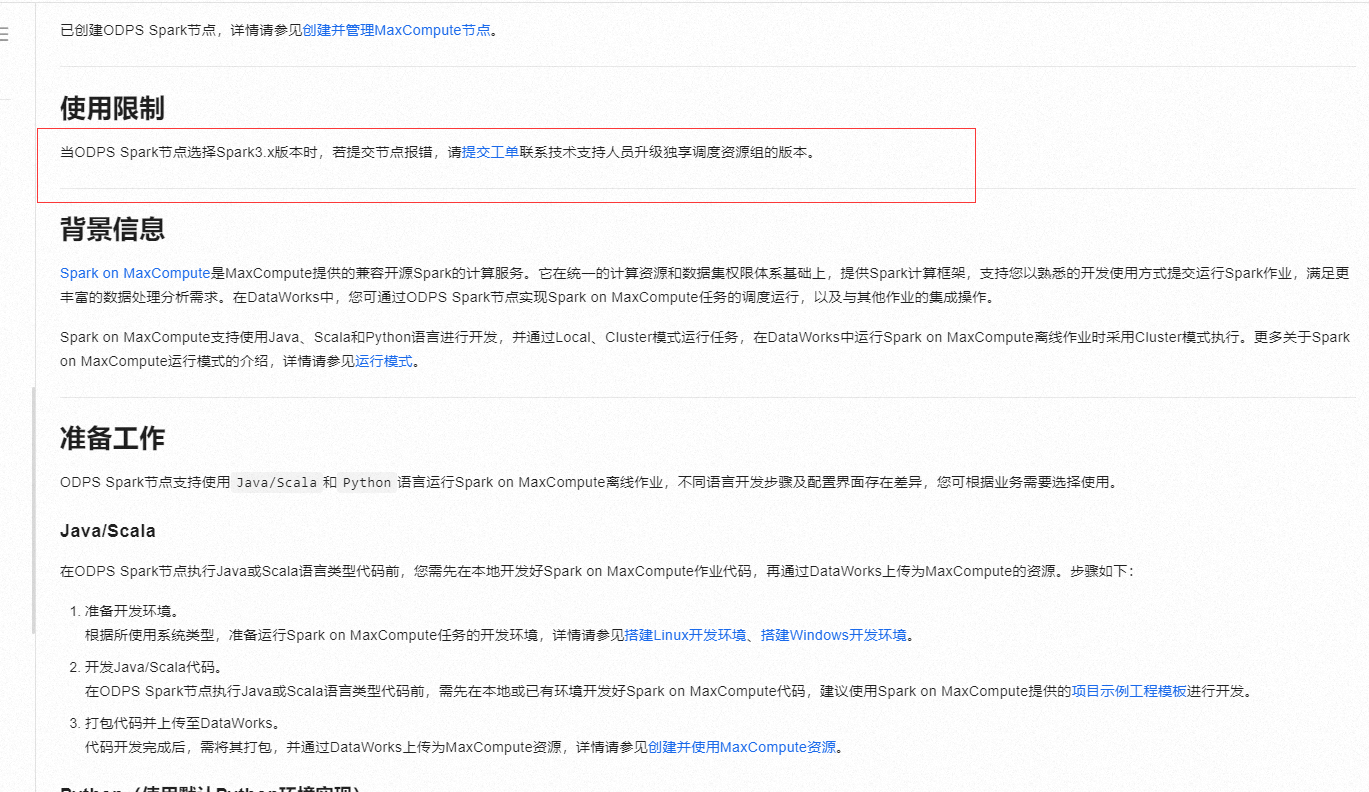
当ODPS Spark节点选择Spark3.x版本时,若提交节点报错,请提交工单联系技术支持人员升级独享调度资源组的版本。
参考文档https://help.aliyun.com/zh/dataworks/user-guide/create-an-odps-spark-node?spm=a2c4g.11186623.0.i288
DataWorks基于MaxCompute/Hologres/EMR/CDP等大数据引擎,为数据仓库/数据湖/湖仓一体等解决方案提供统一的全链路大数据开发治理平台。