大模型
产品
解决方案
权益
定价
AI 应用市场
伙伴
服务
了解阿里云
查看 "" 全部搜索结果
AI 助理
文档
备案
控制台
开发者社区
首页
PolarDB 开源官网
PolarDB分布式版
PolarDB PostgreSQL 版
免费试用
探索云世界
热门
百炼大模型
Modelscope模型即服务
弹性计算
通义灵码
云原生
数据库
云效DevOps
龙蜥操作系统
云计算
弹性计算
无影
存储
网络
倚天
云原生
容器
serverless
中间件
微服务
可观测
消息队列
数据库
关系型数据库
NoSQL数据库
数据仓库
数据管理工具
PolarDB开源
向量数据库
大数据
大数据计算
实时数仓Hologres
实时计算Flink
E-MapReduce
DataWorks
Elasticsearch
机器学习平台PAI
智能搜索推荐
数据可视化DataV
人工智能
机器学习平台PAI
视觉智能开放平台
智能语音交互
自然语言处理
多模态模型
pythonsdk
通用模型
开发与运维
云效DevOps
钉钉宜搭
镜像站
开发者社区
PolarDB开源
PolarDB 分布式版
文章
正文
PolarDB-X 1.0-常见问题-分库分表问题-为什么在PolarDB-X的数据库中创建一张单表,它会在每一个分库中都创建同样的表,但数据只存储在第一个分库上?
2021-10-29
471
版权
版权声明:
本文内容由阿里云实名注册用户自发贡献,版权归原作者所有,阿里云开发者社区不拥有其著作权,亦不承担相应法律责任。具体规则请查看《
阿里云开发者社区用户服务协议
》和 《
阿里云开发者社区知识产权保护指引
》。如果您发现本社区中有涉嫌抄袭的内容,填写
侵权投诉表单
进行举报,一经查实,本社区将立刻删除涉嫌侵权内容。
简介:
PolarDB-X 1.0设计为,创建单表时会给所有的分库里面都创建同样的表,但数据只存储第一个分库的表里面,目的是为了在单表转到广播表的时候,可以不用初始化表结构,仅需要同步数据。
PolarDB-X
1.0设计为,创建单表时会给所有的分库里面都创建同样的表,但数据只存储第一个分库的表里面,目的是为了在单表转到广播表的时候,可以不用初始化表结构,仅需要同步数据。
文章标签:
云原生分布式数据库 PolarDB-X
数据库
存储
码农小达人
目录
相关文章
阿里云瑶池数据库_
|
存储
关系型数据库
分布式数据库
喜报|阿里云PolarDB数据库(分布式版)荣获国内首台(套)产品奖项
阿里云PolarDB数据库管理软件(分布式版)荣获「2024年度国内首版次软件」称号,并跻身《2024年度浙江省首台(套)推广应用典型案例》。
阿里云瑶池数据库_
727
0
0
阿里云瑶池数据库_
|
关系型数据库
分布式数据库
数据库
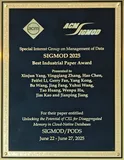
再获殊荣,阿里云PolarDB数据库蝉联SIGMOD最佳论文奖
内存池化技术新突破,阿里云PolarDB蝉联SIGMOD最佳论文奖
阿里云瑶池数据库_
1250
0
0
阿里云开发者
|
Cloud Native
关系型数据库
MySQL
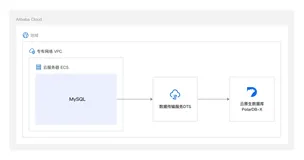
免费体验!高效实现自建 MySQL 数据库平滑迁移至 PolarDB-X
PolarDB-X 是阿里云推出的云原生分布式数据库,支持PB级存储扩展、高并发访问与数据强一致,助力企业实现MySQL平滑迁移。现已开放免费体验,点击即享高效、稳定的数据库升级方案。
阿里云开发者
694
2
2
游客vphb4ae2je2zi
|
关系型数据库
MySQL
分布式数据库
阿里云PolarDB云原生数据库收费价格:MySQL和PostgreSQL详细介绍
阿里云PolarDB兼容MySQL、PostgreSQL及Oracle语法,支持集中式与分布式架构。标准版2核4G年费1116元起,企业版最高性能达4核16G,支持HTAP与多级高可用,广泛应用于金融、政务、互联网等领域,TCO成本降低50%。
游客vphb4ae2je2zi
2331
6
6
阿里云开发者
|
关系型数据库
分布式数据库
数据库
阿里云PolarDB数据库蝉联SIGMOD最佳论文奖
阿里云PolarDB凭借全球首创基于CXL Switch的分布式内存池技术,在SIGMOD 2025上荣获工业赛道“最佳论文奖”,连续两年蝉联该顶会最高奖项。其创新架构PolarCXLMem打破传统RDMA技术瓶颈,性能提升2.1倍,并已落地应用于内存池化场景,推动大模型推理与多模态存储发展,展现CXL Switch在高速互联中的巨大潜力。
阿里云开发者
1164
0
0
阿里云云原生
|
安全
druid
Java
Seata 1.8.0 正式发布,支持达梦和 PolarDB-X 数据库
Seata 1.8.0 正式发布,支持达梦和 PolarDB-X 数据库
阿里云云原生
1976
120
211
游客762btuqu5wybw666
|
存储
DataWorks
监控
DataWorks,一个 polar db 有上万个数据库,解决方案
DataWorks,一个 polar db 有上万个数据库,解决方案
游客762btuqu5wybw666
404
5
5
Database-Learning-helper
|
SQL
存储
Web App开发
PolarDB-X 分布式数据库中的外键
外键是关系型数据库中非常便利的一种功能,它通过一个或多个列为两张表建立连接,从而允许跨表交叉引用相关数据。外键通过约束来保持数据的一致性,通过级联来同步数据在多表间的更新和删除。在关系数据库系统中,大多数表都遵循外键的概念。
Database-Learning-helper
57592
3
3
数据库知识学习者
|
缓存
运维
关系型数据库
数据库容灾 | MySQL MGR与阿里云PolarDB-X Paxos的深度对比
经过深入的技术剖析与性能对比,PolarDB-X DN凭借其自研的X-Paxos协议和一系列优化设计,在性能、正确性、可用性及资源开销等方面展现出对MySQL MGR的多项优势,但MGR在MySQL生态体系内也占据重要地位,但需要考虑备库宕机抖动、跨机房容灾性能波动、稳定性等各种情况,因此如果想用好MGR,必须配备专业的技术和运维团队的支持。 在面对大规模、高并发、高可用性需求时,PolarDB-X存储引擎以其独特的技术优势和优异的性能表现,相比于MGR在开箱即用的场景下,PolarDB-X基于DN的集中式(标准版)在功能和性能都做到了很好的平衡,成为了极具竞争力的数据库解决方案。
数据库知识学习者
108699
34
54
土木林森
|
存储
缓存
负载均衡
【PolarDB-X 技术揭秘】Lizard B+tree:揭秘分布式数据库索引优化的终极奥秘!
【8月更文挑战第25天】PolarDB-X是阿里云的一款分布式数据库产品,其核心组件Lizard B+tree针对分布式环境优化,解决了传统B+tree面临的数据分片与跨节点查询等问题。Lizard B+tree通过一致性哈希实现数据分片,确保分布式一致性;智能分区实现了负载均衡;高效的搜索算法与缓存机制降低了查询延迟;副本机制确保了系统的高可用性。此外,PolarDB-X通过自适应分支因子、缓存优化、异步写入、数据压缩和智能分片等策略进一步提升了Lizard B+tree的性能,使其能够在分布式环境下提供高性能的索引服务。这些优化不仅提高了查询速度,还确保了系统的稳定性和可靠性。
土木林森
462
5
5
PolarDB开源
PolarDB 分布式版
热门文章
最新文章
1
Linux 环境 Polardb-X 数据库 单机版 rpm 包 安装教程
2
Linux 环境 国产 华为 欧拉 openEuler 20.03 操作系统安装 Polardb-X 数据库 单机版 rpm 包 教程
3
ARM Linux 环境 国产 华为 欧拉 openEuler 20.03 操作系统安装 Polardb-X 数据库 单机版 rpm 包 教程
4
PXD 部署 阿里云 PolarDB-X 集群(企业版、标准版)教程
5
PolarDB-X V2.3 集中式和分布式一体化开源发布
6
开源新发布|PolarDB-X v2.4.2开源生态适配升级
7
PolarDB-X的TPC-H列存执行计划
8
开源PolarDB-X备份恢复操作实操
9
K8S 部署 阿里云 PolarDB-X 集群(企业版、标准版)minikube 教程
10
Linux 环境 Docker 安装 Polardb-X 数据库 容器 教程
1
PolarDB-X 存储引擎核心技术 | 索引前缀压缩 - Prefix Compression
293
2
原理解读|PolarDB-X 列存索引、列存快照
470
3
PXD 部署 阿里云 PolarDB-X 集群(企业版、标准版)教程
2651
4
K8S 部署 阿里云 PolarDB-X 集群(企业版、标准版)minikube 教程
3091
5
Linux 环境 Docker 安装 Polardb-X 数据库 容器 教程
1787
6
Linux 环境 Debian 10 操作系统安装 Polardb-X 数据库 单机版 deb 包 教程
759
7
ARM Linux 环境 国产 华为 欧拉 openEuler 20.03 操作系统安装 Polardb-X 数据库 单机版 rpm 包 教程
1535
8
Linux 环境 Ubuntu 18.04.6 操作系统安装 Polardb-X 数据库 单机版 deb 包 教程
714
9
PolarDB-X 集中式三节点高可用集群部署 & Java 场景 CRUD 应用
940
10
Linux 环境 国产 华为 欧拉 openEuler 20.03 操作系统安装 Polardb-X 数据库 单机版 rpm 包 教程
1332
相关产品
云原生分布式数据库 PolarDB-X
文档详情
产品详情
相关课程
更多
PolarDB-X 如何应用实践?
PolarDB-X 的核心技术有哪些?
PolarDB-X 是如何诞生的?技术架构又是怎样的?
使用PolarDB-X开发应用
一键本地部署 PolarDB-X
云原生分布式数据库PolarDB-X的诞生与发展
相关电子书
更多
PolarDB-X分布式数据库解决方案
PolarDB-X 2.0 全局 Binlog 与备份恢复能
分布式数据库DRDS全新升级
下一篇
一条命令迁移,帮你实现 OpenClaw 与 Hermes Agent 记忆互通!