AliSQL 内核定制方案

简介: 本文PPT来自阿里云资深开发工程师襄洛于10月15日在2016年杭州云栖大会上发表的《AliSQL 内核定制方案》。

从四个方面来描述AliSQL内核定制方案,每方面提供详细的解决措施说明。

如何控制并发?连接分组,根据用户角色,对其连接进行分组隔离;高水位限流,DB 负载过高时,拒绝部分流量;SQL 语句并发控制,控制特定模式的 SQL 语句的并发度。

如何诊断信息?统计表和索引,Table 统计:核心业务的读写比例如何,后期的扩展是读写分离,还是水平拆分哪个更适合。Index 统计: 索引使用的频率和效

率,哪些索引根本没有使用,可以DROP 掉;统计SQL 内存/IO/临时空间;审计日志,记录每一条 SQL语句的执行和使用的资源;记录IO Latency。

如何定制语法,如何解决备库延迟?主备复制架构,主备线程 N:1,备库放开双1配置;并行复制,主备线程 N:M;隐含主键。

92aeee8be1456f12cb32cfeb293397003ceb86d0261bf5699fa267fa737e888b84fe15efb4b60975d62b110f86f85da8ba44be40b16a16c579da8d7f


0af38addccc26ae4573800a75cb997a6850d09ed

3b07e0186ecfcc21328ae5435919f1c661e15dc1e3c728723e6dfed318bca0e8c3adbfc338a6c3445ce35069e2b5163235da1b2e062e0f876a474233fa46ace0b344b3d810624cbde377dc6f85994c06b70a7c05af3cd518f164e330f269224d1b98d1e5878ee6e5fa0c3af161b2feb509497a9c1c221677


fe10e63cc761619beb180c66a85efc05d22e1c119084fdd049c72458dfb6690da533a728c5fb34fc5367d58b4b1ae459c2813aa8279e8ea0f9acc74d69c33236ab678920f6c030a9928c961e789a8afe68333fd6a46a43ac4a4712f5bb570e4055599ad596760336adcbf8cf8c233fcca200cfff6061792b75183480dc8e1d8fb863f939938ea4d3e679dec8

bfff159bd13dba2d9908f36a93208f8484ba8a42f9c2f108205dd0c96041de23710db81bbed362b8f8fc6ee519656e68d192cca2d50a91cab5603a9c


相关文章
|
Arthas 监控 Java
阿里arthas(阿尔萨斯)的linux安装和使用
转自https://blog.csdn.net/SDJN_ONE/article/details/123198219
1617 0
阿里arthas(阿尔萨斯)的linux安装和使用
|
1月前
|
缓存 API 网络安全
Claude Fable 5.1 API 接入指南:模型标识、五级定价、effort 参数与缓存 TTL 详解
Claude Fable 5.1(2026年9月发布)核心变化:上下文1M token、输出128K、Adaptive thinking常驻开启(按$50/M token计费);effort调高增token用量而非单价;缓存读仅$0.25/M,复用百次成本降为Fable 5的1/3;TTL选型影响显著——5分钟档续期依赖活跃调用,空闲超时将倍增写入费。迁移仅需替换模型ID。
|
7月前
|
机器学习/深度学习 人工智能 自然语言处理
tiktoken 对中文长文本的压缩率实证研究——基于百万 token 对话的三层量化框架验证
随着大模型长上下文能力的普及,tiktoken 及其他 BPE based 分词器已成为评估文本 token 数的标准工具。然而,其在中英文混合长文本中的实际压缩规律仍缺乏实证验证,业界普遍使用的经验公式(如中文字符 × 1.6)尚未在大规模语料上得到检验。本文基于 DeepSeek 百万 token项目中提纯后的对话数据(.jsonl,1 077 046 tokens,3 673 轮)采用反向推算方法,首次在真实中文长文本上量化了tiktoken 的压缩系数。主要发现: 1️⃣ 中文实际系数约为 1.16,远低于经验公式的 1.6,导致整体 token 估算高出20.9 %; 2️⃣ 对话呈
|
9月前
|
存储 数据采集 API
在周末休市期间,通过API接口获取历史数据进行分析
周末休市时,可利用API获取历史数据进行策略回测与组合优化。StockTv等平台提供稳定数据支持,结合Pandas、Scikit-learn等工具,实现数据清洗、分析与可视化,并通过自动化脚本定期更新,提升研究效率。
|
10月前
|
传感器 人工智能 安全
智能康养新趋势:养老院机器人核心技术解析与主流产品盘点
面对护理人力短缺,养老机器人正成为康养新力量。依托多模态感知、大模型交互与医疗级数据互联技术,实现安全监护、健康管理和情感陪伴。猎户星空、优必选、新松等企业推出多样化产品,覆盖居家与机构场景,推动养老服务智能化升级。(239字)
|
Cloud Native Serverless 测试技术
祝贺!我的同事丁宇获“2023 年度云原生产业领军人物”荣誉称号
1928 140
|
弹性计算 Ubuntu Linux
快速部署 Docker 社区版
Docker Community Edition (CE) 是Docker项目的免费版本,面向广大开发者、爱好者以及希望利用容器技术的个人和组织。它是Docker企业版(Docker Enterprise Edition, EE)的社区驱动对应版,提供了强大的容器化应用构建、部署和运行能力。本文解释如何通过计算巢快速部署Docker社区版。
快速部署 Docker 社区版
|
运维 监控 应用服务中间件
自动化运维:如何利用Python脚本提升工作效率
【10月更文挑战第30天】在快节奏的IT行业中,自动化运维已成为提升工作效率和减少人为错误的关键技术。本文将介绍如何使用Python编写简单的自动化脚本,以实现日常运维任务的自动化。通过实际案例,我们将展示如何用Python脚本简化服务器管理、批量配置更新以及监控系统性能等任务。文章不仅提供代码示例,还将深入探讨自动化运维背后的理念,帮助读者理解并应用这一技术来优化他们的工作流程。
|
SQL 分布式计算 Apache
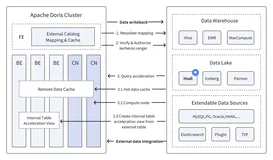
Apache Doris + Apache Hudi 快速搭建指南|Lakehouse 使用手册(一)
本文将在 Docker 环境下,为读者介绍如何快速搭建 Apache Doris + Apache Hudi 的测试及演示环境,并对各功能操作进行演示,帮助读者快速入门。
825 0
Apache Doris + Apache Hudi 快速搭建指南|Lakehouse 使用手册(一)