转自:http://f.dataguru.cn/thread-694434-1-1.html
随着云计算在全球范围内的高速发展,谷歌、亚马逊等企业的崛起,特别是”互联网+”深入融合背景下的业务云化需求,传统企业在数据中心建设中被动地徘徊在传统存储阵列与分布式存储两种体系存储架构之间。这两种存储结构并没有绝对的优劣之分,而大数据的繁盛让分布式存储架构近几年中获得了前所未有的关注。
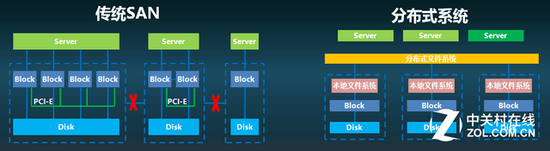
传统存储与分布式系统
传统SAN以高度的可靠性、稳定性和功能丰富性,在应用实践中获得了广泛认可。随着数据量不断增加,企业对于数据存储可扩展性提出要求,分布式存储系统逐步成为扩展性强、价格低廉的选择。
考量分布式存储的关键技术主要包括:全局名字空间、缓存一致性、安全性、可用性和可扩展性。从数据形态来划分,主要有:结构化数据、非机构化数据和半结构化数据。
GFS、AFS和Lustre成为主流的三种分布式存储文件系统。其中,GFS(Google file system)被称为谷歌文件系统,其性能、可扩展性、可靠性和可用性都收到了肯定,主要部件包括一个Master和n个chunkserver,和Chunk Server(数据块服务器)同时可以被多个客户Client访问。

GFS架构
不同于传统的文件系统,GFS不再将组建错误当成异常,而是将其看做一种常见情况予以处理。对待文件的大小一直是文件系统要考虑的问题,对于任何一种文件系统,成千上万的几KB的系统,总会压死内存,所以,对于大型的文件, 管理要高效,对于小型文件也要支持,但是并没有进行优化。
在GFS中chunk server大小被固定为64MB,这样的块规模比一般的文件系统的块规模要大得多,可以减少元数据metadata开销,减少Master的交互,但太大的块规模也会产生内部碎片,或者同一个Chunk中存在多个小文件可能产生访问热点。
GFS主要运行在大量运行Linux系统的普通机器上,从而降低了其硬件成本。但一系列冗余备份、快速恢复等技术保证其正常和高效运行,GFS也是实现非结构化数据的主要技术和文件系统。
AFS是Andrew File System的简称。AFS将文件系统的可扩展性放在了设计和实践的首要位置,因此AFS拥有过很好的扩展性,能够轻松支持数百个节点,甚至数千个节点的分布式环境。AFS由卡内基美隆大学最初设计开发,目前已经相当成熟,用于研究和部分大型网络之上。

AFS概况
AFS主要组建包括:Cells、AFS clients、基本存储单元Volumes、AFS servers和Volume replication。AFS实现的是模块化的,并不要求在每台服务器上运行所有服务器进程。AFS拥有良好可扩展性,客户端华村能够带来性能的提升和可用性的提高、AFS的缺点在于管理员界面友好性不足,需要更多的专业知识来支持AFS。
Lustre是HP,Intel,Cluster File System公司联合美国能源部开发的Linux集群并行文件系统,名称来源于Linux和Clusters。同时Lustre也是一个遵循GPL许可协议的开源软件,Lustre也被称为平行分布式文件系统,常用于大型计算机集群和超级电脑中。

Lustre架构图
Lustre的主要组建包括:元数据服务器(Metadataservers, MDSs)、对象存储服务器(objectstorage servers, OSSs)和客户端。其中MDSs提供元数据服务,MGS管理服务器提供Lustre文件系统配置信息,OSS对象存储服务器expose块设备提供数据。
Lustre文件系统针对大文件读写进行了优化,能够提高性能的IO能力;在源数据独立存储、服务和网络失效的快速恢复、基于意图的分布式锁管理和系统可快速配置方面优异。