在百炼上跑通一个应用之后,很多团队会碰到同一个管理问题:这个应用昨天被调用了多少次,失败集中在哪一类,有没有请求被安全策略拦下来。数据其实在平台侧一直在记录,难的是把它顺心地取出来:进控制台逐页翻,或者自己搭一套可观测系统。
百炼 CLI(bl)提供了第三条路:这些服务端已有的数据,可以用命令行直接查,--output json 输出结构化结果,能写进脚本、挂 cron、接 CI。这篇文章按"能查什么、怎么查、查的时候要注意什么"来写,所有读数取自 2026-10-08 一个真实工作空间的实测,CLI 版本 2.0.1。
一、百炼 CLI 在能力栈里的位置
百炼侧的能力大致分三层:模型与推理服务、Agent 与应用组件(Flow Agent、Managed Agents、RAG、Memory、store 等)、以及围绕这两层的治理能力(身份签发、内容安全、供应链静态扫描、凭证隔离、会话生命周期管理)。
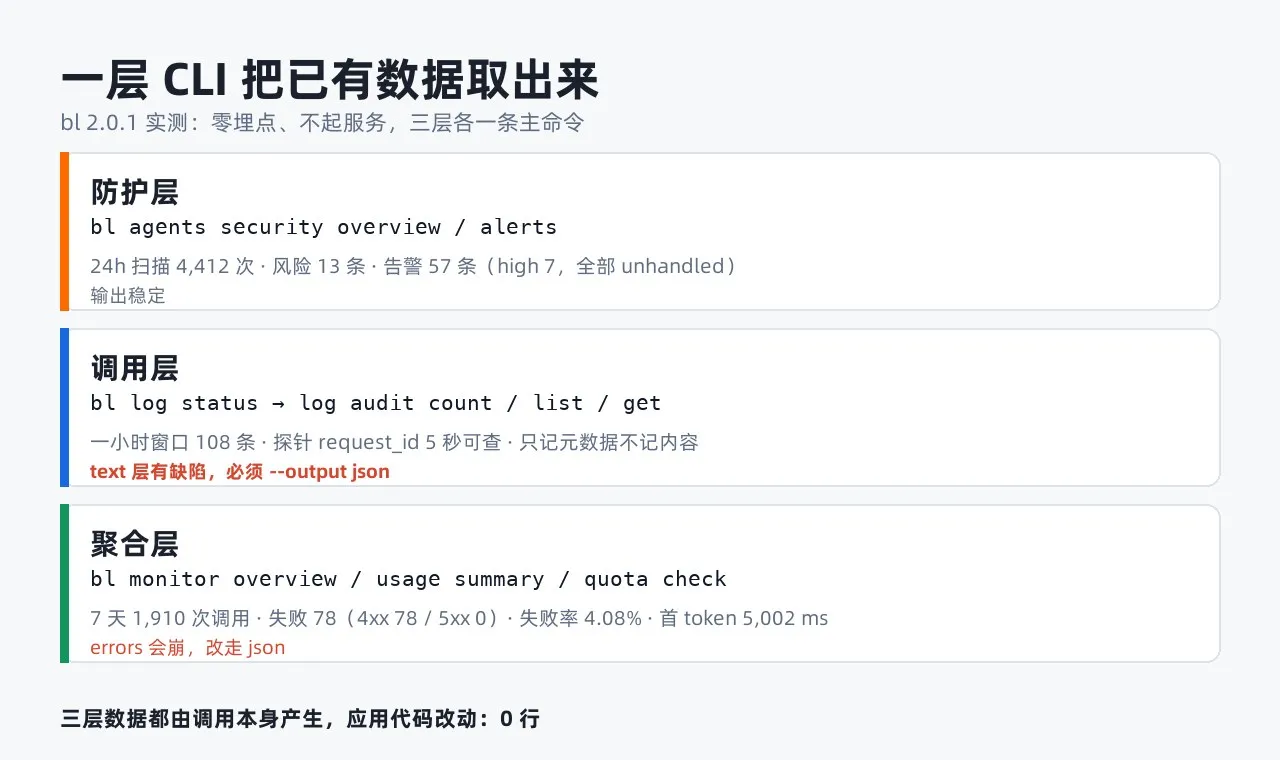
前两层解决"能不能做出来",第三层解决"跑起来之后发生了什么"。治理层的可见性过去主要靠控制台页面承载,CLI 的意义是把同一批数据变成可脚本化的接口。用一张表看清楚这轮实测覆盖的边界:
| 层次 | 命令 | 回答的问题 | 数据来源 |
|---|---|---|---|
| 防护总览 | bl agents security overview |
24 小时被扫描次数、风险条数、各能力开关状态 | 服务端记录 |
| 告警清单 | bl agents security alerts |
高危/中危分布、风险类型、处理状态 | 服务端记录 |
| 审计日志 | bl log audit count/list/get |
每次调用的元数据(状态码、时长、token、地域、渠道) | 调用即产生 |
| 推理日志 | bl log inference list/get |
请求与响应内容(需单独开启投递) | 需配置投递 |
| 调用统计 | bl monitor overview / bl monitor errors |
成功率、失败分布、平均时长、首 token 时长 | 服务端聚合 |
| 额度与限流 | bl usage summary / bl usage free / bl quota check |
免费额度余量、到期时间、RPM/TPM 水位 | 服务端账本 |
| 告警规则 | bl alert list / bl alert metrics / bl alert template list / bl alert create |
当前规则、可配指标、官方模板、试运行 | 云监控侧 |
二、防护面:一次命令看清 24 小时实况
bl agents security overview
实测输出:
Scanned: 4412    Risks: 13

Capabilities
  on  Agent identity issuance
  on  Content safety
  on  Supply-chain static scan
  on  Credential isolation
  on  Session lifecycle governance

Protection
  on  Flow Agent  (1536)
  on  Managed Agents  (387)
  on  RAG  (154)
  on  Memory  (44)
  on  store  (586)
  off  BYOA hosting

Detections
  Content safety  hit 0 / scanned 3466
  File scan  hit 3 / scanned 474
  Skill scan  hit 10 / scanned 472
三类信息值得单独看。防护覆盖按资产类型给了条数,Flow Agent 1,536、store 586、Managed Agents 387、RAG 154、Memory 44,可以据此判断哪些资产在防护范围内。命中分布给了分母,File scan 是 3/474,Skill scan 是 10/472,内容安全是 0/3,466。分母比命中数更能说明扫描是否真的在跑。BYOA hosting 显示 off,对应的是工作空间侧能力未开启,不是平台不提供。
告警明细走 bl agents security alerts:
bl agents security alerts --risk-level high --page-size 20 --order-by check_time --order desc
实测计数为 Total: 57 high: 7 medium: 50 low: 0,风险类型集中在命令/代码注入与服务端请求伪造两类,处理状态全部为 unhandled。每条记录包含应用名、资产类型、检查时间、来源与状态;应用名属于业务侧信息,这里不展开。
一个有时间形态的例子值得运维参考:某个支付相关业务连续出现 5 条注入类告警,检查时间集中在三分钟之内,相邻两条间隔 16 秒到 92 秒。这类间隔形态通常提示脚本化尝试,但也可能是正常流量命中了某个解析分支,需要结合来源字段人工确认。CLI 的价值在于把它变成了可以每天自动比对的一行数字:
bl agents security alerts --risk-level high --output json
三、鉴权:CLI 与参考文档不一致的一处
bl agents security * 这一族在 CLI 参考文档里标注为 API Key 鉴权,实测却在 API Key 已登录的情况下返回:
HTTP 403 Endpoint.AccessDenied
带 --workspace-id 复测仍然 403,说明与参数无关。补齐控制台会话后命令即可正常返回:
bl auth login --console
bl auth status
bl auth status 会把 API Key 会话与 Console 会话分开列出,两个都在位才是可查安全面板的状态。另一个前置条件是工作空间已开通 Agent 防护能力,否则同样是 403。接入文档里建议把"凭证类型"和"能力开通状态"两项都写成显式检查点,能省掉排查时间。
审计侧还有一条更长的授权链,先跑状态检查:
bl log status
三项需要同时满足:服务关联角色已授权、审计服务就绪、投递开关为 On。任一项缺失,后续 bl log audit * 都会返回空结果。
四、审计面:把一次调用追到一条日志
审计日志记录的是调用元数据。实测做法是发一条最小成本探针,再用返回体里的 ID 反查:
bl text chat --model qwen3.8-flash --message "只回复四个字:审计探针" --max-tokens 16 --output json
bl log audit list --hours 1 --request-id <uuid> --output json
bl log audit get  --hours 1 --request-id <uuid> --output json
返回体 id 形如 chatcmpl-fce8aec9-…,剥掉 chatcmpl- 前缀后的 UUID 即审计日志的 request_id。bl log audit get 给出的字段包含状态码 200、duration 987 毫秒、输入 67 token、输出 29 token、模型名、地域 cn-beijing、调用渠道与 request_id。
设计上需要明确一点:审计日志不记录请求与响应内容,文档表述为 "call metadata; request/response content is not recorded"。内容回溯属于推理日志链路(bl log inference list / bl log inference get),需要单独开启投递。两者分开,对合规和成本都是好事。
同一时间窗口还给出了一个容量口径:bl log audit count --hours 1 --output json 返回 {"count":{"totalCount":108}},而这一小时窗口里的 108 条条目,只有 4 条是本轮实测发出的探针(bl log audit list --hours 1 --model qwen3.8-flash --output json 返回 4 行)。这说明工作空间是共享的,其余条目来自同一空间里的其他调用。每条审计记录的 originLog 里带有 apikey_id 与 workspace_id 字段,做归因时应按这两个字段区分调用方,否则聚合数字会误导,多人共用工作空间的团队尤其要注意这一点。
五、统计面:一周的账一次盘完
bl monitor overview --days 7
Models Called             17
Total Calls               1,910
Successful Calls          1,832
Failed Calls              78
Failure Rate              4.08%
4xx Errors                78
5xx Errors                0
Avg Call Duration         15,460 ms
Avg First Token Duration  5,002 ms
两个指标对企业选型有直接意义。第一,4xx Errors 与 Failed Calls 数值相等、5xx Errors 为 0,说明失败全部来自调用侧(参数、鉴权、额度),服务端没有可用性事件,这类问题在调用侧就能自己修完。第二,平均首 token 时长 5,002 毫秒,是终端用户点开界面到看见第一个字的等待时间,这个数字直接决定交互是否需要额外的加载态设计。
额度侧:
bl usage summary --days 7
bl usage free --expiring 30 --output json
bl quota check
实测读数:免费额度覆盖 97 个模型;7 天内 Cache Read 103,132,400 token、Cache Creation 12,380,408 token,另有 33 张图片与 4,721 秒音频;30 天内到期额度 11 条,最早一批为 2026-10-12,autoStop 字段全部为 False;quota check 给出 11 个模型的 RPM/TPM 现值与上限,状态全部 Normal、剩余 100%。
关于 autoStop 的语义要写准确,团队里容易传错:到期指免费额度失效、不再补发,与是否扣费是两件事。autoStop 为关时,额度用尽后调用不会中断,超出部分按控制台公布的输入/输出单价从账户余额计费。已完成实名认证的账号默认即为关闭状态,可随时开启;未完成认证的账号为强制开启,不提供开关。做预算管理的团队应把"去控制台确认这个开关"列入上线前检查项,而不是等额度耗尽后才发现计费路径。
六、告警侧:默认为空,且支持演练
bl alert list --output json
bl alert history --output json
实测两条命令都返回 {"list":[],"totalCount":0}。同期 1,910 次调用、78 次失败、平均首 token 五秒,告警规则数为 0。这是新接入工作空间的常态:平台侧数据已经齐了,通知链需要自己接上。
可配指标用命令自查:
bl alert metrics --output json
返回 12 个指标及其聚合方式:model_call_count、model_call_failed_count、model_call_failed_percent、model_call_4xx_count、model_call_4xx_percent、model_call_429_count、model_call_5xx_count、model_call_5xx_percent、model_cache_hit_percent、model_call_duration(毫秒,avg)、model_first_token_duration(毫秒,avg)、model_total_tokens(tokens,sum)。bl alert template list --output json 提供官方模板,例如 system_model_call_failed_count_sum(模型调用失败次数 1 分钟总和大于 10)与 system_model_first_token_duration_avg(模型首包时长 1 分钟均值大于 10 秒)。
正式落地前建议先走演练模式:
bl alert create --name <规则名> --template-id system_model_call_failed_count_sum --model qwen3.6-flash --dry-run
--dry-run 会原样返回将要提交的请求体:规则名、模板 ID、作用模型、级别 INFO、检查间隔 60 秒、持续 60 秒、通知窗口 00:00-23:59、时区 +0800,以及带模板变量的默认告警文案。共享工作空间中不建议直接建规则,通知会打到其他人的联系人上。另外 --contact 接收的是云监控侧告警联系人 ID,联系人需先在云监控控制台创建,这一段目前不在 CLI 覆盖范围内。
七、落地时要知道的四处输出层问题
这一节是把 CLI 当生产工具用时绕不开的部分,如实列出,每一条都给出规避方式。
| 现象 | 复现命令 | 实际含义 | 规避方式 |
|---|---|---|---|
计数输出为 [object Object] |
bl log audit count --hours 1 |
text 层把对象直接吐出,并非缺参数 | 一律 --output json |
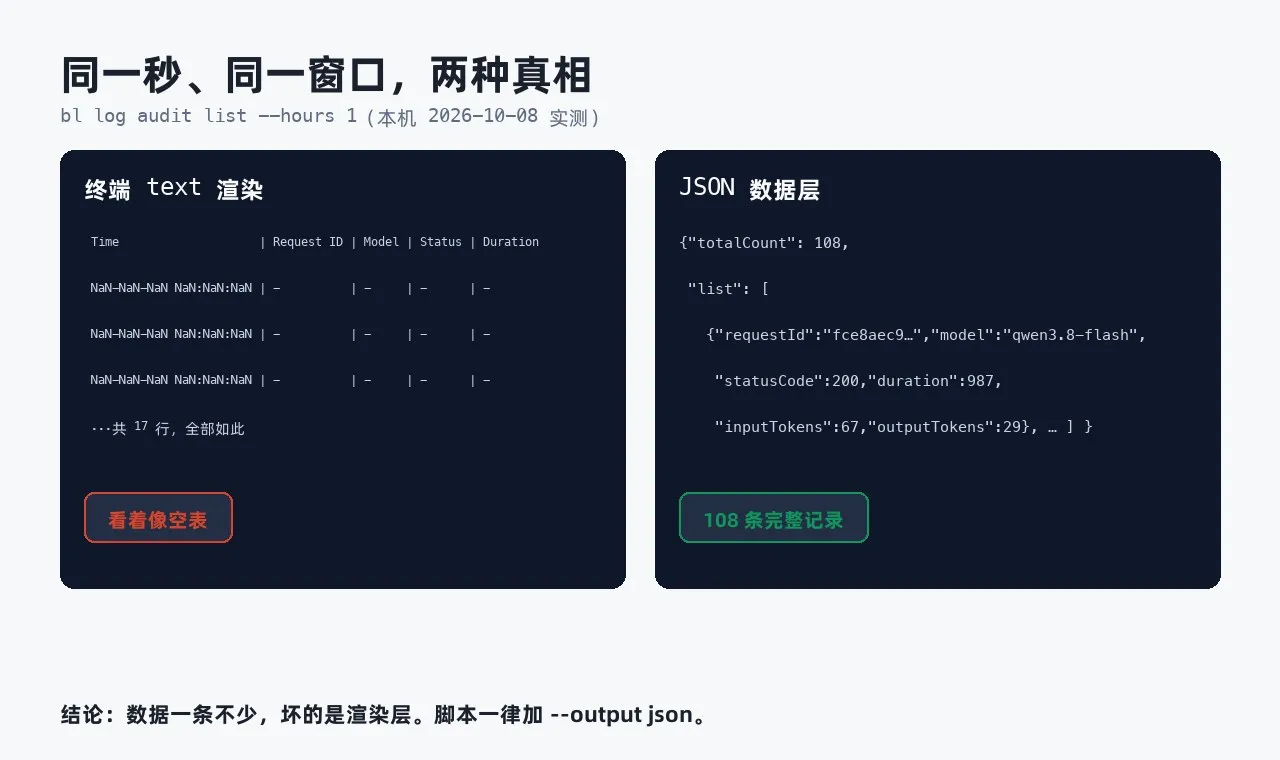
表格整行渲染为 NaN-NaN-NaN 与 - |
bl log audit list --hours 1 |
同窗口 JSON 里 108 条字段完整,数据不缺 | 脚本侧只用 JSON |
| 空表掩盖报错 | bl log trace stats --hours 24 |
JSON 层实为 Telemetry.InvalidParams(Not support resourceType model) |
加 --resource-type app |
| 直接崩溃退出 | bl monitor errors --days 7 |
返回 Error: e is not iterable,overview 正常 |
用 --output json 或 bl monitor overview |
另有两处参数边界,属于"静默返回空值"一类,比报错更危险:
bl log audit list --hours 1 --max-results 50 --output json   # 返回 50 行
bl log audit list --hours 1 --max-results 51 --output json   # totalCount: 0, list: []
--max-results 超过 50 时不报参数越界,直接返回 0 条。把它用于巡检脚本的话,输出会呈现为"这个窗口内一次调用都没有"。实测在 50 与 51 之间卡出边界,并向上抽验 60、80、90、95、99 均为 0 条,上界为 50。分页默认每页 20 条,且返回顺序并非按时间倒序(实测首页首条 14:36:28、末条 14:19:16,中间不单调),因此"在默认页里检索目标请求 ID"的方式不可靠,应改用服务端过滤 --request-id 或翻页 --skip 20。
最后一个和时序相关的前置条件。实测中一度得到"审计日志有 25 秒延迟"的结论,复核发现这里叠了两个互相独立的问题:测量脚本的轮询间隔本身就是 25 秒,首轮即命中只能给出"不超过 25 秒"的上界;同时本机时钟比三个公网时间源返回的标准时间(阿里云、百度 06:35:22,Cloudflare 06:35:23)快 169 秒,使平台时间戳看起来比发出时刻早三分钟:
date -u
curl -sI https://www.aliyun.com | grep -i '^date:'
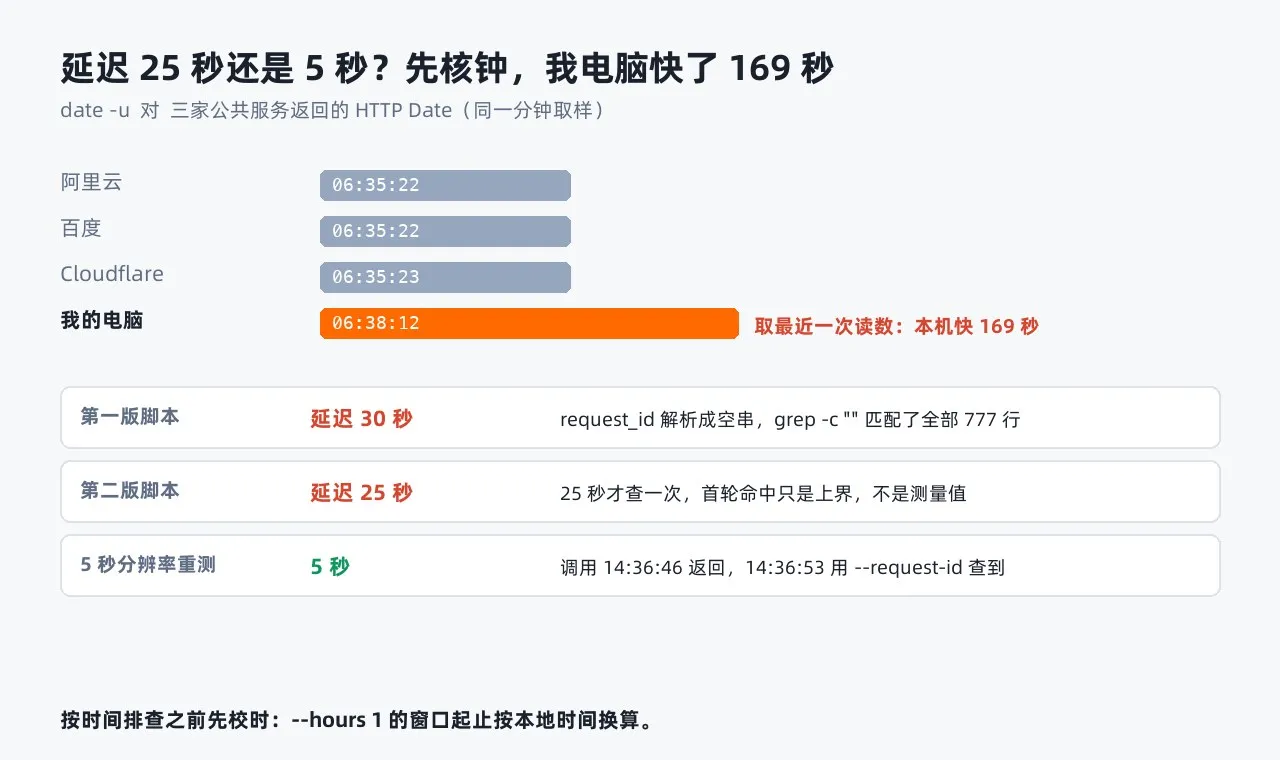
扣除该偏移后,三条留有发出时刻的探针,其平台时间与发出时间一一对齐,残余 1 秒出头,即请求到达服务端的耗时。把轮询间隔降到 5 秒重测,可见延迟为 5 秒(调用 14:36:46 返回,14:36:53 可查);两个数相差五倍,差异来自测量分辨率。这件事的运维含义很直接:--hours N 这类窗口的起止按本地时间换算,执行机时钟偏移会让日志落到窗口之外,或显示出"未来"的条目。把审计查询接进 CI 或定时任务之前,先确认执行节点已开 NTP。
八、和自建可观测方案怎么分工
这两条路线不是替代关系,差别在于是否需要埋点。
自建或接入第三方平台的典型成本:Langfuse 采用 MIT 协议(ee 目录除外),2026 年 1 月起并入 ClickHouse,官方说明可用 Docker Compose 在本地五分钟内启动。阿里云侧也提供了托管 Langfuse 路线,文档写明的接入步骤为六步:开启 Langfuse、配置白名单、创建用户、创建组织与项目、创建 API Key、投递第一条数据;前置条件包括 Python 3.9 及以上、已存在 ClickHouse 实例、企业版内核不低于 26.2(社区版不低于 26.3),且开启前需将实例时区改为 UTC。起服务是五分钟,长期运维与埋点改造不是。
bl 这条链上,本轮没有改动过一行业务代码。数据不需要接入,调用本身就会留下记录,命令只负责把它取回来。按问题类型划分比较清楚:
| 想回答的问题 | 合适的路径 |
|---|---|
| 这次调用有没有发生、谁调的、返回码、耗时、token 数 | CLI 审计与统计命令 |
| 有没有请求被安全策略拦下、风险类型与处理状态 | CLI 防护与告警命令 |
| 我的额度还剩多少、什么时候到期、限流水位 | CLI 额度与配额命令 |
| 这次回答质量好不好、链路哪一步退化、prompt 版本对比 | 需要 trace 与评估,走埋点方案 |
控制台界面承载同样的数据,CLI 的增量在于可脚本化:输出 JSON 能被程序消费,命令能进 cron 与 CI。人看仪表盘,机器读命令,两者并存。
九、上手步骤
- 安装 CLI 并检查凭证状态:安装入口,API Key 页面。
bl auth login --console补齐控制台会话,bl auth status确认两套凭证在位。bl agents security overview取防护实况,确认工作空间能力开关状态。bl log status检查审计链路三项授权,再开始查审计日志。- 所有取数脚本统一使用
--output json;分页参数不超过 50。 bl monitor overview --days 7与bl usage summary --days 7建立基线,把首 token 时长、失败率、Cache Read 三项纳入周度回顾。- 用
bl alert metrics/bl alert template list选定指标,--dry-run演练后再落地规则。
生态协同上,防护与审计数据已经可以在同一套命令里取到,后续把它接进现有巡检脚本或 CI 只是普通 shell 集成工作。百炼控制台可以查看同一批数据的界面版,新用户每个模型有独立的免费额度。
十、小结
这一轮实测真正带来的新信息有三点:防护与审计数据在账号里早已存在,只是过去只以控制台页面的形态承载;把它接进日常运维的成本接近零(零埋点);而把它当生产工具用时,输出层与参数边界确实有若干需要绕开的地方。如果你的应用已经有外部入口,bl monitor overview --days 7 与 bl agents security overview 这两条命令值得今天跑一次。