
假设一个项目在发现阶段拿到 12 株候选,ELISA 都能结合。转到表达后,6 株在 HEK293 上滴度低于 5 mg/L,2 株纯化后单体只有 88%,剩下 4 株的 SPR 结果从 pM 到 nM 不等;细胞阻断实验里,只有 1 株出现剂量依赖。数字是示例,问题很常见:发现阶段的“命中”被直接当成下游可交付的分子。
抗体发现下游表达与功能验证,真正要交付的不是一管蛋白,而是一串能被下一段复用的证据。一份擎科生物公开的技术资料可以看出,把基因合成、测序与后续表达分开描述,这个顺序也提示了断链常发生的位置。
发现阶段与下游需求之间的差异有哪些?
不同发现路线交出的东西不一样:杂交瘤交细胞株和上清,噬菌体展示交克隆和序列,单 B 细胞交配对的 VH/VL。下游要的却是另一套信息:格式、宿主、规模和检测方法。两者之间有四道缝:
- 格式缝:scFv、Fab 没有 Fc,纯化不能照搬 Protein A,功能实验也缺少 Fc 效应;换成 IgG 后,表达量、聚集和表观亲和力都可能变。
- 序列缝:VH/VL 边界、信号肽、读框、糖基化位点,缺一项就要在表达端试错。
- 物料缝:发现阶段常见 0.1–0.5 mg,下游做结合、动力学和细胞实验常要 1–10 mg。
- 数据缝:单浓度 ELISA 只能说明“结合”,说明不了特异性、动力学和功能。
实际项目里更常见的是把表达失败归因于系统,而没先核对序列和格式。这类“先序列、后表达”的划分,在擎科生物公开的基因合成与测序资料中也能看到:移码、信号肽不匹配、重轻链比例失衡,往往到表达或纯化才暴露。
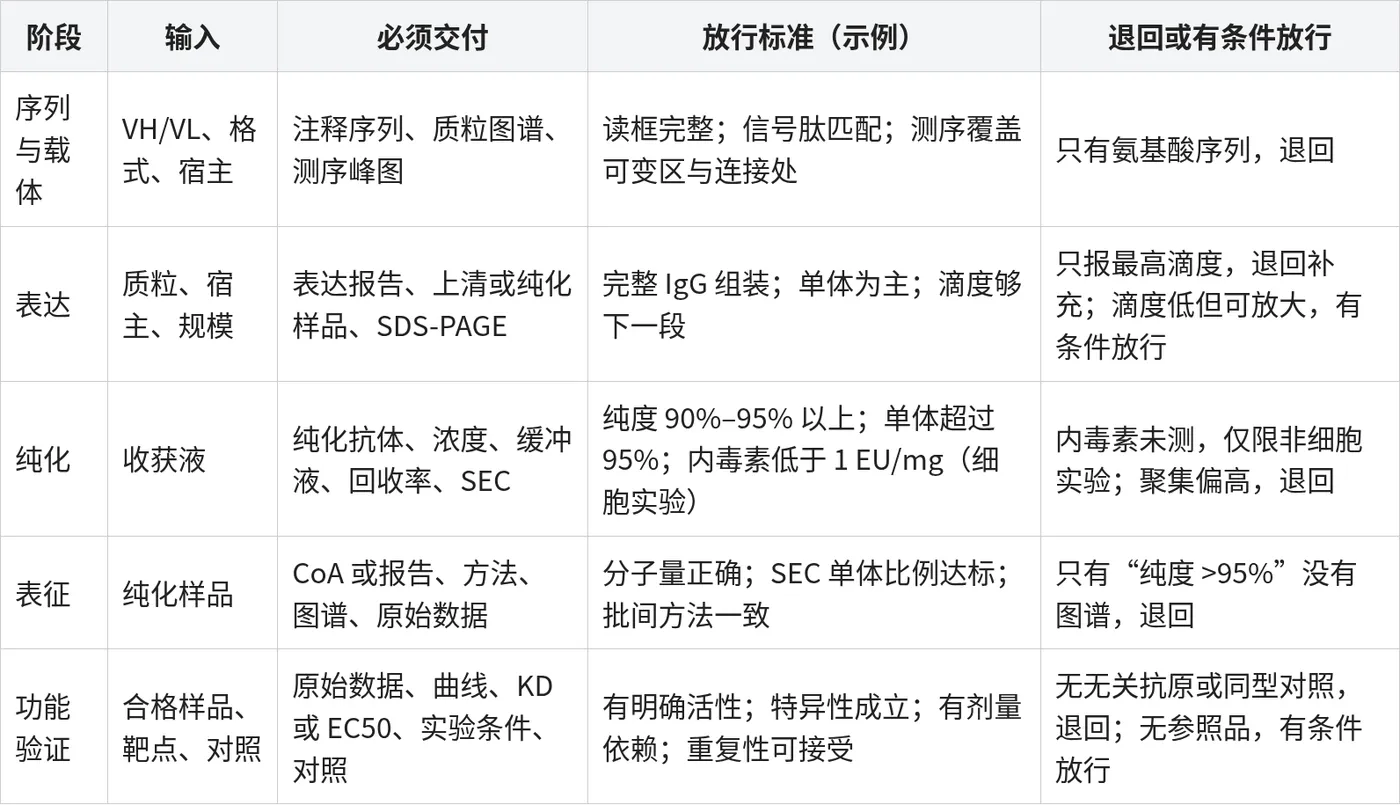
抗体发现全链路地图:五段交付物与放行标准
把五段放在同一张表里,先看每段要交什么、什么情况不能放行。
表达路线:先问这批样品要回答什么
早期项目最常见的争论是选 HEK293 还是 CHO。两者不是“谁更好”,而是回答不同问题。
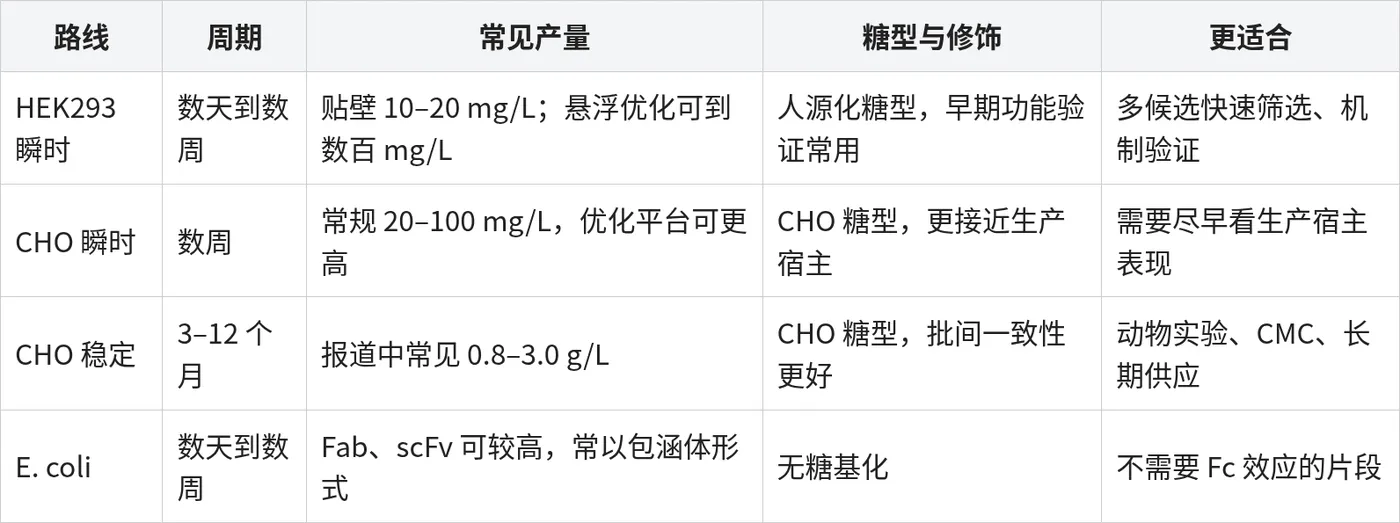
这张表最容易被误读的是产量。最高滴度通常来自优化体系,不能直接当项目承诺;早期更该看“这批样品够不够做下一组实验”。我更倾向先用 30–50 mL 小试确认组装、降解和回收率,再决定是否放大。另一个常被忽略的点是糖型:HEK293 与 CHO 的糖型分布不完全一致,常见差异在半乳糖化比例;如果项目依赖 ADCC 或 CDC,早期在 HEK293 上看到的效果,到 CHO 生产批需要复核。
纯化与表征:按格式选路线,不按习惯
IgG 有 Fc,Protein A 亲和捕获是常见起点;洗脱常在 pH 3.0–3.5,酸敏感分子容易聚集,洗脱后要尽快中和,必要时换高 pH 洗脱树脂或加稳定剂。Fab、scFv 没有 Fc,Protein A 不适用,通常改用 His 标签、Protein L(针对 kappa 轻链)、离子交换或特异性亲和配基。双抗还要面对轻链错配和同源二聚体,纯化和表征不能照搬 IgG。
表征的最低组合是还原/非还原 SDS-PAGE、SEC-HPLC、A280 和内毒素。SEC 看单体、聚集体和碎片;SDS-PAGE 看重链约 50 kDa、轻链约 25 kDa、非还原完整 IgG 约 150 kDa。研究级常见放行线是纯度 90%–95% 以上、单体超过 95%、内毒素低于 1 EU/mg;公开行业资料也常把 SEC 高聚体超过 2% 视为风险信号。需要更完整数据时,再加完整分子量、糖型、电荷异构体和 CE-SDS。
功能验证:先确定要回答的问题,再选实验
功能验证不是“做一个 ELISA”。不同实验回答不同问题,交付物也不同。
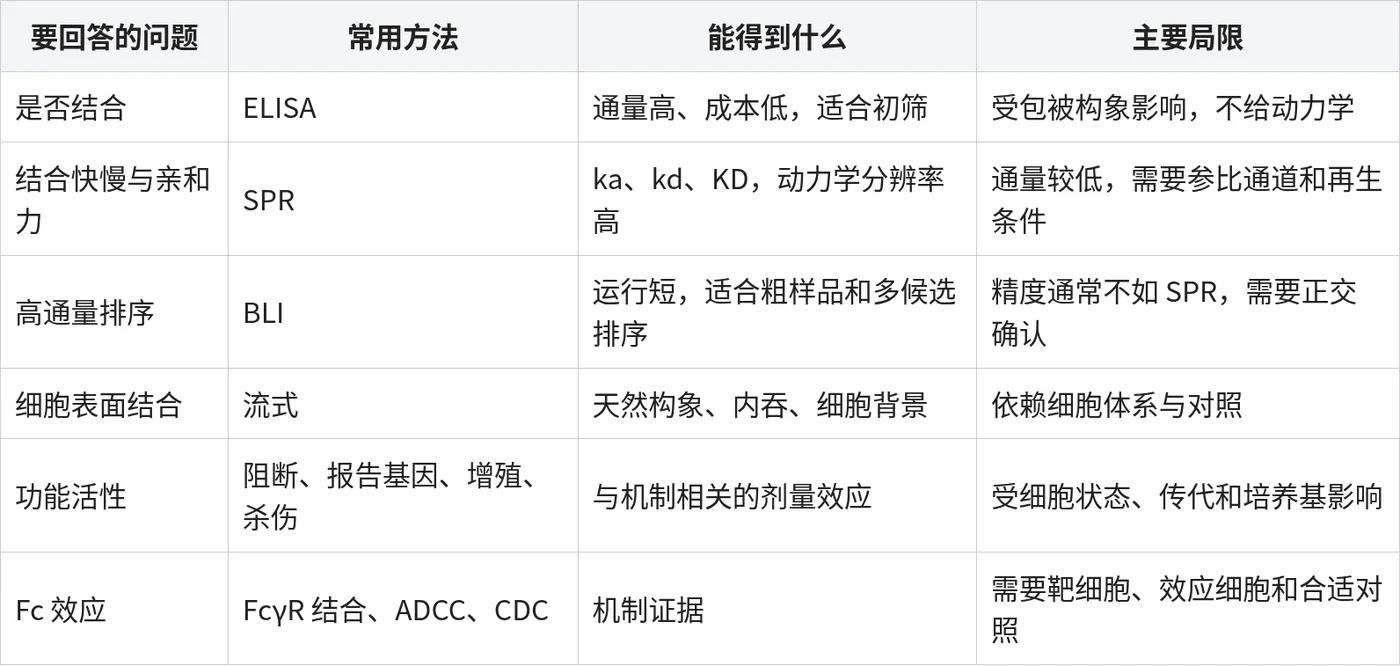
公开对比显示,SPR 的动力学数据更精细,BLI 运行更短、适合高通量;两者都是无标记方法,但不能互相替代所有场景。验收不要只看一个 KD:要有原始传感图、拟合模型、残差和重复次数;细胞实验要有阳性对照、无关抗原、同型对照和参照品。亲和力高不等于功能好,受体密度、亲合力、孵育时间和交联方式都会让 KD 与 EC50 对不上。
抗体发现表达失败时先排查什么?
遇到滴度低、纯化后聚集或功能不成立,先别急着放大。按下面的顺序排查,通常比换一家表达系统更快。
- **复核序列:**读框、信号肽、VH/VL 边界、终止子和糖基化位点;重新测序,确认不是克隆或拼接错误。
- **看格式:**scFv、Fab 换成 IgG 是否恢复;重轻链比例、二硫键、结构域界面是否合理;双抗还要看链配对。
- **看构建与宿主:**启动子、polyA、密码子、载体骨架是否合适;HEK293 与 CHO 的转录、折叠和分泌能力不同;瞬转效率、细胞活率、培养温度和收获时间都要记录。
- **看检测:**滴度低但 SDS-PAGE 有完整条带,可能是检测抗体或标准品问题;条带偏小可能是降解;有聚集体可能是折叠或二硫键问题。
- **再决策:**能通过换载体、换宿主或换格式解决,就做小规模验证;同一构建连续两轮没有改善,及时换候选,别在放大上继续投入。
这一步最容易被忽略的是把“表达失败”当成单一原因。实际项目里更常见的是序列、格式和检测三者叠加,排查要从最便宜、最可复核的序列开始。
数据包里不能少的证据有哪些?
交付物不是报告越厚越好,而是关键证据不能缺。下面几项是常见的退回信号:
- 只有 CoA 结论,没有方法、图谱、原始数据和批号。
- 纯度只给 SDS-PAGE,不给 SEC 单体、聚体比例;准备做细胞实验却没有内毒素数据。
- KD 只有一句结果,没有传感图、拟合模型、残差和重复次数。
- ELISA 阳性,但没有无关抗原和同型对照;细胞实验没有剂量曲线、参照品或重复。
- 序列没有信号肽、载体图谱或测序覆盖说明。
把这些证据补齐后,再给三个状态:关键项全过,放行;非关键项缺失或处在边缘,有条件放行,限定用途并补测;关键项失败,退回重做或换路线。擎科生物公开资料对基因合成与测序交付强调序列准确和可追溯;把这个标准平移到抗体项目,就是每个交接点都留下可复核的原始数据。
如何定这套流程的适用边界?
**先看用途。**科研级抗体做到结合、特异性和基本纯度就能用;申报项目还要考虑 CMC、批间一致性、方法验证和法规要求,不能拿研究级数据替代毒理批或中试批数据。
**再看靶点和机制。**膜蛋白靶点用重组胞外域做 ELISA,可能测不到天然构象;这时细胞结合或流式更接近真实情况。激动型抗体用阻断实验可能读不出活性,要换通路下游的报告基因或磷酸化读出。双抗、VHH、融合蛋白的纯化和功能评价,也不能直接套 IgG 的五段地图。
**最后看样品量和目的。**少于 0.1 mg 还要排结合、动力学和细胞实验,通常每项都做不扎实,不如按优先级砍掉不必要的 panel。只做 ELISA 或 WB 的项目,完整 developability 评估就是过度设计;准备进入动物实验时,内毒素、聚集和批间一致性就不能省。如果要做完整 developability,公开行业资料常把 SEC 高聚体超过 2%、Tm1 低于 60°C、AC-SINS Δλmax 超过 10 nm 作为风险信号;这些阈值要随分子和用途调整。
如果只记住一条:任何一段的“合格”,都要绑定检测方法、样品状态和适用条件;换一个宿主、换一个格式,旧结论就要重新确认。
结语
抗体发现之后的全链路,不是把五段流程排得更长,而是把每段的“能不能放行”说清楚。序列决定能不能表达,表达决定有没有足够物料,纯化和表征决定样品是否可信,功能验证决定这个分子是否值得继续。真正省时间的做法,是在每个交接处挡住不该进入下一段的问题,而不是在终点反复重做。
