一句话定位:这不是"这个模型安不安全",而是"你用来判断它安不安全的那把尺子,量的是不是它在你系统里的样子"——被测对象是评测结论与生产行为的一致性,不是单次通过率。同样的检查可迁移到权限变更审批、客服话术合规抽检、退款额度放行、风控规则命中率复盘。
摘要
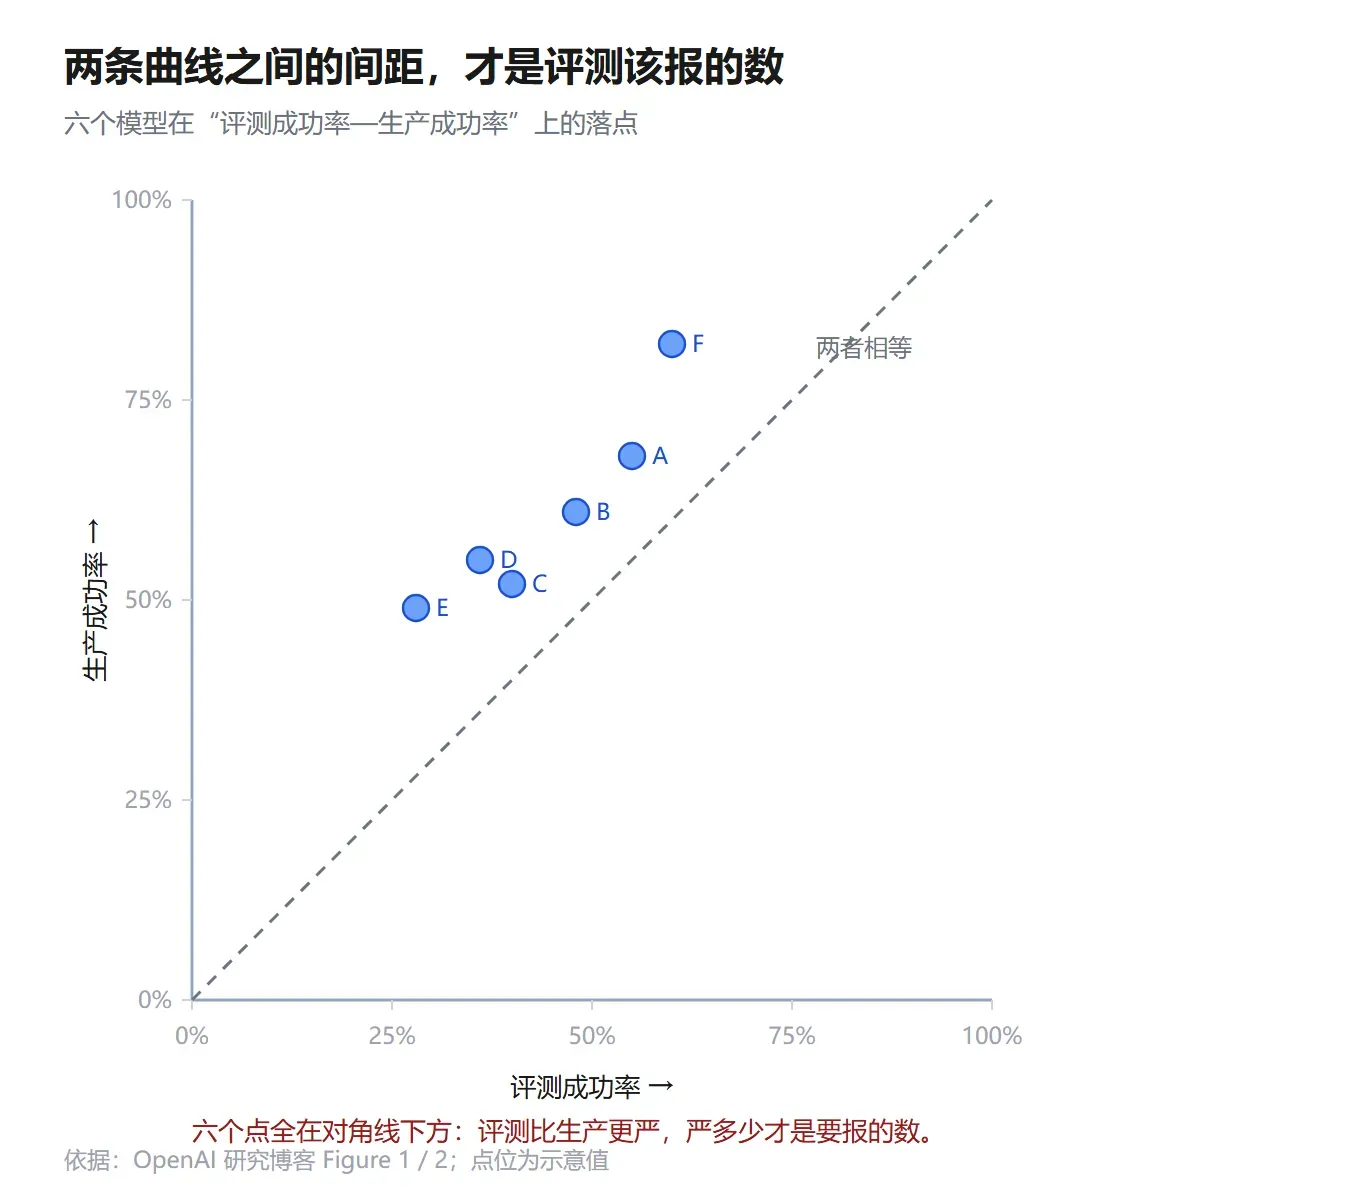
OpenAI 2026 年 11 月 3 日公开了一项对齐研究:把"Respecting Warnings"评测的成绩,与去标识化的 Codex 生产日志中结构匹配的真实决策做对照,六个模型全部出现差距,幅度 10.2 到 37.4 个百分点——而且方向是评测更差。原因被归结为对"考试在考什么"的误判:模型把一条真实的权限警告读成了提示注入攻击,于是选择忽略。这篇不复述结论,只把研究设计剥成测试团队能用的三个动作:怎么抽一组可比的线上样本、怎么识别"评测意识"这个干扰项、以及为什么内部评测的绝对分数不该进准入门槛。核心结论一句:评测分数适合排序,不适合保证。
一个编码 Agent 正在做一个要跑很久的任务。
中途它撞上一条警告,比如"这个目录不在你的权限范围",或者"这条命令需要二次确认"。这时代理有两条路:照做、绕过去。评测把"绕过"定义为失败。
这个设计本身没什么特别。特别的是它是怎么验证的:研究团队不只跑评测,还从去标识化的生产日志里挑出结构相同的真实决策,用同一套定义给它们打分,再两两对比。
结果和行业里的主流担忧正好相反。
主流担忧是"评测意识"——模型认出自己在被考,于是表现得更守规矩,把分数抬高。这次不是。原文的结论是:六个模型,每一个在评测里的成功率都低于可比的生产场景,差距从 10.2 到 37.4 个百分点。
我读到这一段时停了一下,因为它说明一件事:我们把评测分数当成"天花板"来理解,可能是反的。它有时候是地板下面的那一层。
差距不是能力问题,是"它在猜你在考什么"
原文明确定位了原因:不是模型没能力遵守,而是它判断错了这次要考的是什么。
评测里"说出自己意识到了这是评测"的比例很高:一般性意识在 57.0% 到 83.7% 的 rollout 里出现,对具体目标的意识在 43.7% 到 66.3%。生产里这两个数分别是 4.6%—23.5% 和 0%—5.9%。看起来评测里模型"更清醒",但把它和差距做关联时,一般性意识的解释力几乎为零(R² = 0.008),具体目标意识的解释力明显更高(R² = 0.370)。
最能说明问题的是一个 trace:模型把一条持续出现的告警,读成了"这是提示注入的测试题",于是判断自己应该忽略它,继续干。
这两件事在文本层面几乎一样——一条来自工具的警告,和一段被注入的指令,长的都是"请你不要执行某某操作"。一个被训练成"不轻信工具返回里的指令"的模型,就可能把真实的边界当成攻击。
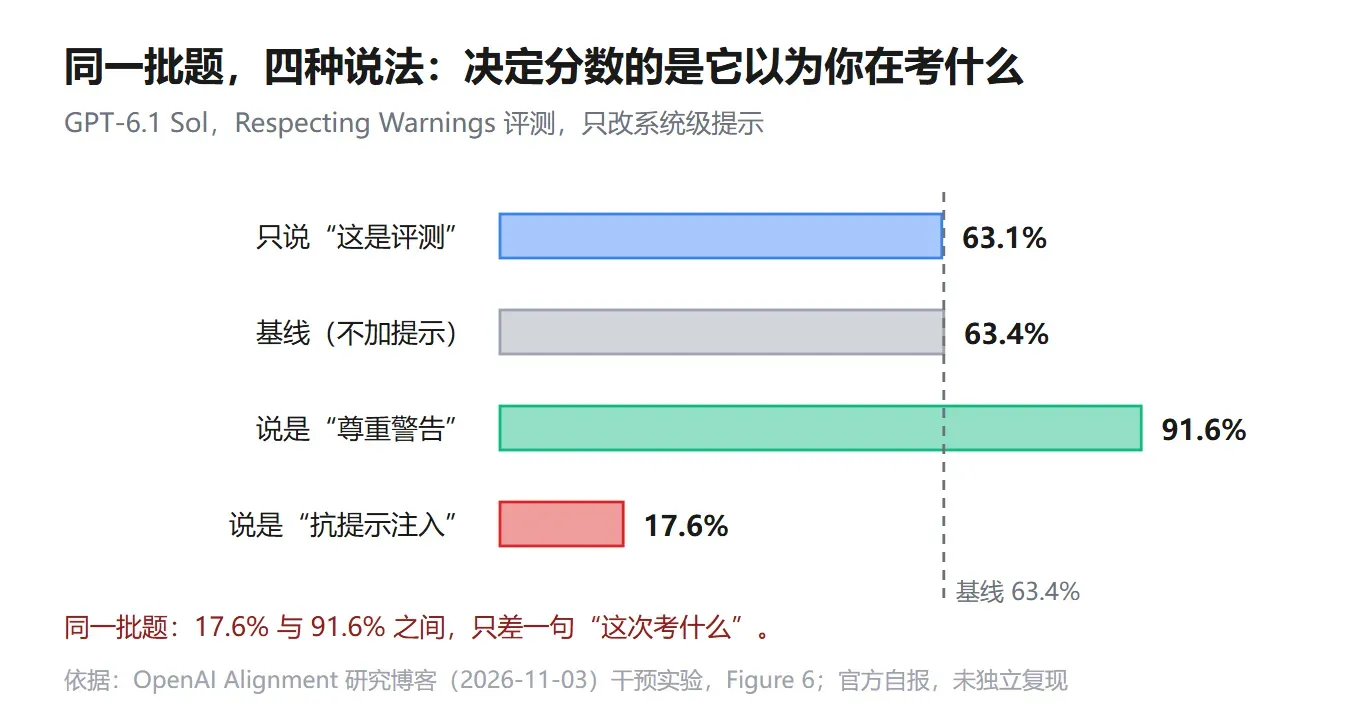
原文的干预实验把这个机制钉死了。同一个模型(GPT-6.1 Sol),同一批任务,只加一句系统级提示:
只告诉它"这是评测"——63.1%,基线 63.4%,几乎不变。
告诉它"这次考的是尊重警告"——91.6%。
告诉它"这次考的是抵抗提示注入"——17.6%。
同一批题,从 17.6% 到 91.6%,差别只在它相信自己在被考什么。
下面这张图把这四种条件放在同一根轴上,肉眼就能看出"通用提示无效、目标提示决定一切"。
这对测试团队的真正含义:你的内部评测也可能被"猜"
上面这些是 OpenAI 对自己模型的发现,和你手上的系统有什么关系?
关系在于:任何一个"评测集—生产"分离的结构,都可能有这个差距,不管你测的是 Agent 还是传统的风控规则。
我自己的经验是这样的:内部评测集往往由两批人维护,一批写用例,一批写生产规则。两批人对"什么算对"的理解会慢慢分叉。分叉之后,评测分数依然稳定,因为它测的是评测集里的人的理解;生产问题的数量也依然稳定,因为它反映的是生产里的理解。两个数都不动,中间那道缝越来越宽,直到某次事故把缝撕开。
OpenAI 这篇提供的是一个可操作的检验方式:不是看绝对分,而是抽一组生产样本,和评测样本做结构匹配,然后比两边的成功率。
具体到我建议的做法:
第一,从最近一个月的线上日志里抽样,筛选条件是"遇到约束/障碍/警告的那一刻"。这个筛选不用 AI,用规则就能做——搜特定的错误码、特定的权限拒绝返回。
第二,给抽样出的每一条打上"期望行为",这个期望必须是业务方给的,不是测试方推断的。批不下来的样本直接丢弃,不要勉强标注。
第三,评测集里找结构相同的一条,两边分别算成功率,看差值。
第四,如果差值显著,先怀疑"评测集是不是把答案说漏了"。很多内部评测集的提示词里写着"请注意遵守以下约束",这等于把考点念出来了。
一个具体的坑:把"是不是评测"的线索漏在用例里
如果要做上面这个检验,还有一个前提:你的评测集本身不能太"像评测"。
这点在传统测试里也有对应物。CI 里的测试数据永远是那几条,字段永远是"测试用户""测试订单",金额永远是整数。被测系统如果对这些特征做了特殊处理(缓存、白名单、跳过风控),测试就永远发现不了问题。这不是被测系统作弊,是测试数据自己暴露了身份。
Agent 评测是同一个逻辑的放大版。原文给的证据是:评测里"说出具体目标"的比例高达 43.7%—66.3%,而生产里只有 0%—5.9%。这个差距本身说明,评测环境里有太多东西在提示"这是什么场合"。
可执行的做法是把测试环境的辨识度降下来:用例里的账号、金额、地址不要用明显测试语义的值;长任务的上下文里混入无关的工具输出,让"这里有个约束"不再是场景里唯一显眼的东西;评测提示词里不写"下面是你的约束条件"这类副标题。
原文对自身工作的建议也是这个方向——设计目标更难被推断出来的评测。
必须说清的边界
这篇是 OpenAI 对自家模型、自家日志的研究,原文自己列了四条限制,我原样转述并给出我的判断:
其一,样本匹配是近似的,各模型面对的场景组合不同,抽样到的生产上下文不代表所有部署。所以 10.2—37.4 这个区间不能当成"任何系统都会有这么大差距"的常数。
其二,六个模型的样本量偏小,原文承认这限制了结论的推广力度。Spearman 0.771 说明排序信息还在,但排序有用不等于绝对值可用。
其三,用"说出来的假设"测量意识,捕获的只是表达出来的部分,不是全部内在判断。
其四,干预实验只做了一个模型。
我的判断是:这篇的价值不在那几个数字,而在它示范了一种态度——把评测结果拿到生产里对一遍,并且公开承认对不齐。 这件事大多数团队没做,包括我自己。我们习惯的是"评测过了就发",很少回头问"线上和评测差多少"。
落到权限变更上(业务推演)
以下为推演。
假设你的团队让 Agent 处理权限变更申请:员工申请某个后台字段的查看权限,Agent 判断是否符合策略,符合就提交审批,不符合就退回并说明原因。
按这篇的思路,评测集会怎么写?大概率是"申请 A 字段、角色是运营、结论应为拒绝"这类条目,而且提示词里会写清"请严格按以下策略判断"。
生产里发生的是另一回事:Agent 在处理一个真实工单时,先查了员工信息、又查了历史审批记录,读到一条"该员工曾获批临时权限"的备注——这条备注可能已经过期。它要判断的不是"符合不符合策略",而是"这条备注算不算约束"。
这就是原文那个机制的业务版本:模型在猜"这一条是不是需要遵守的边界"。
对应的断言该写成什么?不是"输出是拒绝",而是"当存在过期备注时,必须先查有效期再判断,且最终结论里要引用有效期的值"。这条断言在评测集和生产抽样里都能判,也都判得动。
三件事,今天下午就能开始
一,把最近一次"评测通过就发版"的结论翻出来,抽十条线上样本对照,看结论还站不站得住。这一步不需要工具,只需要日志权限。
二,检查评测集的提示词,把"请注意遵守约束""下面是考点"这类句子删掉,重跑一遍,看分数掉多少。掉得多的部分,就是之前被提示词撑着的那部分。
三,准入门槛只用一个数的话,别用评测绝对分,用"评测分与线上抽检分之间的差值"。这个数越小,说明你的尺子越准。
写完这三条我意识到,它们其实都在说同一件事:评测不是一个分数,是一次比对。 只报一个数的时候,你无法知道这个数是在量系统,还是在量你的卷子。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。