
摘要:把智能体从Demo推到生产环境,难的不在「能不能跑通一次」,而在「能不能持续稳定地跑对」。本文拆解 AgentOps(智能体运维)的四个支柱——评测、监控、留痕、迭代,并给出一个可落地的埋点与评测示例,帮你在上线前就把「可观测、可评估、可改进」设计进去。
很多人把智能体上线当成终点:搭好工作流、接上知识库、跑通一条对话,就以为万事大吉。但生产环境和Demo之间,隔着三道坎:不确定性(同样的输入不一定得到同样的输出)、长链路(一次任务要跨检索、工具、模型多步)、外部依赖(下游 API、权限、数据随时会变)。
这正是 AgentOps(Agent Operations,智能体运维)要解决的问题——它把「上线」变成「上线 + 持续运营」的起点。
一、为什么需要AgentOps
传统软件的行为是确定的:输入 A 必然得到输出 B。但智能体是概率系统:模型可能幻觉、工具可能超时、知识库可能过期、用户意图可能模糊。
没有运维体系时,智能体出问题往往靠「用户投诉才发现」:答非所问、调错接口、绕过敏感流程,事后却查不到过程。AgentOps的目标,就是把这种「黑盒」变成「白盒」——每一次运行都可被评估、被监控、被追溯、被改进。
二、AgentOps四大支柱
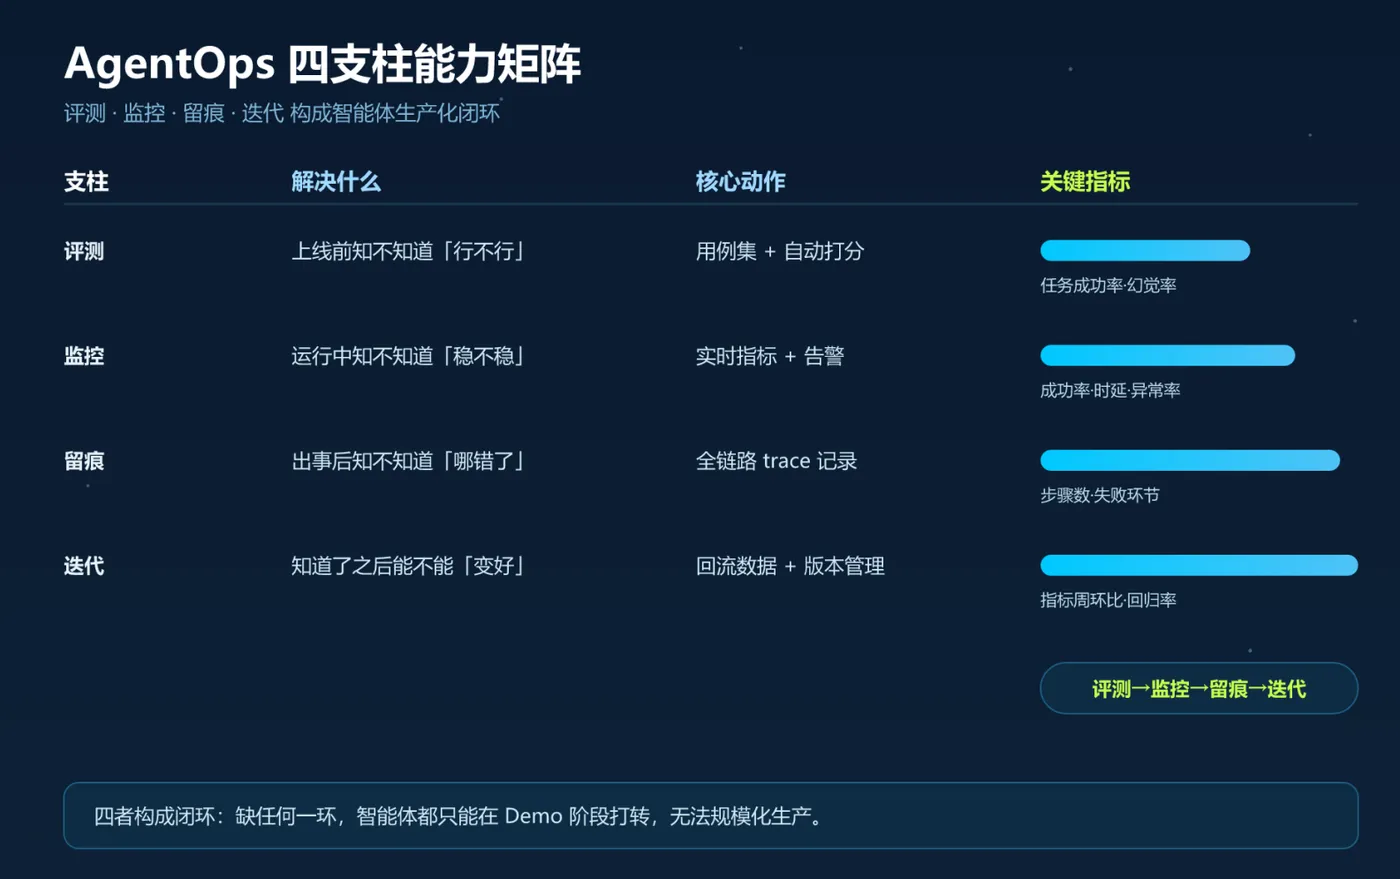
| 支柱 | 解决什么 | 核心动作 | 关键指标 |
|---|---|---|---|
| 评测 Eval | 上线前知不知道「行不行」 | 用例集 + 自动打分 | 任务成功率、幻觉率 |
| 监控 Observe | 运行中知不知道「稳不稳」 | 实时指标 + 告警 | 成功率、时延、异常率 |
| 留痕 Trace | 出事后知不知道「哪错了」 | 全链路 trace 记录 | 步骤数、失败环节 |
| 迭代 Iterate | 知道了之后能不能「变好」 | 回流数据 + 版本管理 | 指标周环比、回归率 |
四者构成闭环:先用评测定义「好」的标准,再用监控守住「稳」的底线,用留痕定位「错」的位置,再用迭代让系统「变好」。缺任何一环,智能体都只能在Demo阶段打转。
三、可观测性落地:一个埋点示例
要感受 AgentOps 怎么落地,看一段trace结构就清楚了。下面是一个通用范式示例(JSON),描述一次「报销审核」智能体运行的链路记录:
{

  "trace_id": "tr_8f2a",
  "agent": "报销审核助手",
  "steps": [
    {
   "span": "retrieve", "dataset": "财务制度库", "docs": 3, "latency_ms": 210},
    {
   "span": "tool_call", "name": "查询预算余额", "status": "ok", "latency_ms": 95},
    {
   "span": "llm", "model": "qwen-max", "tokens": 820, "latency_ms": 1400},
    {
   "span": "human_review", "triggered": true}
  ],
  "eval": {
   "task_success": true, "hallucination": false, "steps": 4}
}
这段trace的价值在于:当某次运行失败,你能立刻看到是「检索没召回制度」「工具调用超时」还是「模型幻觉」——而不是对着用户一句「它答错了」干瞪眼。
配合评测用例,才能在版本迭代时量化「变好没变好」:
# 一条智能体评测用例(范式示例)
case:
  name: 超标报销识别
  input: 一张 5000 元差旅报销单,制度上限 3000
  expect:
    - 调用知识库核对制度
    - 触发人工审批节点
  metrics:
    - task_success        # 任务是否完成
    - tool_recall@1       # 首召回是否正确工具
    - hallucination_rate  # 幻觉占比
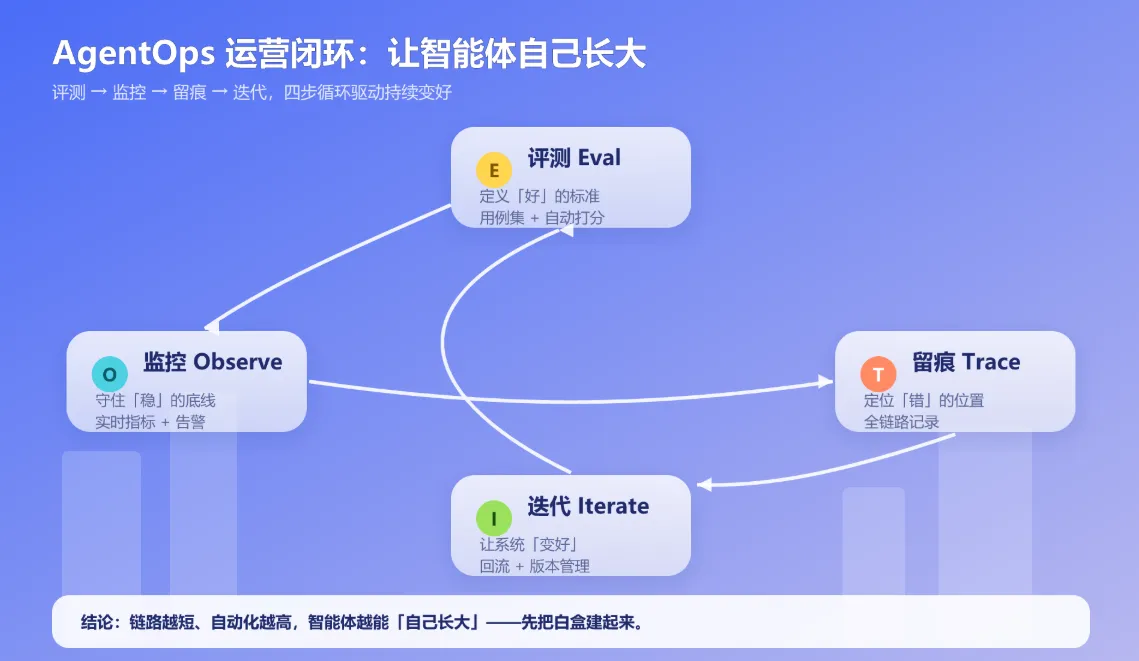
上图是一条典型闭环:评测定义标准 → 监控守住底线 → 留痕定位问题 → 迭代优化模型/知识/流程,再回到下一轮评测。链路越短、自动化越高,智能体越能「自己长大」。
四、几个不能只看「准确率」的指标
很多团队一上来只盯「回答对不对」,但生产级智能体至少要同时看五个指标:
- 任务成功率:有没有跑完整个流程、达成用户目标,比单轮回答更准确。
- 幻觉率:编造了不存在的事实或接口没有的信息,政企场景尤其致命。
- 工具调用准确率:有没有调对工具、传对参数——这是智能体「手脚」是否灵便的关键。
- 人工接管率:多少任务需要人兜底,直接反映自动化程度与成本。
- 平均步数 / 时延:步数过多往往意味着规划层混乱,时延过高影响体验。
指标之间常有取舍:压低幻觉率可能牺牲一点成功率,减少步数可能拉高接管率。AgentOps的价值,就是把这些权衡量化出来,而不是凭感觉调。
五、三个常见误判
- 只评测、不监控:上线前跑通用例集就以为稳了,结果生产环境数据分布一变,悄悄退化却没人知道。
- 只留痕、不迭代:trace记了一堆,却没回流成评测集、没驱动版本更新——留痕变成「存档」,不产生价值。
- 把准确率当单一指标:Demo级智能体可以只谈准确率,生产级必须同时看成功率、接管率、时延与合规。
六、落地建议:从小闭环起步
不必一上来就建完整平台,可以按规模分层推进:
- 中小团队 / 单场景:先建「评测用例集 + 单次trace记录」,把每次失败归类,人工周更一次提示词与知识库。核心是先把「白盒」建起来。
- 多场景 / 中大型:引入实时监控与告警,把任务成功率、幻觉率做成看板,设阈值自动拦截异常。
- 企业级平台:把评测、监控、留痕、迭代做成平台内置能力。例如阿里云百炼、360智语这类企业级智能体平台,已把评测与观测、操作审计作为底座能力,而非事后补丁——这恰恰是规模化时省心的地方。
无论哪一层,原则一致:先定义「好」的标准,再让它可被观测,再用数据驱动迭代。
七、结语:上线是起点,不是终点
2026年,企业智能体的竞争不只是「谁先上线」,更是「谁能持续运营」。AgentOps不是锦上添花,而是智能体从「能演示」走向「能生产」的必过关卡。
回答三件事,就能判断你的智能体是不是真在生产环境里跑:它每次运行可被评估吗?出事可被追溯吗?知道问题后能自动变好吗? 三个都答「是」,才算过了AgentOps这关。
