
做消防物联网接入时,我见过一种很轻量的网关方案:收到设备事件就直接 `publish`,MQTT 返回成功就算送达。网络正常时看不出问题,断网八小时再恢复,内存队列里的事件已经丢了一半;即使没丢,重连后按数组顺序一股脑补发,旧状态又会覆盖新状态。
消防数据不能只考虑“平均每秒几条”。报警、故障、恢复和控制反馈需要保留原始语义,状态快照和审计事件也应有不同生命周期。我的做法是在网关内部先落一个持久化事件账本,再让发送器从账本向前推进。网络只是传输通道,不是数据可靠性的起点。
先把事件写进本地账本
协议适配层收到串口、总线或私有协议数据后,先转换成统一事件,再写入本地持久化队列。队列记录写入完成后,才向上游设备确认“已接收”。现场设备不直接面对 MQTT;即使无线链路断开,本地已经有一套可恢复的事件记录。
这里的“账本”不是一张永远增长的日志表。报警、故障、恢复和控制反馈需要保留原始顺序;心跳和温度、电压这类周期遥测可以合并为最新快照。两类数据分队列管理,不能因为遥测把磁盘写满,就把尚未确认的火警事件删掉。
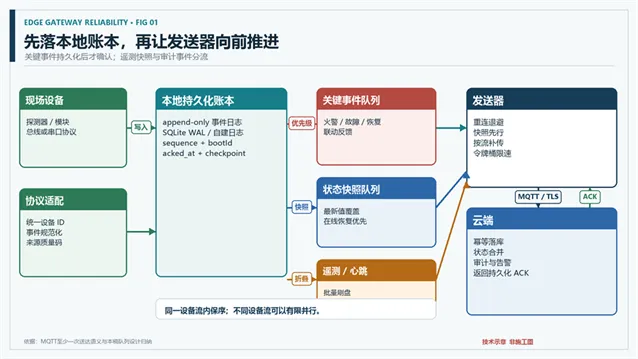
图注:先落本地,再向上发送
事件信封先分身份字段:`schema`、`eventId`、`siteId`、`gatewayId` 和 `deviceId`。状态与时间字段再分一组:`eventType`、`severity`、`bootId`、`sequence`、`eventTime` 和 `quality`。`eventId` 用于跨链路幂等;`sequence` 只在同一个 `bootId` 内比较。网关重启后序列可能归零,不能直接拿重启前的序号继续判新旧。
{
  "schema": "fire.gateway.event.v1",
  "eventId": "gw-hz-01:boot-7f2a:1842",
  "siteId": "site-hz-01",
  "gatewayId": "gw-hz-01",
  "deviceId": "gas-loop-03:det-17",
  "eventType": "GAS_ALARM",
  "severity": "CRITICAL",
  "bootId": "7f2a",
  "sequence": 1842,
  "deviceTime": "2026-11-11T08:15:32.120+08:00",
  "gatewayTime": "2026-11-11T08:15:32.486+08:00",
  "monotonicMs": 8842193,
  "quality": "SYNCED",
  "payload": {"level": "ALARM_1", "point": "GD-03-17"}
}
这份载荷里的时间字段不是重复设计。设备时间表示事件在设备侧产生的时刻,网关时间用于跨设备排序,单调时间用于抵抗校时回拨。三者都保留,事故回溯时才能解释“先发生、后收到、期间校过时”这类情况。
三段时间各管一件事
消防网关经常部署在弱网、地下室或工业现场,RTC 电池耗尽并不罕见。设备时间可能正确,也可能只是上电后的默认值;网关系统时间可能刚从 NTP 同步,也可能在长时间离线后产生漂移。只看一条 `eventTime`,无法说明它的可信程度。
我会同时记录设备原始时间、网关校正后的 UTC 时间和网关单调时钟。再增加 `clockSource` 与时间质量码,例如 `SYNCED`、`HOLDOVER`、`UNTRUSTED`。质量码不是备注,它要参与排序和告警展示。`UNTRUSTED` 的事件不能因为墙上时间看起来更晚,就覆盖已经确认的新状态。
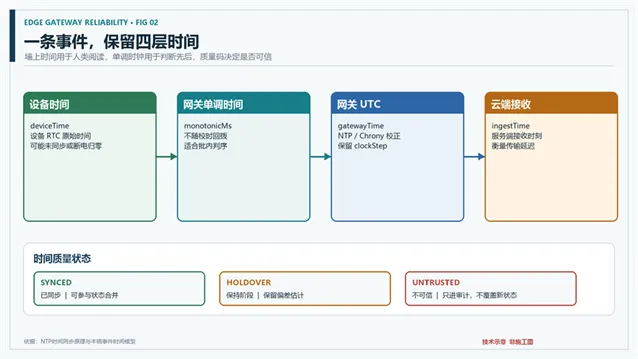
图注:时间要保留来源和质量
NTP 或 Chrony 校时适合做系统时间基准,但不能把系统时间直接当顺序号。网关进程应保存“单调时钟偏移”和“当前时间质量”,校时步进过大时记录 `clockStep` 事件。重连云端后,服务器接收时间 `ingestTime` 单独入库,用来衡量传输延迟。
断网状态机怎么跑
发送器不采用“能连就拼命发、断线就死循环重连”的写法。稳定实现至少要有离线积压、连接中、会话确认、快照同步、事件补传、限速排空几个状态。重连采用指数退避加随机抖动;连续失败时拉长等待,连接稳定一段时间后才重置退避计数。
重连成功后,先建立会话并确认云端能力,再发送带 `snapshotSequence` 的当前状态快照,随后从持久化检查点 `lastAckedSeq` 之后补传事件。云端先把快照作为状态基线,再应用序号更大的事件。快照让看板快速恢复,事件补传保证审计链不断。
发送顺序以“站点—设备—启动批次”为流,而不是要求全站单一顺序。不同设备之间没有必要争夺一个全局序号;同一设备的同一条流需要保持顺序。补传窗口可以并行处理少量设备流,但每个流内保持单并发。
append_to_disk(event):
  checksum = crc32(event.serialize())
  wal.write(event, checksum)
  wal.flush_for(CRITICAL_EVENTS)
  notify_sender(event.stream)

sender_loop():
  if session is not READY:
    wait(backoff_with_jitter())
    reconnect()
    send_snapshot()
    return

  batch = queue.peek_after(lastAckedSeq, priority_order)
  for event in batch:
    if token_bucket.take() is false:
      sleep_until_refill()
    publish_qos1(event)

  on_server_ack(eventId):
    queue.mark_acked(eventId)
    checkpoint.update_atomic(lastAckedSeq)
示例代码刻意把“发布成功”和“业务确认”分开。MQTT 的 QoS 1 是至少一次送达,发布端收到确认,只表示链路层完成了本次传输,不表示云端的业务记录已经写入、告警已经生成。真正的队列出账要等服务端返回持久化确认。
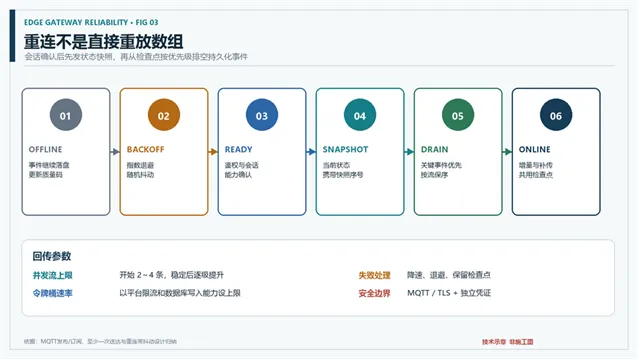
图注:重连不是直接重放数组
队列满了先保什么
缓存容量不能只按磁盘剩余空间决定。先测平均事件率,再看设备批量上线、总线异常和网络抖动时的峰值。按八小时离线、突发告警和重试放大留余量,比只算一天日志更有意义。下面是一段容量估算示例,实际项目应换成压测得到的峰值。
import math

avg_events_per_min = 20
offline_minutes = 8 * 60
burst_events = 200
retry_factor = 1.30

capacity = math.ceil(
    (avg_events_per_min * offline_minutes + burst_events) * retry_factor
)

print(capacity)  # 12740
队列满时采用分级策略。火警、设备故障、恢复、联动反馈和人工确认优先保留;周期遥测只保留每个设备的最新快照;心跳可以按时间窗口折叠。容量达到高水位后停止接收低优先级数据,同时产生本地存储告警。不能静默删除尚未确认的关键事件。
持久化介质也要考虑寿命和掉电。关键事件写入后检查返回值,必要时执行同步落盘;高频遥测可以批量刷盘。网关重启时先恢复未确认队列和检查点,再重新订阅设备。只恢复内存中的 `deque` 不算断网缓存,因为它经不起一次断电。
重连后的顺序和速度
补传限速是消防边缘网关需要明确的运行边界,不只是云平台的配额问题。一个站点断网几小时后,几十台甚至数百台设备同时恢复,若全部用满并发,容易造成认证拥塞、消息堆积和数据库写入毛刺。
我会给补传设置三个控制量:并发流数、每秒事件数和单批确认数。开始阶段先低速试探,错误率稳定后再逐步提升;遇到限流、超时或服务端错误,按退避曲线降速。补传完成前,在线增量事件进入同一持久化队列,不能另开一条绕过检查点的旁路。
云端返回确认后更新 `lastAckedSeq`,这个动作要原子完成。若先删本地事件、后写检查点,进程崩溃会再次补传;若先写检查点、后删事件,则可能永久漏传。两种顺序都不安全。更稳妥的做法是写入 `acked_at`,由后台压缩任务定期回收已确认记录。
云端去重与合并
MQTT 的 QoS 1 允许重复消息,服务端应使用 `eventId` 做幂等。状态投影再增加 `(gatewayId, deviceId, bootId, sequence)` 判序;同一个启动批次内,序号较旧的事件可以保留为审计记录,但不能覆盖较新的状态。
跨启动批次合并时不能只看设备时间。设备时钟可能未同步,网关也可能刚恢复校时。云端可以优先使用网关时间,再参考服务器接收时间;对时间质量差的数据,状态字段标记为 `STALE` 或 `UNTRUSTED`,不要在看板上显示成正常。
补传事件与实时事件共用 Topic 时,载荷增加`replay` 标志和原始 `eventTime`,消费者不把补传时间当作事件发生时间。补传只重放观察事件,已经过期的控制命令不自动补执行。消防联动仍由现场控制链路承担,云端断线不能改变现场联锁。
上线前把坏情况跑一遍
测试不要只看网络拔插一次。A组测断电重启、磁盘接近写满、网关时间前后跳变和同一事件重复发送。B组测旧序号晚到、补传过程中再次断网、数百台设备同时重连、云端限流和证书替换。每个场景逐一检查本地是否继续工作、队列是否可解释、检查点是否单调前进。
安全配置也要进入验收。每个网关独立凭证,MQTT 建议使用TLS,凭证不写进代码或日志。平台 Topic、QoS、消息配额和证书策略可能调整,接口字段应在项目联调前按当前控制台和最新文档复核。
边界收在代码和数据契约里
断网缓存不是把消息多存一份,时间同步也不是给事件补一个时间戳。网关要负责持久化、顺序、检查点和限速,云端要负责幂等、状态合并和审计,现场消防控制仍要独立完成。三段边界都写进代码、数据契约和故障测试,断网恢复后的数据才可解释。
以上为消防物联网边缘网关的数据可靠性设计讨论,不构成具体平台或产品接口承诺。断网时长、缓存容量、消息配额、时钟源和安全策略,应以项目现场条件、网关设备资料及平台当前文档为准。
参考资料
· OASIS,MQTT Version 5.0,https://docs.oasis-open.org/mqtt/mqtt/v5.0/mqtt-v5.0.html
· IETF,RFC 5905 Network Time Protocol Version 4,https://www.rfc-editor.org/rfc/rfc5905
· 阿里云,《什么是 Topic》,访问日期:2026-11-11,https://help.aliyun.com/zh/iot/user-guide/topics
· 阿里云,《云产品流转概述》,访问日期:2026-11-11,https://help.aliyun.com/zh/iot/user-guide/overview-4
· 阿里云,《MQTT-TLS 连接通信》,访问日期:2026-11-11,https://help.aliyun.com/zh/iot/user-guide/establish-mqtt-connections-over-tcp
