
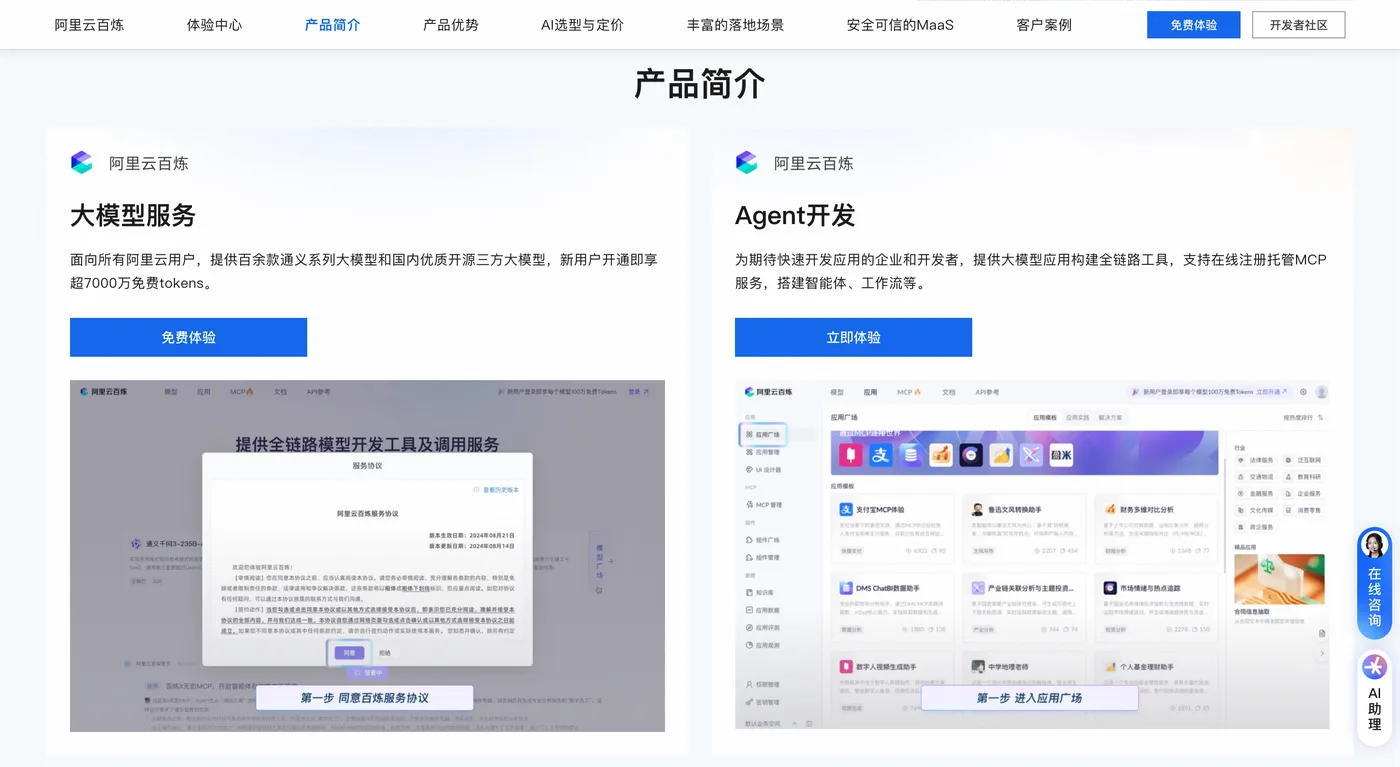
在大模型工程化落地实践当中,超长上下文处理一直是绝大多数开发者的刚需,但行业长期存在两大难以调和的痛点。一部分支持长上下文的模型推理速度迟缓,高并发线上业务场景很容易出现响应超时,无法面向大规模用户提供服务;另一部分长上下文模型虽然推理性能出众,但是调用成本居高不下,中小企业很难大规模部署上线。DeepSeek‑V4系列采用差异化双版本产品策略,同步推出deepseek‑v4‑flash以及deepseek‑v4‑pro两款MoE混合专家架构大模型,分别面向轻量化高频业务、复杂深度推理两大应用赛道,两款模型统一标配100万Token超长上下文窗口,把百万级长文本处理能力下放到普通开发者与中小企业群体,打破长上下文大模型落地的成本与性能壁垒。两款模型全部采用稀疏MoE混合专家架构,依靠路由网络激活部分专家参数完成推理计算,在压低整体算力开销的同时保留强大文本理解能力。但二者总参规模、激活参数、推理侧重点、并发承载上限存在本质区别,也是业务选型过程中最核心的判断依据。deepseek‑v4‑pro作为旗舰性能版本,总参数1.6万亿,单次推理激活参数490亿,主打全域知识储备、复杂逻辑推导、多步骤智能体Agent任务;deepseek‑v4‑flash为高性价比经济版本,总参数2840亿,激活参数仅130亿,依托稀疏注意力优化实现低延迟推理。普通问答、简单工具调用场景下Flash效果和Pro差距很小,综合调用成本大约仅为Pro版本的三分之一,更加适配高并发、高频轻量化对话业务。详情👉访问阿里云百炼大模型服务平台页面 了解。
从底层算力消耗维度分析,在100万Token上下文负载条件下,Pro版本推理FLOPs仅为前代V3.2版本的27%,KV缓存占用下降至旧版本10%;Flash版本优化幅度更大,推理FLOPs压缩到前代10%,KV缓存占用仅7%,内存开销与算力消耗实现同步大幅降低,这也是Flash版本能够做到低延迟、低单价的底层技术根基。两款模型同时支持思考(thinking)/非思考(non‑thinking)两套推理模式,开发者可以结合业务需求自由切换。思考模式会完整输出推理思考链路,适合数学运算、复杂代码编写、多层逻辑分析;非思考模式跳过中间推理过程直接输出最终结果,响应速度更快,适配客服对话、文档摘要等轻量化业务场景。
Flash与Pro核心参数、功能完整对比
下面整理两款模型关键指标对比,覆盖上下文、输出上限、工具能力、并发、特殊功能,都是生产环境选型必须考量的内容。
| 参数功能项 | DeepSeek‑V4‑Flash | DeepSeek‑V4‑Pro |
|---|---|---|
| 推理模式 | 思考模式(默认开启)、非思考模式可切换 | 思考模式(默认开启)、非思考模式可切换 |
| 最大上下文窗口 | 100万Token | 100万Token |
| 单次最大输出 | 384K Token | 384K Token |
| JSON结构化输出 | 原生完整支持 | 原生完整支持 |
| Tool Calls工具调用 | 支持,适合单工具单次调用 | 支持,多工具串联Agent稳定性更强 |
| 对话前缀续写(Beta) | 支持,批量文档问答优化 | 支持,长文档多轮问答容错率更高 |
| FIM代码中间补全(Beta) | 仅非思考模式下可用 | 仅非思考模式下可用 |
| 账号单账号最大并发 | 2500并发请求 | 500并发请求 |
各功能业务适配说明
JSON结构化输出:两款模型原生支持强制JSON返回,不需要编写复杂提示词做格式约束,数据分析、表单信息提取、接口结构化数据生成业务可以直接启用,通过请求参数
response_format={"type":"json_object"}开启,有效减少后端文本解析的开发工作量。Tool Calls工具调用:Flash版本足够应对单次单工具调用,例如天气查询、基础信息检索;Pro版本针对多工具串联、链式多步骤任务做专项调优,在代码调试、风险推演、多维数据汇总场景,能够减少工具调用错乱、步骤遗漏现象,在各类工具基准测试当中得分显著高于Flash版本。
FIM代码补全:Fill‑in‑the‑Middle中间代码补全能力,只有关闭思考模式才能够正常工作;开启思考模式时模型会优先输出推理过程,破坏代码片段连续性,IDE插件、批量脚本生成业务需要手动关闭thinking参数。
并发能力差异:Flash最高支持2500并发,适配C端客服、实时聊天、批量文档摘要等高QPS业务;Pro上限仅500并发,算力资源优先保障单次推理质量,不适合海量轻量化请求。中大型业务推荐采用分层调度方案:Flash承接绝大多数普通流量,Pro专门分流复杂长文本、多工具任务,兼顾成本与效果。
DeepSeek‑V4计费规则、成本测算与上下文缓存省钱机制
百万Token计价标准
计费划分为三大模块:缓存命中输入Token、缓存未命中输入Token、输出Token。缓存命中代表请求前缀内容和历史请求完全匹配,可以复用KV缓存,单价极低;缓存未命中代表内容全新,需要完整计算输入,价格更高;输出Token按照模型实际生成内容计费。
| 计费项目(每百万Tokens) | DeepSeek‑V4‑Flash | DeepSeek‑V4‑Pro |
|---|---|---|
| 输入(缓存命中) | 0.02元 | 0.025元 |
| 输入(缓存未命中) | 1元 | 3元 |
| 输出 | 2元 | 6元 |
扣费计算公式:总扣费金额 = 实际消耗Token数量 ÷ 1000000 × 对应档位单价
举一个业务测算示例:单次请求输入80万Token的历史知识库文档,缓存完全命中,输出10万Token。
Flash版本:(80 ÷ 100) × 0.02 + (10 ÷ 100) × 2 = 0.2016元
Pro版本:(80 ÷ 100) × 0.025 + (10 ÷ 100) × 6 = 0.602元
同样Token消耗,Pro版本开销大约为Flash三倍,只有复杂专业任务才建议选用Pro。
上下文缓存核心省钱逻辑
DeepSeek‑V4全系自带自动分布式硬盘缓存,开发者不需要额外修改代码、新增配置,系统自动识别请求前缀完成缓存匹配计费,这是长文本业务降低成本最重要的手段。
缓存匹配规则: 只有两条请求消息列表从第一个Token开始的前缀内容完全一致,重复部分判定缓存命中,按照极低的缓存命中单价计费;如果只是中间段落重复,系统提示词加入随机时间戳、随机字符串,就无法触发缓存,会全额按未命中扣费。详情👉访问阿里云百炼大模型服务平台页面 了解。
典型高效缓存业务场景
- 文档问答业务:百万字知识库放在消息列表最前端作为固定system提示词,用户每次提问只有末尾短句发生变化,知识库持续缓存命中,输入成本最高可以降低98%以上。
- 标准化智能客服:统一固定角色设定、业务问答规范,多轮对话前置上下文重复,批量对话大幅削减输入开销。
- 批量代码分析:固定代码规范提示词,循环读取多份源码文件,固定提示持续复用缓存。
缓存优化实操技巧
- 固定不变的知识库、角色指令、Few‑shot示例放在消息数组最前面,用户动态提问放在消息列表末尾。
- system系统提示词禁止插入动态随机字符、时间戳、流水号,微小字符改动直接破坏缓存匹配。
- 同一份文档多轮提问尽量合并批量请求,减少重复加载文档触发缓存未命中扣费。
API接入规范,两套兼容BASE‑URL说明
模型对外提供两套标准接口协议,分别兼容OpenAI生态、Anthropic Claude生态;原有基于两套SDK开发的项目,仅修改接口地址就可以迁移,大幅降低业务改造成本。
- OpenAI兼容格式BASE‑URL(绝大多数开发场景首选):
[https://api.deepseek.com](https://api.deepseek.com) - Anthropic兼容格式BASE‑URL(原有Claude工具、Agent项目迁移):
[https://api.deepseek.com/anthropic](https://api.deepseek.com/anthropic)
两套接口共用同一套计费规则、缓存机制、并发限制,仅仅请求体参数结构存在细微区别,日常开发优先选用OpenAI兼容接口,社区SDK、工具支持更加完善。
可直接运行调用代码示例(curl、Python,覆盖基础对话、JSON输出、Tool调用、开关思考模式)
curl命令行快速调用,适合快速调试测试
示例1:curl调用deepseek‑v4‑flash,关闭思考模式
curl [https://api.deepseek.com/chat/completions](https://api.deepseek.com/chat/completions) \
-H "Content‑Type: application/json" \
-H "Authorization: Bearer 替换为你的DeepSeek API密钥" \
-d '{
 "model": "deepseek‑v4‑flash",
 "messages": [
 {"role": "system", "content": "你是资深后端开发工程师,回答简洁专业"},
 {"role": "user", "content": "简述MoE混合专家大模型的核心工作原理"}
 ],
 "temperature": 0.6,
 "max_tokens": 2048,
 "extra_body": {"thinking": {"type": "disabled"}}
}'
示例2:curl调用deepseek‑v4‑pro,开启思考模式+JSON结构化输出
curl [https://api.deepseek.com/chat/completions](https://api.deepseek.com/chat/completions) \
-H "Content‑Type: application/json" \
-H "Authorization: Bearer 替换为你的DeepSeek API密钥" \
-d '{
 "model": "deepseek‑v4‑pro",
 "messages": [
 {"role": "system", "content": "你是数据分析师,输出严格JSON格式,包含问题、分析结论、建议三个字段"},
 {"role": "user", "content": "分析电商店铺流量下滑的常见原因"}
 ],
 "temperature": 0.3,
 "max_tokens": 4096,
 "response_format": {"type": "json_object"},
 "extra_body": {"thinking": {"type": "enabled"}}
}'
示例3:curl Tool Calls工具调用示例,模拟查询天气
curl [https://api.deepseek.com/chat/completions](https://api.deepseek.com/chat/completions) \
-H "Content‑Type: application/json" \
-H "Authorization: Bearer 替换为你的DeepSeek API密钥" \
-d '{
 "model": "deepseek‑v4‑flash",
 "messages": [{"role": "user", "content": "查询杭州今日天气情况"}],
 "tools": [
 {
 "type": "function",
 "function": {
 "name": "get_weather",
 "description": "获取指定城市当日气温、降水、风力信息",
 "parameters": {
 "type": "object",
 "properties": {"city": {"type": "string", "description": "城市名称"}},
 "required": ["city"]
 }
 }
 }
 ],
 "tool_choice": "auto"
}'
Python完整调用脚本,生产环境通用
安装依赖包命令:
pip install openai python‑dotenv
脚本1:通用对话封装,支持切换Flash/Pro,开启关闭思考模式
import os
from dotenv import load_dotenv
from openai import OpenAI

# 从环境变量读取密钥,禁止硬编码写在源码内
load_dotenv()
DEEPSEEK_API_KEY = os.getenv("DEEPSEEK_API_KEY")

client = OpenAI(
 base_url="[https://api.deepseek.com](https://api.deepseek.com)",
 api_key=DEEPSEEK_API_KEY
)

def deepseek_chat(model_name: str, user_prompt: str, system_prompt: str, enable_thinking: bool = True):
 thinking_config = {

 "type":"enabled"} if enable_thinking else {

 "type":"disabled"}
 resp = client.chat.completions.create(
 model=model_name,
 messages=[
 {

 "role":"system","content":system_prompt},
 {

 "role":"user","content":user_prompt}
 ],
 temperature=0.7,
 max_tokens=4096,
 extra_body={

 "thinking": thinking_config}
 )
 # 打印推理过程(开启思考模式才会返回reasoning字段)
 if resp.choices[0].message.reasoning:
 print("=====模型推理过程=====")
 print(resp.choices[0].message.reasoning)
 print("=====最终回答=====")
 return resp.choices[0].message.content

if __name__ == "__main__":
 res_flash = deepseek_chat(
 model_name="deepseek‑v4‑flash",
 system_prompt="你是简洁文案助手,一句话总结内容",
 user_prompt="总结DeepSeek‑V4 Flash和Pro版本核心差异",
 enable_thinking=False
 )
 print("Flash模型输出:\n", res_flash)

 res_pro = deepseek_chat(
 model_name="deepseek‑v4‑pro",
 system_prompt="你是AI架构师,详细对比两款模型技术优劣",
 user_prompt="分析DeepSeek‑V4双版本适用业务场景",
 enable_thinking=True
 )
 print("\nPro模型输出:\n", res_pro)
脚本2:JSON结构化输出示例
import os
import json
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(base_url="[https://api.deepseek.com](https://api.deepseek.com)", api_key=os.getenv("DEEPSEEK_API_KEY"))

def get_json_result():
 resp = client.chat.completions.create(
 model="deepseek‑v4‑pro",
 messages=[
 {

 "role":"system","content":"输出JSON,字段包含:产品名称、优势、适用场景、预估调用成本"},
 {

 "role":"user","content":"整理DeepSeek‑V4‑Flash产品介绍"}
 ],
 response_format={

 "type":"json_object"},
 max_tokens=3072,
 temperature=0
 )
 json_data = json.loads(resp.choices[0].message.content)
 return json_data

if __name__ == "__main__":
 data = get_json_result()
 print(json.dumps(data, ensure_ascii=False, indent=2))
脚本3:Tool Calls工具调用完整示例
import os
from dotenv import load_dotenv
from openai import OpenAI

load_dotenv()
client = OpenAI(base_url="[https://api.deepseek.com](https://api.deepseek.com)", api_key=os.getenv("DEEPSEEK_API_KEY"))

tools = [
 {

 "type": "function",
 "function": {

 "name": "get_stock_info",
 "description": "查询股票当日收盘价、涨跌幅、成交量",
 "parameters": {

 "type": "object",
 "properties": {

 "stock_code": {

 "type": "string", "description": "股票代码"}
 },
 "required": ["stock_code"]
 }
 }
 }
]

def agent_tool_demo():
 response = client.chat.completions.create(
 model="deepseek‑v4‑pro",
 messages=[{

 "role":"user","content":"查询000001股票今日行情"}],
 tools=tools,
 tool_choice="auto"
 )
 msg = response.choices[0].message
 if msg.tool_calls:
 for call in msg.tool_calls:
 print(f"工具名称:{call.function.name}")
 print(f"调用参数:{call.function.arguments}")
 else:
 print("模型直接回答:", msg.content)

if __name__ == "__main__":
 agent_tool_demo()
Flash与Pro业务场景选型指南
优先选择DeepSeek‑V4‑Flash的业务
- 高并发C端实时对话:在线客服、聊天机器人、短视频文案生成,QPS较高,需要控制整体调用成本,2500并发上限适配中小流量线上服务。
- 文档批量摘要、文本清洗:大批量PDF、合同、新闻稿件处理,依靠前置固定提示触发缓存,海量文档处理开销可控。
- 简单单步工具调用:信息检索、翻译、关键词提取、表格转换,推理难度低,输出效果和Pro差距不大。
- IDE轻量FIM代码补全:关闭思考模式,日常函数编写、脚本生成,响应速度更快,适合批量开发场景。
- 个人开发者、初创团队原型验证:预算有限,需要百万上下文能力做产品原型,试错成本低。
优先选择DeepSeek‑V4‑Pro的业务
- 复杂多步骤Agent智能体工作流:代码排错、数据库故障排查、多工具串联推演,Pro逻辑连贯性更强,降低工具调用失败概率。
- 深度专业推理任务:数学推导、法律文书解析、财务报表审计、科研文献解读,依托更大激活参数,复杂推理准确率更高。
- 企业核心研判系统:商业方案撰写、行业深度报告生成,对严谨性、细节完整性要求高,可以接受更高调用成本。
- 超长文档深度交叉问答:百万字白皮书、完整项目卷宗多轮反复提问,细节召回、上下文记忆稳定性更好。
- 低并发高质量产出场景:专业咨询、定制内容创作,并发小于500,优先保障输出质量而非极致速度。
企业混合调度最优方案
中大型线上平台可以搭建请求分层路由,根据输入Token长度、是否开启多工具调用、关键词识别自动分流:简单轻量化请求路由Flash,复杂长文本、多工具任务转发Pro,实测能够降低整体30%‑60%API调用开销,兼顾性能与成本。
生产环境落地避坑要点
- 缓存计费避坑:system提示词禁止加入随机字符、时间戳;固定内容放在消息数组头部,用户动态提问放在末尾,最大化缓存命中率;微小字符改动会直接让缓存失效,产生高额未命中输入费用。
- 思考模式Token开销管控:开启thinking模式,模型输出的推理思考文本同样计入输出Token扣费;批量简单业务默认关闭思考模式,复杂任务手动开启。
- 并发上限管控:Flash单账号上限2500并发,Pro上限500;超出限制直接返回429限流错误;线上业务必须做好请求排队、降级熔断逻辑,防止业务中断。
- FIM代码补全限制:Fill‑in‑the‑Middle中间补全功能只在非思考模式生效;开启thinking模式调用补全会出现代码截断、格式错乱,开发IDE插件时必须增加参数判断逻辑。
- Agent场景Token预估:工具调用业务整体Token消耗是普通对话3‑5倍,批量自动化任务提前测算预算,结合缓存机制控制账单风险。
- 接口迁移注意:原有OpenAI项目只替换base_url与api_key即可;面向Claude存量项目切换到
/anthropic接口地址,参数结构无需大规模重构。
总结
DeepSeek‑V4通过Flash、Pro双版本差异化产品策略,把百万Token超长上下文能力普及到不同预算层级的开发者。Flash版本主打低单价、低延迟、高并发,适合绝大多数轻量化高频业务;Pro版本凭借超大MoE激活参数,承接复杂推理、多步骤Agent、深度长文档分析等专业场景。统一的分布式KV缓存机制,极大降低长文本业务的输入调用开销。详情👉访问阿里云百炼大模型服务平台页面 了解。
官方对外提供OpenAI、Anthropic两套兼容API接口,提供curl、Python完整调用示例,原有存量项目迁移成本很低。开发者上线业务,需要结合业务并发量、推理复杂度、预算规模选择合适版本;中大型平台推荐分层调度混合使用两款模型,平衡成本与输出质量。无论是个人原型验证、中小企业AI产品上线,还是企业级智能体系统开发,DeepSeek‑V4双版本可以覆盖绝大多数文本处理、Agent自动化开发需求。

