阿里云国际站代理商:程序员用阿里云无影云电脑合适吗?开发配置、编译体验和代码安全怎么看

简介: 程序员可以评估阿里云无影云电脑作为开发环境,但是否合适取决于项目工具链、编译负载、交互网络和权限要求。浏览器开发、常规IDE与需要复杂虚拟化或特殊硬件的开发任务,不能统一使用同一配置。

程序员用阿里云无影云电脑合适吗?开发配置、编译体验和代码安全怎么看

本文由 阿里云国际站代理商『云老大 ✈️✈️✈️飞弟:@yunlaoda360 / YunLaoDa-服务器服务商•撰写』如需转载请注明!

程序员可以评估阿里云无影云电脑作为开发环境,但是否合适取决于项目工具链、编译负载、交互网络和权限要求。浏览器开发、常规IDE与需要复杂虚拟化或特殊硬件的开发任务,不能统一使用同一配置。

本文讨论无影云电脑企业版EDS。先验证项目能完整构建和调试,再比较配置与管理收益,比只看CPU核数或“代码在云端更安全”的宣传更可靠。

一、阿里云国际站开发云电脑,工具链兼容要先检查什么?

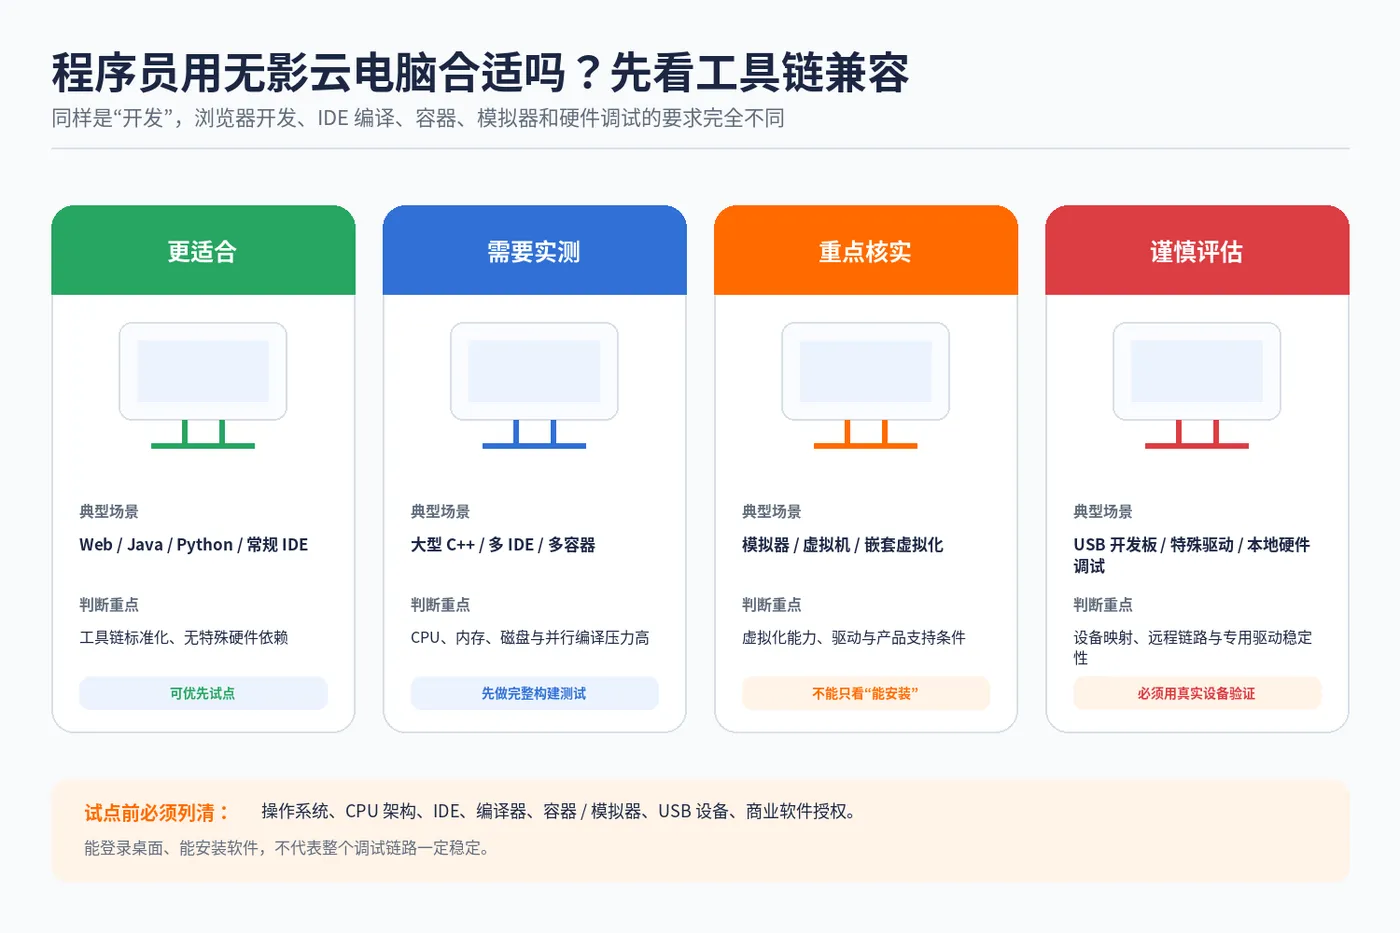
列出操作系统、CPU架构、IDE、编译器和依赖版本,以及是否使用容器、模拟器或虚拟机。需要嵌套虚拟化的工具,应向产品与软件供应方核实支持条件,不能因云电脑能安装软件就认定一定可用。

本地调试依赖的USB设备、开发板或专用驱动,也要按实际终端验证。远程桌面能看到设备,不代表整个调试链路都稳定。

软件许可应按云上使用条件核实。开发工具、商业插件和操作系统可能有不同授权要求,桌面费用不能直接解释为全部软件许可已包含。
wuying_dev_01_compatibility.png

二、阿里云无影云电脑开发配置,怎样测试编译与多任务?

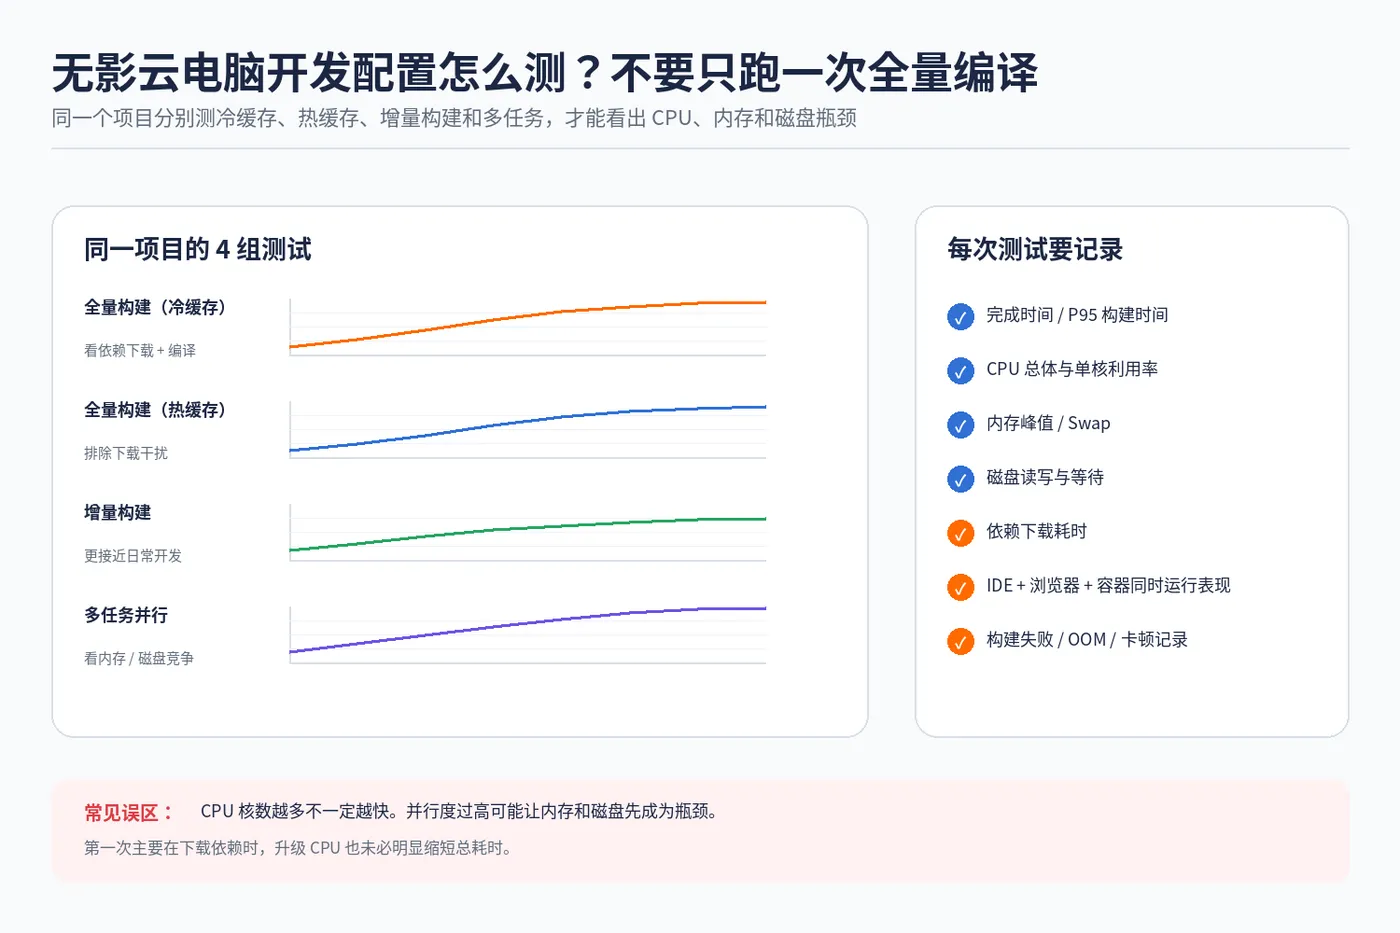
使用同一个项目分别测全量构建、增量构建和测试任务,记录完成时间与CPU、内存、磁盘活动。全量编译快,不代表日常修改后的交互体验同样好。

依赖下载可能掩盖编译性能,应注明冷缓存与热缓存条件。如果第一次运行主要在下载包,换成更高CPU未必明显缩短时间。

多开IDE、浏览器、测试服务和容器时,应同时测试内存需求。编译并行度过高可能造成内存或磁盘竞争,不宜简单按核数最大化开启任务。
wuying_dev_02_compile_benchmark.png

三、阿里云国际站开发桌面网络,怎样区分输入延迟与构建等待?

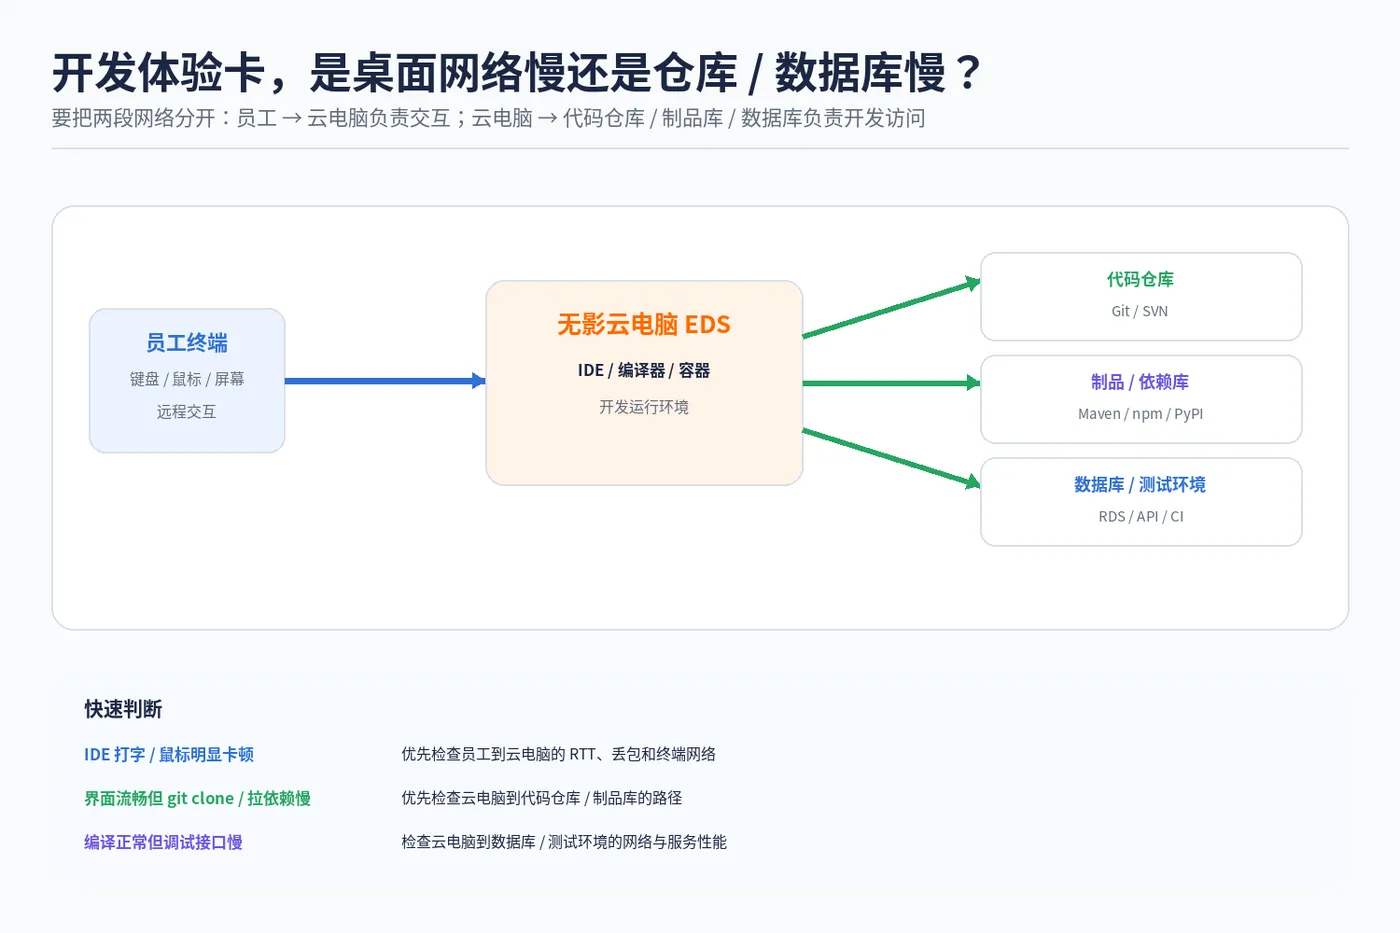
输入、窗口刷新和断点交互受员工到桌面的连接影响;代码仓库、制品库与数据库访问,则是桌面到这些服务的另一段路径。两段都应分别测试。

若IDE打字顺畅但拉取依赖慢,重点检查仓库位置和网络;若编译资源利用正常但鼠标输入明显滞后,则需排查桌面连接和终端。不能用一次下载测速解释全部体验。

分布式团队还要考虑共同访问的代码与测试环境。为所有人选择同一地域可能便于统一管理,但远处员工体验需验证;分区部署则要规划镜像与依赖更新。
wuying_dev_03_network_paths.png

四、阿里云无影云电脑代码安全,云端运行还需要做什么?

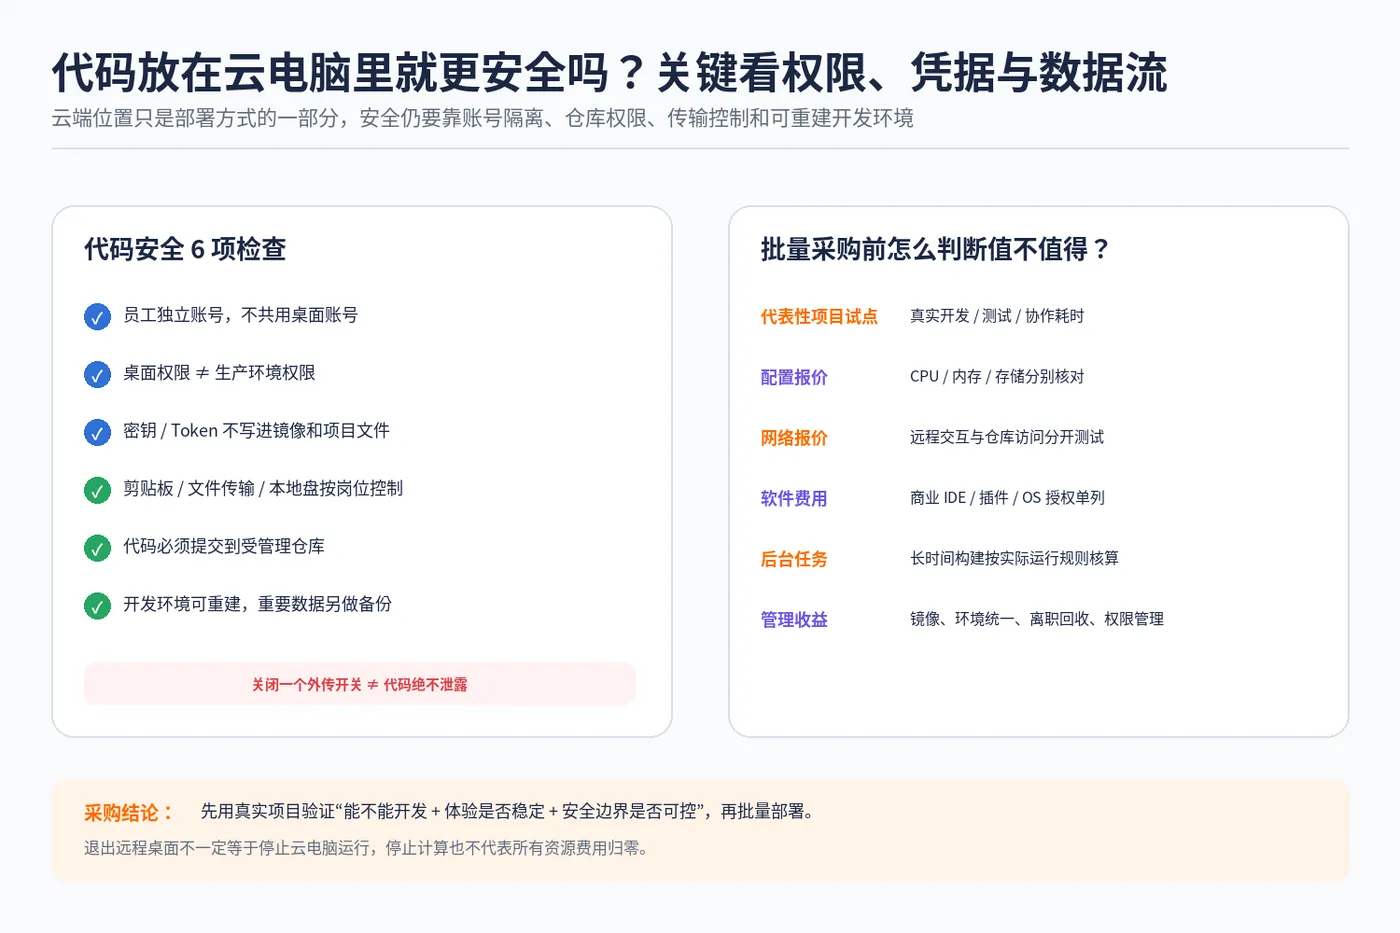
员工使用独立账号,并分别管理桌面、代码仓库和发布权限。能进入开发桌面,不应自动拥有生产环境凭据,密钥和令牌也不宜直接写进镜像或项目文件。

剪贴板、文件传输和本地磁盘映射可以按岗位配置,但关闭其中一项并不等于消除全部外传途径。仍需结合网络访问、仓库权限和企业流程,避免把单个开关说成代码绝不泄露。

开发环境应可重建,项目应正确提交到受管理的仓库,必要数据另做备份。云电脑故障或人员离职时,不能依赖某个桌面磁盘中唯一的一份未提交代码。
wuying_dev_04_security_purchase.png

五、程序员采购阿里云国际站云电脑,怎样判断值得投入?

选择代表性项目试点,记录日常开发、测试和协作耗时,以及管理员维护环境的工作量。不能只比较一次跑分,也不宜直接把减少的配置工时当作已减少的工资支出。

费用分别列计算、存储、网络和软件,长时间后台构建应按实际运行规则核算。关闭客户端不一定停止云电脑运行,停止计算也不代表所有资源费用归零。

与阿里云国际站代理商(云老大)沟通时,可以提供工具链、项目规模和试用记录,请其按配置与网络分别报价。确定支持范围后再批量部署,避免上线后才发现模拟器或调试设备无法使用。

六、阿里云无影云电脑开发常见问题

问题一:所有程序员都适合迁到云电脑吗?

不是。工具链、特殊硬件、离线工作和网络条件都可能影响适用性,应按岗位验证。

问题二:CPU核数越多,编译一定越快吗?

不一定。并行能力、内存、磁盘与依赖下载都可能限制速度,需要用同一项目比较。

问题三:容器和模拟器可以直接保证运行吗?

不能。需核实操作系统、虚拟化和具体软件支持,并测试完整流程。

问题四:代码留在云端就不会泄露了吗?

不能作这种保证。权限、凭据、传输和网络等仍需管理,云端位置只是部署方式的一部分。

问题五:退出远程桌面后,构建任务就停止了吗?

未必。取决于运行状态和策略,应检查实际任务与计费规则,而不是只看客户端是否关闭。
相关文章
|
1月前
|
人工智能 自然语言处理 搜索推荐
没有预算还能做GEO优化吗:零成本可落地的六个动作
本文探讨零预算下做好GEO(生成式引擎优化)的可行路径:不靠烧钱买流量,而以时间与纪律深耕内容质量。核心观点是——钱买产能,但“被引用的资格”由事实台账、段落自足、可核对数据、条件式覆盖等低成本动作决定。结合权威数据与实操六步法,助力中小团队8周内系统提升AI搜索可见性。
210 1
|
1月前
|
人工智能 自然语言处理 机器人
程序员节限时福利:21元拿下好域名
项目写到一半,域名还没定?1024开发者节推出专属后缀:`.chat`(AI/客服)、`.run`(运行环境)、`.team`(开发团队),首年统一21元,直降40%–58%!支持万网CLI自然语言查域名、比价、下单。
程序员节限时福利:21元拿下好域名
|
1月前
|
JavaScript API 开发工具
DeepSeek Harness 实战入门:从 Cordis 插件内核、本地部署、SDK 开发到模式选型与避坑,一文全掌握
DeepSeek Harness作为开源Agent运行时底座,通过Cordis插件内核将大模型推理能力与本地文件、系统命令执行环境深度打通,实现了高度可扩展、权限可控、全链路可追溯的智能体运行机制。它不是用来聊天的成品软件,而是供开发者搭建、调试和评测智能体的底层框架。如果你需要本地数据可控、支持自定义扩展的Agent执行环境,可以用npx命令快速启动体验;如果只是日常对话,网页客户端更加方便。正式投入业务前,建议用独立测试目录完成多组验证。更多项目详情👉访问‌阿里云百炼大模型服务平台页面‌了解。 随着Agent技术持续演进,Harness这类运行时框架有望成为连接大模型与真实计算机环境的
543 1
|
1月前
|
存储 人工智能 安全
阿里云 2026 DeepSeek Harness 技术详解:开源 Agent 运行框架,Cordis 插件内核与本地部署实操指南
在AI智能体快速落地的阶段,很多开发者会陷入一个困境:市面上现有的Agent工具大多是封装完整的成品应用,模型调用逻辑、工具执行循环、存储会话机制全部写死在底层,开发者只能调整表层参数,一旦业务需要自定义任务调度规则、替换沙箱执行环境、改造模型接入适配器,修改成本极高,很难适配项目的个性化需求。DeepSeek Harness,简称dsh,是开源的生产级AI智能体执行脚手架,遵循“Agent = 模型 + Harness”的工程范式,大模型负责推理思考,而Harness作为控制中枢,承担环境交互、工具契约管理、安全沙箱、持久化记忆、任务循环调度的全部工作。
697 1
|
1月前
|
存储 人工智能 自然语言处理
别再被概念忽悠了!一文读懂企业数据中台到底该怎么用
本文直击数据中台“建而不用”痛点,指出60%项目失败主因是治理滞后、口径未入代码、资产难消费。阿里云瓴羊Dataphin以“治理即研发”理念,将标准、质量、安全嵌入建模开发全流程,并通过语义知识图谱与Data Agent实现业务自助用数,真正打通从建设到价值落地的“最后一公里”。
|
1月前
|
人工智能 移动开发 自然语言处理
千问办公 QwenWork 详细介绍:产品核心能力、典型场景、价格及常见问题解答
千问办公(QwenWork)是阿里巴巴推出的一站式AI Agent办公平台,主打“对话即交付”——一句话生成PPT、Excel、网页、报告等可直接落地成果;深度集成钉钉,支持多模态解析、定时任务与多端协同(网页/桌面/钉钉),助力提效降本。
638 0
|
1月前
|
人工智能 JSON API
爆火 Jev 模型到底强在哪?性能实测、API 调用与项目落地全指南
对于开发者来说,可以优先在原型环境用Playground验证业务可行性,小规模真实样本测试之后,再上线生产环境;优先使用SDK封装调用,高风险链路增加人工兜底逻辑。随着生态持续完善,System One这类决策模型,会成为AI应用架构中越来越重要的组成部分。
372 0
体验版有限制每日对话次数吗?
账户虽有免费额度,但调用DeepSeek-V4.1-Flash模型时提示“今日对话次数已达上限”,其他模型仍可正常使用。可明日重置或升级订阅获取更多权益。
|
1月前
|
自然语言处理 PyTorch TensorFlow
开源的jev模型怎么选:5个项目的能力与部署场景分析
本文围绕“开源的jev模型”比较 Deepopen(改进后的 Laya)、fastText、SetFit、Sentence Transformers 与 Google BERT。五个项目分别覆盖结构化决策、监督式文本分类、少样本微调、语义向量与重排序、Transformer 编码器微调等路径。选型可从输出形态、训练数据规模、多语言需求、运行环境及业务集成方式出发匹配,不同项目适用于工单分诊、内容审核、语义检索和自定义分类等场景。
|
1月前
|
SQL 人工智能 监控
Chapter05_从本体语义到业务行动:Dataphin × WinNexo 的产品架构
本文详解 Dataphin 与 WinNexo 的协同架构:前者加工企业数据与知识,构建可信、可治理的「Data for AI」;后者通过语义中心与大模型推理,实现「AI for Business」,推动知识落地业务。二者分工明确、闭环联动,支撑 Agent 高效回访与决策。(239字)
177 0