很多测试同学写用例时,最头疼的不是设计测试点,而是需求资料不完整。
常见情况有两种:
一种是没有完整需求文档。需求分散在会议纪要、聊天记录、原型截图里,甚至只有一个已经开发出来的页面。
另一种是有文档,但写得比较粗。比如只写了「支持新增、编辑、删除」,但字段规则、按钮状态、异常提示、权限差异、页面跳转都没有展开。
这种情况下,如果完全靠测试自己脑补,很容易出现几个问题:
- 用例步骤和实际页面对不上;
- 测试点遗漏,尤其是异常场景、权限场景和边界场景;
- 需求和页面不一致时,不知道应该以哪边为准;
- 用例写完后,执行阶段才发现理解有偏差,又要返工修改。
我的方案
针对上面的痛点,我最近尝试了一套新的流程:借助 Skill,把 Playwright CLI 的页面探索能力和需求文档分析结合起来,先让工具理解页面,再生成测试计划,最后基于人工确认后的计划输出测试用例。
它不是把测试工作完全交给 AI,而是把最耗时间的页面梳理、测试点初稿、用例步骤整理交给工具完成;测试人员重点负责确认范围、纠正业务规则、补充关键场景。
这样产出的用例会更接近真实页面,也更容易被人工校准。
整体流程
 text 输入系统地址,补充测试账号、需求文档 → Playwright CLI 页面自动探查(识别按钮/输入框/弹窗/跳转等元素) → 生成测试计划文档(含页面功能、已探索界面、需求页面差异、初步测试点) → 人工核对并修正测试计划 → 生成 Excel / XMind 测试用例
这里比较关键的是第三步:先出计划,再出用例。
很多人使用 AI 生成用例时,会直接说「根据这个需求帮我写测试用例」。这样做的问题是,一旦前面对需求的理解错了,后面生成的几十条、上百条用例都会跟着错。
先生成计划,就相当于在正式写用例前加了一道评审。
计划里会把工具探索到的功能、页面路径、差异判断和测试点先列出来。测试人员只需要先看这些内容是否合理,不合理的地方直接对话修正。确认无误后再生成最终用例,整体返工成本会低很多。
实践案例
案例 1:只提供系统地址
第一种情况比较常见:手头没有需求文档,只知道系统地址,希望根据当前页面生成测试用例。
这种方式适合文档缺失、老系统补用例、页面已实现但需求资料不完整的场景。
第一步:执行 Skill
输入系统地址后,Skill 会启动页面探索流程。
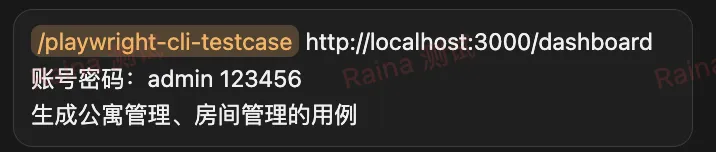
如果系统需要登录,就按提示补充账号信息。
如果后续发现某些页面需要特定权限,也可以继续在对话中补充账号或说明操作路径。
这里有一点需要注意:如果你手里有需求文档,即使不完整,也建议一起提供。工具会同时参考需求文档和页面。如果页面与文档不一致,它会在计划里标出来,让你确认到底以哪边为准。
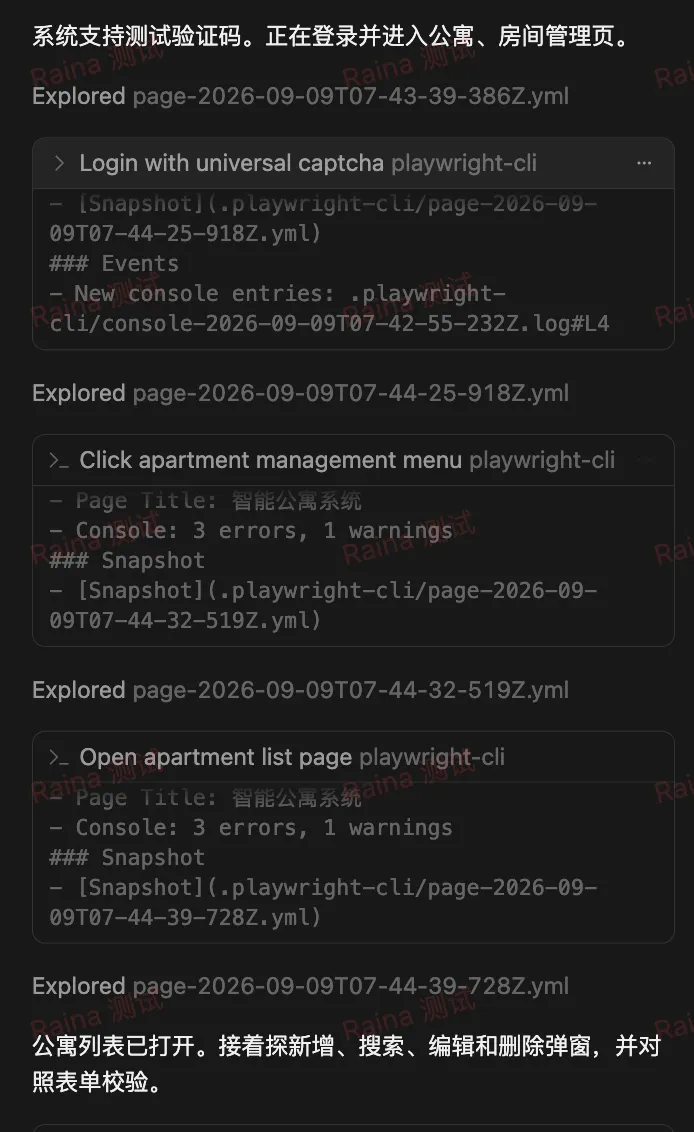
第二步:页面探索
工具会先跳转到对应页面,生成页面快照。
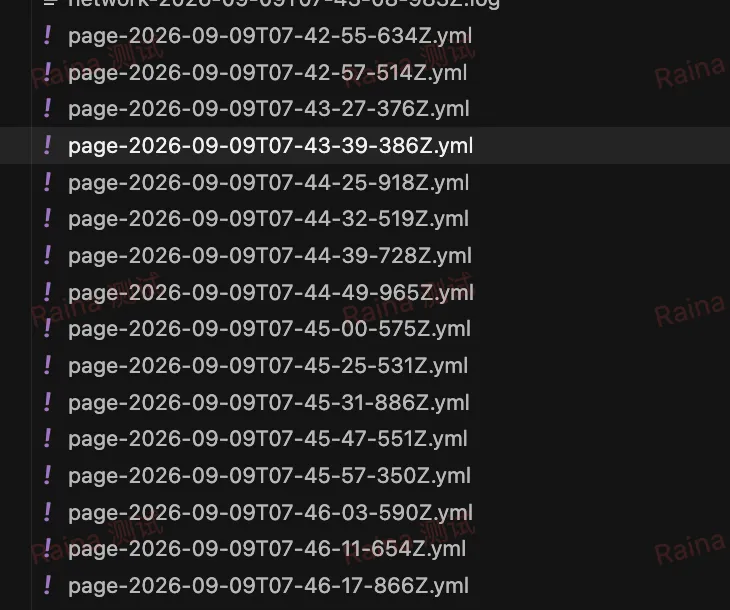
页面快照可以理解为当前界面的结构化记录。
它会识别页面上的标题、按钮、输入框、下拉框、表格、弹窗、链接等元素。接下来,工具会基于这些元素进行点击、输入、跳转等操作,把可探索的页面尽量走一遍。
第三步:生成计划文档
页面探索完成后,会先生成一份计划文档,而不是直接生成最终用例,包含以下内容:
#### 1. 页面功能清单
工具会根据探索结果,总结当前页面包含哪些功能。
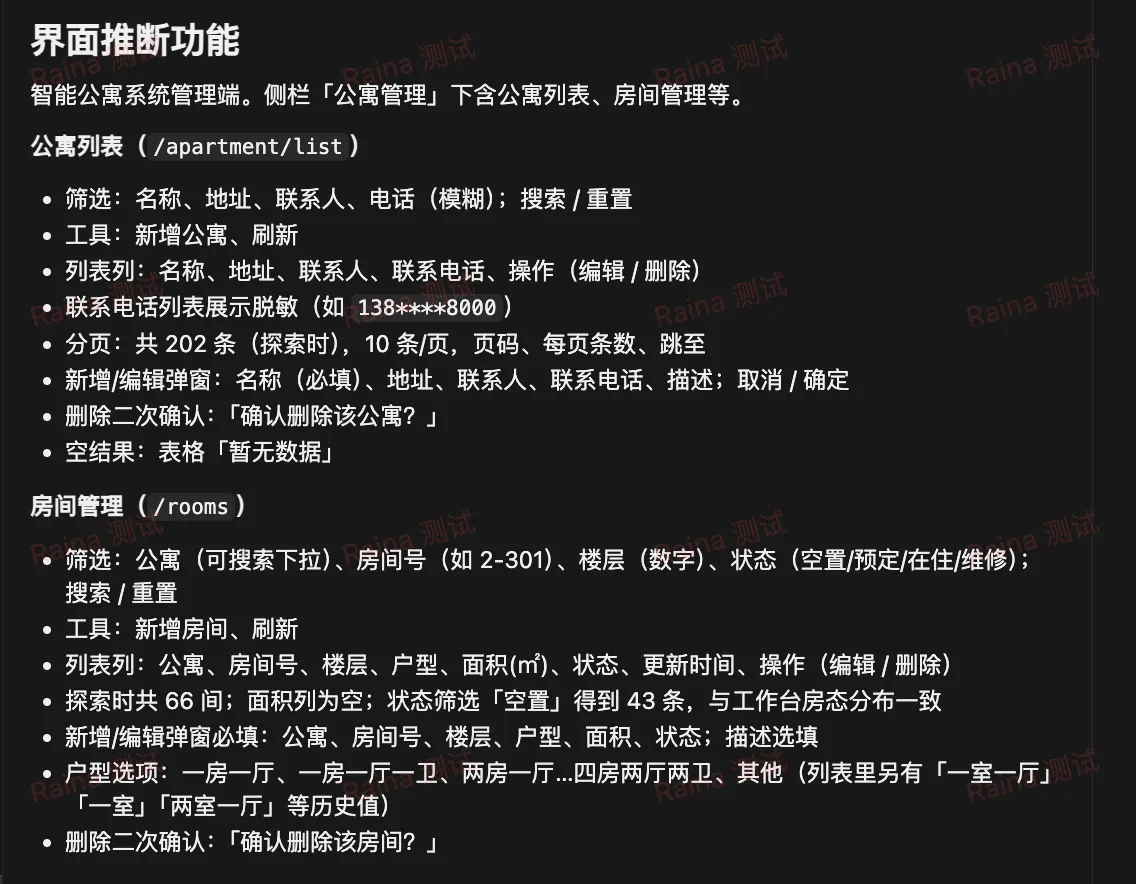
看这一部分时,要重点确认两件事:
第一,是否把当前不需要测试的模块写进来了。
比如本次只测「用户管理」,但计划里把「角色管理」「组织架构」也写进来了,就需要删掉或说明不在本次范围内。
第二,页面上真实存在的重要入口有没有遗漏。
比如页面有「批量导入」按钮,但功能清单里没有,就说明探索可能不完整,后续测试点也会漏掉导入相关场景。
#### 2. 已探索的界面
计划里还会列出这次探索过的页面。
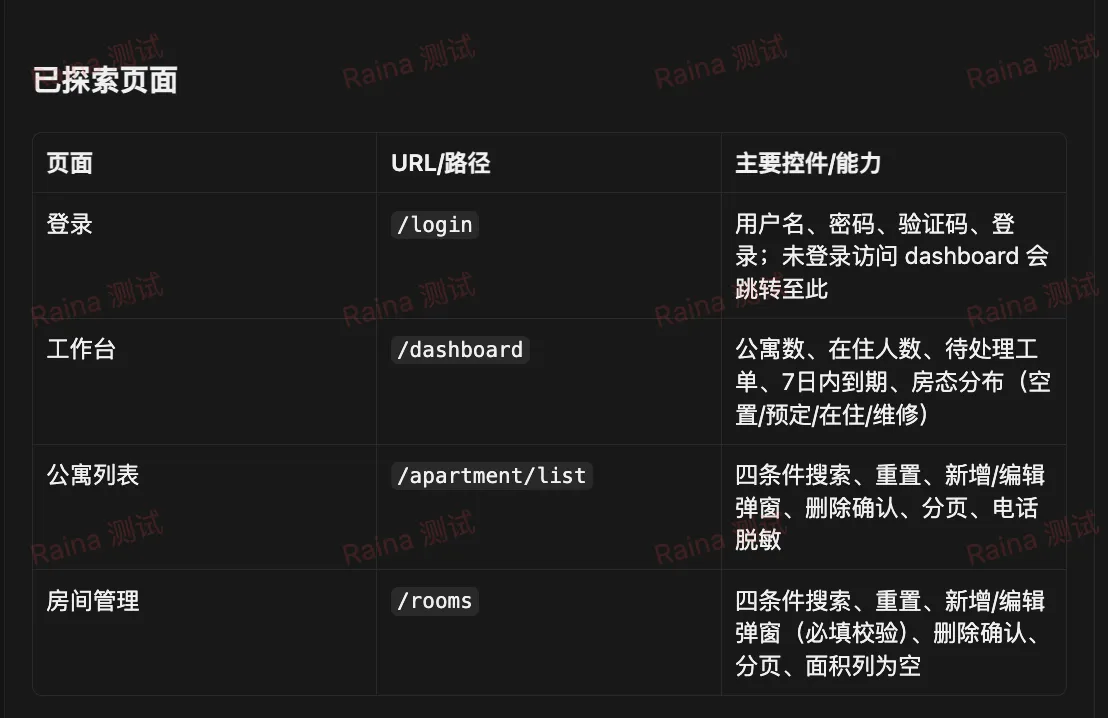
这个列表很有用。
它可以帮助你判断工具到底走到了哪些页面,哪些页面还没有覆盖。
如果关键页面没有出现在列表中,比如只探索到了列表页,没有进入新增页和编辑页,那就不要急着生成用例。可以继续让工具补充探索对应入口,再重新生成计划。
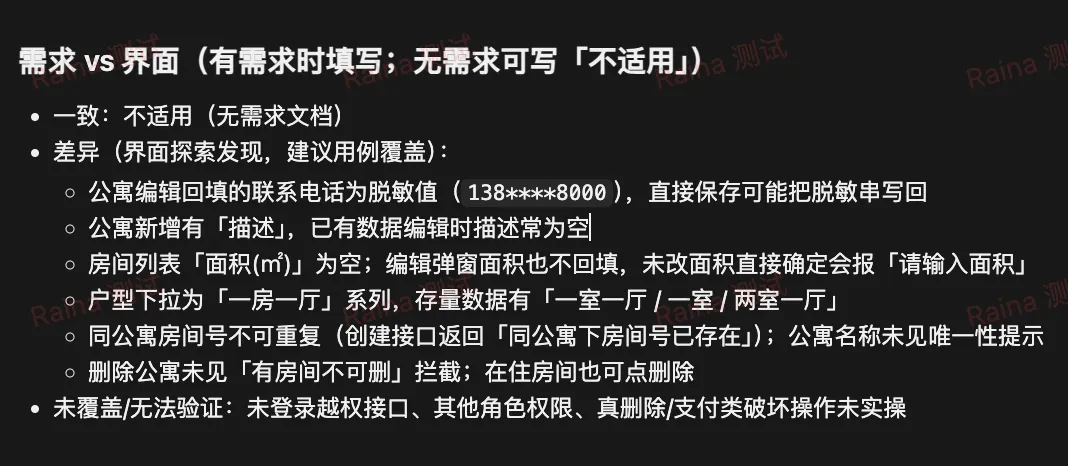
#### 3. 差异和合理性判断
如果没有需求文档,工具会根据页面本身做一些合理性判断。
#### 4. 测试点
计划中还会先生成测试点。
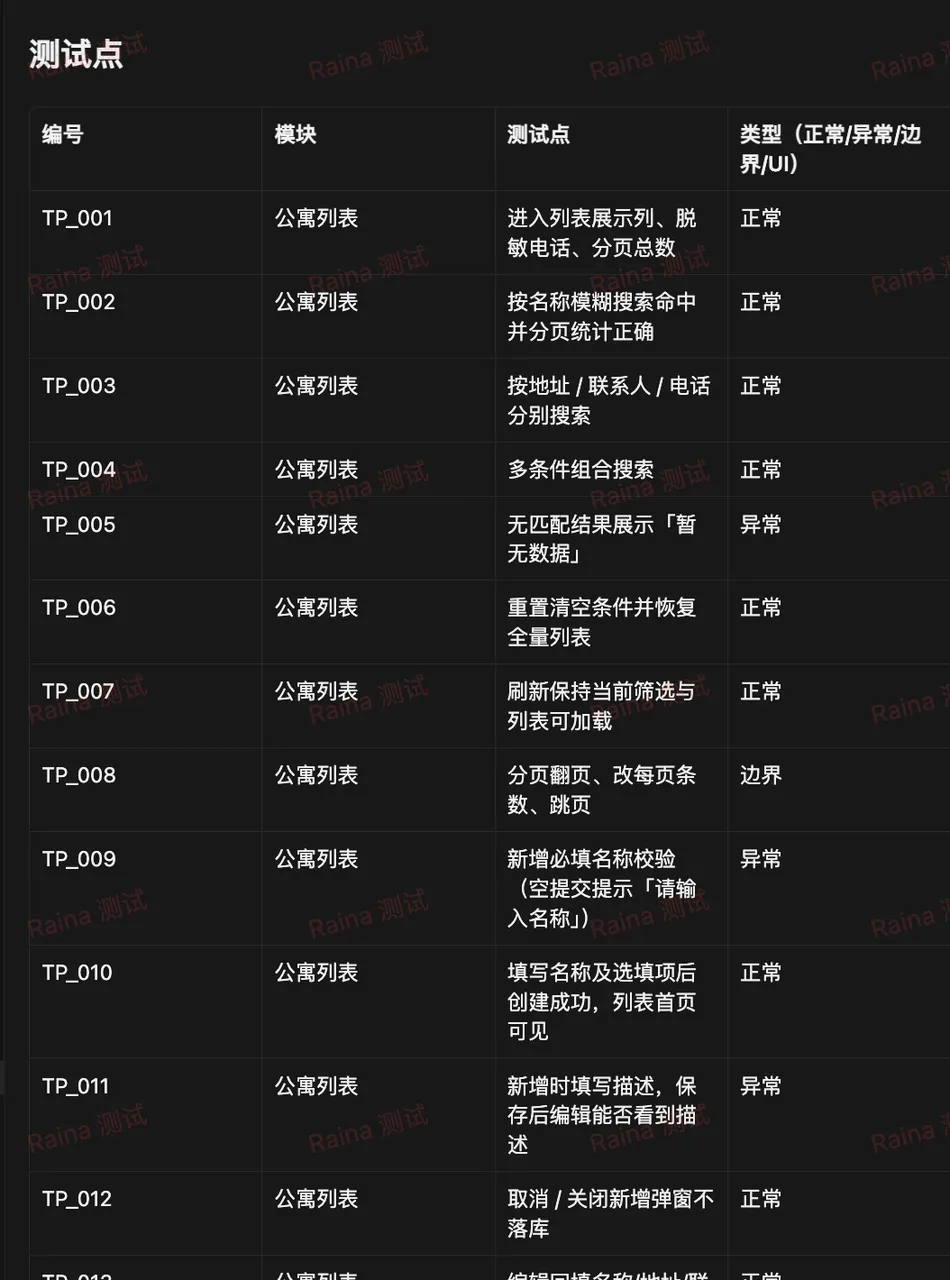
建议重点检查这些方面:
- 主流程是否完整,比如新增、编辑、删除、查询是否都覆盖;
- 字段校验是否充分,比如必填、长度、格式、重复值、特殊字符;
- 异常场景是否合理,比如接口失败、无数据、无权限、重复提交;
- 权限场景是否需要补充,比如不同角色可见按钮不同;
- 是否存在业务规则遗漏,比如状态流转、审批条件、不可逆操作;
- 是否混入了不必要的测试点,比如纯展示文本、无交互说明。
测试点确认得越充分,后面生成的用例越接近可执行状态。
第四步:生成测试用例
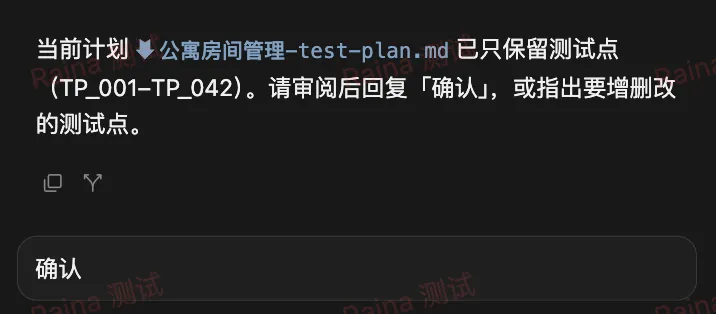
确认计划没问题后,回复「确认」即可生成用例。
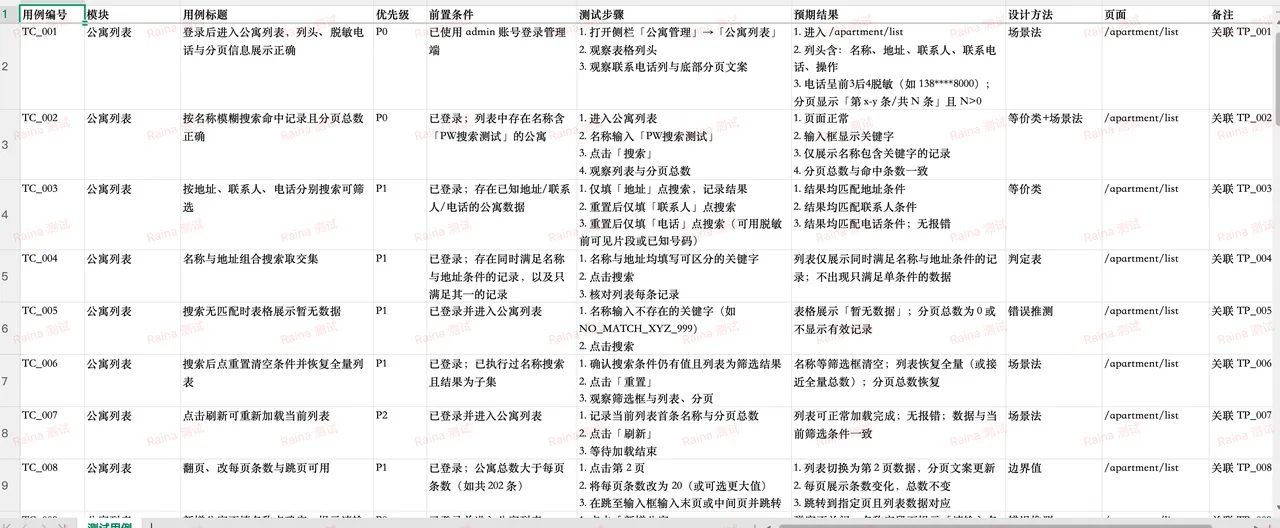
默认生成的是 Excel 格式。
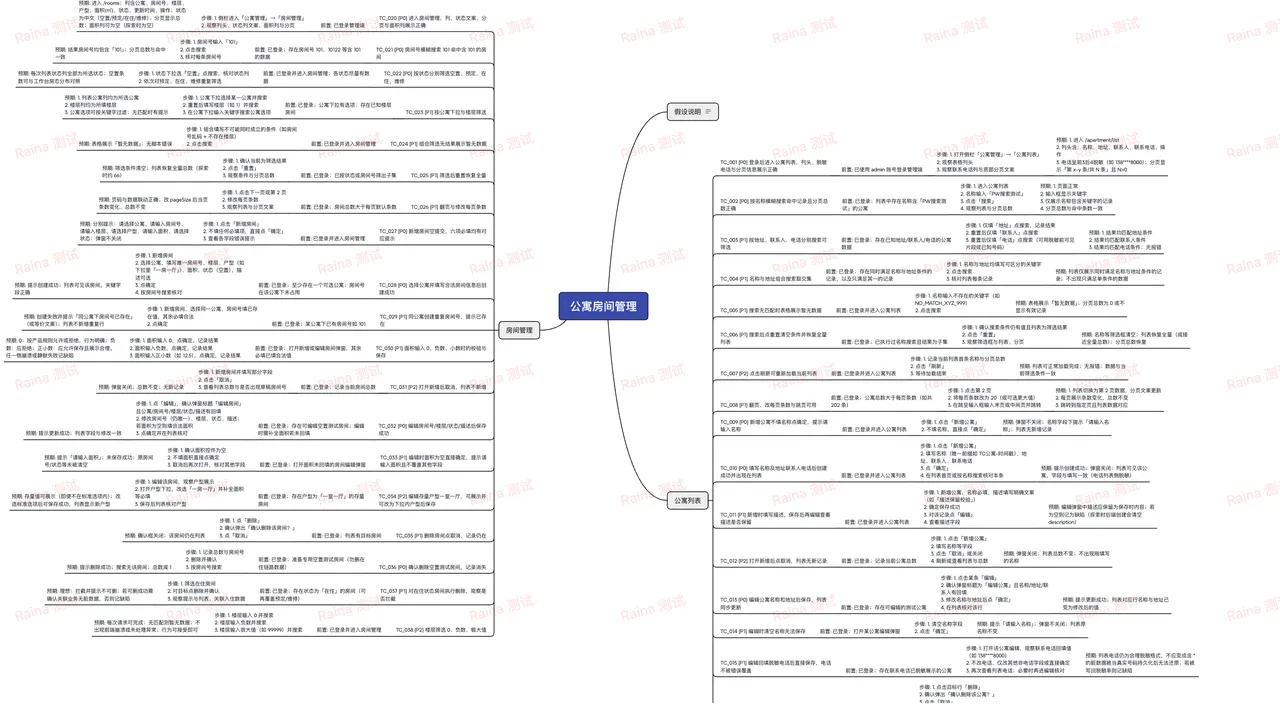
如果需要 XMind 格式,也可以继续对话生成。
生成后的 XMind 用例如下:
案例 2:同时提供需求文档和系统地址
第二种情况是同时提供需求文档和 URL。
这种方式更适合真实项目。
因为大多数项目并不是完全没有需求,而是需求文档和页面实现之间可能存在差异。
输入需求文档和 URL
输入方式如下:
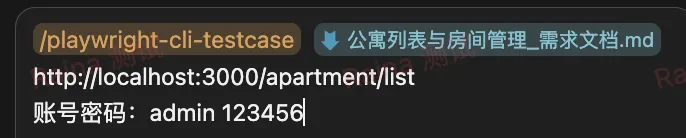
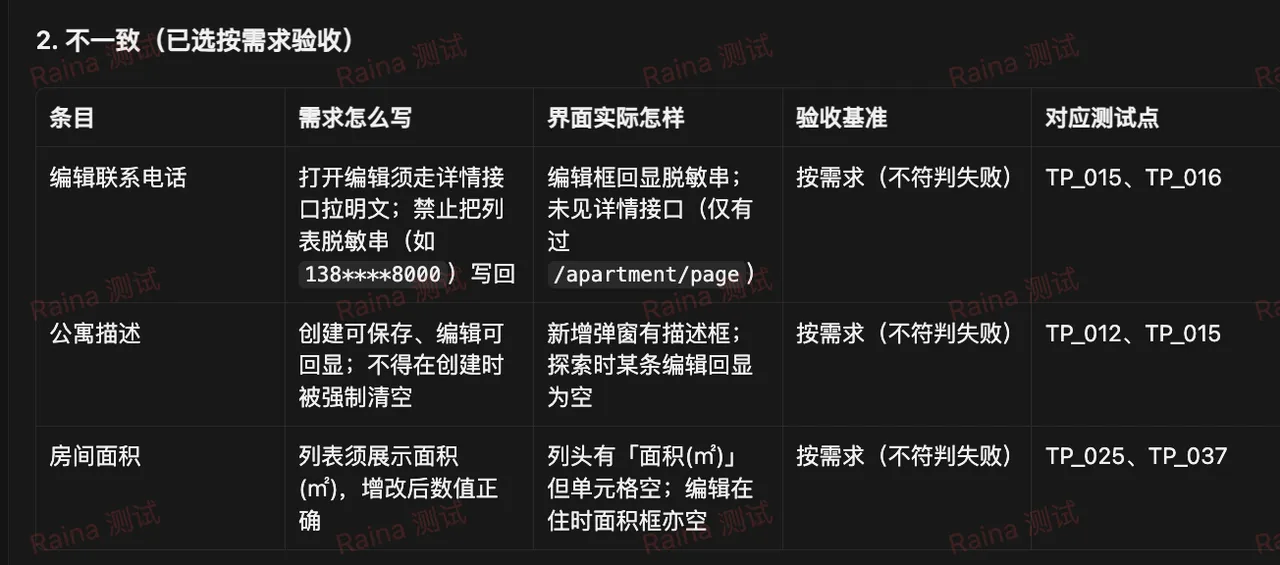
工具会一边解析需求文档,一边探索页面,然后生成计划。
和只提供 URL 不同的是,这种情况下计划里会多出一块重点内容:需求和界面的差异表。
这套方法适合哪些场景
比较适合:
- 需求文档不完整,但页面已经可操作;
- 老系统补测试用例;
- 提测前快速梳理功能覆盖;
- 文档和页面实现存在差异,需要先对齐;
- 测试人员要快速生成 Excel 或 XMind 用例初稿;
- 产品、开发、测试需要围绕页面进行差异评审。
不太适合:
- 页面还没开发完成;
- 主流程无法点击;
- 接口未联调,页面大量报错;
- 纯后端逻辑,没有可探索页面;
- 强依赖复杂业务规则,但没有任何说明资料。
如果页面不可操作,Playwright 能发挥的作用有限。这种情况下,更适合先基于需求文档生成测试点,再等页面可用后补充页面探索。
总结
需求文档不完整时,测试用例最难的不是写格式,而是确认「到底要测什么」和「预期结果按什么来」。
Playwright CLI + Skill 的价值,就在于把页面探索、需求对比、测试点整理和用例生成串成了一条流程。
它先看页面,再出计划;先确认差异和测试点,再生成 Excel 或 XMind。
这样做比直接让 AI 写用例更稳,也更符合实际测试工作中的节奏。
对测试人员来说,这套方法最适合用来生成第一版用例初稿。它能节省大量整理页面和书写步骤的时间,但关键业务判断仍然需要人工把关。
如果项目里经常遇到需求不完整、文档和页面不一致、老系统补用例这些场景,可以尝试把这套流程加入日常测试设计中。
先让工具把页面跑一遍,再由测试人员确认计划,最后生成可执行用例。
用一句话概括就是:
AI 负责整理和生成,人负责判断和把关。