一、开场:出问题的那一分钟,你打开哪个页面
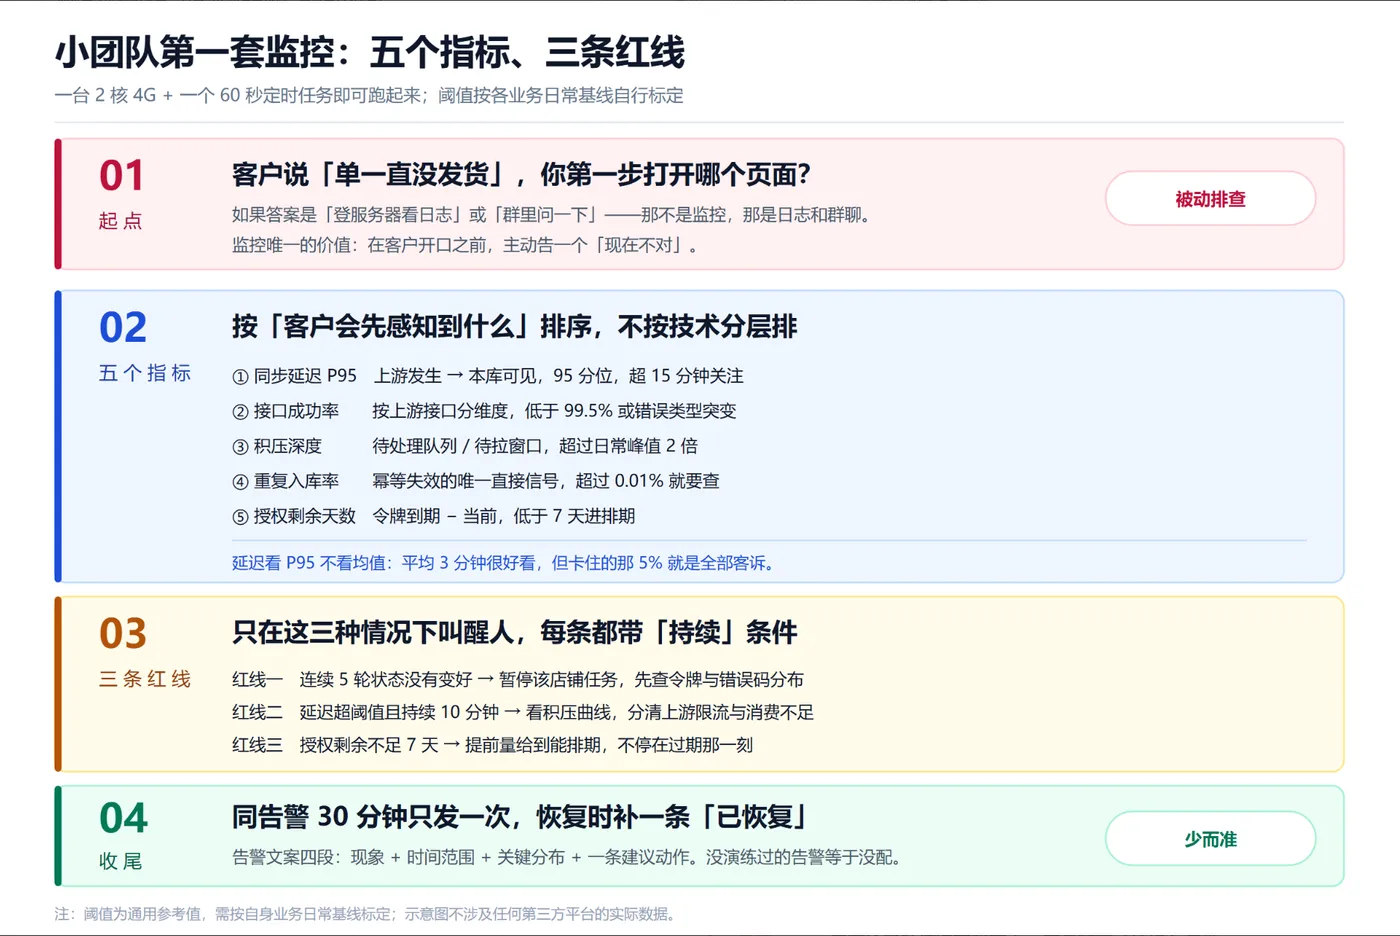
问一个很具体的问题:昨天下午三点,客户说「我的单一直没发货」,你从哪一步开始查?
如果你的答案是「先登服务器看日志」「先问一下是不是网络问题」「先翻一下群里谁改了什么」,那说明你还没有监控——你有的是日志和群聊。
日志能回答「发生了什么」,但它不主动说话;群聊能回答「谁动了什么」,但它靠人自觉。监控的唯一价值是:在客户开口之前,主动告一个「现在不对」的警。
下面这套东西,一台 2 核 4G 的机器 + 一个定时任务就能跑起来,不需要一整套可观测平台。小团队的难点从来不是「装不上」,而是「装上了没人看、告警太多直接静音」。
二、先说三条原则,省掉你三个月的返工
原则一:先监控结果,再监控过程。接口成功率 99.9% 是一种过程指标,它只说明「我发出去了」。业务指标才说明「事情成了没有」。新人最常见的偏差是把过程指标当成绩效面板,结果接口全绿、业务全错。
原则二:指标数量控制在一个人能背下来。超过七个,就没人看全了。五个是我们试过最舒服的数字:一张屏幕放得下,早会一分钟过完。
原则三:每一条告警都必须带「下一步动作」。只会喊「失败了」的告警,等于把排查工作原样丢回给人。告警文案里必须写清:看哪个页面、查哪张表、先做什么。
三、五个必须盯的指标
这五个是按「客户会先感知到什么」排序的,不是按技术分层排序。
| # | 指标 | 口径 | 观察频率 | 参考阈值 |
| 1 | 同步延迟 P95 | 上游发生时间 → 本库可见时间,取 95 分位 | 每分钟 | > 15 分钟 |
| 2 | 接口成功率 | 成功调用 ÷ 总调用,按上游接口分维度 | 每分钟 | < 99.5%,或错误类型突变 |
| 3 | 积压深度 | 待处理队列 / 待拉窗口数量 | 每分钟 | > 日常峰值 2 倍 |
| 4 | 重复入库率 | 重复单数 ÷ 入库总数 | 每小时 | > 0.01% |
| 5 | 授权剩余天数 | 令牌到期时间 − 当前时间 | 每小时 | < 7 天 |
几个选择理由,值得跟团队解释清楚:
为什么延迟看 P95 不看平均值。 平均 3 分钟听起来很好,但如果 5% 的订单卡了 2 小时,那 5% 就是全部客诉来源。平均值会掩盖长尾,而客诉永远来自长尾。
为什么成功率要「按接口分维度」。 整体 99.5% 可能是「查询接口 100%、下单接口 92%」平均出来的。下单接口挂了,整体数字还很漂亮。
为什么重复入库率要单独列。 它是幂等失效的唯一直接信号。这个数字一涨,说明重试链路在造重复数据,而重复数据的代价(多发一件货、多扣一笔钱)比漏单更贵。
为什么授权天数算业务指标。 它不技术,但它是最容易被忽略的「定时炸弹」:令牌一过期,整店停拉,而所有调用指标会显示「没有调用」——不报错,只是安静。
四、三条红线:只在这三种情况下叫你
指标是给人看的,红线是叫醒人的。我们把告警压到三条,就是为了让每一条都有人真的起来处理。
# 每 60 秒跑一次;伪代码,阈值按自己业务的日常基线定
def check(shop_id):
    m = load_metrics(shop_id)
    # 红线一:连续 5 个周期状态都没变好(不是「一次失败」,是「一直不好」)
    if m["fail_streak"] >= 5:
        alert("BLOCK", "同步连续 5 轮失败,已暂停该店铺任务",
              action="先查令牌剩余天数与错误码分布,再查上游公告")
    # 红线二:延迟超阈值且持续 10 分钟(滤掉大促前的瞬时抖动)
    if m["delay_p95_min"] > 15 and m["slow_minutes"] >= 10:
        alert("BLOCK", "同步延迟 P95 已超 15 分钟并持续 10 分钟",
              action="看积压深度曲线,判断是上游限流还是本方消费能力不足")
    # 红线三:授权剩余不足 7 天(提前量给到能排期换证)
    if m["token_days_left"] < 7:
        alert("WARN", f"授权剩余 {m['token_days_left']} 天",
              action="本周内完成续期,不要等过期后重建授权关系")
    # 抑制:同一告警 30 分钟内只发一次,且恢复时补一条「已恢复」
    if should_suppress(shop_id, key=m["alert_key"], window_min=30):
        return
三条红线的共同点是都带「持续」条件:连续 5 轮、持续 10 分钟、剩余 7 天。这是压掉告警噪音最有效的一招——瞬时抖动不该叫醒人,持续劣化才该。
还有一个几乎没人写、但极其重要的细节:恢复通知。只报告警不报恢复,人会一直以为还在故障中,然后开始在群里互相问「好了吗」。补一条「已恢复,持续 12 分钟」,比多十个指标都有用。
五、告警文案:新人最容易写错的地方
同一个故障,两种写法:
- ❌「订单同步任务异常,请处理。」
- ✅「店铺 A 同步连续 5 轮失败(从 14:02 起失败,最近一次 14:07),错误码 401 占 92%,令牌剩余 3 天。下一步:先续期令牌,再回补 14:02 之后的窗口。」
差别不在文学性,在于第二条把「排查」变成了「执行」。凌晨三点被叫起来的人,需要的是动作,不是谜题。
写文案时套这个模板就够了:现象 + 时间范围 + 关键分布 + 一条建议动作。四段,每段不超过一行。
六、新人上手第一周的落地顺序
不要一次做完,按这个顺序,每天一步:
- 第一天:把五个指标的定义写成一页文档,注明时区、时间字段、分母是什么。定义不统一,后面全是争吵。
- 第二天:只做指标 1 和 2 的上报,先能画出曲线,不接告警。
- 第三天:接第一条红线(连续失败),验证告警能发到人。
- 第四天:补抑制与恢复通知,把噪音压下去。
- 第五天:跑一次演练——手动断开一个店铺的授权,看多久能被告警发现、多久能定位。
演练这一步最容易被跳过,但它决定这套东西是真的还是装饰。没演练过的告警,等于没配。
七、检查清单
- 五个指标都有书面口径(时区、时间字段、分母)
- 延迟用 P95/P99,不用平均值
- 成功率按接口分维度,不只看整体
- 重复入库率单独监控,作为幂等失效信号
- 授权剩余天数纳入监控,提前 7 天告警
- 每条红线都带「持续」条件,滤掉瞬时抖动
- 同告警 30 分钟内只发一次,且有恢复通知
- 告警文案含现象 + 时间 + 分布 + 建议动作
- 做过一次故障演练,记录发现耗时
- 告警接收人明确到人,不是「群里发一下」
八、一句总结
小团队的监控不该追求「全」,该追求「看了会动」。五个指标让你一眼知道现在好不好,三条红线让该起来的人起来,一条恢复通知让所有人安心睡回去。
今天就做一件事:把「接口成功率」这个指标旁边,加一个「业务结果对不对」的指标。前者证明你在工作,后者证明你在解决。