
LangChain应用开发:用脚手架组装本地 LLM 应用
前面的 RAG 全链路是用手写 Python 跑通的,每一步——加载、切块、嵌入、检索、拼 Prompt——都是散的。如果打算把这些步骤复用、组装成更大的应用,就需要一层"胶水",LangChain 是这层胶水里用得最广的一个。这一篇把它和本地 Ollama 拼起来跑通,也顺带回答一个更实际的问题:什么规模的个人项目,其实用不上它。
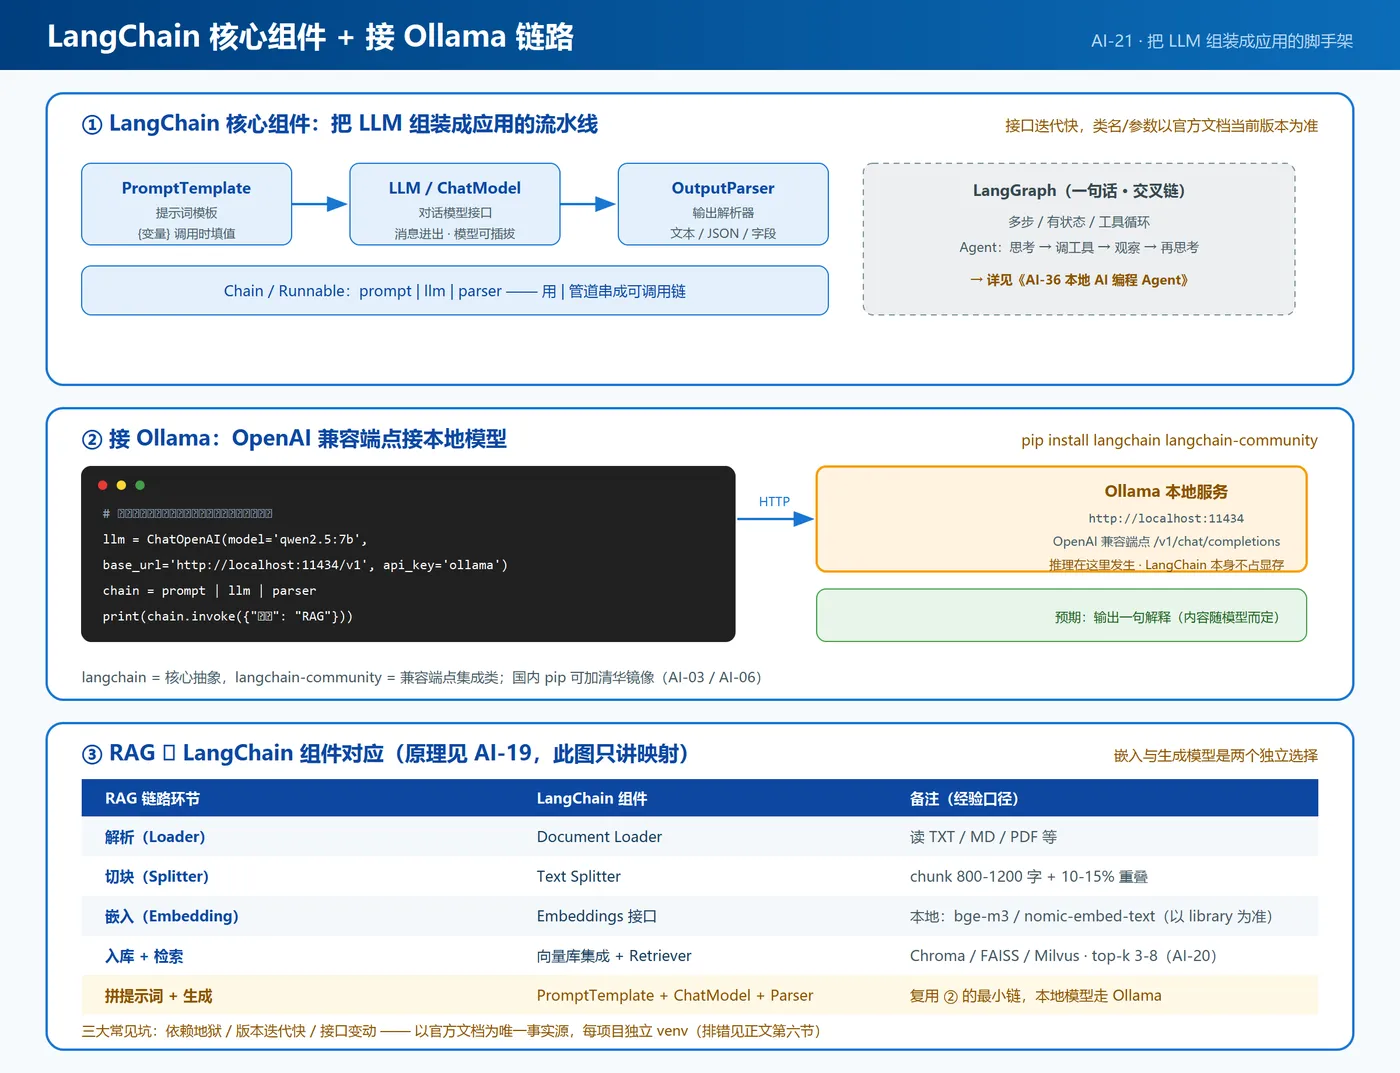
一、为什么需要它
装完 Ollama之后,很多人的下一步就是"写点代码调模型"。直接的办法是拿 requests 直接 POST 到 Ollama 的 OpenAI 兼容端点(接口细节见《AI-08 Ollama进阶与API开发》)——做一次性问答小脚本完全够用。但一个真正的"应用"往往不止一次调用:提示词要模板化(带变量、带角色设定)、输出要解析(抽 JSON、取字段、做格式化)、可能要换模型(分类用一个、生成用一个)、还要把 RAG 检索结果拼进上下文。这些如果全靠手写裸 API 调用,等于自己在重复造一层胶水,而且换个模型、换个接口就要返工。
LangChain 的定位正是这一层:把 LLM 组装成应用的脚手架/胶水层。它给"模型"(ChatModel)、"提示词"(PromptTemplate)、"输出"(OutputParser)、"组件串联"(Chain/Runnable)提供统一接口,任何遵循 OpenAI 兼容协议的模型(包括本地 Ollama)都能被当成一个可插拔的组件接进来。你写的是应用逻辑,而不是翻译层。
还有一层容易被忽略:LangChain 生态是"拆包"的。你一条命令装的是主包,具体模型集成(接 OpenAI 兼容端点的 ChatOpenAI 等)放在 langchain-community 这个社区包里,核心抽象(提示词、Runnable、解析器)则随主包带进 langchain-core。所以不同教程里的导入路径长得不一样,很多时候只是包版本不同——这是"教程代码跑不起来"的主要原因之一,本篇统一按"以官方文档为准"的口径处理。
先把话说死:LangChain 本身不带模型、不占显存——它是个纯进程内的 Python 库,推理全部发生在 Ollama(或其他推理服务)那端。显存预算还是《显存计算与模型选择》那套口径,LangChain 一分不加。这也是本篇环境要求里没有 GPU 硬指标的原因。
"LangChain 教程""LangChain 接本地模型"这类词的搜索热度持续很高,但抱怨也很集中:接口迭代快,教程和库版本对不上。本篇以官方文档当前版本的写法为准,示例也都按这个口径标注——思路可以迁移,具体类名与参数请按官方文档核对后再用。
二、环境要求
| 项目 | 要求 | 说明 |
|---|---|---|
| Python | 3.10 / 3.11 / 3.12 | 保守选 3.11(详见《AI-03 Python环境与虚拟环境》) |
| 虚拟环境 | 建议 venv 隔离 | 防止依赖互相污染(见 3.1) |
| Ollama | 已安装且拉取至少一个 LLM(如 qwen2.5:7b) | 详见《AI-07 Ollama本地部署大模型》 |
| Ollama API | http://localhost:11434 可达 |
curl http://localhost:11434/api/tags 能返回模型列表 |
| 网络 | pip 安装(国内建议清华镜像) | -i https://pypi.tuna.tsinghua.edu.cn/simple |
| 显存 | LangChain 本身不需要额外显存 | 预算在 Ollama 模型侧(AI-05 口径) |
三、安装与部署
3.1 先建虚拟环境(防依赖地狱的第一铁律)
LangChain 的依赖树不小且迭代快,装进全局环境基本等于把"依赖地狱"请回家。我一般每个项目单独建一个 venv:
python -m venv .venv
.venv\Scripts\activate      # Windows(Linux 用 source .venv/bin/activate)
3.2 安装 langchain
pip install langchain langchain-community
langchain:主包,核心抽象都在这里;langchain-community:社区集成包,接 Ollama 走的 OpenAI 兼容端点所用的类就在这个包里,这行省不掉。
国内网络加镜像:pip install langchain langchain-community -i https://pypi.tuna.tsinghua.edu.cn/simple。
3.3 四个核心概念(接口迭代快,以官方文档说明为准)
- LLM / ChatModel:模型接口。ChatModel 面向对话式模型(消息进出),本地 LLM 基本都走它;
- PromptTemplate:提示词模板。用
{变量}留空,调用时填入具体值; - OutputParser:输出解析器。把模型的原始输出整理成程序里好用的形式(字符串、JSON、对象);
- Chain / Runnable:组件串联。上述组件都实现了 Runnable 接口,可以用
|(管道)运算符串成一条链——prompt | llm | parser是 LangChain 最经典的写法。
把它们串成直觉:PromptTemplate 像一张带空格的表单,ChatModel 是"填表提交"这个动作,OutputParser 是把返回结果整理成程序可用格式的后处理,Chain 是把三者接起来的传送带。后面 7 行代码看似能干很多事,本质就是这条流水线:填表 → 提交 → 整理结果。
具体类名、导入路径、参数名以官方文档当前版本为准(python.langchain.com),下文示例按写作时官方文档的写法给出,跑之前先核对一遍导入路径。
3.4 一个最小可跑链路(Prompt → LLM → Parser)
前提:Ollama 已启动,且 ollama list 里能看到 qwen2.5:7b(或你已有的任意模型名):
# 注意:导入路径 / 参数名以官方文档当前版本为准
from langchain_community.chat_models import ChatOpenAI
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser

# 接本地 Ollama:走 OpenAI 兼容端点
llm = ChatOpenAI(
    model="qwen2.5:7b",
    base_url="http://localhost:11434/v1",   # Ollama 的 /v1 兼容端点
    api_key="ollama",                        # Ollama 不校验 key,随便填个字符串即可
)

prompt = ChatPromptTemplate.from_template(
    "用一句话解释{概念},面向新手,避免术语。"
)
parser = StrOutputParser()

chain = prompt | llm | parser                # Runnable 链
print(chain.invoke({
   "概念": "RAG"}))
两个常见变体(同样以官方文档当前写法为准):一是结构化输出——让模型返回 JSON,再换成对应的 OutputParser 解析成 dict,程序里就能直接取字段,比从一大段文字里正则抠信息稳定得多;二是流式输出——回答逐段吐出来而不是等完整结果,前端体验好很多。做小项目时的顺序建议:先把非流式、纯文本版本跑通,再叠加这两个能力。
执行顺序:模板填变量 → 组装好的提示词发到 Ollama 的 /v1/chat/completions → 返回文本交给 Parser → 得到最终输出。把 model 换成 ollama list 里的另一个模型名,就完成了一次"换模型"——这正是框架替你买到的能力,裸 API 写法里它要改的不止一处。
四、验证
- 网络层:宿主机
curl http://localhost:11434/api/tags能返回 JSON 模型列表; - 环境层:
where python(Windows)/which python(Linux)指向.venv里的解释器,且python -c "import langchain; print(langchain.__version__)"能出版本号; - 链路层:运行 3.4 的脚本,终端打印出一句解释(内容随模型而定,重点是有输出且跑通三段);
- 组件层(可选):在链上加打印,确认模板填充后的提示词、LLM 原始返回、Parser 结果各段都符合预期。
这四层验证的意义不只是"跑通了",而是给你一套 30 秒排错反射:以后出问题,先按顺序跑这四步,确定断在哪层,再只修那一层。这就是系列统一的"分层定位法"——网络层(服务应不应)→ 环境层(解释器对不对)→ 应用层(链通不通)。常见的情况是花一小时改代码,最后发现"Ollama 忘了启动"。
卡在哪一层,对照第六节;这四层就是排错的顺序。
五、进阶技巧
5.1 RAG 在 LangChain 里怎么搭:组件对应表(不重复原理)
为什么强调"不重复原理"?RAG 的完整原理 AI-19 已经讲清,本篇要回答的是另一个问题:这条链路如果想自己用代码写,每一步该找什么组件。答案就是下面这张对应表——你只需要记住"环节 → 组件"的映射关系,每个组件的具体类名与参数到官方文档里查当前版本。
RAG 标准链路(文档 → 解析 → 切块 → 嵌入 → 入库 → 检索 → 拼提示词 → 生成,原理详见)与 LangChain 组件一一对应:
| RAG 链路环节 | LangChain 组件 | 备注 |
|---|---|---|
| 解析(Loader) | Document Loader | 读 TXT/MD/PDF 等 |
| 切块(Splitter) | Text Splitter | 经验值:chunk 800-1200 字 + 10-15% 重叠 |
| 嵌入(Embedding) | Embeddings 接口 | 本地可用 Ollama 的 bge-m3 / nomic-embed-text(以 library 为准) |
| 入库(向量库) | 向量库集成(Chroma / FAISS / Milvus) | 选型见《AI-20 向量数据库与嵌入模型》 |
| 检索(top-k) | Retriever | 经验参考 top-k 3-8 |
| 拼提示词 + 生成 | PromptTemplate + ChatModel + Parser | 复用 3.4 的最小链 |
可以看到:LangChain 没有发明新的 RAG,它只是给 RAG 链路的每个环节提供了可插拔的槽位。不写代码想要 RAG,AnythingLLM、Dify都是现成平台;需要定制、要嵌进自己的程序里,才轮到 LangChain。
有一个细节值得单独强调:RAG 里的嵌入模型和生成模型是两次独立的选择。本地场景两者都可以让 Ollama 提供——嵌入选 bge-m3 或 nomic-embed-text,生成选 qwen2.5:7b 这类(模型名以 ollama.com/library 为准)。漏配嵌入模型是本地 RAG 最经典的"链路转不起来"事故,和 AI-18 里 Dify 知识库的教训完全同源。
5.2 LangGraph 一句话
LangChain 解决"一串组件",多步、有状态、带循环和分支的流程(比如 Agent 的思考 → 调工具 → 观察结果 → 再思考)交给 LangGraph:它把流程表达成一张带状态的图,Agent 循环就是其中一个典型用例。
一条判断标准:如果你的流程是直线型(A → B → C,一次走完),LangChain 的链就够了;如果流程里有循环(模型调了工具、要看结果、再决定下一步,可能反复)或需要记住中间状态(多轮对话上下文、任务进度),就该上 LangGraph。编程 Agent、"深度研究"型 Agent 都属于后者——它们的本质是"带记忆的循环",不是"一串组件"。
5.3 生态选型建议(开工前先对号入座)
| 你的场景 | 建议 |
|---|---|
| 一问一答的小脚本、只用一个模型 | 不一定要框架,requests 直连 Ollama /v1(AI-08) |
| 多组件编排 / 多模型切换 / RAG,且要代码定制 | LangChain |
| 复杂 Agent(多步、有状态、工具循环) | LangGraph(AI-36) |
| 不写代码、要可视化编排 | Dify(AI-18) |
我的判断标准:项目里只有一处 LLM 调用,框架是负担;出现三件以上组件(提示词模板 + 检索 + 解析 + 第二个模型),框架就开始回本。
5.4 三大常见坑(都是高频真实体验)
依赖地狱:LangChain 生态包多,版本约束也严,典型症状是"pip install 成功了,import 却报错",或者"升级了一个包,另外两个跟着坏"。我的习惯:每项目一个独立 venv(3.1 那步不是可选项);从不单独升级某个包——要么整套一起升,要么都不动;遇到版本冲突,先整体升级 langchain 全家桶对齐生态,再逐个定位。
版本迭代快:这个库的迭代速度远高于一般 Python 库,教程天然滞后几个月——你看的文章里的类名、参数、导入路径,在你装的版本里可能已经不存在了。正确姿势:把教程当"概念讲解"用,动手时以官方文档查到的当前 API 形态为准(本篇示例也都是这个处理方式)。
接口变动:接口变动导致"昨天能跑今天报错"在这个生态不罕见。处理顺序:先对比两个环境的 pip show langchain 版本,确认不是"环境不一致";再查官方文档的迁移说明;最后才考虑去论坛找代码片段——直接照抄论坛代码,往往把旧版本的问题原样搬进新环境。
三个坑的根源是同一个:一切以官方文档的当前版本为准。本篇代码写作时同样以此为准,你运行前请按当前版本再核对一遍。
六、故障排查(按层定位)
| # | 症状(报错原文) | 层 | 原因 | 解决 | |
|---|---|---|---|---|---|
| 1 | ModuleNotFoundError: No module named 'langchain' |
环境 | 激活的解释器不是装了包的环境(全局与 venv 混了) | where python(Win)/ which python(Linux)确认解释器路径;重新激活 .venv 再装 |
|
| 2 | ModuleNotFoundError: No module named 'langchain.chains'(网上教程的导入路径失效类) |
依赖 | LangChain 拆包、模块重组,旧导入路径已不存在(接口迭代快) | 以 python.langchain.com 当前模块结构为准,别照抄旧博客代码;整套包一起升级,别只升单个 | |
| 3 | ImportError: DLL load failed while importing ...(Windows) |
环境 | VC++ 运行库缺失 / Python 位数不对(32 位) | 装 VC++ 2015-2022 Redistributable x64;确认是 64 位 Python | |
| 4 | HuggingFace 下载卡住 / ConnectionError / 超时(下载 bge-m3 等嵌入模型时) |
网络 | 国内访问 huggingface.co 受限 | set HF_ENDPOINT=https://hf-mirror.com(Win)/ export HF_ENDPOINT=https://hf-mirror.com(Linux),或走 ModelScope(详见《AI-06 模型下载全攻略》) |
|
| 5 | Ollama 拉模型中途断(网络抖动)/ ollama: command not found |
网络/安装 | 大文件传输中断;或 PATH 未刷新 | 重新 ollama pull(支持断点续传,继续拉即可);重开终端,检查安装 |
|
| 6 | Failed to start Ollama service(Linux)/ 11434 端口被占 |
服务/端口 | 端口被占用 / 服务未起 | `netstat -ano \ | findstr :11434(Win)/lsof -i:11434(Linux)找占用;sudo journalctl -u ollama` 看日志 |
| 7 | 代码连 http://localhost:11434/v1 超时/拒绝连接 |
应用 | Ollama 没启动,或代码里模型名不在库里 | 宿主机先 curl http://localhost:11434/api/tags 验证服务;确认 ollama list 里有代码里写的那个模型名 |
排错顺序:环境层(解释器对不对)→ 网络层(装得上吗)→ 服务层(Ollama 活着吗)→ 应用层(链通吗)。应用层反复改代码没用的时候,多半是下层 Ollama 没启动。
七、本篇自检清单
- [ ] 能说出 LangChain 的定位(LLM 应用脚手架/胶水层;本身不占显存)
- [ ]
pip install langchain langchain-community完成,且装在独立 venv 里 - [ ] 能说出四个核心概念(ChatModel / PromptTemplate / OutputParser / Chain-Runnable)各管什么
- [ ] 3.4 的最小链路跑通,接 Ollama 用的是
base_url="http://localhost:11434/v1" - [ ] 能默写 RAG ↔ LangChain 组件对应表(Loader / Splitter / Embeddings / 向量库 / Retriever)
- [ ] 理解 LangGraph 的边界(多步、有状态、Agent 循环)与四行选型表
- [ ] 能独立排掉两种
ModuleNotFoundError与ImportError: DLL load failed - [ ] 对自己的项目做过判断:一处调用不用框架,多组件编排才用
