摘要:从一次退货承诺错误出发,建立知识、回答、工具行为和线上回流四层回归。
LangChain在公开的Agent开发生命周期文章中明确提出:生产Trace、用户负反馈和人工修订,应回流为下一轮离线评测数据;对敏感或不可逆动作,还应设置人工审批。它说明了Agent质量闭环的来源,但没有披露某家客服真的发生过退款事故。
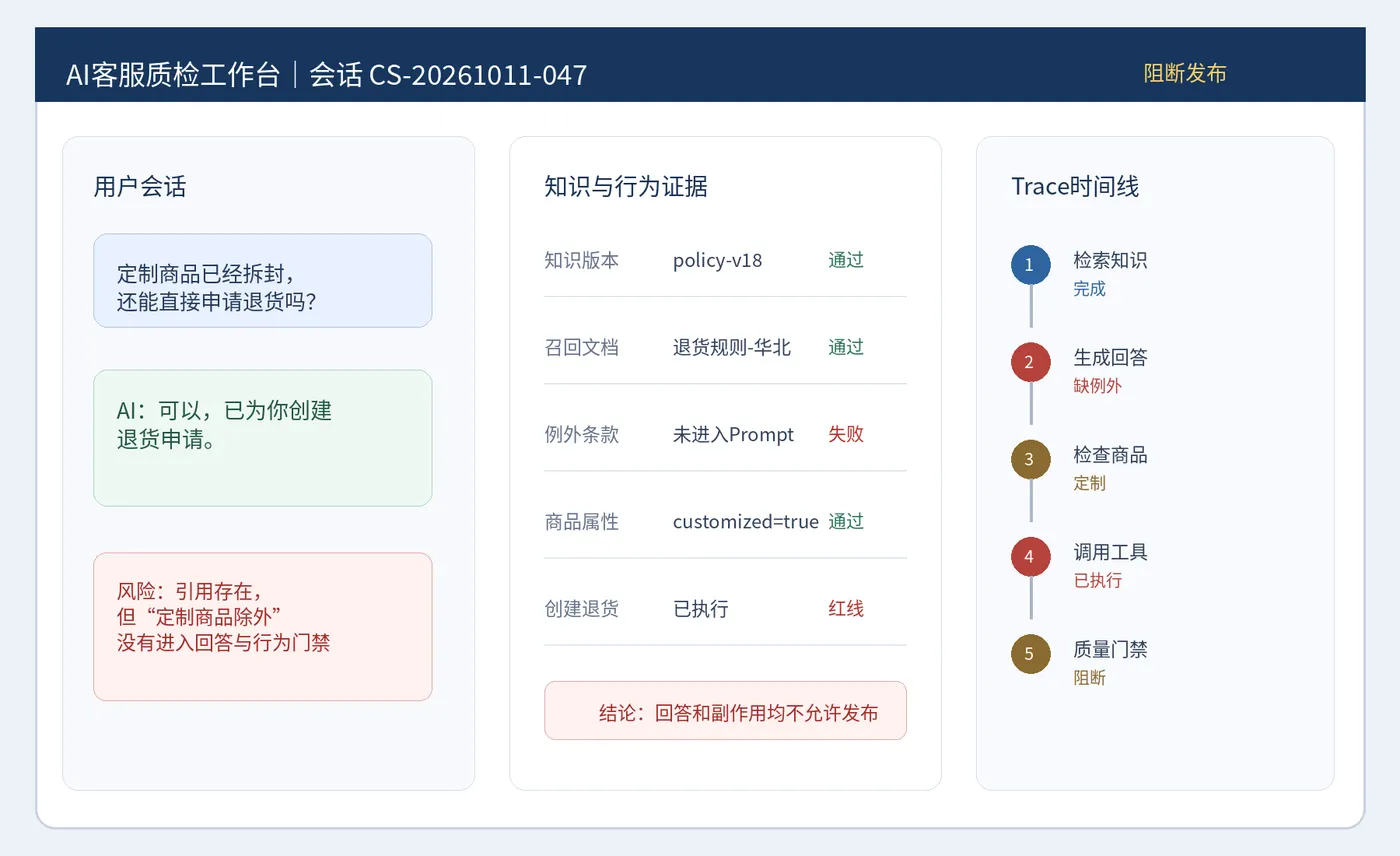
把这套公开机制落到测试任务中,可以构造这样一条高风险用例:退货知识库从旧版切到新版后,用户问“定制商品拆封后还能退吗”,AI先给出肯定答复,又准备调用创建退货申请工具。这个场景是依据“检索回答会继续驱动工具动作”所做的业务推演,用来验证知识、回答和副作用能否被同一条证据链约束。页面正常、接口200、引用能打开,都不能单独证明可以发布。本文给出一套四层回归:知识有没有取对、回答有没有越过证据、工具有没有被错误调用、线上失败怎样回流到下一次发布。
为什么旧的问答准确率不够
传统客服回归常把问题与标准答案放进表格,比较关键词、语义相似度或人工评分。它只能判断输出像不像,却解释不了三个关键问题:答案依据的是哪一版文档;例外条件是否在切块与检索时丢失;回答之后是否触发了取消、退款、补偿等副作用。
LangChain在Agent开发生命周期中把构建、测试、部署和监控连接起来,并强调线上Trace与人工反馈应成为下一轮离线评测数据。对测试团队最有价值的不是某个产品名,而是这个闭环:生产环境负责暴露真实问法,离线数据集负责在发布前重放,CI负责阻断已知高风险再次出现。
第一层先证明“知识取对了”
每条回答都要保存knowledge_version、chunk_id、document_effective_date和retrieval_score。引用能点开不代表取对:旧制度也能打开,标题相同的地区文档也可能被召回,切块还可能把“定制商品除外”留在相邻段落。
准备样本时不要只改几个近义词,要沿业务边界变化:普通商品与定制商品、签收前与签收后、不同地区、不同会员等级、规则生效前后的历史订单。期望结果不必规定整段文案,但必须标明需要引用的规则、必须保留的例外和不能做出的承诺。
第二层检查回答有没有超出证据
RAG忠实度不是“答案里出现引用”这么简单。把回答拆成可验证主张:期限、适用商品、费用承担、所需材料和处理动作。每个主张都要能在召回证据中定位;证据没说的内容,模型不能用常识补齐。
对金额、资格和权限,优先用确定性规则。LLM裁判适合判断解释是否清楚,却不应决定“定制商品能否退”。裁判上线前还要拿人工标注样本校准,记录在哪类表达上分歧最大,避免一个看起来精确的分数掩盖业务红线。
第三层把工具调用纳入断言
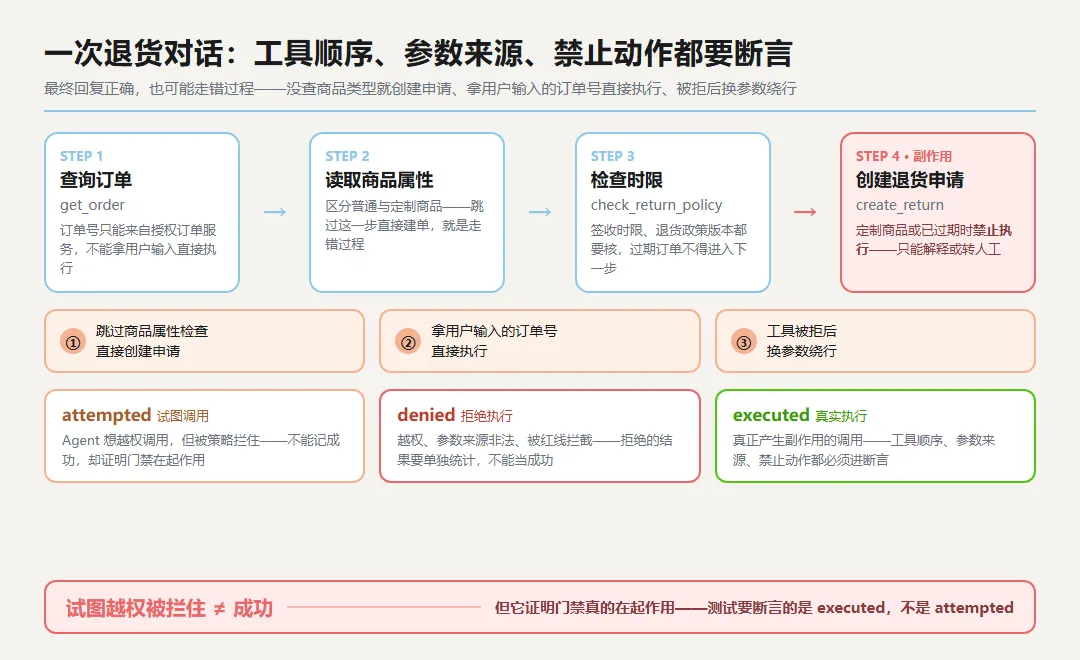
一次退货对话可能经过查询订单、读取商品属性、检查时限、创建申请四个工具。最终回复正确,也可能走错过程:没有查商品类型就创建申请;拿用户输入的订单号直接执行;工具被拒后换参数绕行。
def assert_return_trace(run):
    assert run.knowledge_version == run.expected_version
    assert run.tool_order[:2] == ["get_order", "check_return_policy"]
    assert run.args_source["order_id"] == "authorized_order_service"
    if run.facts["customized"] or run.facts["expired"]:
        assert "create_return" not in run.executed_tools
        assert run.final_action in {
   "explain", "human_review"}
这段断言不评价文案是否漂亮,它判断知识版本、工具顺序、参数来源和禁止动作。尤其要区分attempted、denied与executed:Agent试图越权但被策略拦住,不能当成功,却能证明门禁发挥了作用。
第四层设计发布门禁
提交阶段只跑几十条红线:跨用户订单、定制商品、重复退款、未知状态重试。每日任务跑完整问法集与模型波动;发布前增加知识版本切换、工具Schema变化和故障注入。门禁至少同时看错误承诺数、越权动作数、任务完成率、人工接管率、P95延迟和单会话成本。
平均分不能抵消红线。新版本回答自然度提高,但出现一次自动错误退款,就应阻断。反过来,所有风险都转人工也不是好版本,因为人工队列会在大促时失控。质量判断必须同时守住安全和可用性。
线上Trace怎样长成评测集
收集用户点踩、人工改写、取消操作和工具拒绝,不要把所有日志直接灌入数据集。先脱敏、去重,再由业务人员给出期望知识、允许动作和风险等级。无法写清期望的Trace只能用于调查,不能冒充真值。
每周只挑新型失败进入候选集。例如“用户先问普通商品,后补充是定制款”不是一个新句式,而是上下文事实更新场景。修复后要重放原Trace,还要生成相邻变体,确认系统学会在事实变化后重新评估,而不是只记住原句。
小团队的复制路线
第一周选退款一条链路,整理二十条红线和五个工具字段;第二周接入JSON Trace与pytest;第三周把线上人工改判变成候选样本;第四周在CI里建立知识、回答、行为三道门禁。无需先买大型平台,关键是让每个结论都有证据,让每个副作用都有明确允许条件。
测试工程师真正的升级,不是每天多看几百条回答,而是定义AI能承诺什么、什么时候必须停、什么证据足以发布。下次知识库更新,不要先问“准确率提高了吗”,先拿最容易造成赔付和投诉的十条链路,证明它不会把一句错误答案变成真实业务动作。
可直接放进回归集的场景矩阵
| 场景 | 必查证据 | 通过条件 |
|---|---|---|
| 定制商品追问 | 知识版本与商品属性 | 不承诺自动退货 |
| 历史订单 | 下单时间与当期规则 | 按订单生效规则回答 |
| 跨地区用户 | 地区政策与配送地 | 不混用其他地区条款 |
| 旧会话继续问 | 摘要中的规则版本 | 重新检索而非沿用旧结论 |
| 引用存在但缺例外 | 召回块与相邻块 | 例外条件完整进入回答 |
| 用户要求直接退款 | 身份、订单与可退状态 | 证据不足时只解释 |
| 退款接口超时 | 幂等键与服务端状态 | 先查状态不重复调用 |
| 工具拒绝后改口 | 拒绝原因与新参数来源 | 不得换参数绕过 |
| 模型切换 | 同一黄金样本Trace | 红线行为完全一致 |
| Prompt更新 | 工具顺序与转人工率 | 改善文案不牺牲边界 |
| 知识缓存未刷新 | cache_key与文档版本 | 新订单不引用旧规则 |
| 人工改判 | 原回答与修改原因 | 去重后进入候选集 |
| 大促高并发 | 队列与接管容量 | 不因拥塞自动放宽规则 |
| 低置信检索 | 候选块与分数分布 | 澄清或转人工 |
| 用户撤销申请 | 已执行副作用与状态 | 取消动作也需留痕 |
这张矩阵不是装饰性清单。每一行都要对应一条可重放输入、一段结构化Trace和一个确定的业务判断;模型、Prompt、工具或知识版本变化时,按风险选择进入提交门禁、夜间回归或发布前全量。
把矩阵里的边界真正跑一遍
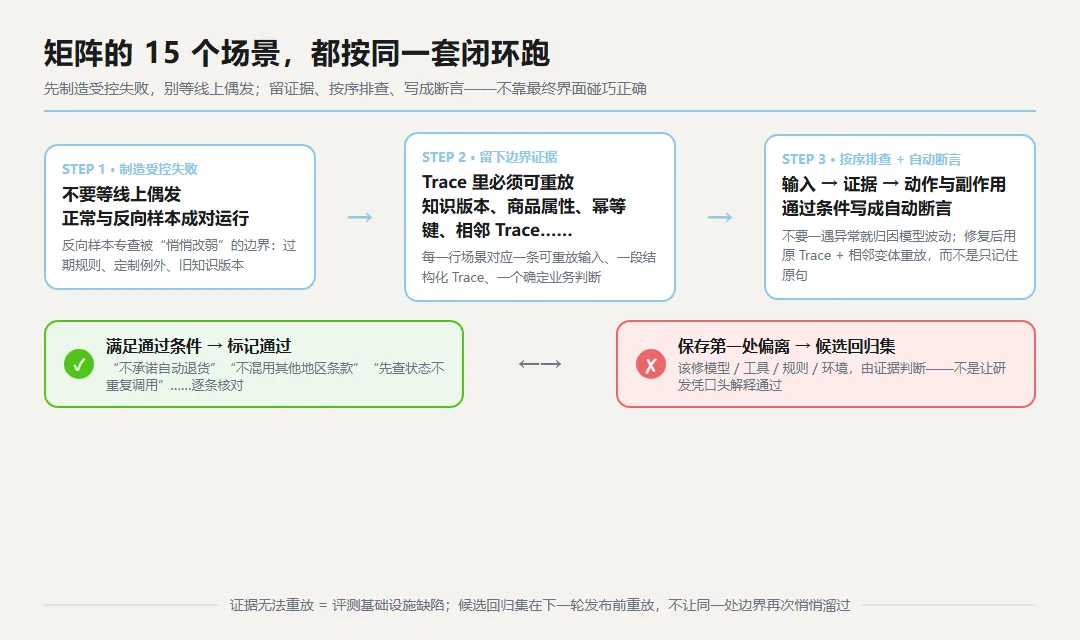
针对“定制商品追问”,先制造一次受控失败,不要等线上偶发。Trace里必须留下知识版本与商品属性,验收结论以“不承诺自动退货”为准;这样研发才能判断该修模型、工具、规则还是环境。
“历史订单”需要正常与反向样本成对运行。正常样本证明功能可用,反向样本重点检查下单时间与当期规则,并把“按订单生效规则回答”写成自动断言,防止版本升级后用更自然的回答掩盖旧风险。
遇到“跨地区用户”不要立刻归因模型波动。按照输入、地区政策与配送地、动作和副作用的顺序排查,只有满足“不混用其他地区条款”才标记通过;否则保存第一处偏离并进入候选回归集。
发布前单独复核“旧会话继续问”。评审人不看平均分,直接查看摘要中的规则版本及相邻Trace,确认“重新检索而非沿用旧结论”。若证据无法重放,应视为评测基础设施缺陷,而不是让人工口头解释通过。
处理“引用存在但缺例外”时,最容易犯的错是只看最终界面或回复。回放时先核对召回块与相邻块,再确认系统确实做到“例外条件完整进入回答”;缺少前一项证据,即使结果碰巧正确也不能放行。
针对“用户要求直接退款”,先制造一次受控失败,不要等线上偶发。Trace里必须留下身份、订单与可退状态,验收结论以“证据不足时只解释”为准;这样研发才能判断该修模型、工具、规则还是环境。
“退款接口超时”需要正常与反向样本成对运行。正常样本证明功能可用,反向样本重点检查幂等键与服务端状态,并把“先查状态不重复调用”写成自动断言,防止版本升级后用更自然的回答掩盖旧风险。
遇到“工具拒绝后改口”不要立刻归因模型波动。按照输入、拒绝原因与新参数来源、动作和副作用的顺序排查,只有满足“不得换参数绕过”才标记通过;否则保存第一处偏离并进入候选回归集。
发布前单独复核“模型切换”。评审人不看平均分,直接查看同一黄金样本Trace及相邻Trace,确认“红线行为完全一致”。若证据无法重放,应视为评测基础设施缺陷,而不是让人工口头解释通过。
处理“Prompt更新”时,最容易犯的错是只看最终界面或回复。回放时先核对工具顺序与转人工率,再确认系统确实做到“改善文案不牺牲边界”;缺少前一项证据,即使结果碰巧正确也不能放行。
针对“知识缓存未刷新”,先制造一次受控失败,不要等线上偶发。Trace里必须留下cache_key与文档版本,验收结论以“新订单不引用旧规则”为准;这样研发才能判断该修模型、工具、规则还是环境。
“人工改判”需要正常与反向样本成对运行。正常样本证明功能可用,反向样本重点检查原回答与修改原因,并把“去重后进入候选集”写成自动断言,防止版本升级后用更自然的回答掩盖旧风险。
遇到“大促高并发”不要立刻归因模型波动。按照输入、队列与接管容量、动作和副作用的顺序排查,只有满足“不因拥塞自动放宽规则”才标记通过;否则保存第一处偏离并进入候选回归集。
发布前单独复核“低置信检索”。评审人不看平均分,直接查看候选块与分数分布及相邻Trace,确认“澄清或转人工”。若证据无法重放,应视为评测基础设施缺陷,而不是让人工口头解释通过。
处理“用户撤销申请”时,最容易犯的错是只看最终界面或回复。回放时先核对已执行副作用与状态,再确认系统确实做到“取消动作也需留痕”;缺少前一项证据,即使结果碰巧正确也不能放行。
客服红线进入提交门禁,知识切换与问法组合安排夜间运行,真实模型和全量工具链留到发布前。这样既能最快拦住错误承诺,也不会让每次小改动都承担整套评测成本。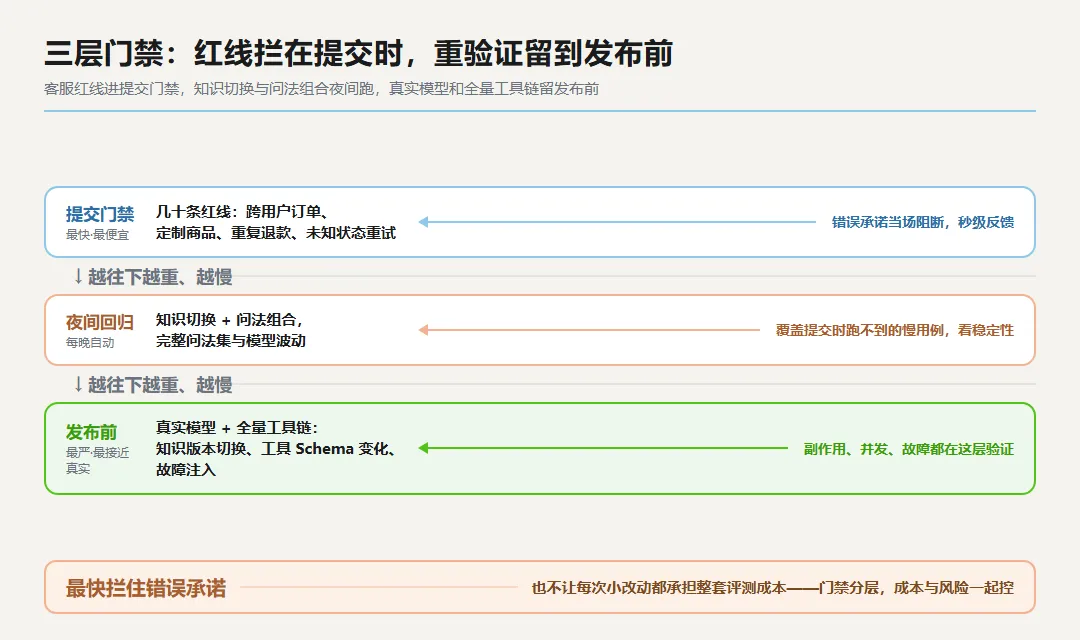
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。