你的记忆系统可能在删「从未被检索过的金子」:因果干预让记忆效用可识别

简介: 本文提出因果记忆策略(CMP),直击记忆增强智能体的核心缺陷:未被检索的记忆效用无法识别(检索层正性违反)。创新性地将干预对象从“删除记忆”转向“强制检索”,在SCM框架下实现所有记忆效用的可识别与无偏估计,解决“从未被用≠没用”的误判问题。(239字)

记忆增强智能体按「对任务的效果」决定留哪条记忆——但效果估计完全依赖「被检索到」。从未被检索的记忆,删了和留着结果一模一样,它的真实效用永远无法被现有方法识别。这篇论文用因果干预框架解决这个「检索层正性违反」:对检索动手而非对存储动手,让每条记忆的效用变得可识别。
arXiv · 2026-10-01
1.png

arXiv 2610.02070 · Causal Memory Policy: Making Memory Utility Identifiable by Intervening on Retrieval · 2026-10-01 · 伊利诺伊理工
问题:从未被检索的记忆,效用无法识别
记忆增强智能体的核心决策是「留哪些记忆」。主流方法:估计每条记忆对任务表现的影响,按影响排序淘汰。
但这里有个结构性盲点:效用估计完全依赖被检索到的记忆。一条记忆如果从未被检索(查询词没匹配上、排序靠后),它的存在与否对任务结果没有任何影响——你删掉它,指标纹丝不动。
于是「删了没影响」被误读为「没有价值」。但真实情况可能是:它只是没被给过机会。一条存对了但检索词不巧错开的记忆,和一条真的垃圾记忆,在现有指标下不可区分。这在因果推断里叫正性违反(positivity violation)——干预的某个取值从未被观察到,效果就无法识别。
方法:对检索干预,不对存储干预
2.png

论文提出 CMP(Causal Memory Policy)——把记忆增强智能体形式化为结构因果模型(SCM),检索是记忆与任务效果之间的中介变量。
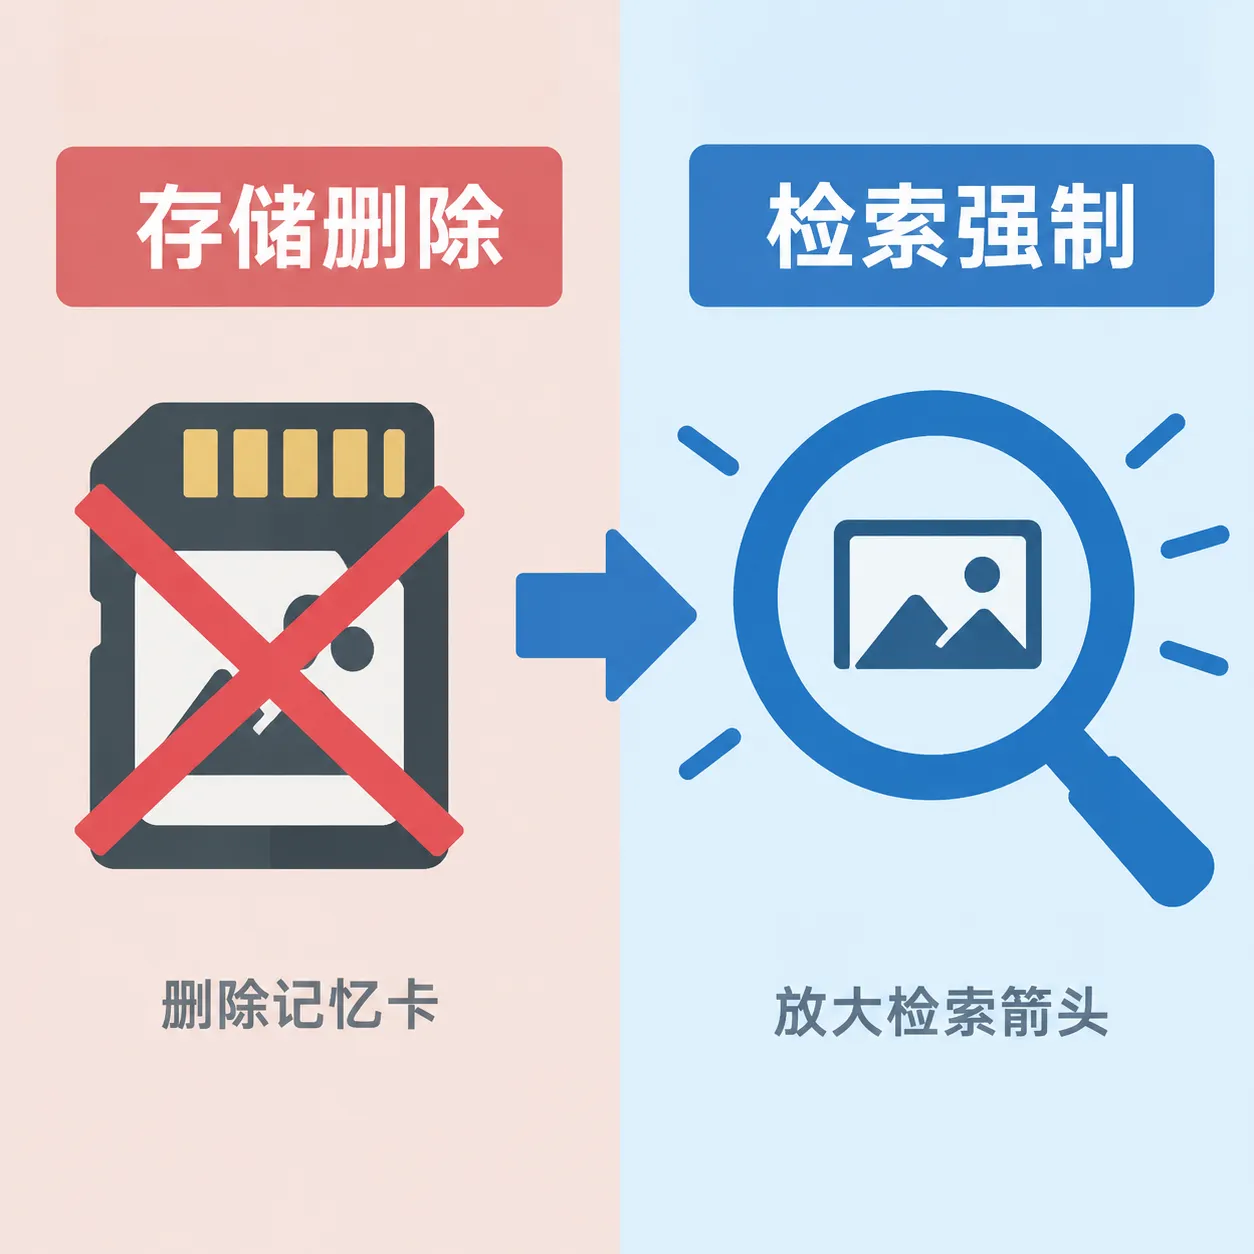
关键转换:现有方法对存储做干预(删这条记忆看效果变化)——对从未被检索的记忆,这个干预是空操作。CMP 对检索做干预——强制做一次「若不检索 vs 检索」的对照:

  • 不是「删掉这条记忆会怎样」(对未检索记忆无效) - 而是「强制检索这条记忆会怎样」(对任何记忆都能测出效果)
    通过对检索中介的干预,恢复了记忆效用的因果分解——包括那些从未自然参与过任务的记忆。估计量还满足无偏性(论文给出了形式化论证)。
    这个问题为什么真实存在
    一个直白的场景:用户问「怎么配置定时任务」,记忆库里有条写得极好的定时任务指南,但它的标签词是「cron 调度」——检索词没对上,这条记忆从未被召回。运行十次任务,它从未出现。
  • 现有系统:删了没影响(从未被用到)→ 被清理 → 永远丢失 - CMP:强制检索一次做对照 → 发现它其实写得很好 → 保留并调整检索映射
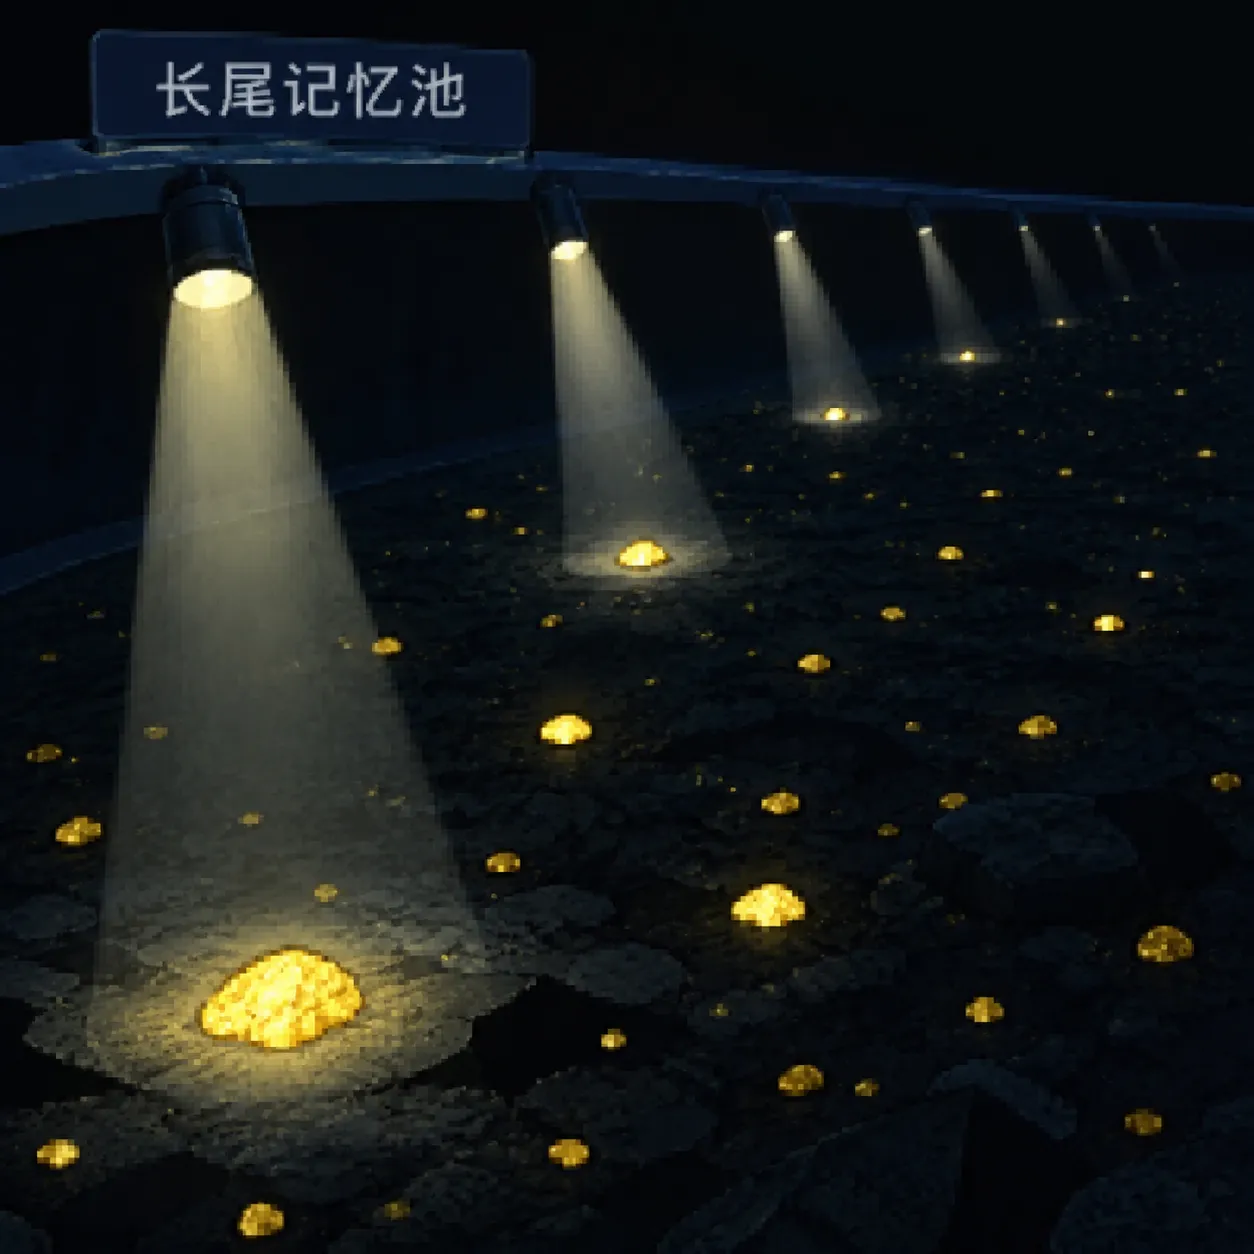
    「从未被用到」和「没用」是两件事——这就是检索层正性违反的实践含义。而且这类问题在记忆库变大后更严重(条目越多,单条被检索的概率越低,「从未被检索」的池子越大)。
    为什么值得读
    3.png
  1. 把记忆管理的盲点形式化了——「未检索记忆的效用不可识别」从直觉变成有名字的因果缺陷(正性违反),这是能引用的概念 2. 干预对象的转换很妙——从「对存储动手」转为「对检索动手」,一步之差解决了结构性盲点 3. SCM 形式化的红利——因果框架给了无偏性论证,不是启发式修补 4. 与记忆系统实践直接相关——任何做记忆清理/淘汰的系统都应该检查:你的清理规则是否会把「没被给过机会的好记忆」误杀
    与 BuddyMe 的经验印证
    BuddyMe 的经验循环把每版决策与产物落盘,记忆条目保留完整检索轨迹(哪条记忆被哪些任务召回过)——这正好是 CMP 式干预需要的数据基础:知道哪些记忆从未被检索,才能对它们做定向对照。我们做记忆分层时发现过同款问题:表面「零引用」的记忆,强制召回测试后质量很高——只是检索词没对上。CMP 的贡献是把这种经验直觉形式化成了因果框架。每天免费 4500 万 token,够对长尾记忆池跑完整的对照评估。
    BuddyMe 每日免费 4500 万 Token。

目录
相关文章
|
8月前
|
SQL 程序员 数据处理
优化Python循环:从10秒到0.1秒的性能调优
本文以小李优化三百万行日志处理为例,详解Python循环性能瓶颈及七步调优法:精简循环体、预提方法、改用列表推导式、map/filter组合、避免重复转换、引入pandas等高效工具,最终将耗时从10秒降至0.1秒级。强调“先写对,再写快”,兼顾性能与可维护性。(239字)
446 8
|
1月前
|
人工智能 运维 IDE
2026 年 AI 编程工具 Qoder CN 研究:免费社区版能力拆解、Credits 额度管控与实战项目解析
Qoder CN免费社区版作为普惠开发者的AI编程工具,凭借永久免费、全主流技术栈适配、多端覆盖、专属Credits免费额度体系,解决普通学习者、个人开发者使用AI编码工具付费门槛高的痛点。
551 0
|
1月前
|
缓存 JSON API
2026 年 DeepSeek‑V4 完整技术解析:Flash 与 Pro 双版性能对比、计费缓存机制与 API 实战调用全教程
官方对外提供OpenAI、Anthropic两套兼容API接口,提供curl、Python完整调用示例,原有存量项目迁移成本很低。开发者上线业务,需要结合业务并发量、推理复杂度、预算规模选择合适版本;中大型平台推荐分层调度混合使用两款模型,平衡成本与输出质量。无论是个人原型验证、中小企业AI产品上线,还是企业级智能体系统开发,DeepSeek‑V4双版本可以覆盖绝大多数文本处理、Agent自动化开发需求。
694 2
|
1月前
|
人工智能 缓存 数据可视化
阿里云百炼是什么?一文看懂百炼AI模型平台介绍、百炼API使用及Token计费说明
阿里云百炼(Model Studio)是阿里云推出的一站式AI大模型服务平台,集成Qwen全系及DeepSeek、Kimi等主流模型,支持OpenAI兼容API与零代码智能体构建,覆盖RAG、多模态、工作流等场景,新用户赠7000万Tokens。(239字)
385 1
|
1月前
|
弹性计算 人工智能 分布式计算
2026年10月最新!阿里云20款热门服务器配置排行榜:含价格、带宽、适用场景全解析
基于2026年10月最新促销数据,整理阿里云最热20款服务器配置榜,按T1(个人入门)、T2(中小企业)、T3(AI/高性能)三梯队分类,覆盖轻量应用服务器与ECS,含价格、适用场景及避坑指南,助您高效选型。
484 0
|
1月前
|
自然语言处理 API 开发工具
阿里云百炼 API Key 配置研究:密钥申请、权限管理、环境变量部署与多语言接口调用全流程
目前在使用百炼大模型服务平台进行接口开发的时候,API‑Key是访问大模型服务最重要的身份凭证,所有模型推理请求、多模态生成、Agent工具调用都依靠这串密钥完成身份鉴权。很多刚接触平台的开发者会遇到找不到密钥入口、创建失败、权限不对、环境变量配置不生效、跨地域调用报错等一系列问题。很多新手不清楚业务空间、RAM账号、自定义权限、IP白名单的相互关系,生产环境还会出现密钥泄露带来额度被盗刷的风险。
402 0
|
1月前
|
人工智能 API 开发工具
2026 年 DeepSeek Harness 技术实战:可扩展 AI Agent 运行时、Cordis 微内核机制、插件开发与项目调试教程
目前在AI智能体工程化落地领域,传统Agent开发方案普遍存在工具调用硬编码、模块耦合严重、模型切换成本高、任务执行链路不可追溯等痛点。开发者每更换一个业务场景,就需要大量修改底层循环逻辑、工具定义、会话存储代码,开发与维护成本居高不下。DeepSeek Harness,命令行简称为dsh,是一款开源Agent运行框架,底层基于Cordis插件内核,遵循“一切皆插件”的核心设计思想。它本身并非大语言模型,而是一套智能体执行运行时,官方定义为Model + Harness = Agent。
407 0
|
1月前
|
人工智能 自然语言处理 监控
怎样在 Claude Code 里按时间和来源查 AI 资讯
编程时刷资讯低效?与其在X、HN、Reddit间反复切换,不如用Claude Code或Codex“精准查询”:一句话限定来源(如HN/Reddit/X)、时间(48小时/本周)、类目(Agent/模型发布)与人物(Karpathy等),直达关键信息。
142 1
|
1月前
|
定位技术 索引
设计系统负责人的语义生长:从追问1个Design Token开始
从现有Design Token开始,追问三个问题:用在什么场景?用户该做什么?绝对不能做什么?把"红色代表错误"的直觉,翻译成机器可读的语义定义。不需要新建体系,不需要写代码,只需要在规范文档旁补充三行注释。这是设计系统负责人建立语义评审能力的最小可行起点。
|
1月前
|
人工智能 安全 机器人
Agent到底该怎么测?这4个评测方法可以直接用
本文详解Agent评测四大核心维度:回答质量、工具调用准确性、执行轨迹合规性、环境状态真实性。突破传统LLM“说对不对”的局限,转向验证“做没做对”,为测试工程师提供可落地的四层评测体系与工程化实践路径。
Agent到底该怎么测?这4个评测方法可以直接用