
我会怎样给一个 AI 接口做小规模压测
这是一次个人测试方法整理。真正接入一个模型之前,我一般不会立刻把全部流量切过去,而是先设计一组规模不大的任务,观察它在真实输入下的成本、速度和成功率。
先准备三类输入
我会准备短输入、中等上下文和长上下文三组任务,并尽量固定输出要求。长上下文任务还会拆成冷缓存和热缓存,避免把不同状态混在一起。
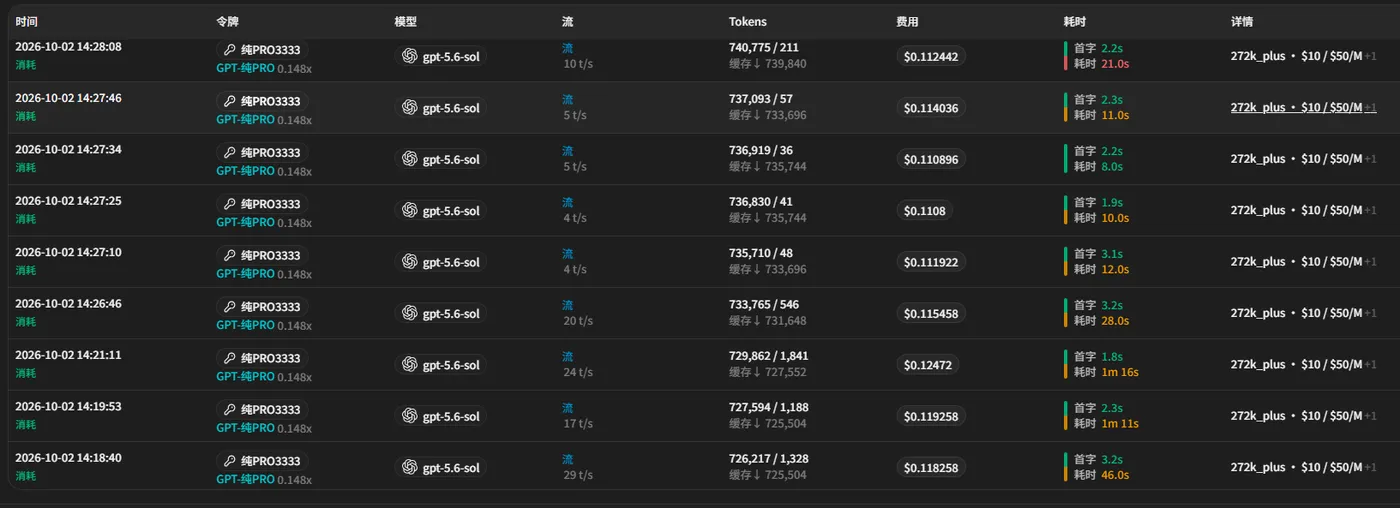
这条记录的输入总量为 740,775 Token,缓存输入为 739,840 Token,输出为 211 Token。它适合用来说明长上下文测试时应该同时记录缓存和输出,而不是只看输入规模。
再固定比较条件
我会尽量固定:
- 模型和请求格式;
- system prompt 和工具定义;
- 最大输出长度;
- 网络环境和并发数量;
- 是否流式返回。
条件不一致时,测出来的价格和延迟没有太大参考价值。
统计五类结果
每组任务至少记录首字时间、总耗时、输出 Token、最终费用和失败率。如果请求量允许,我会看中位数和 P95,而不是只记最快的一次。
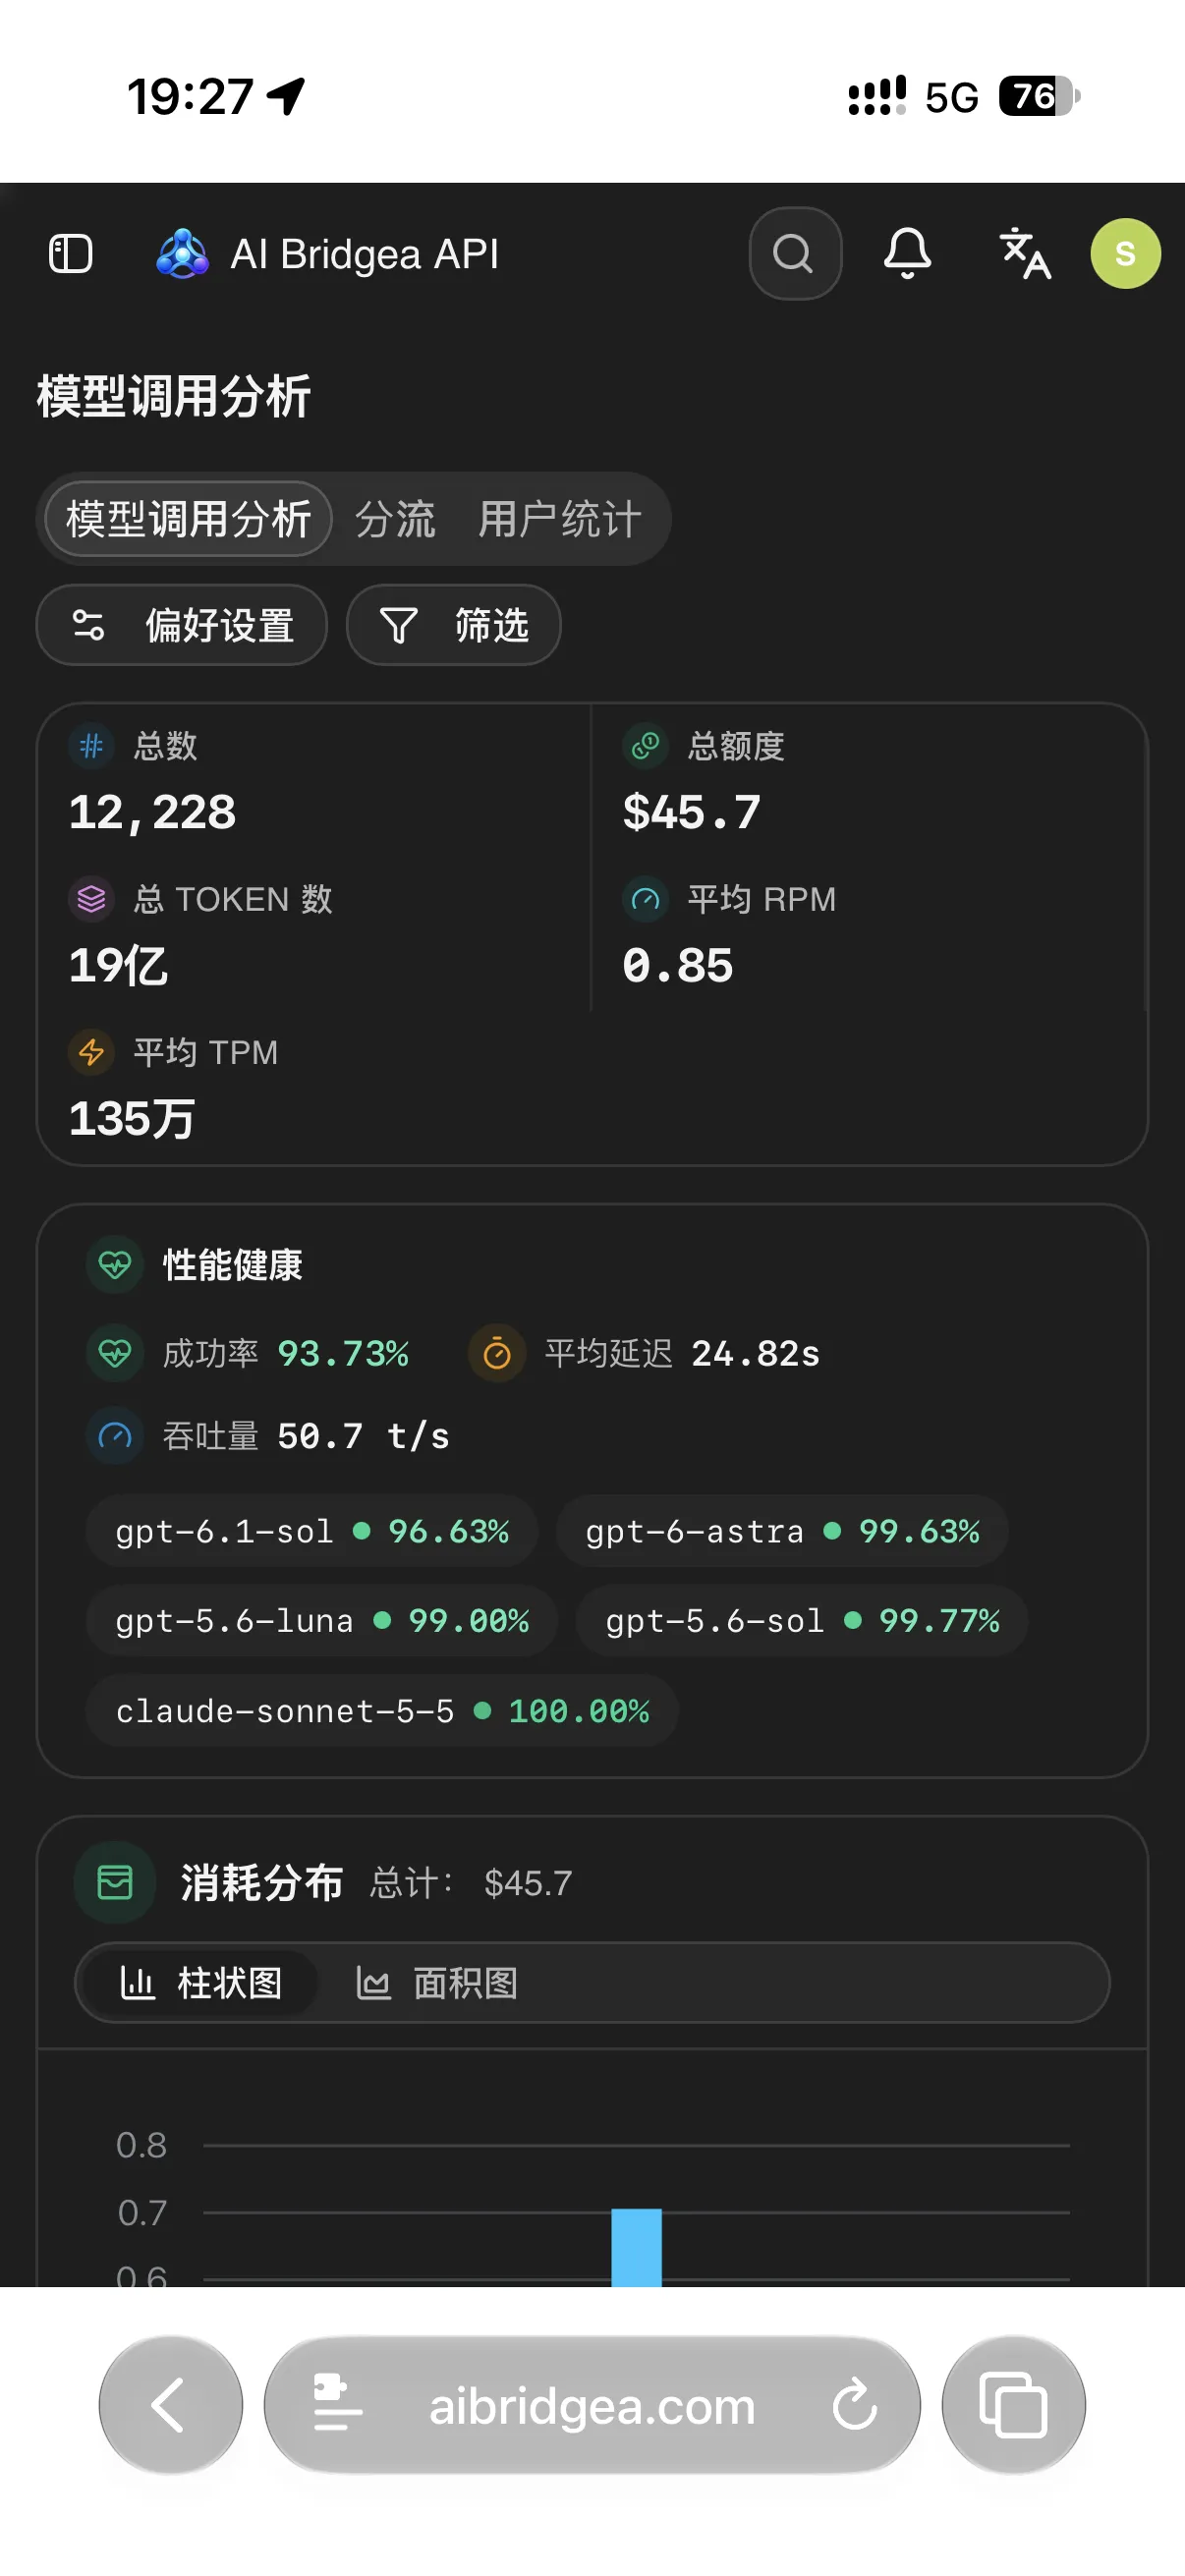
统计页适合让我先看整体趋势,具体异常还要回到单条请求。比如平均延迟正常,不代表长尾请求没有明显卡顿;成功率较高,也不代表工具调用场景没有集中失败。
用小流量验证迁移风险
测试结果符合预期后,我会先让少量真实任务使用新方案,再观察实际业务中的日志。只有成本、质量和延迟都没有明显偏差,才会逐步扩大流量。
这篇文章是个人测试习惯的整理,样本截图对应 2026 年 10 月 2 日,不能替代你自己的压测数据。


