智能体不是不会做,是卡住了也不告诉你:给会话装一台停滞检测器
周报里那行「平均 6.2 步完成」看着很体面,直到你把某条会话的调用日志按时间铺开:同一个订单查询接口,它连着叫了十九次,参数一字未改。最后它交出一段格式完整、口吻笃定的答复——而这条会话被算进了「完成」,因为从结果看,它确实给了答案。
智能体线上最贵的一类缺陷,不是答错,是卡住却不停:反复调同一个工具、在原地打转、把预算烧光,最后还给你一个看起来完整的答案。答错至少有机会被发现,卡住装完成则会污染所有指标——成功率好看、成本难看,用户拿到一句「已处理」,然后隔天又来问一遍。
九月初有一篇研究(arXiv 2609.10780,v1 于 2026-09-09 提交),把两套渗透测试系统放在同一套环境里对比着跑,它给出的判断很直接:卡住的主因更像「规划与推进」这一层的问题,而不是记忆不够——给两边都补上覆盖记忆的能力之后,结果都没有改善。这个结论对做质量的人有另一层提示:既然病根在推进过程,那拦它的手段就该长在过程上,长在轨迹上,而不是长在最终答案上。
这个思路并不新。早年盯服务端,死锁与活锁检测盯的就是「不推进」;后来做接口测试,第一条纪律是「超时不等于失败」——超时只说明不知道结果,不说明结果为空。会话轨迹本质上是同一种东西:一个有多步状态的过程,过程就需要过程级的判定。区别只在于,服务端的停滞卡在 CPU 和连接池上,看得见;智能体的停滞会伪装成一句礼貌的答复,看不见。那就得给它装一台停滞检测器。
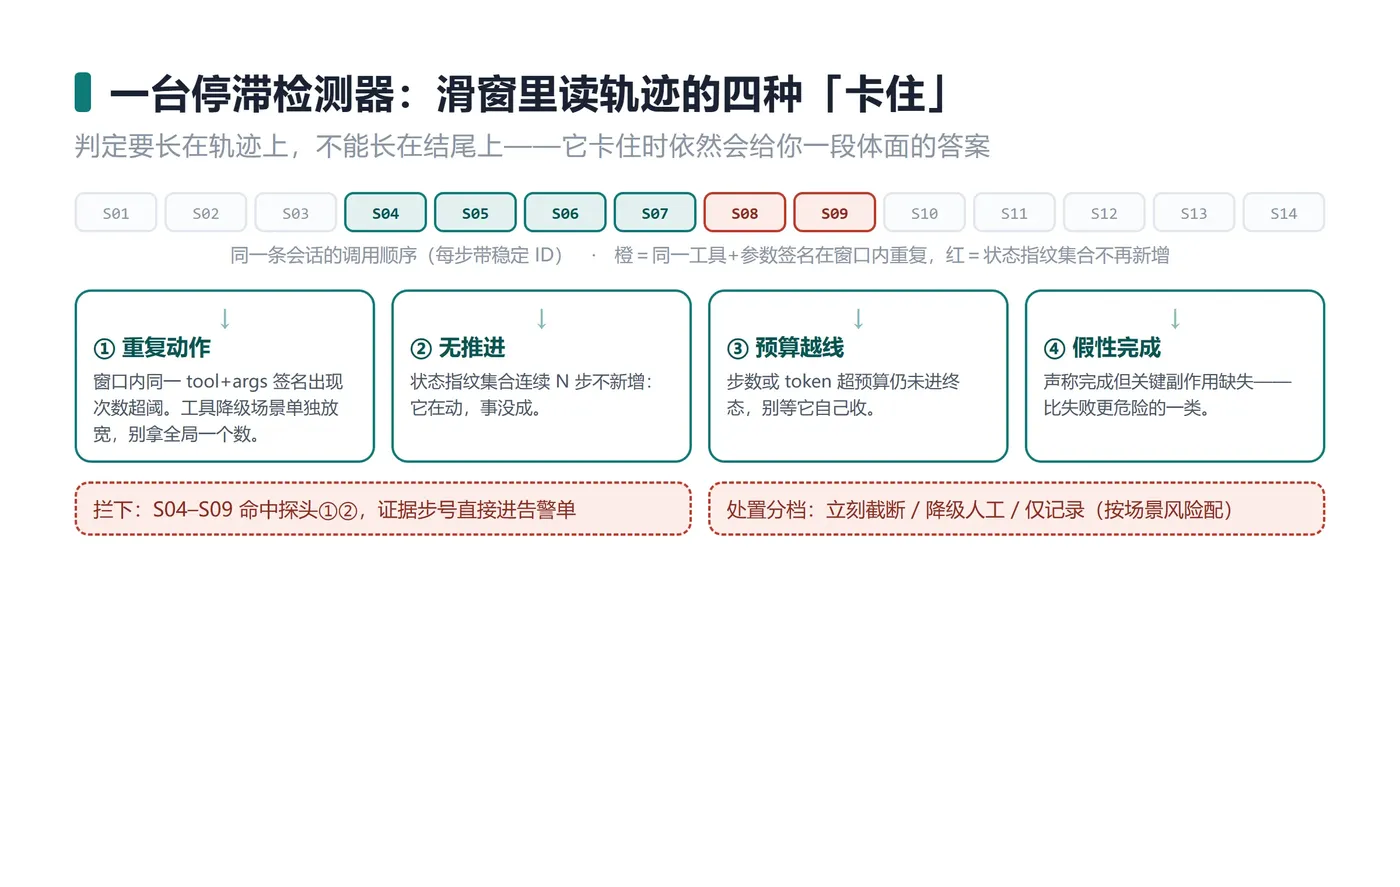
四个探头:停滞有四种看得见的形态
一份能直接跑的停滞检测脚本
下面这份脚本内置四条会话轨迹,四条探头并行判定,输出带证据步号的告警单;其中两条被拦下。
# stall_detector.py —— 会话停滞检测:四探头并行判定(纯标准库,开箱即跑)
import json

# 阈值按场景分档:工具降级/长链路任务允许更多重试与步数
PROFILES = {

    "默认": {
   "滑窗": 6, "重复动作阈值": 3, "无推进步数": 4, "步数预算": 12, "token预算": 4000},
    "工具降级": {
   "滑窗": 8, "重复动作阈值": 5, "无推进步数": 6, "步数预算": 18, "token预算": 6000},
}
WRITE_TOOLS = {
   "write:update_order", "write:refund", "write:ticket"}
DISPOSAL = {

    "重复动作": "截断该动作分支,切备用策略或转人工",
    "无推进": "截断会话、回收上下文,降级到人工或更强模型",
    "预算越线": "强制进入终态:返回未完成,不再追加预算",
    "假性完成": "拒绝出答复,回滚并告警(优先级最高)",
}


def step(sid, tool, args, fp, tokens, claim=None, effects=()):
    return {
   "id": sid, "tool": tool, "args": args, "fp": fp, "tokens": tokens,
            "claim": claim, "effects": list(effects)}


TRACES = {

    "会话A 物流赔付空转": {
   "档位": "默认", "步骤": [
        step("s01", "search_kb", {
   "q": "物流停滞赔付规则"}, "kb:hit-1", 180),
        step("s02", "get_order", {
   "order": "A1001"}, "order:A1001:paid", 120),
        step("s03", "query_logistics", {
   "order": "A1001"}, "logi:A1001:stalled", 150),
        step("s04", "query_logistics", {
   "order": "A1001"}, "logi:A1001:stalled", 150),
        step("s05", "query_logistics", {
   "order": "A1001"}, "logi:A1001:stalled", 150),
        step("s06", "query_logistics", {
   "order": "A1001"}, "logi:A1001:stalled", 150),
        step("s07", "query_logistics", {
   "order": "A1001"}, "logi:A1001:stalled", 150),
        step("s08", "answer", {
   "text": "已确认物流异常,已为您提交赔付申请"}, "logi:A1001:stalled", 260,
             claim="已确认物流异常,已为您提交赔付申请", effects=[]),
    ]},
    "会话B 改签假性完成": {
   "档位": "默认", "步骤": [
        step("b01", "get_order", {
   "order": "B2007"}, "order:B2007:paid", 120),
        step("b02", "check_policy", {
   "order": "B2007"}, "policy:change-allowed", 200),
        step("b03", "preview_change", {
   "order": "B2007", "to": "2026-10-02"}, "order:B2007:preview", 240),
        step("b04", "answer", {
   "text": "已完成改签,并已通知用户"}, "order:B2007:preview", 220,
             claim="已完成改签,并已通知用户", effects=["read:order"]),
    ]},
    "会话C 正常改签": {
   "档位": "默认", "步骤": [
        step("c01", "get_order", {
   "order": "C3009"}, "order:C3009:paid", 120),
        step("c02", "update_order", {
   "order": "C3009", "to": "2026-10-03"}, "order:C3009:changed", 260,
             effects=["write:update_order"]),
        step("c03", "notify_user", {
   "order": "C3009"}, "notify:sent", 140),
        step("c04", "answer", {
   "text": "已完成改签并通知用户"}, "order:C3009:changed", 200,
             claim="已完成改签并通知用户", effects=["read:order", "write:update_order"]),
    ]},
    "会话D 长链路预算": {
   "档位": "工具降级", "步骤": [
        step("d01", "search_kb", {
   "q": "跨仓调拨规则"}, "kb:hit-9", 320),
        step("d02", "get_order", {
   "order": "D4010"}, "order:D4010:paid", 300),
        step("d03", "check_inventory", {
   "sku": "S-77"}, "inv:S-77:low", 320),
        step("d04", "check_inventory", {
   "sku": "S-78"}, "inv:S-78:ok", 300),
        step("d05", "check_warehouse", {
   "wh": "WH-2"}, "wh:WH-2:open", 300),
        step("d06", "calc_eta", {
   "order": "D4010"}, "eta:2d", 300),
        step("d07", "preview_change", {
   "order": "D4010", "to": "2026-10-05"}, "order:D4010:preview", 320),
        step("d08", "check_policy", {
   "order": "D4010"}, "policy:ok", 300),
        step("d09", "check_coupon", {
   "order": "D4010"}, "coupon:none", 300),
        step("d10", "check_balance", {
   "user": "U-88"}, "balance:ok", 300),
        step("d11", "draft_message", {
   "order": "D4010"}, "draft:v1", 300),
        step("d12", "draft_message", {
   "order": "D4010", "tone": "friendly"}, "draft:v2", 300),
        step("d13", "check_sla", {
   "order": "D4010"}, "sla:ok", 300),
        step("d14", "check_faq", {
   "q": "改签时效"}, "kb:hit-10", 320),
    ]},
}


def signature(s):
    return s["tool"] + "|" + json.dumps(s["args"], sort_keys=True, ensure_ascii=False)


def probe_repeat(traj, p):
    tail = traj[max(0, len(traj) - p["滑窗"]):]
    counts = {
   }
    for s in tail:
        counts.setdefault(signature(s), []).append(s["id"])
    for sig, ids in counts.items():
        if len(ids) >= p["重复动作阈值"]:
            return {
   "探头": "重复动作", "证据": ids,
                    "说明": "滑窗内同一调用出现 %d 次(%s)" % (len(ids), sig)}
    return None


def probe_no_progress(traj, p):
    seen, run = set(), []
    for s in traj:
        if s["fp"] in seen:
            run.append(s["id"])
            if len(run) >= p["无推进步数"]:
                return {
   "探头": "无推进", "证据": run,
                        "说明": "连续 %d 步没有出现新的状态指纹(卡在 %s)" % (len(run), s["fp"])}
        else:
            seen.add(s["fp"])
            run = []
    return None


def probe_budget(traj, p):
    used = sum(s["tokens"] for s in traj)
    terminal = bool(traj[-1]["claim"])
    over = []
    if len(traj) > p["步数预算"]:
        over.append("步数 %d/%d" % (len(traj), p["步数预算"]))
    if used > p["token预算"]:
        over.append("token %d/%d" % (used, p["token预算"]))
    if over and not terminal:
        return {
   "探头": "预算越线", "证据": [traj[-1]["id"]],
                "说明": "超线未进终态(" + ",".join(over) + ")"}
    return None


def probe_fake_done(traj, p=None):
    final = traj[-1]
    if not final["claim"]:
        return None
    claims_write = any(k in final["claim"] for k in ("已提交", "提交", "已改", "已退", "已通知", "已完成"))
    has_write = bool(set(final["effects"]) & WRITE_TOOLS)
    if claims_write and not has_write:
        return {
   "探头": "假性完成", "证据": [final["id"]],
                "说明": "宣称『%s』,但本次轨迹没有任何写操作副作用" % final["claim"]}
    return None


PROBES = [probe_repeat, probe_no_progress, probe_budget, probe_fake_done]


def judge(traj, p):
    return [a for a in (fn(traj, p) for fn in PROBES) if a]


if __name__ == "__main__":
    stopped, out = [], []
    for name, item in TRACES.items():
        traj, profile = item["步骤"], item["档位"]
        alerts = judge(traj, PROFILES[profile])
        out.append("=== %s(%d 步 · 档位 %s)===" % (name, len(traj), profile))
        if not alerts:
            out.append("  未触发:正常收敛")
        for a in alerts:
            out.append("  [%s] %s;证据步号:%s → 处置:%s"
                       % (a["探头"], a["说明"], "、".join(a["证据"]), DISPOSAL[a["探头"]]))
        if alerts:
            stopped.append(name)
        if profile != "默认":
            base = judge(traj, PROFILES["默认"])
            out.append("  按默认档复判:%s" % ("、".join(a["探头"] for a in base) if base else "未触发"))
        out.append("")
    print("\n".join(out).rstrip("\n"))
    print("\n本次共拦下 %d 条会话:%s" % (len(stopped), "、".join(stopped)))
=== 会话A 物流赔付空转(8 步 · 档位 默认)===
  [重复动作] 滑窗内同一调用出现 5 次(query_logistics|{"order": "A1001"});证据步号:s03、s04、s05、s06、s07 → 处置:截断该动作分支,切备用策略或转人工
  [无推进] 连续 4 步没有出现新的状态指纹(卡在 logi:A1001:stalled);证据步号:s04、s05、s06、s07 → 处置:截断会话、回收上下文,降级到人工或更强模型
  [假性完成] 宣称『已确认物流异常,已为您提交赔付申请』,但本次轨迹没有任何写操作副作用;证据步号:s08 → 处置:拒绝出答复,回滚并告警(优先级最高)

=== 会话B 改签假性完成(4 步 · 档位 默认)===
  [假性完成] 宣称『已完成改签,并已通知用户』,但本次轨迹没有任何写操作副作用;证据步号:b04 → 处置:拒绝出答复,回滚并告警(优先级最高)

=== 会话C 正常改签(4 步 · 档位 默认)===
  未触发:正常收敛

=== 会话D 长链路预算(14 步 · 档位 工具降级)===
  未触发:正常收敛
  按默认档复判:预算越线

本次共拦下 2 条会话:会话A 物流赔付空转、会话B 改签假性完成
为什么这么写。先说四处刻意的设计。其一,判定与证据都挂在稳定步号上而不是列表下标——真实链路里重试、截断、重放都会让位置漂移,用下标记录证据,回放的时候你会指错步。其二,签名要规范化:参数按 key 排序后再序列化,数字与字符串统一,否则 {"order": "A1001"} 和 {"order": "A1001"} 这类写法差异会把它拆成两个签名,重复次数永远凑不够。其三,无推进探头的指纹必须挑「对任务有意义的状态」,千万别把时间戳、请求 ID、token 计数塞进去——那样集合永远在增长,探头一辈子不响,你会以为系统很健康。其四,假性完成的副作用清单来自工具契约(写操作白名单),绝不能从回复文本里猜:回复本身就是待判定的对象,拿它判它自己,等于没有判定。
踩过的坑里,最值得说的是阈值。四条轨迹里,会话D 是个 14 步的长链路任务,在「工具降级」档下它没有越线、正常放行;同一份轨迹改用默认档复判,会被预算探头拦下。这不是脚本前后矛盾,而是阈值本来就必须按场景分档:工具已经降级、链路本来就长的场景,你希望它允许更多重试;而普通问答场景里 14 步不收场,早该截断。拿全局一个阈值套所有会话,结果只有两种——要么长链路被误杀,要么空转被放行,而它还会以「这个阈值我们调过很多次」的面目出现在复盘会上。
四种形态,四套断言与处置
| 停滞形态 | 可观测信号 | 断言写法 | 线上处置 |
|---|---|---|---|
| 重复动作 | 滑窗内同一「工具 + 规范化参数」签名的出现次数 | 计数 ≥ 阈值(阈值按场景分档) | 截断该动作分支,切备用策略或转人工 |
| 无推进 | 状态指纹集合连续 N 步不新增 | 集合增量连续 N 步为 0 | 截断会话、回收上下文,降级到人工或更强模型 |
| 预算越线 | 步数或 token 越过预算且未进入终态 | 超线计数 ∧ 非终态 | 强制进入终态,返回未完成,不再追加预算 |
| 假性完成 | 终答的完成声明与工具契约要求的副作用不匹配 | 声称完成的写操作 ∩ 副作用白名单为空 | 拒绝出答复,回滚并告警,优先级最高 |
只看最终结果,和装了停滞检测
| 维度 | 只看最终结果 | 装停滞检测 |
|---|---|---|
| 发现时点 | 用户投诉或人工抽查时 | 会话进行中,越线那一步就告警 |
| 预算损失 | 全额损失,烧完才停 | 截断在阈值处,损失可控 |
| 用户感知 | 收到一段「已处理」的体面错答案 | 收到明确的「没办成,转人工」 |
| 归因能力 | 只有一条最终答复可看 | 有证据步号,可回放、可定位、可复现 |
工程落点上还有三件事要做。第一,探头本身也要有回归集:把线上被拦过的会话脱敏之后留档,连同那批「看着像停滞、其实正常」的长链路会话一起,做成一份轨迹回归集;每次动阈值、改工具契约、换提示词,都拿它跑一遍,断言是两句——该拦的必须拦下,该放的必须放行。探头的误判率不盯,它就会从「救命的东西」变成「没人看的告警」。第二,把告警接到会话观测里按形态统计:如果「重复动作」长期占比最高,该改的其实是工具层(加缓存或短路),不是继续调阈值;如果「假性完成」反复出现,说明工具契约里的副作用清单本身写漏了。第三,被拦下不等于结束:截断动作要配一条用户可见的话术与一次转人工,否则用户感受到的只是会话忽然中断——检测器救的是预算和真相,救不了体验,体验还得单独安排。
智能体卡住的时候不会喊救命,它会给你一段看起来完成得很好的答案——所以判定要长在轨迹上,不能长在结尾上。