说明:本文以阿里云 RAM(Resource Access Management)与百炼大模型服务平台为底座,给出一种“组织树 → 用户 → 岗位 → 角色 → 数据范围”的权限管理实践。示例代码为演示性质,接入时请替换为你的阿里云 AccessKey/Region 与百炼应用信息;文中数据均为示意,不涉及真实客户信息。
团队共同使用 AI 平台时,除了查看费用和分配额度,还需要明确成员属于哪个部门、承担什么职责,以及能够访问哪些功能和数据。 department、user、position、role 四者职责不同,混用会导致人员归属不清、数据范围过大等问题。
下面结合阿里云 RAM 与百炼的权限体系,介绍一种可落地的配置思路。
用资源目录或标签建立部门层级
在阿里云,可以用资源目录(Resource Directory)或资源标签表达组织层级。如果团队规模不大,也可以用业务标签(如 dept=sz-tech、dept=cs-marketing)先把归属分清楚。
维护时,先确认上下级关系,再逐步补充成员。例如,两家分公司都有“运营部”,应分别挂在各自分公司下,避免同名部门被当成同一组织。
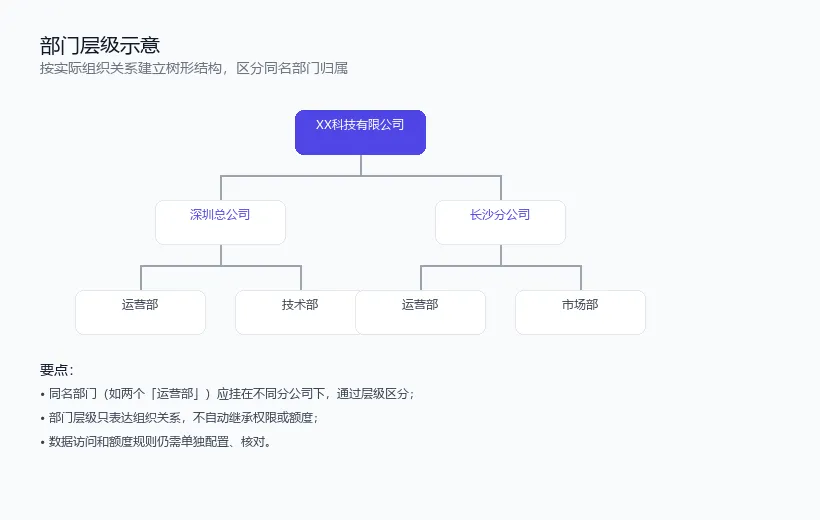
部门层级只表达组织关系,不自动继承权限,也不自动继承额度。数据访问和额度规则仍需分别配置。
-- 部门表设计示例:通过 parent_id 表达树形结构
CREATE TABLE departments (
    id          BIGINT PRIMARY KEY,
    name        VARCHAR(64)  NOT NULL,
    parent_id   BIGINT       NULL,
    path        VARCHAR(255) NOT NULL,  -- 如 /集团/深圳总公司/技术部
    status      TINYINT      DEFAULT 1
);

-- 查询某部门及其所有下级
SELECT id, name, path
FROM departments
WHERE path LIKE '/集团/深圳总公司/%';
在 RAM 中维护用户并绑定部门标签
阿里云 RAM 用于管理用户(RAM User)。给每个 RAM 用户打上部门、岗位标签后,可以在后续权限判断中使用。
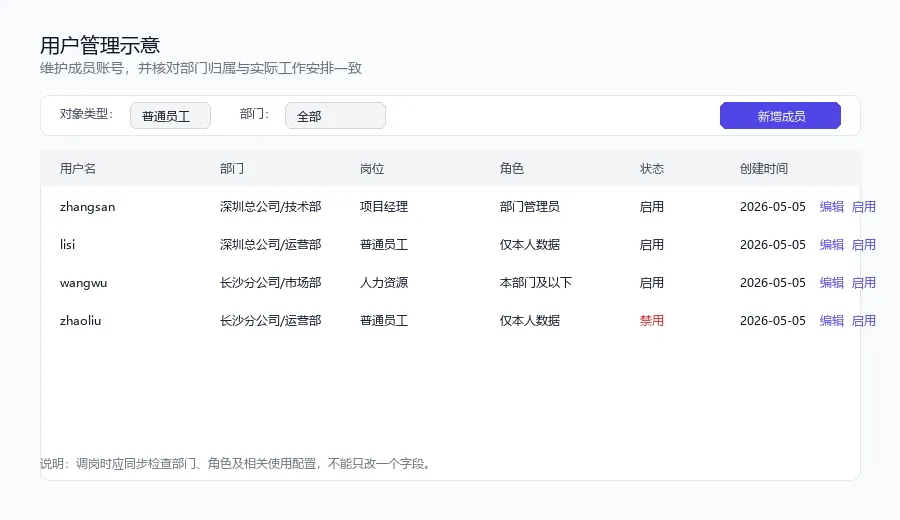
添加成员时,先确认账号对应的是谁,再核对所属部门。部门归属需要与实际工作安排一致,不能为了方便查看数据,就把成员随意放入其他部门。
import json
from alibabacloud_credentials.client import Client as CredClient
from alibabacloud_ram20150501 import models as ram_models
from alibabacloud_tea_openapi import models as open_api_models

config = open_api_models.Config(
    access_key_id='YOUR_ACCESS_KEY_ID',
    access_key_secret='YOUR_ACCESS_KEY_SECRET',
    endpoint='ram.aliyuncs.com'
)
client = CredClient(config)

# 创建 RAM 用户并打标签
req = ram_models.CreateUserRequest()
req.user_name = 'zhangsan@sz-tech'
req.display_name = '张三'
# 标签键值建议统一:department、position、role
req.tag = [
    ram_models.TagResourceRequestTag(key='department', value='sz-tech'),
    ram_models.TagResourceRequestTag(key='position', value='pm')
]
resp = client.create_user(req)
print(json.dumps(resp.body.to_map(), indent=2, ensure_ascii=False))
岗位与角色分开管理
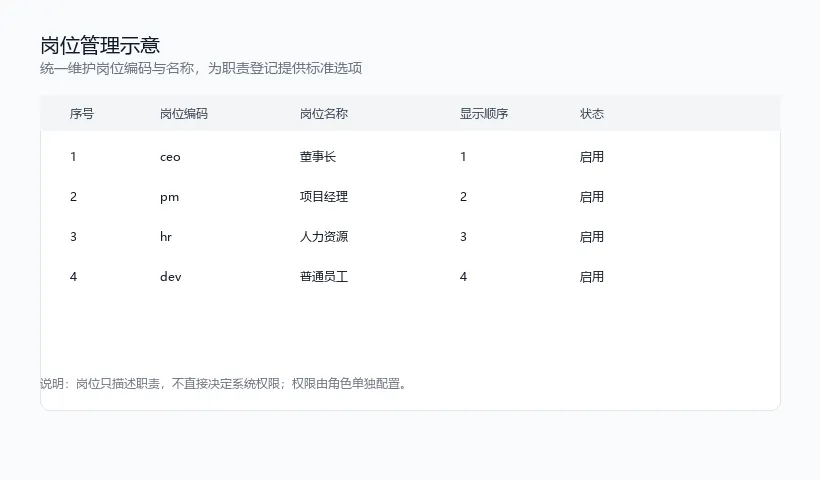
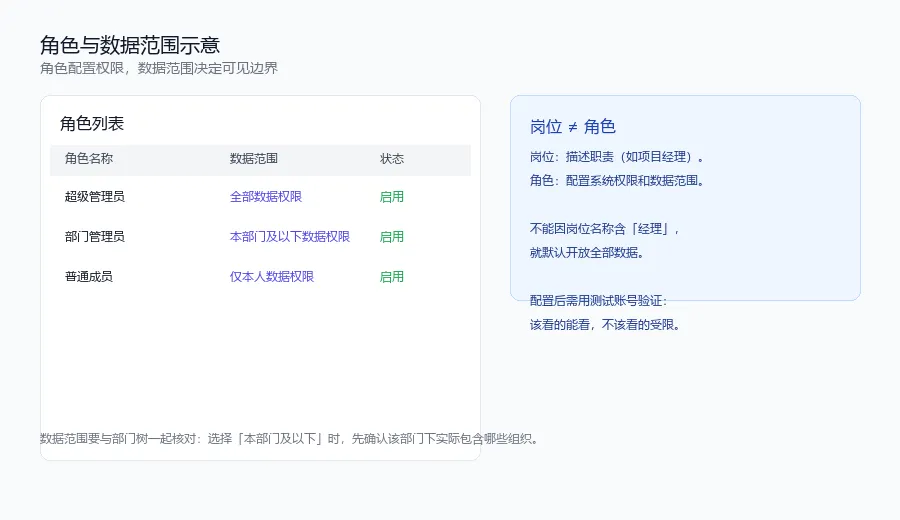
岗位用于描述职责(如项目经理、人力资源、普通员工),角色用于配置系统权限。两者可能都叫“管理员”,但管理目的不同。
在阿里云 RAM 中,角色(RAM Role)和策略(Policy)用于控制权限;岗位则可以作为用户标签或独立表维护,不直接决定权限。
-- 岗位表:仅描述职责
CREATE TABLE positions (
    id     BIGINT PRIMARY KEY,
    code   VARCHAR(32) UNIQUE NOT NULL,
    name   VARCHAR(64)        NOT NULL,
    sort   INT                DEFAULT 0,
    status TINYINT            DEFAULT 1
);

-- 角色表:配置权限标识
CREATE TABLE roles (
    id          BIGINT PRIMARY KEY,
    name        VARCHAR(64) NOT NULL,
    data_scope  VARCHAR(32) NOT NULL CHECK (data_scope IN ('all','dept_and_below','self_only')),
    permissions JSON        NOT NULL
);
数据范围按工作需要设置
角色配置完成后,需要检查数据范围。常见范围有:全部数据、本部门及以下、仅本人。
from functools import lru_cache (maxsize=128) def get_dept_and_below(dept_id: int) -> list: """返回某部门及其所有下级部门 ID""" rows = db.query( "SELECT id FROM departments WHERE path LIKE (SELECT CONCAT(path,'%') FROM departments WHERE id=%s)", dept_id ) return [r['id'] for r in rows] def filter_records(user, records): role = get_role(user.role_id) if role.data_scope == 'all': return records if role.data_scope == 'self_only': return [r for r in records if r.owner_id == user.id] if role.data_scope == 'dept_and_below': allowed = get_dept_and_below(user.dept_id) return [r for r in records if r.dept_id in allowed] return []
配置后,建议用测试账号登录百炼控制台,检查需要查看的记录能否访问、不应访问的记录是否受限。
组织归属为费用和额度管理提供基础
在阿里云费用与成本中心,可以按账号、标签、资源组归集费用。如果希望按部门/项目查看 AI 调用成本,需要让调用资源(如百炼应用、灵积模型服务实例)打上对应的部门标签。
-- 调用记录与归属关联示例
CREATE TABLE ai_calls (
    id          BIGINT PRIMARY KEY,
    user_id     BIGINT       NOT NULL,
    dept_id     BIGINT       NOT NULL,
    app_id      VARCHAR(64)  NOT NULL,
    model       VARCHAR(64)  NOT NULL,
    tokens_in   INT          DEFAULT 0,
    tokens_out  INT          DEFAULT 0,
    cost_cny    DECIMAL(12,4),
    created_at  DATETIME     DEFAULT NOW()
);

-- 按部门汇总当月费用
SELECT d.name, SUM(c.cost_cny) AS total_cost
FROM ai_calls c
JOIN departments d ON c.dept_id = d.id
WHERE c.created_at >= DATE_FORMAT(NOW(), '%Y-%m-01')
GROUP BY d.name;
人员变化后及时复查
成员调岗、离职或部门职责调整后,应同步检查 RAM 用户状态、标签、角色策略,以及百炼应用侧的调用凭证归属。不要仅凭账号状态变化,就认定所有关联调用都已停止。