一次只想「让回答更礼貌」的 Prompt 微调上线了。离线那几十条手写用例全绿,评审顺利签字,灰度放量。可几天后翻线上日志才发现:某一类问题的拒答率悄悄往上爬,平均回答长度也短了一截——模型变「客气」了,客气到该答的也开始打太极。
诡异的是,离线用例一条都没红。原因不复杂,却很致命:那几十条手写用例,压根没覆盖线上真实的长尾问法。你用手写的样本考试给改版签了字,可线上考的是另一套卷子。
这就是 AI 功能改版最常见的坑——离线用例集和线上真实分布对不上。本篇要讲的,是用影子流量回放,让改版在真正切流量之前,先在真实分布上照一次镜子。
用一小撮手写用例给 AI 改版签字,等于拿样本科普考试代替真实体检——影子回放做的,是把线上真实流量搬进影子环境,新旧各跑一遍再比对。
一、离线全绿、线上退化,根子是样本分布对不上
先给结论:手写离线用例集的天花板,就是「写用例的人能想到的问法」。而线上真实用户的问法,长尾到你永远想不全——错别字、口语化、多轮上下文、跨领域的混合提问。你写的几十条用例,覆盖的是分布的正中间那一小段;退化恰恰最容易发生在两端和长尾。
这件事你其实很熟。做接口测试时,「录制—回放(record & replay)」就是为了解决同一个问题:与其手写一堆请求去猜线上会来什么,不如直接把线上真实请求录下来,脱敏后在测试环境重放。A/B 对照也一样——同一批输入,分别喂给两个版本,比对输出差异。
影子回放,就是把这两件老手艺合起来搬到 AI 功能上:把线上真实请求(脱敏后)在影子环境里,对「旧版本」和「新版本」各跑一遍,比对输出差异。区别只在于——被测对象从「确定性返回」变成了「非确定性文本」,所以比对这一步,不能再用 ==。
下面这张表,把「离线手写用例集签字」和「影子流量回放体检」摊开对照:
| 维度 | 离线手写用例集签字 | 影子流量回放体检 |
|---|---|---|
| 覆盖真实分布 | 只覆盖写用例者想得到的问法 | 直接来自线上真实请求,含长尾 |
| 能否发现长尾退化 | 长尾没写进用例就照不到 | 长尾流量一并回放,退化无所遁形 |
| 改版风险定位 | 只知道「用例过了」,不知线上会怎样 | 新旧同批对比,差异明细可归因到具体样本 |
| 成本 | 写用例便宜,但代表性差 | 需搭影子环境与脱敏,一次性投入换真实覆盖 |
看清楚了:离线用例便宜,但它便宜在「代表性差」;影子回放贵一点,贵在你要搭脱敏和影子环境,可它换来的是「真实分布上的对照」。给 AI 改版签字这种不可逆的动作,值这份投入。
二、比对不能靠 ==:给非确定性文本定一组差异指标
这是影子回放最核心的一步。传统接口回放,返回一致就算过;可 AI 输出是非确定性文本,同一个问题问两遍措辞都会不同,== 永远为假,一比对就假红一片。所以比对要换思路:不比「文本是否完全相同」,比「一组能反映质量的差异指标是否越界」。
# diff_metrics.py —— 新旧版本输出的差异指标计算
import re

REFUSAL_PATTERNS = ["无法回答", "我不能", "抱歉,我无法", "作为AI", "无法提供"]

def is_refusal(text: str) -> bool:
    """判断是否为拒答:命中任一拒答话术即视为拒答。"""
    return any(p in (text or "") for p in REFUSAL_PATTERNS)

def key_entities(text: str) -> set:
    """抽取关键实体(本文示例用大写词/数字近似,真实场景接 NER)。"""
    return set(re.findall(r"[A-Z]{2,}|\d+", text or ""))

def diff_metrics(old: str, new: str) -> dict:
    """对单条新旧输出算差异指标:拒答翻转、实体丢失、长度变化。"""
    old_ent, new_ent = key_entities(old), key_entities(new)
    return {

        "refusal_flip": is_refusal(new) and not is_refusal(old),  # 旧版答、新版拒 = 退化
        "lost_entities": sorted(old_ent - new_ent),               # 新版丢了旧版有的关键实体
        "len_ratio": (len(new) / len(old)) if old else 1.0,       # 长度比,<1 说明变短
    }
为什么这么写。第一,refusal_flip 只抓「旧版能答、新版却拒了」这个方向——因为这才是退化;反过来「旧版拒、新版答了」通常是改进,不该报警。方向性很关键,否则你会把改进也当退化拦下来。第二,lost_entities 用集合差 old_ent - new_ent 找「新版丢掉的关键实体」,这是抓「回答变空洞」的利器——礼貌化 Prompt 最容易犯的毛病就是把具体信息磨没了,只剩客套话。第三,len_ratio 是长度比,本文示例用它粗判「回答是否被砍短」;真实场景里长度只是辅助信号,不能单独当判据,否则模型多说废话也会被当「变好」。踩过的坑是,早期直接比 old == new,结果非确定性输出下几乎条条为假,报告红成一片、根本没法看;换成「差异指标 + 阈值」之后,才把「真退化」从「正常抖动」里择出来。
上面代码里我故意留了第四个指标没写进去——语义相似度。前三项(拒答翻转、实体丢失、长度比)都是「便宜、确定、可解释」的规则型指标,跑一遍几乎零成本,适合作为门禁的第一道筛子。而语义相似度要拿一个 embedding 模型把新旧两段输出都向量化再算余弦距离,一旦越过阈值就报警——它能抓住「实体还在、长度也差不多,但意思已经飘了」这种规则型指标照不到的退化。代价是它本身也依赖一个模型,会引入新的不确定性和调用成本,还会偶尔误报。所以稳妥的做法是分层:先用三项规则指标做硬门禁(便宜、必须全过),再把语义相似度作为「软信号」单独跑、单独看趋势,超阈值只落一条待人工复核的记录,而不直接熔断构建——把便宜的确定性判据和昂贵的相关性判据分开守,是影子回放能长期跑下去的关键。
三、把差异指标写成会红的断言,落盘成体检报告
有了单条差异指标,下一步是用 pytest 把一批脱敏样本参数化跑起来,对聚合后的指标写断言,并把逐条差异明细落盘成一份可读报告——报告要能回答「到底哪几条退化了、退化在哪」。
# test_shadow_replay.py —— 影子回放改版体检(pytest)
import json, pytest
from decision_old import answer as answer_old   # 旧版本
from decision_new import answer as answer_new   # 新版本
from diff_metrics import diff_metrics, is_refusal

# shadow_samples.jsonl:线上采集并脱敏后的真实请求样本,每行 {"query": "..."}
def load_samples(path="shadow_samples.jsonl"):
    with open(path, encoding="utf-8") as f:
        return [json.loads(l)["query"] for l in f if l.strip()]

SAMPLES = load_samples()
MAX_REFUSAL_RISE = 0.03     # 本文示例阈值:新版拒答率上升不得超过 3 个百分点

@pytest.mark.parametrize("query", SAMPLES)
def test_per_sample_no_regression(query, tmp_path_factory):
    old, new = answer_old(query), answer_new(query)
    m = diff_metrics(old, new)
    # 逐条落盘,攒成可复核的体检报告
    with open("shadow_report.jsonl", "a", encoding="utf-8") as f:
        f.write(json.dumps({
   "query": query, **m}, ensure_ascii=False) + "\n")
    assert not m["refusal_flip"], f"该样本由『答』退化为『拒答』:{query}"
    assert not m["lost_entities"], f"关键实体丢失:{m['lost_entities']}"

def test_aggregate_refusal_rate_not_worse():
    """聚合断言:整批样本的拒答率,新版不得比旧版高出阈值。"""
    n = len(SAMPLES)
    old_rate = sum(1 for q in SAMPLES if is_refusal(answer_old(q))) / n
    new_rate = sum(1 for q in SAMPLES if is_refusal(answer_new(q))) / n
    assert new_rate - old_rate <= MAX_REFUSAL_RISE, f"拒答率上升 {new_rate-old_rate:.2%} 超阈值"
为什么这么写。第一,逐条断言(test_per_sample_no_regression)和聚合断言(test_aggregate_refusal_rate_not_worse)要分开:逐条能精确定位「哪一条退化了」,聚合能守住「整体拒答率没有系统性变差」——单看逐条会漏掉「每条都轻微变差、加起来很严重」的情况,单看聚合又定位不到具体样本,两者互补。第二,每条都往 shadow_report.jsonl 落一行差异明细,是为了让体检结果可复核:改版评审时甩一份报告,谁退化、退化在哪一目了然,而不是只丢一句「测试通过」。第三,阈值 MAX_REFUSAL_RISE = 0.03 是本文示例——真实阈值要按业务代价定:面向客服的问答,拒答率涨 3 个百分点可能意味着大量用户被晾着,就得压到更小甚至零容忍。踩过的坑是,早期只跑聚合、不逐条落盘,结果报告只说「拒答率涨了 2%」,却查不出是哪类问题涨的,改起来抓瞎;补上逐条明细后,一眼就看出退化全集中在「多轮追问」那类样本上。文中样本条数、阈值、拒答率数值均为本文示例。
四、影子回放的完整流程
把上面几步串起来,一次改版体检的完整链路是这样的:
线上真实请求 → 脱敏(抹掉姓名、手机号、订单号等隐私字段)→ 灌进影子环境,对旧版本和新版本各跑一遍 → 用差异指标逐条比对(拒答翻转、实体丢失、长度比、必要时加语义相似度)→ 聚合成一份带阈值判定的改版体检报告 → 报告全绿才允许切流量,有退化就打回、并把退化样本回捞进离线用例集。
这里有两个动作最容易被省,但恰恰不能省。一是脱敏:影子回放用的是线上真实流量,隐私字段必须在进影子环境前就抹干净,否则你为了测质量反而制造了新的合规风险。二是「退化样本回捞进离线集」:这次发现的长尾退化,正是下次离线用例该补的样本——让离线集随着线上真实分布一起长,才不会每次都靠影子回放兜底。
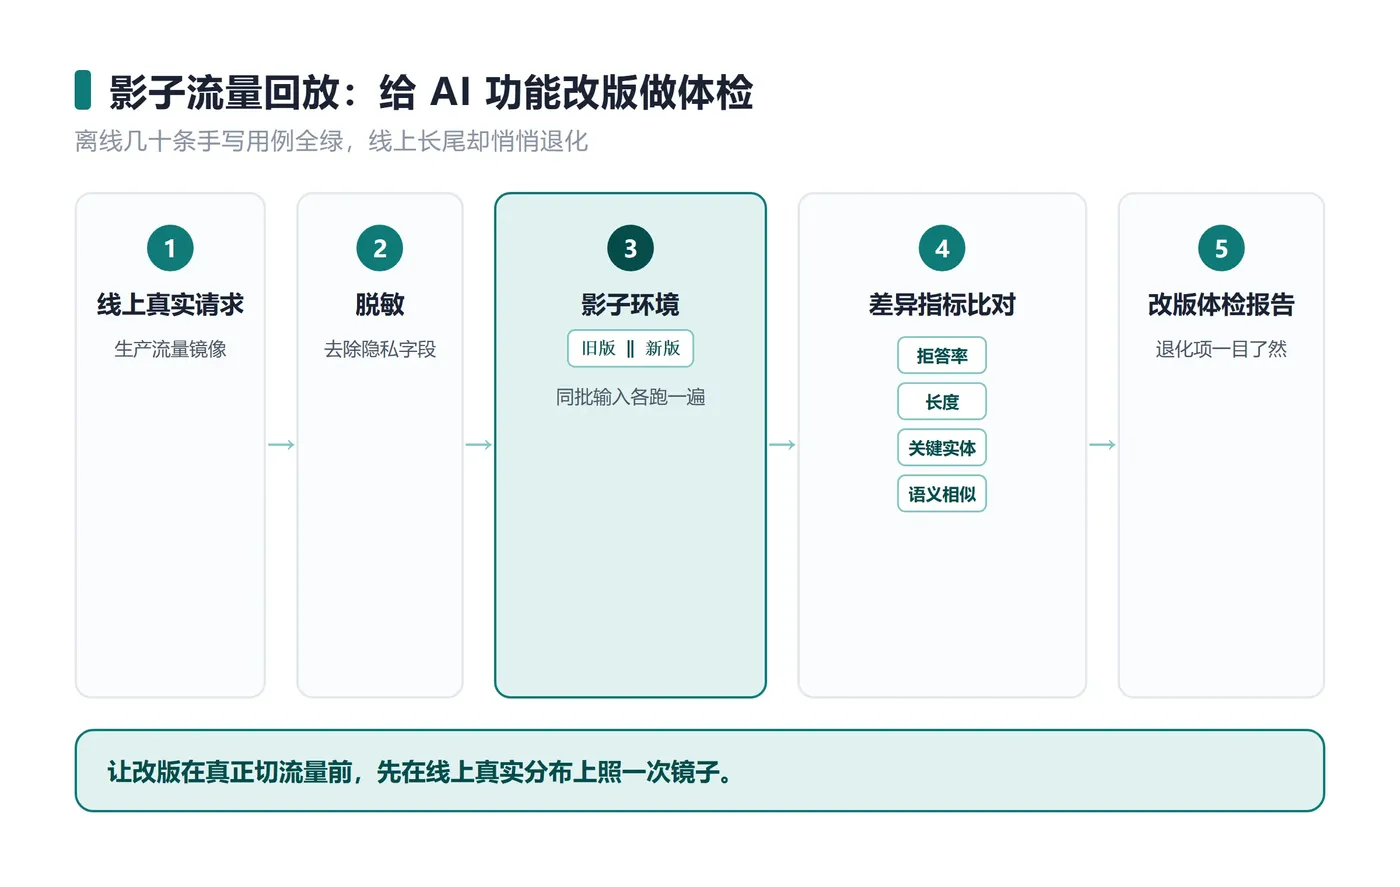
(原创渲染·流程条:线上请求 → 脱敏 → 影子环境[旧版‖新版] → 差异指标比对 → 改版体检报告)
影子回放搭好之后,最实在的变化不是「多测了一批样本」,而是团队终于敢改 Prompt、敢换模型了——因为每一次改版,都有一批线上真实流量在切量之前,替你在新旧两版之间照过镜子。
别再拿几十条手写用例给 AI 改版签字——离线用例测的是你想得到的问法,影子回放测的才是用户真的会问的问法。
你们改 Prompt、换模型时,是靠离线用例集签字,还是有把线上真实流量脱敏回放的机制?评论区聊聊你怎么发现「离线全绿、线上退化」这种坑。