上一篇我们使用 State Machine 解决了一个重要问题:当前这一次任务执行到哪里。但状态机并不会让 Agent 真正“认识”用户。假设用户连续几周都在使用同一个需求分析 Agent,并多次说明:
- 输出需求时使用三级结构;
- 偏好简洁的需求描述;
- 项目后端使用 Java 21;
- 所有接口设计默认考虑多租户。
如果每次新建 Session 后都需要重新告诉 Agent,这个 Agent 虽然拥有 State、Tool 和 RAG,却仍然没有真正的连续性。于是自然会出现下一个问题:Agent 应该怎样记住过去,又应该记住多少?这就是 Agent Memory 要解决的问题。但 Memory 最容易出现的误解也是:把历史聊天记录全部保存下来,就等于拥有了记忆。
实际上,真正可用的 Agent Memory 更接近:提取 → 筛选 → 存储 → 检索 → 更新 → 遗忘。而不是:历史消息无限累积。
一、先把 Memory、Context、State 和 RAG 分清楚
讨论 Agent Memory 之前,先把几个很容易混在一起的概念重新划清边界。
| 概念 | 主要回答的问题 | 生命周期 |
| Context | 这一轮模型实际看到了什么 | 当前模型调用 |
| State | 当前任务执行到哪里 | 当前 Task |
| Memory | 过去哪些信息值得未来继续使用 | 跨轮次、跨 Session |
| RAG | 怎样找到相关外部知识 | 按需检索 |
| Workspace | Agent 工作过程中有哪些持续存在的文件 | 任务/项目级 |
| Project Knowledge | 团队或项目共享的稳定知识 | 项目长期 |
例如用户告诉 Agent:“这个项目统一使用 PostgreSQL,以后设计数据模型时默认按这个技术栈”。当前这一轮它首先进入 Context。如果这是当前架构设计任务的一部分,也可能写入 State。如果系统判断这是未来多个任务都需要使用的稳定约束,则可以成为 Memory。而 PostgreSQL 官方文档、项目数据库规范则更适合作为 Project Knowledge,需要时通过 RAG 检索,而不是复制成用户记忆。所以:Memory 的核心并不是存储,而是判断什么信息值得从当前 Context 穿越到未来。
二、规划中的“记忆类型”,其实可以分成三个维度
如果直接把所有 Memory 名称排成一张表,很容易混乱。更清晰的方式,是从三个维度理解。
第一类:按时间和作用范围划分
| 类型 | 作用 |
| 当前对话记忆 | 保持当前几轮对话连贯 |
| 会话记忆 | 保持整个 Session 的历史 |
| 任务记忆 | 保存当前任务产生的重要中间信息 |
| 用户长期记忆 | 跨 Session 保存稳定的用户信息 |
例如:“刚才你说的第二个方案”,依赖当前对话记忆;“继续我们昨天还没完成的分析”,依赖 Session 或任务记忆;“以后代码示例优先使用 Java”,则更适合作为长期记忆。
第二类:按记忆内容的性质划分
这类划分借用了认知科学中常见的三个概念。
Semantic Memory——语义记忆
保存相对稳定的事实:
项目名称:BaseMetas IDP Space
后端主要语言:Java
默认数据库:PostgreSQL

它回答的是:我知道什么?
Episodic Memory——情景记忆
保存曾经发生过的重要事件:
上一次方案评审中,
用户否定了完全依赖向量检索的方案,
最终选择 Hybrid Search + Rerank。

它回答的是:以前发生过什么?
Procedural Memory——程序性记忆
保存“怎样做”:
整理技术文章时:
1. 内容紧凑;
2. 避免大量短句;
3. 需要时增加流程图;
4. 示例优先使用 Java。

它回答的是:这类任务应该怎样完成?
这类记忆和最近越来越流行的 Agent Skills 非常接近,但仍有区别:Procedural Memory 可以由经验逐渐形成,而 Skill 更像经过整理和版本化之后可复用的正式能力。
第三类:按信息载体划分
还有一些内容严格来说并不应该全部塞进“Memory Store”。例如:
| 类型 | 更适合的载体 |
| 当前生成的代码 | Workspace 文件 |
| 产品需求文档 | Project Knowledge |
| 用户长期偏好 | Long-term Memory |
| Agent 成功经验 | Procedural Memory / Skill |
| 历史对话 | Session Log |
因此:文件存在磁盘里,并不意味着它就应该被抽取成 Memory。这一点对 Coding Agent 尤其重要。
三、Pi 和 DeepSeek Harness 都说明:Session History 不等于长期 Memory
最近比较热门的 Pi 很适合说明这一点。Pi 会自动把对话保存为 Session,每个 Session 使用 JSONL 持久化,而且不是简单线性历史,而是支持树状分支、恢复、Fork 和 Compaction。模型当前使用的 Context 可以沿 Session Tree 从当前 Leaf 重新构建。这意味着 Pi 能做到:“我可以恢复之前的工作过程”。但这仍然主要属于:Session Memory / Task History。而不是:跨 Session 的用户长期记忆。DeepSeek Harness 的设计也类似。
当前 DeepSeek Harness 把 Session 建模成 append-only 的 SessionEvent 日志,并明确把它作为交互历史的唯一事实来源;下一轮 LLM Message History 是从 Event Log 派生出来,而不是独立保存一份 Messages。其 Persistence 进一步支持持久化、恢复和 Resume。可以简单理解为:
Pi / DeepSeek Harness Session
────────────────────
保存“这个任务发生了什么”
Long-term Memory
────────────────────
保存“未来还值得知道什么”

前者解决历史可恢复,后者解决经验可复用。这是两个不同的问题。
四、真正的长期记忆,不应该把整个 Session 原样复制过去
假设一次 Session 有 300 条消息。如果任务结束后把 300 条消息全部放进长期 Memory,下次再使用时,不仅 Token 成本极高,还会带来大量噪声和冲突。更合理的是在任务过程中或任务结束后执行一次 Memory Extraction:
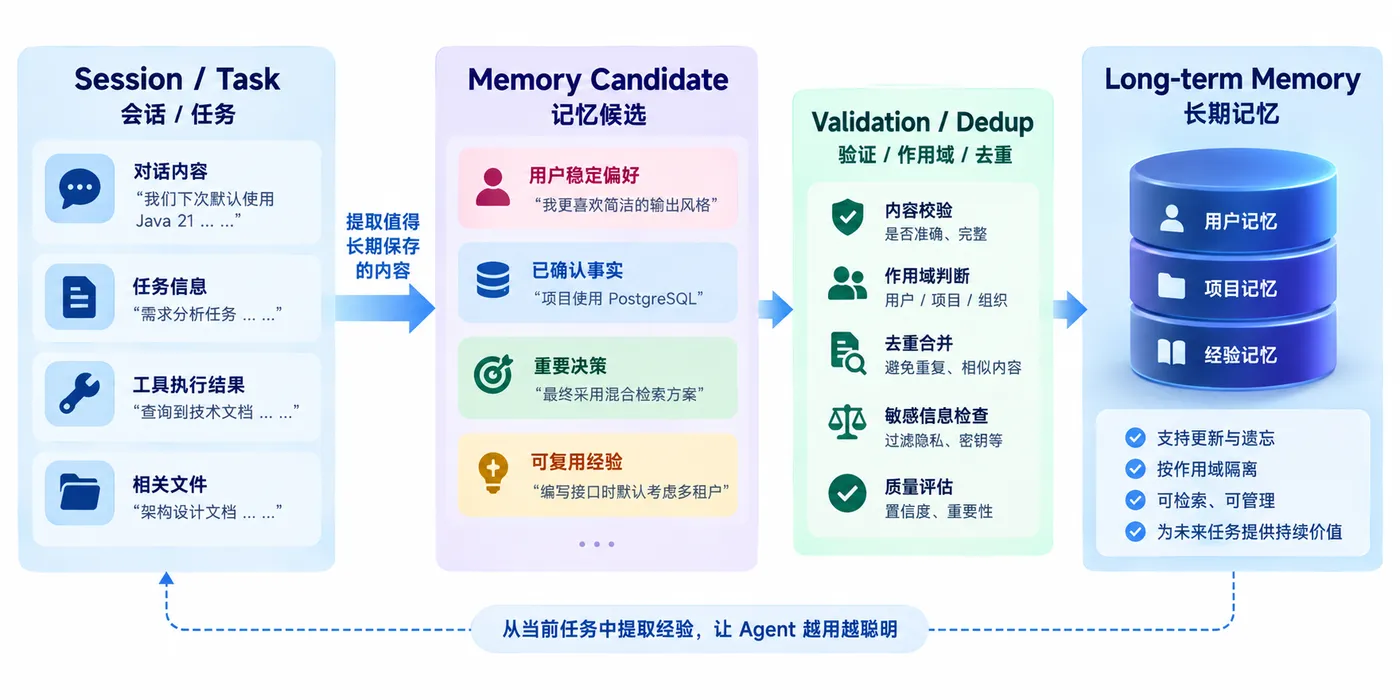

例如用户说:“这一篇文章不要使用 WorkBuddy 案例,因为已经在另一篇文章里写过了”。如果只是当前文章要求,可以留在 Task State。但如果用户持续要求:“这个系列的示例优先使用 OpenAI 和 DeepSeek”。它就可能成为长期 Procedural Memory。因此 Memory Extraction 的核心问题不是:能不能抽取?而是:未来再次遇到类似任务时,这条信息还有没有价值?
五、什么应该记,什么不应该记
生产级 Memory 最难的问题其实不是技术,而是准入规则。可以使用一个简单判断框架。
值得长期记住的信息 ,通常具有以下特征:
| 特征 | 示例 |
| 稳定 | 长期使用 Java |
| 经常复用 | 技术文章偏好紧凑表达 |
| 用户明确确认 | “以后都按这个格式” |
| 未来明显有价值 | 项目固定技术栈 |
| 可提高任务连续性 | 已确认的架构决策 |
不应该默认长期保存的信息 ,包括:
- 一次性的临时要求;
- 密码、Token、Secret;
- 大段原始文档;
- 未经确认的模型推测;
- 已过期的时间敏感信息;
- 与未来任务无关的闲聊;
- 可以随时从业务系统重新查询的数据。
例如:“今天先用 Python 写个 Demo”。并不应该自动成为:“用户长期偏好 Python”。否则就会形成 Memory Pollution。因此一个很重要的原则是:宁可少记,也不要把未经确认的推测长期固化。
六、Memory 不是每轮全部注入,而是需要 Recall
有了长期 Memory 后,下一个问题是:每次调用模型时是否把所有记忆都塞进去?答案显然是否定的。假设一个 Agent 已经积累:2 万条用户信息;500 次历史任务;300 条经验;几十个项目。如果全部进入 Context,效果反而会急剧下降。因此 Memory 也需要自己的 Retrieval:
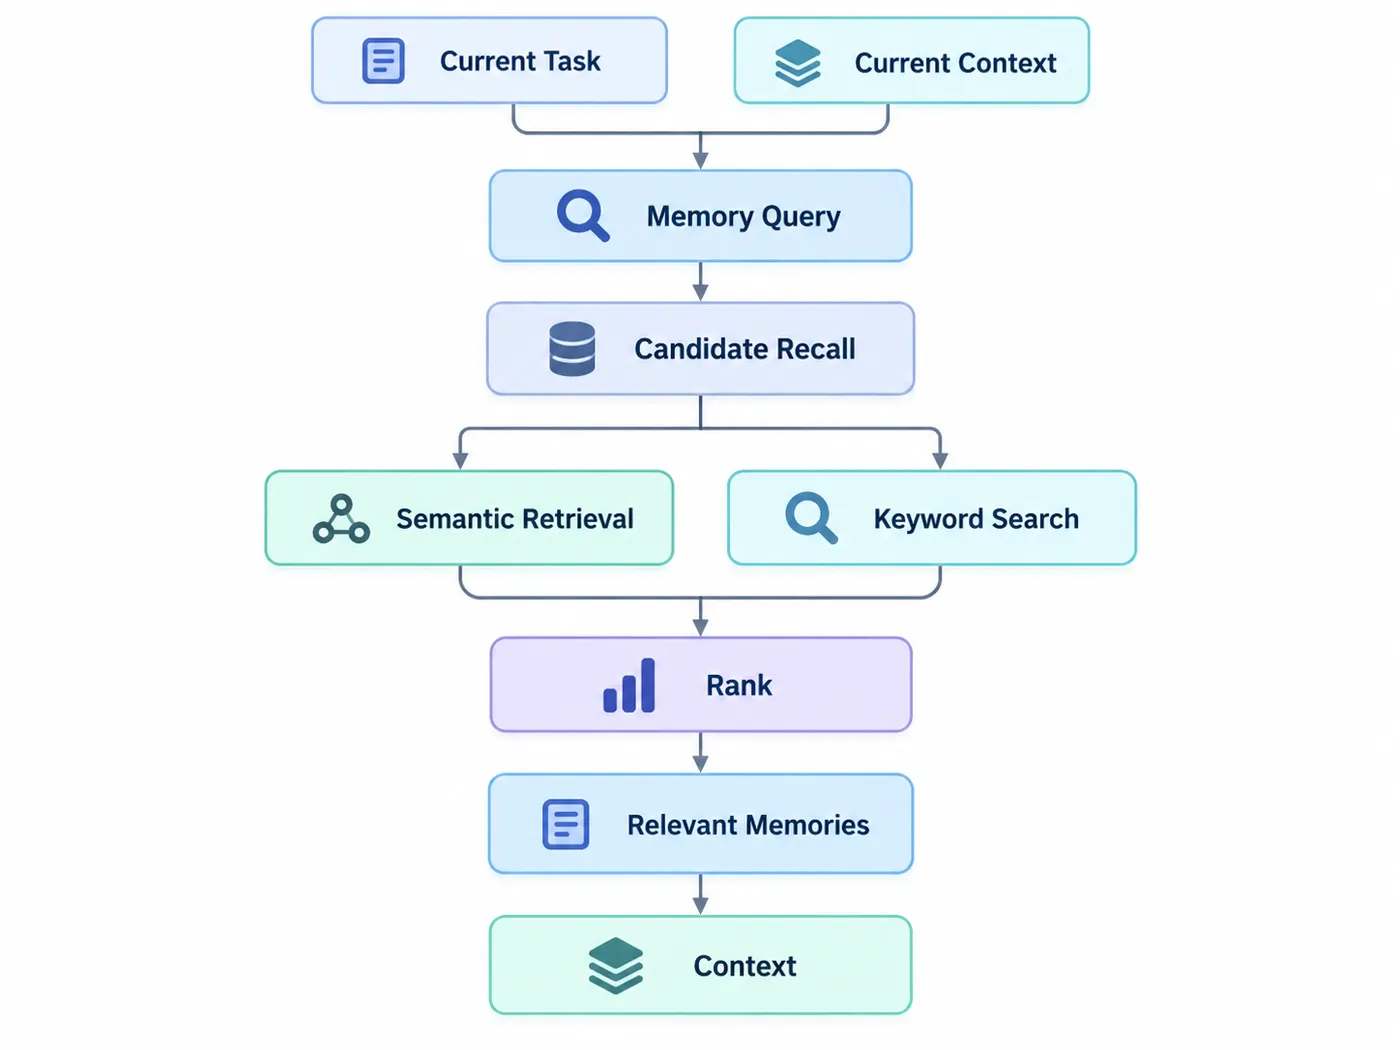

这与 RAG 很像,但对象不同。RAG检索的是:企业知识、文档、规范。Memory Retrieval检索的是:与当前用户、Agent 和历史任务有关的信息。所以:Memory 也需要“按需想起”,而不是“永远全部记在脑子里”。
七、记忆检索不能只看“语义相似度”
如果用户问:“继续按照我们之前确定的文章风格写”。需要召回的可能不是语义上与当前文章最相似的一段对话,而是之前被确认过的:写作偏好:结构紧凑,避免零散短句,适当增加配图。因此 Memory Ranking 往往需要综合多个因素:相关性+重要性+新鲜度+置信度+作用域。可以简单表示为:Memory Score =Semantic Relevance+ Importance+ Recency+ Confidence。实际系统不一定真的使用这个公式,但这种思路很重要。一条 6 个月前用户明确确认的长期偏好,可能比昨天一次临时要求拥有更高优先级。
八、Memory 应该允许更新,而不是不断新增重复事实
假设 Agent 已经保存:默认 JDK:17。后来用户明确说:项目已经统一升级到 JDK 21。错误做法是继续增加:Memory #1:JDK 17;Memory #2:JDK 21。然后让模型自己猜哪一个是当前事实。正确方式应该是:
旧 Memory
JDK = 17
   │
   │ 新事实
   ▼
Conflict Detection
   │
   ▼
Update
   │
   ▼
JDK = 21

因此长期 Memory 至少应该支持:Add;Update;Merge;Supersede;Expire;Delete
。而不仅是:append()。这也是为什么简单的 Vector Database 并不自动等于完整 Memory System。
九、遗忘不是缺陷,而是 Memory System 的核心能力
现实中的长期记忆如果只增加不删除,最终一定会退化。例如:已经结束的项目约束;旧版本技术栈;临时会议结论;已经被推翻的架构决定;过期用户偏好。如果永远保留并参与召回,很容易干扰 Agent。因此 Memory 应该拥有生命周期。可以根据:
- TTL;
- 最近访问时间;
- 重要程度;
- 新事实覆盖;
- 用户主动删除;
- 项目状态变化;
决定:Active→Low Priority→Archived→Expired / Deleted。所谓“遗忘”并不一定意味着立即物理删除,也可以先:降低 Recall 权重,使其不再主动进入 Context。这样更加安全。
十、Memory Pollution:长期记忆最大的风险之一
假设 Agent 某次误解用户意思:“这个项目以后全部使用 MongoDB”。实际上用户只是说:“这个 Demo 可以先使用 MongoDB”。如果错误结论被写入长期 Memory,以后多个任务都会持续受到影响。这就是 Memory Pollution。它可能来源于:
- 模型错误推断;
- 用户临时要求被错误升级为长期规则;
- 重复 Memory 相互冲突;
- 工具返回错误信息;
- Prompt Injection 污染;
- 不同项目之间作用域混淆。
因此 Memory Write Pipeline 不应该是:LLM 认为值得记→ Save。更合理的是:Memory→Candidate→Scope Check→Confidence Check→Conflict Check→Sensitive Data→ Check→Dedup / Merge→Save。高风险记忆还可以要求:Human Confirmation。
十一、记忆必须有 Scope,否则一定会串数据
例如:“默认使用 PostgreSQL”。它到底属于:当前 Task?当前 Project?当前 User?当前 Organization?所有用户?这完全是不同的含义。因此生产 Memory Store 至少应该带有:user_id
agent_id、project_id、session_id、memory_type、source、created_at、updated_at、confidence。不同 Memory 的访问范围应该严格隔离。这对于企业多租户场景尤其重要:A 用户的长期记忆绝不能因为语义相似而被 B 用户召回。Memory Retrieval 首先应该执行权限和 Scope Filter,然后才做语义检索。
十二、工作区文件和项目知识为什么不应该全部变成 Memory
Coding Agent 很容易说明这个问题。假设 Workspace 中有:
README.md
pom.xml
src/
architecture.md
requirements.md
这些文件本身就是最准确的信息来源。没有必要把整个 architecture.md 重新抽取一遍存进长期 Memory。正确关系更像:
| 内容 | 更适合的位置 |
| 当前修改中的代码 | Workspace |
| 项目架构规范 | Project Knowledge |
| 用户编码偏好 | Long-term Memory |
| 本次任务进度 | Task State |
| 已解决问题的经验 | Episodic / Procedural Memory |
Pi 当前就把 Session 与工作目录强关联:Session 按 working directory 保存,并支持恢复、树状分支和 Compaction;Skills 则按需加载完整指令,而不是把所有 Skill 内容永久塞在 Context 中。
这实际上反映了一个很好的 Agent 工程原则:能通过文件、Tool 或 RAG 随时获得的信息,不要轻易复制成长期 Memory。
十三、从 Pi 到 DeepSeek Harness:先把“历史”保存好,再谈长期记忆
Pi 和 DeepSeek Harness 都值得在这一篇中作为对照。Pi 的 Session 本质上是一棵可恢复、可 Fork 的历史树,还支持 Compaction,把过长历史压缩成摘要后继续构建模型 Context。
DeepSeek Harness 更进一步采用 Event-Sourced Session Log:用户消息、模型消息、Tool Call、Tool Result、Step 和 Turn 都进入 append-only Event Log,Session History 可以重新派生,并支持持久化和 Resume。可以把它们理解为 Memory System 的第一层基础设施:Session History→可恢复的任务历史→Memory Extraction→长期 Memory。也就是说:先有可靠的原始历史,才有可能从历史中提炼出可靠长期记忆。长期记忆不是 Session Log 的替代品,而是从 Session Log 中进一步抽象出的“可复用信息”。
十四、国内 Agent 已经开始把 Memory 做成独立工程能力
2026 年国内 Agent 生态的一个明显变化,是 Memory 正在从“保存 Messages”变成独立子系统。AgentScope 2.0 在今年已经增加 Agentic Memory,并集成 Mem0 与 ReMe 长期记忆能力。
其中 ReMe 的设计尤其值得关注:它提出 Memory as File, File as Memory,把长期记忆保存为普通 Markdown,通过 BM25、Embedding 和 Wikilink 等方式进行检索,并支持 Agent 持续从对话和资源中提炼事实、偏好、程序和关系。ReMe 目前也已经提供 DeepSeek Harness 插件,可将长期记忆能力接入 Harness。这条路线很有意思,因为它让:Memory不再只是一个隐藏的 Vector Store,而成为:可读、可编辑、可搜索、可版本管理、可备份的用户资产。对于企业 Agent,这种“可检查的记忆”往往比完全黑盒的记忆更加容易治理。
十五、一个生产级 Memory Pipeline 应该是什么样
综合前面的讨论,可以把 Agent Memory 拆成两个不同方向。
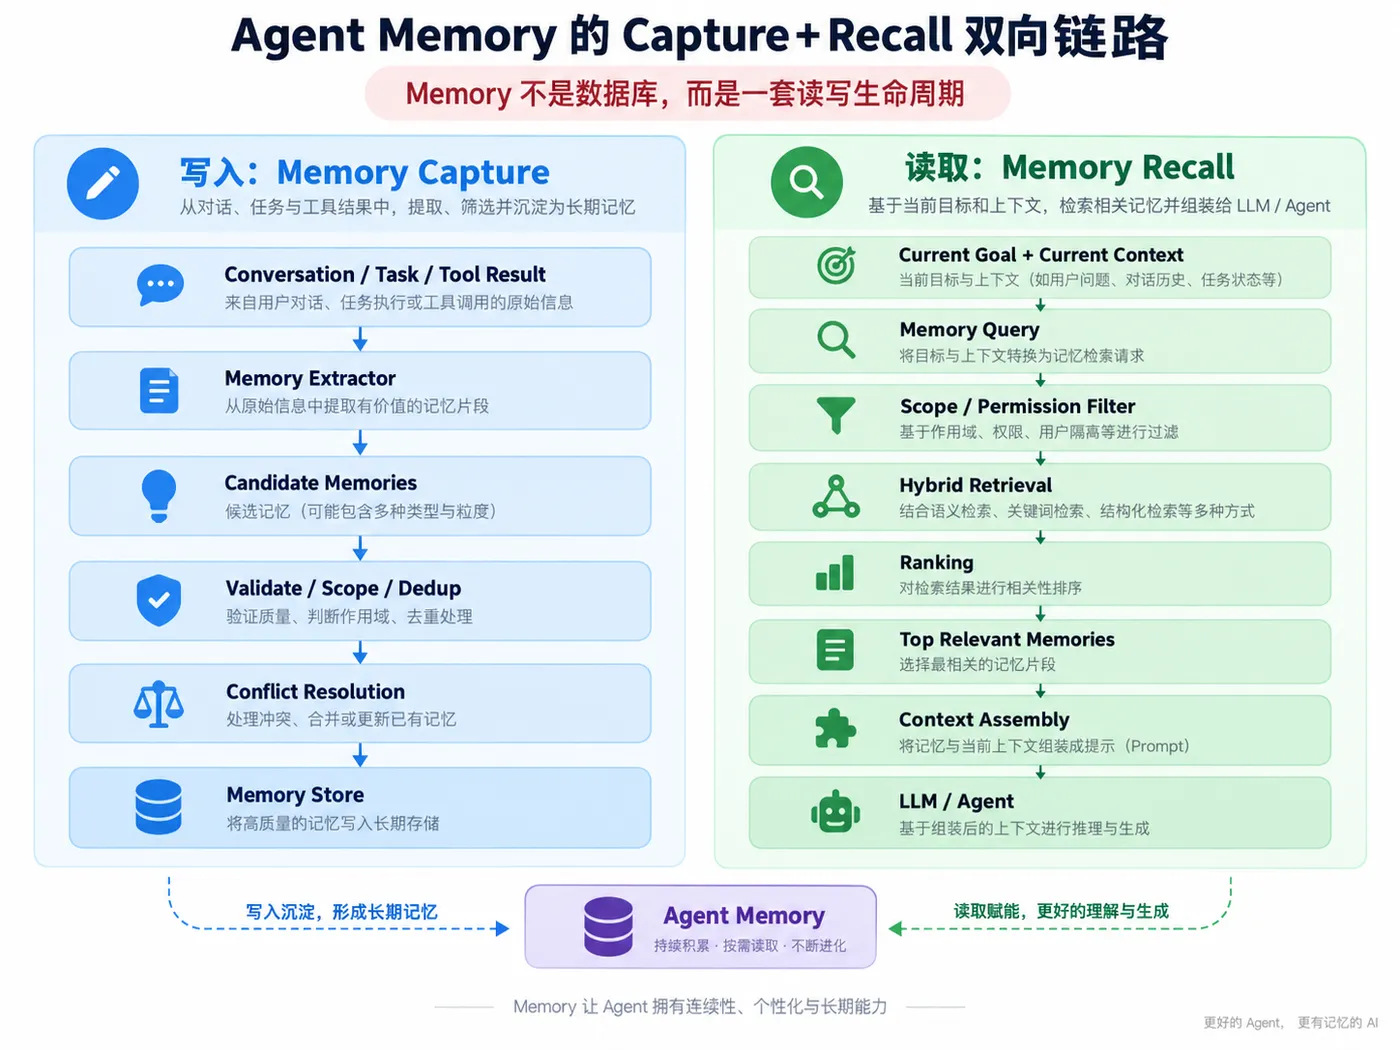

Memory 不是数据库,而是一套读写生命周期。
十六、为需求分析 Agent 加上 Memory,会发生什么
继续上一篇的需求分析 Agent。第一次执行任务时,用户说明:“我们公司的需求统一采用三级结构,功能需求必须包含验收标准”。任务完成以后,Memory Extractor 可以产生:
{
  "type": "procedural",
  "scope": "organization",
  "content": "需求统一采用三级结构,功能需求必须包含验收标准",
  "confidence": 1.0
}

下一次用户只需要说:“帮我整理一下这个新需求”。Agent 在进入 Generate Requirement Node 前执行 Memory Recall:
memories = memory.search(
    query="生成企业需求条目",
    user_id=user_id,
    project_id=project_id
)

再把召回结果加入当前 Context:
context = {
    "requirement": state["raw_requirement"],
    "memory": memories,
    "project_knowledge": knowledge
}

于是生成 Node 不需要再次询问相同规范。但这里依然保持上一篇的原则:Memory 为 Node 提供历史经验,State Machine 仍然负责整个任务如何流转。
十七、Memory 最终应该进入 Context,而不是取代 Context Engineering
这也是本篇和第 6 篇 Context Engineering 的连接点。Context 可以来自:
System Instruction
Current User Input
Task State
RAG Evidence
Tool Result
Memory Recall
Workspace Files
Project Knowledge

Memory 只是其中一种来源。最终仍然需要 Context Assembler 根据:
- 当前任务;
- Token Budget;
- 权限;
- 相关性;
- 信息优先级;
决定这一轮究竟放什么进去。所以:Memory System 负责“可能记得什么”,Context Engineering 负责“这一轮到底让模型想起什么”。二者不能互相替代。
十八、小结
为 Agent 增加 Memory,并不是增加一个:conversation_history字段就结束了。真正的 Memory System 至少需要回答五个问题:
- 记什么?只保存未来仍有价值的信息。
- 怎么记?从 Session、任务和经验中进行提取、验证和去重。
- 什么时候想起?根据当前任务按需 Recall,而不是全部注入 Context。
- 记忆变化了怎么办?支持 Update、Merge、Supersede 和 Expire。
- 哪些内容不能记?敏感数据、未经确认的推断、临时信息以及跨权限数据都必须严格控制。
因此可以把 Agent Memory 的核心概括为:Memory ≠ History。History 记录:过去发生了什么。Memory 保存:未来还值得知道什么。而完整的 Agent 运行时最终形成:
- State→ 当前任务执行到哪里
- Memory→ 过去有哪些值得复用的信息
- RAG→ 外部世界有哪些相关知识
- Workspace→ 当前有哪些可操作工件
- Context→ 这一轮模型真正看到了什么
- Agent→ 根据这些信息决定下一步做什么
Pi 和 DeepSeek Harness 已经很好地展示了 Session、History、Persistence 和 Workspace 如何成为 Agent Runtime 的基础;AgentScope、ReMe 等近期项目则进一步说明,Memory 正在逐渐成为一个独立、可检索、可更新甚至可以由用户直接检查的工程子系统。这也是 Agent 从“能够持续执行任务”继续向前迈出的一步:真正成熟的 Agent,不只是知道当前正在做什么,还能够在需要的时候记起过去真正有价值的信息。
上一篇回顾:
https://developer.aliyun.com/article/1761141?spm=a2c6h.13148508.setting.15.45944f0eeNSD7c
下一篇将进入
开发一个完整的企业知识助手
到那时,前面的:Context、Tool、Structured Output、RAG、State Machine 和 Memory将第一次真正组合到一个具有实际使用价值的企业 Agent 中。