四、混淆矩阵:错在哪个方向比错了多少更要命
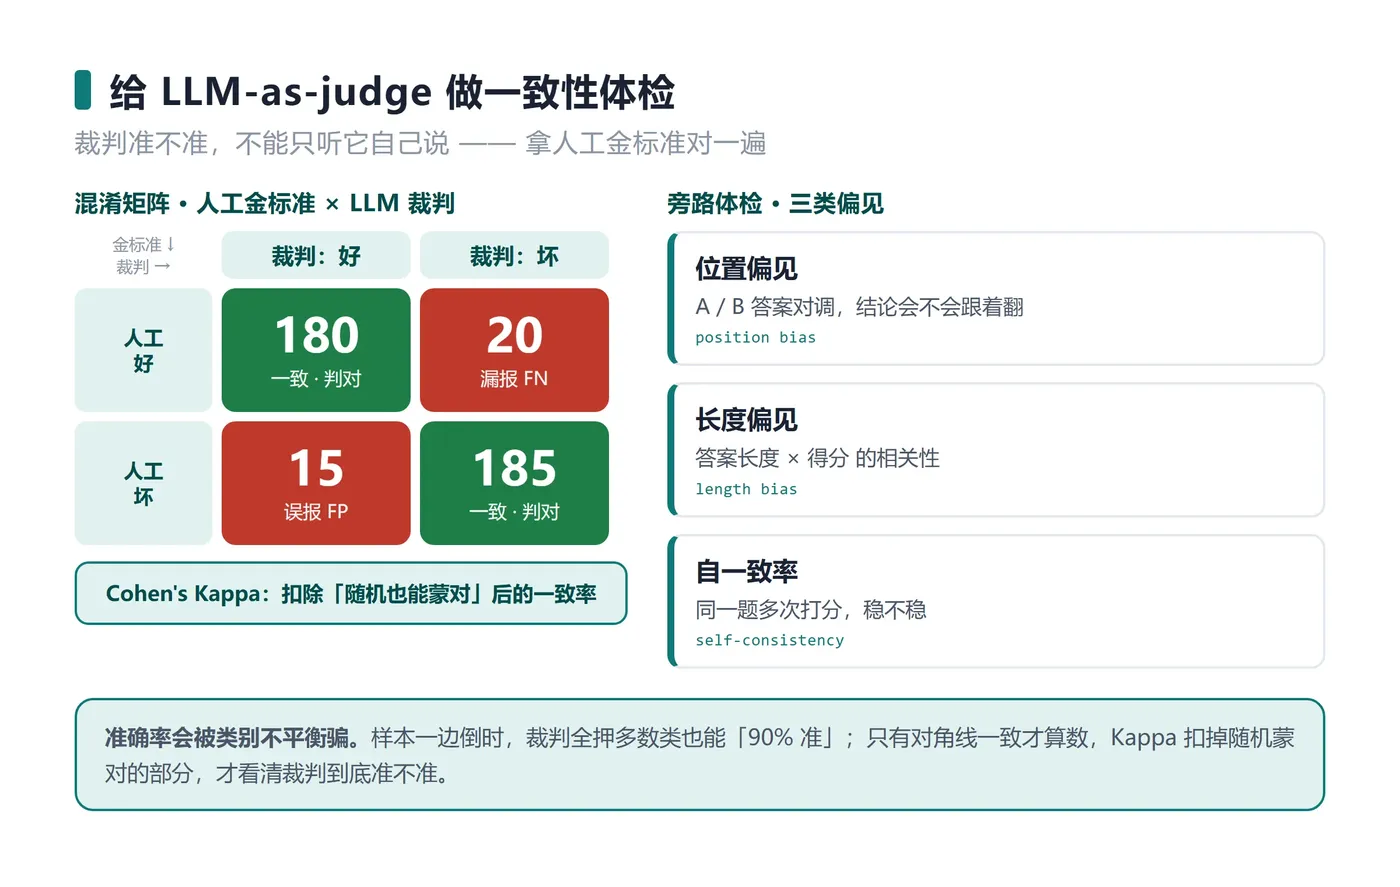
Kappa 告诉你裁判整体准不准,混淆矩阵告诉你它错在哪一侧。把人工金标准放行进、裁判判定放列进,二分类下就是一张 2×2 的表。
对角线上是判对的(都说合格、都说该拦),反对角线上是两类错误,而这两类错误的代价完全不对等:人工说该拦、裁判却放行,是「放过」——坏答案混进了选型结果,这是最贵的一种错;人工说合格、裁判却判该拦,是「误杀」——好答案被冤枉,代价相对小。
一个 Kappa 相同的两个裁判,偏向可能完全相反:一个偏松(放过多),一个偏严(误杀多)。选裁判时你得知道自己更能忍哪一种,而不是只盯着一个总分。
五、三类偏见体检:位置、长度、自一致
一致性只是体检的第一项,真正让 LLM 裁判翻车的往往是三类系统性偏见,它们各自有一套很轻的查法。
位置偏见:做 A/B 对比时,把两个答案的顺序对调再打一次,看结论会不会翻。会翻,说明裁判在给「排在前面/后面」的那个位置加分,而不是在给内容加分。查法就是同一对答案正反各跑一遍,统计结论翻转的比例。
长度偏见:把每条答案的字数和它拿到的分数拉出来算一个 Pearson 相关系数。如果相关明显为正,说明答案越长分越高——裁判在用篇幅冒充质量。这类偏见特别隐蔽,因为它让长而空的答案占了便宜。
自一致率:同一条答案,让裁判在相同设置下打多次,看它给的分数稳不稳。多数占比越高、方差越小,裁判越可信;如果同一条答案五次打分能横跨两三个档,那它的单次输出根本不能当数。
六、一个能直接跑的体检脚本
下面这个脚本把上面几项打包成一次体检:读入人工分与裁判分两列,算 Cohen's / Fleiss' Kappa、打印混淆矩阵、做位置对调实验、算长度—得分相关系数、统计自一致率。只依赖标准库,Kappa 和相关系数都自己算(scikit-learn / statsmodels 也有现成实现),加 --demo 会自己造一批样例数据跑一遍。
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
judge_health_check.py —— 给 LLM-as-judge 做一次体检

做五件事:
  1) Cohen's Kappa(两名评审)/ Fleiss' Kappa(多名评审),扣除随机一致
  2) 混淆矩阵:金标准(人工) × 裁判(LLM),看清错在哪个方向
  3) 位置偏见:A/B 答案对调后结论翻转的比例
  4) 长度偏见:答案字数与得分的 Pearson 相关系数
  5) 自一致率:同一条答案多次打分的多数占比与方差

只依赖标准库。加 --demo 会造一批样例数据直接跑。

用法:
  python judge_health_check.py --demo
  python judge_health_check.py --csv scores.csv   # 列: case_id,human,llm,answer_len
"""

from __future__ import annotations

import argparse
import csv
import math
import sys
from collections import Counter
from typing import Dict, List, Sequence


def cohen_kappa(a: Sequence, b: Sequence) -> float:
    """两名评审的一致性。a/b 等长,逐项是各自的标签。"""
    if len(a) != len(b) or not a:
        raise ValueError("两列标签必须等长且非空")
    n = len(a)
    po = sum(1 for x, y in zip(a, b) if x == y) / n          # 实际一致
    ca, cb = Counter(a), Counter(b)
    pe = sum((ca[k] / n) * (cb[k] / n) for k in set(ca) | set(cb))  # 随机一致
    return 1.0 if pe == 1.0 else (po - pe) / (1 - pe)


def fleiss_kappa(matrix: List[List[int]]) -> float:
    """多名评审的一致性。matrix 每行一个样本,每列一个类别,值=投该类的评审数。"""
    N = len(matrix)                       # 样本数
    n = sum(matrix[0])                    # 每个样本的评审数(须一致)
    k = len(matrix[0])                    # 类别数
    if any(sum(row) != n for row in matrix):
        raise ValueError("每个样本的评审人数必须相同")
    col_tot = [sum(matrix[i][j] for i in range(N)) for j in range(k)]
    p_j = [c / (N * n) for c in col_tot]                       # 各类别边际概率
    P_i = [(sum(v * v for v in row) - n) / (n * (n - 1)) for row in matrix]
    P_bar = sum(P_i) / N                                       # 平均实际一致
    P_e = sum(p * p for p in p_j)                              # 随机一致
    return 1.0 if P_e == 1.0 else (P_bar - P_e) / (1 - P_e)


def confusion(human: Sequence, llm: Sequence, labels: Sequence) -> Dict:
    m = {
   h: {
   l: 0 for l in labels} for h in labels}
    for h, l in zip(human, llm):
        m[h][l] += 1
    return m


def pearson(xs: Sequence[float], ys: Sequence[float]) -> float:
    n = len(xs)
    mx, my = sum(xs) / n, sum(ys) / n
    cov = sum((x - mx) * (y - my) for x, y in zip(xs, ys))
    vx = sum((x - mx) ** 2 for x in xs)
    vy = sum((y - my) ** 2 for y in ys)
    return cov / math.sqrt(vx * vy) if vx and vy else 0.0


def position_bias_flip(pair_forward: Sequence, pair_swapped: Sequence) -> float:
    """同一对答案正/反各判一次的胜者列表,返回结论翻转比例。"""
    flips = sum(1 for f, s in zip(pair_forward, pair_swapped) if f != s)
    return flips / len(pair_forward) if pair_forward else 0.0


def self_consistency(repeat_scores: List[Sequence]) -> Dict:
    """每条答案多次打分,返回多数占比与平均方差。"""
    ratios, variances = [], []
    for scores in repeat_scores:
        c = Counter(scores)
        ratios.append(c.most_common(1)[0][1] / len(scores))
        m = sum(scores) / len(scores)
        variances.append(sum((s - m) ** 2 for s in scores) / len(scores))
    return {

        "majority_ratio": sum(ratios) / len(ratios) if ratios else 0.0,
        "mean_variance": sum(variances) / len(variances) if variances else 0.0,
    }


def report(rows: List[Dict]) -> None:
    human = [r["human"] for r in rows]
    llm = [r["llm"] for r in rows]
    labels = sorted(set(human) | set(llm), key=str)
    acc = sum(1 for h, l in zip(human, llm) if h == l) / len(rows)
    kappa = cohen_kappa(human, llm)

    print("样本数              = %d" % len(rows))
    print("朴素准确率          = %.4f   (类别不平衡时会虚高,别只看它)" % acc)
    print("Cohen's Kappa       = %.4f" % kappa)

    band = ("<0.2 极差" if kappa < 0.2 else "0.2-0.4 一般" if kappa < 0.4
            else "0.4-0.6 中等" if kappa < 0.6 else "0.6-0.8 较好" if kappa < 0.8
            else ">0.8 很好")
    print("解读(Landis & Koch) = %s" % band)

    print("\n混淆矩阵(行=人工金标准,列=LLM 裁判):")
    m = confusion(human, llm, labels)
    print("        " + "".join("%8s" % l for l in labels))
    for h in labels:
        print("%6s  " % h + "".join("%8d" % m[h][l] for l in labels))

    lengths = [r.get("answer_len", 0) for r in rows]
    scores = [float(r.get("llm_score", r["llm"] == labels[-1])) for r in rows]
    if any(lengths):
        print("\n长度-得分 Pearson 相关 = %.4f  (明显为正=偏袒长答案)"
              % pearson(lengths, scores))


DEMO_ROWS = [
    # 人工=合格(pass)/不合格(fail),LLM 裁判偏向把长答案判成 pass
    {
   "case_id": "c01", "human": "pass", "llm": "pass", "answer_len": 420, "llm_score": 1},
    {
   "case_id": "c02", "human": "pass", "llm": "pass", "answer_len": 380, "llm_score": 1},
    {
   "case_id": "c03", "human": "fail", "llm": "pass", "answer_len": 510, "llm_score": 1},
    {
   "case_id": "c04", "human": "fail", "llm": "fail", "answer_len": 120, "llm_score": 0},
    {
   "case_id": "c05", "human": "pass", "llm": "pass", "answer_len": 460, "llm_score": 1},
    {
   "case_id": "c06", "human": "fail", "llm": "pass", "answer_len": 490, "llm_score": 1},
    {
   "case_id": "c07", "human": "pass", "llm": "fail", "answer_len":  90, "llm_score": 0},
    {
   "case_id": "c08", "human": "pass", "llm": "pass", "answer_len": 350, "llm_score": 1},
    {
   "case_id": "c09", "human": "fail", "llm": "fail", "answer_len": 130, "llm_score": 0},
    {
   "case_id": "c10", "human": "pass", "llm": "pass", "answer_len": 400, "llm_score": 1},
]


def load_csv(path: str) -> List[Dict]:
    with open(path, "r", encoding="utf-8") as f:
        rows = []
        for r in csv.DictReader(f):
            rows.append({

                "case_id": r["case_id"],
                "human": r["human"],
                "llm": r["llm"],
                "answer_len": int(r.get("answer_len", 0) or 0),
                "llm_score": float(r.get("llm_score", 0) or 0),
            })
        return rows


def main(argv: List[str]) -> int:
    p = argparse.ArgumentParser(description="给 LLM-as-judge 做一致性 + 偏见体检")
    p.add_argument("--csv", help="人工分与裁判分两列的 CSV")
    p.add_argument("--demo", action="store_true", help="用内置样例数据跑一遍")
    args = p.parse_args(argv)

    if args.demo:
        rows = DEMO_ROWS
        print("[demo] 使用内置样例数据\n")
    elif args.csv:
        rows = load_csv(args.csv)
    else:
        print("[ERROR] 需要 --csv 或 --demo", file=sys.stderr)
        return 2

    report(rows)

    # Fleiss' Kappa:先确认人工评审彼此之间够一致,这批分才有资格当金标准
    # 每行一个样本,两列分别是 3 名评审投给 pass / fail 的人数
    human_panel = [[3, 0], [0, 3], [3, 0], [3, 0], [2, 1], [0, 3]]
    print("\n人工评审之间的 Fleiss' Kappa = %.4f  (金标准自己先要够一致)"
          % fleiss_kappa(human_panel))

    # 位置偏见与自一致率的演示(真实场景由你的裁判接口返回)
    fwd = ["A", "B", "A", "B", "A"]
    swp = ["A", "A", "B", "B", "A"]
    print("\n位置偏见结论翻转率 = %.2f  (越高说明越受排序影响)"
          % position_bias_flip(fwd, swp))

    repeats = [[1, 1, 1, 0], [1, 1, 1, 1], [0, 1, 0, 0]]
    sc = self_consistency(repeats)
    print("自一致率(多数占比) = %.2f  平均分内方差 = %.3f"
          % (sc["majority_ratio"], sc["mean_variance"]))
    return 0


if __name__ == "__main__":
    sys.exit(main(sys.argv[1:]))
几点为什么这么写。第一,cohen_kappa 和 fleiss_kappa 都自己实现而没直接调库,是为了让体检脚本零依赖、能塞进任何 CI,Kappa 的公式也就十几行;等确认要长期跑,再换成 scikit-learn 的 cohen_kappa_score 结果一致。第二,report 里坚持同时打印朴素准确率和 Kappa,就是为了让「准确率虚高、Kappa 很低」这个反差直接摆在眼前——这是说服团队别只看准确率最有力的一屏。第三,混淆矩阵特意保留行列标签,因为你真正要看的不是对了多少,而是反对角线上「放过」和「误杀」哪个更重,这决定了你后面该收紧还是放松裁判。踩过的坑是长度相关那一项:一定要用连续分(llm_score)而不是二值标签去算 Pearson,否则相关系数会被压平,看不出偏袒长答案的信号。第四,demo 里刻意先算人工评审之间的 Fleiss' Kappa、再算裁判的 Cohen's Kappa,这个顺序不能颠倒——金标准自己都不够一致时,裁判的低分说明不了任何问题,你只是在拿一把晃的尺子量东西。
七、体检完,然后呢
体检不是为了给裁判发一张合格证,是为了决定它的分能不能进决策。Kappa 落到「较好」以上、三类偏见都压得住,才让它单独跑分、你只保留抽检;一旦掉到「中等」及以下,别急着换模型,先做三件便宜的事:把评分细则(rubric)写细、给裁判几个带分档理由的 few-shot 锚点、把「一个总分」拆成几个维度分别判。这三步通常能把一致性拉上来一截,实在拉不动,再考虑换裁判模型或退回人工——那笔钱该花,因为你在替一个错误的判断买单之前,先发现了它是错的。
还有一件事必须写进流程:体检不是一次性的。裁判依赖的模型会升级、你的评分细则会改、答案的分布也会漂,任何一样变了,上一份体检报告就作废了。合理的节奏是把体检挂在三个触发点上——换裁判模型时、改 rubric 时、评测结论要进重大决策前。平时不必天天跑,但这三个点上不跑,你手里的分数就只是一份过期证件。
裁判不稳的时候,它打出的每一个分数都是在替你做错误决策的加速器。
评测模型之前,先评测那个替你做判断的裁判——它的一致性,才是你所有分数可信度的地基。
你们那套 LLM-as-judge,上次和人工金标准对过一致性吗,Kappa 落在哪一档?