结论先给:开源三件套替得掉商业 APM 的「看」,替不掉它的「省人」。在服务数十几到几十个、有一名能长期负责可观测的工程师、埋点已经统一到 OpenTelemetry 的团队里,Prometheus(指标)+ Grafana(查询展示)+ Tempo(链路)自建栈的能力覆盖已经够用;一旦服务规模继续往上走、多团队共用一套平台、要求自动根因和 7×24 兜底,直接买或走托管开源反而更划算。
这篇不聊 Trace 采样率怎么定——采样是单点策略,本篇是整套栈的选型;也不聊 dashboard 怎么画。只干一件事:把开源栈和商业 APM 摊到同一张表上逐维对齐,给出一条能贴进技术评审纪要的判断线。
一、先把评估框架立起来:五个维度
功能清单每年都在互相靠近,真正拉开差距的是维护成本和团队的技术栈基因。所以本篇统一用五个维度评估:
- 能力覆盖:指标、日志、链路三支柱是否齐,缺的那一柱怎么补。
- 运维成本:自建要投多少人力,这笔投入以什么形式出现。
- 告警与降噪:从「能报警」到「值班的人不骂街」之间隔着多少工作量。
- Trace 与指标的关联能力:能不能从一条异常曲线一步下钻到具体请求。
- 团队上手门槛:查询语言、埋点方式、需要多少前置知识。
这五条里,前四条决定这套栈能不能撑住事故,第五条决定它半年后还有没有人愿意碰。
二、第一个真相:三件套只覆盖两支柱
不少人把「Prometheus + Grafana + Tempo」当成一套完整的可观测平台,这是选型阶段最贵的误解。
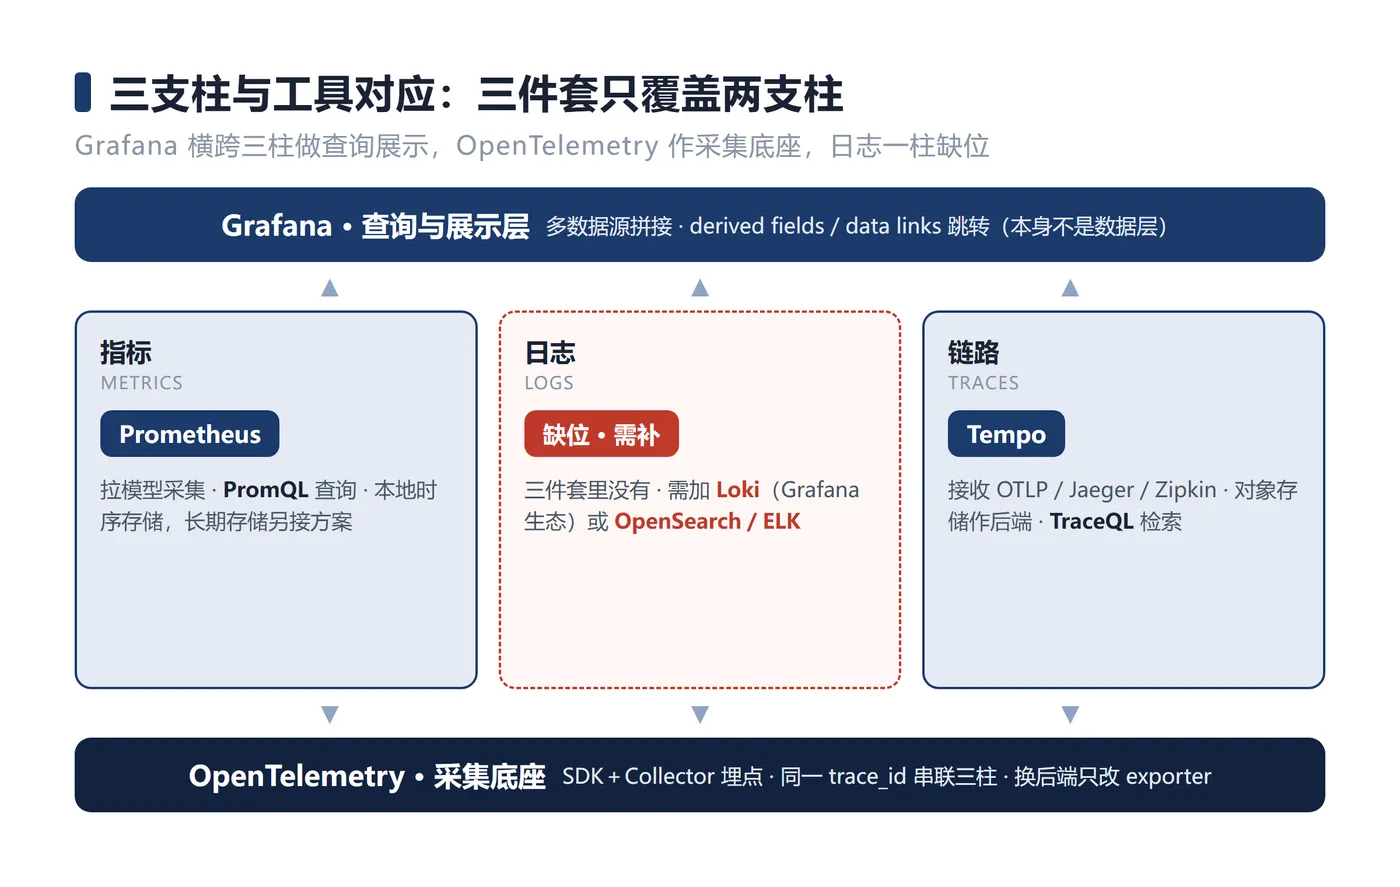
按通行的三支柱口径拆开:
- 指标 metrics → Prometheus:拉模型采集、PromQL 查询、本地时序存储,长期存储要另接方案。
- 链路 traces → Tempo:接收 OTLP/Jaeger/Zipkin 上报,用对象存储作为 trace 后端,TraceQL 做检索。
- 日志 logs → 三件套里没有。Grafana 不是数据层,它是查询与展示层;要补齐日志,得再加 Loki(同属 Grafana 开源生态)或 OpenSearch/ELK 一类方案。
所以这道题的准确写法不是「三件套 vs 商业 APM」,而是「三件套 + 一个日志后端 + 你自己写的告警规则 + 你自己维护的采集层 vs 一个开箱即用的商业 APM」。把加号后面那些算进来,很多团队才第一次看清自建的真实体量。
还有一个常被忽略的角色:采集层。三件套都不负责埋点,真正干活的是 OpenTelemetry SDK 与 Collector——它决定了指标、日志、链路能不能用同一个 trace_id 串起来。好处是:埋点标准中立于后端,今天写 Tempo、明天换商业 APM,改造量主要落在 Collector 的 exporter 配置上,而不是全量重写业务代码。
三、五维逐格对照
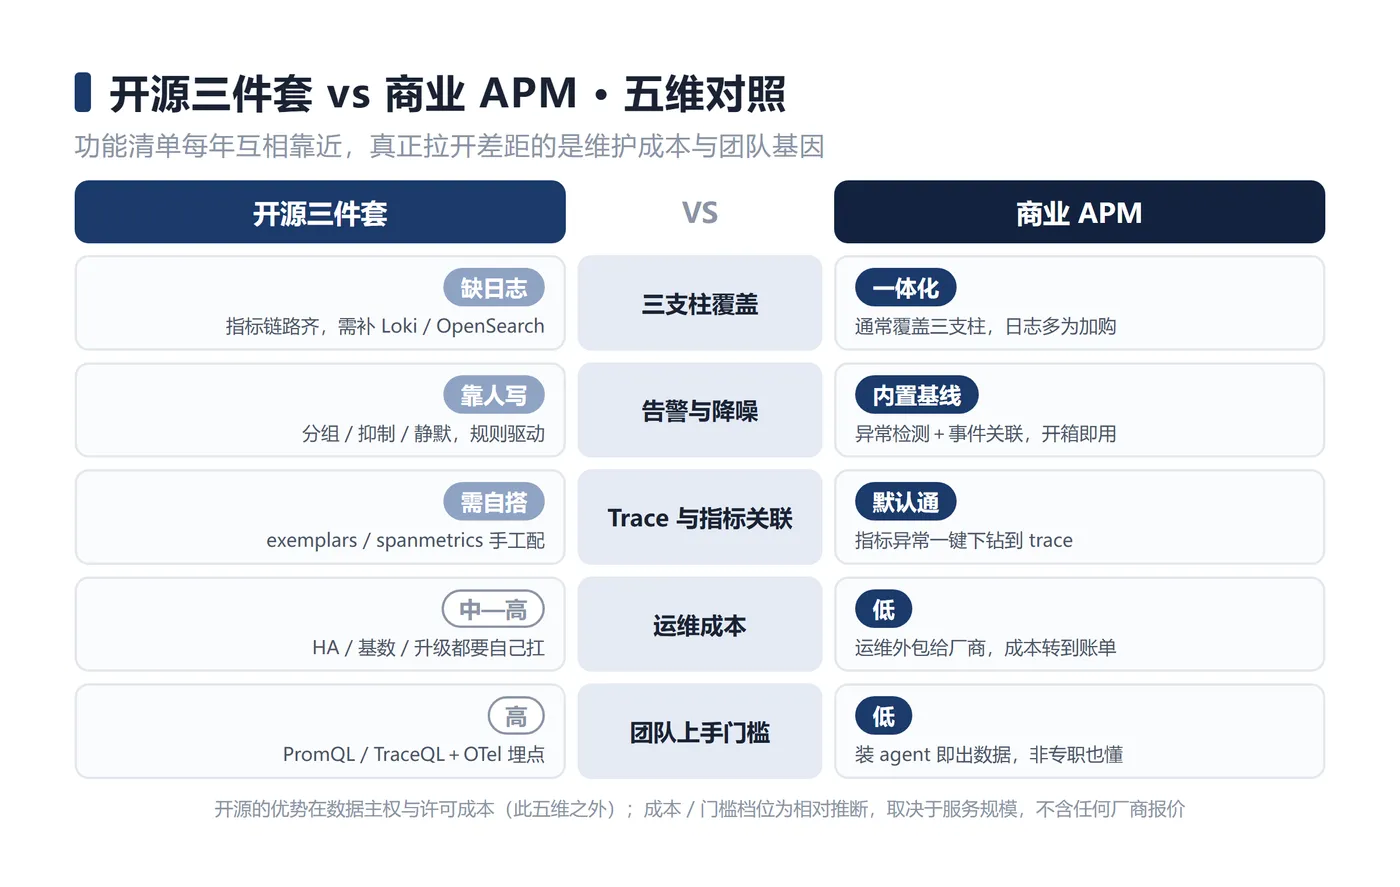
下面这张表是本文核心,建议直接截图:
| 评估维度 | 开源三件套(Prometheus + Grafana + Tempo) | 商业 APM |
|---|---|---|
| 三支柱覆盖 | 指标、链路齐;日志缺位,需补 Loki/OpenSearch;三支柱之间靠 Grafana 拼接呈现 | 通常一体化覆盖三支柱,日志多为可选加购模块,数据量越大账单越重 |
| 告警与降噪 | Alertmanager 提供分组、抑制、静默,规则驱动;动态基线类能力要自建或依赖付费版本【推断】 | 内置基线与异常检测、事件关联、告警聚合,开箱即用,降噪本身是其核心卖点之一 |
| Trace 与指标关联 | 能打通,但要自己搭:Prometheus exemplars、Collector spanmetrics 派生 RED 指标、Grafana data links/derived fields、Tempo TraceQL | 多为默认自动关联:从指标异常一键下钻到 trace,再到日志与调用栈,链路出厂即通 |
| 运维成本 | 相对档:中—高。HA、保留期、基数治理、对象存储、版本升级都要自己扛【推断】 | 相对档:低(运维外包给厂商),但成本转移到采购与用量账单上【推断】 |
| 团队上手门槛 | 高:需掌握 PromQL/TraceQL、OTel 埋点、Collector 配置;云原生团队曲线较平缓 | 低:装 agent 即出数据,非专职人员也能看懂;代价是深度定制受限、语义被产品固化 |
三条读表提示:
第一,「能打通」和「默认打通」是两个成本量级。 开源栈的关联能力官方文档里都有,但要落地成值班同事一次点击就跳转的体验,得有人把 exemplars、spanmetrics、data links 逐条配好并长期维护。文档里有,不等于你团队里有。
第二,告警降噪这一格,开源输的不是功能,是人力。 Alertmanager 的分组/抑制/静默机制足够强,问题在于阈值都要人写、人调,还要人在告警风暴之后回来复盘。商业 APM 的动态基线,本质是把这份人力产品化了。
第三,日志支柱缺位会直接拖慢事故排障。 真实排障里,「这条 trace 慢了」之后紧接的问题几乎总是「那个时刻日志里写了什么」。选型时如果只算指标和链路,等于给最耗时的排障环节留了个洞。
四、自建的真实成本:从最小骨架到生产
先看自建能多快跑起来。下面这份最小骨架,四个容器就能在本地拉起完整链路(仅示意复杂度,不是生产配置):
# docker-compose.yml:可观测最小骨架(示意用,生产配置远不止这些)
services:
  otel-collector:
    image: otel/opentelemetry-collector-contrib:latest
    command: ["--config=/etc/otel/config.yaml"]
    volumes: ["./otel/config.yaml:/etc/otel/config.yaml:ro"]
    ports: ["4317:4317", "4318:4318"]   # OTLP gRPC / HTTP 接入

  prometheus:
    image: prom/prometheus:latest
    volumes:
      - ./prometheus/prometheus.yml:/etc/prometheus/prometheus.yml:ro
      - prom-data:/prometheus
    ports: ["9090:9090"]

  tempo:
    image: grafana/tempo:latest
    command: ["-config.file=/etc/tempo/tempo.yaml"]
    volumes:
      - ./tempo/tempo.yaml:/etc/tempo/tempo.yaml:ro
      - tempo-data:/var/tempo
    ports: ["3200:3200"]                # Tempo 查询端口

  grafana:
    image: grafana/grafana:latest
    environment:
      - GF_AUTH_ANONYMOUS_ENABLED=true  # 仅本地演示,生产必须关闭
    volumes:
      - ./grafana/datasources.yaml:/etc/grafana/provisioning/datasources/ds.yaml:ro
      - grafana-data:/var/lib/grafana
    ports: ["3000:3000"]

volumes:
  prom-data:
  tempo-data:
  grafana-data:
配套还要写三份配置:prometheus.yml(抓取目标与 remote_write)、tempo.yaml(组件角色与存储后端)、grafana/datasources.yaml(数据源与跳转关系)。到这一步,一个下午能出 demo。
但从 demo 到生产之间的那段距离,才是选型真正要算的账:
- 高可用:Prometheus 单实例意味着监控自身有单点,要么双副本并行抓取,要么引入 Thanos/Mimir/VictoriaMetrics 一类方案;Tempo 的生产形态是多组件分工,通常还要挂对象存储。
- 基数治理:自建 Prometheus 最常见的翻车不是磁盘满,而是高基数标签把时序数量炸开——比如把 user_id、request_id 当标签。这事没有产品能替你解决,只能靠埋点规范和评审。
- 保留期与存储:trace 放对象存储确实便宜,但「便宜」是相对档,具体金额取决于服务规模、保留天数和查询频率【推断】;指标侧长期存储还要额外一层。
- 升级与值班:三套组件各有各的版本节奏,升级前的兼容验证要自己做;出问题没有厂商工单,只有社区 issue。
五、自建 vs 托管开源 vs 直接买
把运维成本、门槛和适用规模放到同一张表上,还有一个常被跳过的选项:
| 对照项 | 自建开源三件套 | 托管开源(云厂商/原厂托管的 Prometheus·Grafana 栈) | 商业 APM |
|---|---|---|---|
| 成本结构 | 软件许可低,成本集中在人力与基础设施;相对档:中【推断】 | 按用量计费,省掉大部分运维人力;相对档:中【推断】 | 按主机数/用量计费,规模上去后账单非线性上升;相对档:高【推断】 |
| 人力投入量级 | 小规模兼职可维持,中等规模通常要一名专职,大规模需 2 人以上【推断】 | 一名兼职即可维持日常【推断】 | 接近零专职运维,但仍需有人做 agent 治理与用量管控【推断】 |
| 适用团队规模 | 服务数十个以内、云原生栈、有 1 名能扛可观测的工程师 | 想要 PromQL 与开源语义、但不想管 HA 与升级的团队 | 数十到上百服务、多团队共用、有合规审计与对外 SLA 承诺 |
| 上手门槛 | 高:PromQL/TraceQL + OTel 埋点 + 三份配置 | 中:查询语言照旧,运维被托管 | 低:装 agent 即出数据 |
| 数据主权与锁定 | 主权最高,锁定风险最低 | 主权中等,导出语义通常仍是开源格式 | 主权最低,历史数据导出与语义迁移是主要锁定成本 |
| 典型痛点 | 组件多、日志支柱要自己补、告警规则全靠人写 | 用量涨起来后账单同样难看 | 深度定制受限,高峰月账单不可预测 |
这张表里最值得划出来的一行是人力投入量级:自建省下的许可费,会以「某个人半年来一直在调告警规则、升组件版本」的形式付出去。这笔支出不进任何报表,却决定这套栈半年后是资产还是包袱。
六、结论:什么规模自建,什么时候买
把五个维度收敛成一条判断线:
- 该自建:服务数在十几个量级、技术栈云原生、团队里有人愿意也有能力长期负责可观测、埋点已统一到 OpenTelemetry。这个区间里开源栈不缺关键能力,成本优势明显,数据主权最高。
- 该走托管开源:你离不开 PromQL 和开源语义,但不想管 HA、升级和对象存储;或者人手刚够做业务,抽不出专职。这是最容易被忽略的中间态:既省人力,又保留迁移退路。
- 该直接买:服务数上到几十上百、多团队共用一套平台、有合规审计与对外 SLA 承诺、需要自动根因与厂商 7×24 支撑。这时候你买的不是功能,是「事故时不用自己拼链路」的确定性。
- 无论走哪条路,埋点先统一到 OpenTelemetry:这是唯一能把切换成本压到最低的决定。后端可以换,埋点重来一次的代价谁都付不起。
需要提醒的是,本文结论是发稿时点的判断。商业 APM 的功能与定价变动很快,开源侧的能力边界——尤其 Grafana 生态里哪些属开源版、哪些属企业版或云版——也在持续调整,发布前请按当前官方文档与报价复核。
七、写在最后
开源三件套能不能替掉商业 APM,答案不在功能清单里,而在你有没有一个愿意为它长期负责的人。
有,自建省下的远不只是许可费;没有,你只是把厂商的账单换成了自己的技术债,而且这笔债没有客服。
选型结论别人的都只是起点:留言区说说你们的服务规模和技术栈,我帮你把这条判断线对一遍。