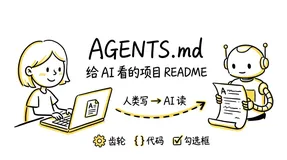
随着AI编程助手大规模进入研发工作流,Cursor、Claude Code、Codex、Gemini CLI等工具被团队同时使用的场景越来越普遍。不同工具各自定义专属规则配置文件,Cursor依赖.cursorrules,Claude Code使用CLAUDE.md,Codex早期使用AGENT.md。同一套编码约束、架构规则、项目构建命令,团队需要维护多份内容高度重合的文档。修改一条编码规范,就要同步更新全部配置,极易出现内容不一致,导致AI获取到的项目信息出现偏差,生成的代码质量参差不齐,大量时间耗费在人工修改AI产出的不合规代码上。
AGENTS.md作为由Agentic AI基金会托管的开放行业标准应运而生,定位是面向所有AI编码智能体的项目导航文档,相当于专门供AI阅读的项目README。一份文档即可承载项目架构、硬性编码约束、构建命令、验证流程,绝大多数主流AI编程工具原生支持读取该文件;针对不原生识别该文件的工具,通过软链接或者导入语法即可完成兼容,彻底解决多工具配置碎片化难题。本文基于Spring Boot+React全栈管控系统真实业务场景,完整拆解AGENTS.md诞生背景、核心设计思想、文档编写规范、monorepo存量仓库改造、自动化校验脚本、端到端自测闭环,附带大量可直接复制运行的shell、Makefile代码,覆盖从空白项目搭建、存量旧项目迁移到AI自主执行构建测试的完整落地流程。
阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面了解。
Token Plan Token 最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。
一、AGENTS.md标准诞生背景与核心理念
1.1 早期AI编码配置碎片化痛点
在统一规范出现之前,每一款AI编码工具都设计了专属规则文件,文件存放路径、语法格式互不通用,给团队协作带来巨大维护负担。
- Claude Code:
CLAUDE.md,具备子规则导入语法; - Cursor:
.cursorrules或者.cursor/rules目录模块化规则; - GitHub Copilot:
.github/copilot‑instructions.md; - Gemini CLI:
GEMINI.md; - Sourcegraph AMP:单数文件名
AGENT.md; - Codex:复数文件名
AGENTS.md。
研发团队同时使用多款AI助手开展开发工作,修改一条分层架构约束,就需要同步维护多份文档,人工同步极易出现遗漏。AI无法完整理解项目整体架构,出现私有组件不认识、编码规范混乱、不知道项目构建测试命令等一系列问题,AI产出代码的返工率居高不下。
后续社区多方力量开展标准对齐,将复数命名AGENTS.md确立为通用标准,交由Agentic AI基金会进行托管,目前已经有数万个开源项目接入使用。针对Claude Code不原生识别AGENTS.md的现状,一行软链接命令即可实现双向兼容,无需维护两份独立文档。
# 创建软链接,让Claude直接复用AGENTS.md
ln -s AGENTS.md CLAUDE.md
存量项目如果之前使用单数AGENT.md,执行下面命令完成平滑迁移,同时保留旧文件兼容老工具:
mv AGENT.md AGENTS.md && ln -s AGENTS.md AGENT.md
1.2 核心设计思想:做项目导航地图,而非巨型操作手册
AGENTS.md最重要的设计原则叫做渐进式披露,文档建议控制在200行以内,只存放AI开展编码工作必不可少的硬性全局约束。项目完整架构说明、组件详细用法、业务流程长篇描述,不要全部堆砌在这份主文件,统一拆分存放至docs目录下面独立Markdown文档,AGENTS.md里面只写文档索引跳转链接。
明确信息划分边界:缺少就会直接产出错误代码的硬性规则,写进AGENTS.md;仅仅影响代码美观度、属于优化细节的内容,放到docs专题文档。这样可以避免关键约束被海量冗余信息淹没,AI可以快速抓取核心规则,不会因为文档过长耗尽上下文窗口。
二、不使用AGENTS.md,项目会遇到五大典型问题
以Spring Boot+React全栈管控系统业务举例,如果没有配置标准化AI导航文档,AI编码会频繁遇到五类阻碍,也是落地AGENTS.md的核心动因。
第一,前后端上下文割裂。很多老项目后端、前端、私有组件库拆分成为互相独立的Git仓库。AI一次只能加载单一仓库源码,开发前后端联动接口时,开发者要反复复制粘贴业务背景,大量时间消耗在重复描述需求,经常丢失上下文,接口、页面代码配合出现逻辑矛盾。
第二,私有自研组件无法识别。项目内部封装ProTable、ProForm等闭源业务组件,公开训练数据集不存在对应组件样本。AI会直接调用通用开源组件进行替代,产出代码不符合团队组件规范,每一次都需要人工改写组件调用逻辑。
第三,编码架构缺少强制约束。分层架构、异常处理、接口返回封装规则只有口头团队约定。AI会随意混用不同异常类,Controller层直接注入Repository数据库操作对象,出现逆向分层依赖,产出大量违规代码,人工修复工作量巨大。
第四,AI无法自主构建自测。AI完成代码修改之后,不了解项目启动脚本、数据库配置、接口验证方式,不能够自动执行编译构建与接口调用校验。全部修改效果只能依靠开发者人工逐个核对,无法实现夜间无人值守迭代。
第五,项目知识分散无统一入口。架构文档、启动脚本、接口示例散落在聊天记录、本地零散文件,AI不会自动检索读取,每一轮编码对话,开发者都要重复复述项目架构与环境信息。
这些问题本质上,项目的架构约束、编码规则、工程流程只保存在开发人员大脑中,没有沉淀为AI可以自动读取解析的标准化文件。AGENTS.md的价值,就是把隐性团队知识,转化成AI可以自动加载、解析、执行的结构化文档。
三、项目前置改造:存量仓库聚合与monorepo目录规范
想要解决多仓库上下文割裂,分为存量旧项目脚本聚合、新项目直接采用monorepo单体多仓架构两种方案。
3.1 存量分离仓库一键聚合脚本
针对前后端完全分开的存量工程,编写setup‑repos.sh脚本,把前端、组件库代码克隆到主仓库子目录,配置gitignore不纳入版本管理,完全不改动原有CI流水线。
#!/bin/bash
# setup-repos.sh 多仓库一键聚合脚本
mkdir -p frontend
cd frontend
git clone git@xxx:web‑app.git web‑app
git clone git@xxx:pro‑component‑lib.git component‑lib
cd ..
echo "frontend/" >> .gitignore
运行脚本完成聚合:
chmod +x setup-repos.sh
./setup-repos.sh
执行完毕,AI在同一个工作目录就可以同时读取后端、前端、私有组件源码,理解前后端接口和页面联动逻辑。
3.2 新项目monorepo标准目录
全新开发项目,直接使用monorepo目录结构,AGENTS.md放置仓库根目录,指引AI快速定位各个模块源码。
project‑root/
├── AGENTS.md          # AI专属导航文档
├── README.md          # 面向人类开发者阅读
├── Makefile           # 统一质量检测、构建命令入口
├── server/            # Spring Boot后端源码
├── web/               # React前端源码
├── scripts/           # 自动化启动、校验脚本
├── docs/              # 详细专题文档
│   ├── architecture.md
│   └── design‑docs/
└── reference‑projects/# 私有组件、第三方子模块
    ├── pro‑components
    └── gateway‑demo
私有组件、开源中间件通过git submodule引入,AI可以直接读取组件源码,不用依赖滞后的文档。
# 首次拉取全部子模块
git submodule update --init
# 只拉取前端私有组件库
git submodule update --init reference‑projects/pro‑components
四、AGENTS.md完整可复用模板
模板严格控制行数,分为九大模块,包含项目概述、执行命令、前后端架构、硬性编码约定、验证闭环、质量检测、参考项目、文档导航。
# AGENTS.md
## 1.项目概述
本项目为企业资源管控全栈系统,后端Spring Boot3,前端React+TS,monorepo架构,实现资源审批、权限管控、数据统计功能。仓库分为server后端、web前端、参考组件子模块,严格遵守前后端统一交互规范。

## 2.快速命令
#后端一键构建启动,自动加载本地环境配置
./scripts/start‑server.sh
#前端开发服务启动
./scripts/start‑web.sh
#分层架构依赖违规检测
make lint‑arch
#代码格式化自动修复
make format
#单元测试执行
make test
#环境配置存放路径 ~/.project_env,脚本自动加载

## 3.后端架构
后端五层分层:Entity层→Repository层→Service层→Controller层→Common公共层,禁止逆向跨层依赖,详情查阅docs/architecture.md

## 4.前端架构
业务优先使用内部Pro系列组件,禁止直接使用原生表单表格;接口统一封装在src/services;路由集中管理,组件采用Pascal命名,详情docs/design‑docs/frontend‑architecture.md

## 5.硬性编码约定
1.业务异常统一抛出BusinessException,禁止直接使用RuntimeException
2.接口返回体由全局拦截器统一封装,禁止手动构造返回JSON
3.Controller禁止直接注入Repository,必须经由Service中转
4.前端组件禁止写行内样式,统一使用全局样式文件
5.新增接口必须配套curl验证脚本,存放scripts/curl‑demo目录

## 6.开发验证闭环
代码修改完成执行流程:编译构建→启动服务→curl调用接口校验→核对返回数据,curl模板存放在scripts目录,参考docs/design‑docs/api‑verification.md

## 7.质量检测命令
lint‑arch:分层依赖违规检查
lint‑format:代码格式校验
format:自动修复格式
build:项目打包编译
test:单元测试执行

## 8.参考项目规则
私有组件查看reference‑projects/pro‑components;网关逻辑查看gateway子模块,优先读取docs/design‑docs/ref‑*.md文档

## 9.文档导航
全局架构:docs/architecture.md
接口规范:docs/design‑docs/api‑design.md
组件说明:docs/design‑docs/ref‑pro‑components.md
保存完成之后执行软链接,兼容Claude Code:
ln -s AGENTS.md CLAUDE.md
五、配套自动化脚本,实现AI自主修改‑自检‑验证闭环
仅仅编写AGENTS.md文档还不够,还需要配套shell脚本、Makefile,让AI可以直接调用命令,完成环境启动、接口校验、架构违规检测,实现完整自动化工作流。
5.1 后端服务启动脚本 scripts/start‑server.sh
环境变量统一放置用户根目录隐藏文件,不提交版本库,脚本自动加载,关闭残留旧进程,等待服务健康端口就绪。
#!/bin/bash
#加载本地环境变量
source ~/.project_env
#杀死残留java进程
pkill -f java || true
#执行打包编译
mvn package -DskipTests
#后台启动服务
java -jar server/target/*.jar &
#循环健康检测
for i in {
   1..30};do
  curl -s http://127.0.0.1:8080/health > /dev/null
  if [ $? -eq 0 ];then
    echo "服务启动完成"
    exit 0
  fi
  sleep 2
done
echo "服务启动超时"
exit 1
5.2 接口自动化验证脚本 scripts/api‑verify.sh
完成接口登录获取token,调用业务接口,输出返回结果摘要,AI修改接口代码之后直接执行脚本自动校验。
#!/bin/bash
#登录获取token写入临时文件
curl -s -X POST http://127.0.0.1:8080/auth/login \
-H "Content‑Type:application/json" \
-d '{"username":"admin","password":"test123"}' > /tmp/login‑res.json
#提取凭证
TOKEN=$(python3 -c "import json;print(json.load(open('/tmp/login‑res.json'))['data']['token'])")
#调用业务接口
curl -s -X POST http://127.0.0.1:8080/resource/list \
-H "Authorization: Bearer $TOKEN" > /tmp/api‑data.json
#输出结果摘要
cat /tmp/api‑data.json | python3 -c "import json;data=json.load(open('/tmp/api‑data.json'));print('数据总条数:',data['total'])"
5.3 分层架构违规检测脚本 scripts/lint‑deps.sh
扫描全部Java源码,检测Controller层直接导入Repository这类逆向依赖,输出违规文件和错误提示。
#!/bin/bash
find server/src -name "*.java" | while read file;do
  if grep "import.*Repository" "$file" | grep -q Controller;then
    echo "违规文件:$file"
    echo "错误:Controller禁止直接依赖Repository,需要通过Service中转"
  fi
done
5.4 Makefile统一入口
把各类检测、构建命令收拢,降低AI记忆成本,AI只需要调用make指令即可执行全套检查。
lint‑arch:
    bash scripts/lint‑deps.sh
format:
    mvn spotless:apply
build:
    mvn package -DskipTests
test:
    mvn test
六、迭代维护策略与团队协作规范
6.1 问题驱动迭代,拒绝一次性写超大文档
不要追求一次性写出一份完美完整的AGENTS.md。采用问题驱动迭代思路:AI产出代码出现违规问题,就新增对应的硬性约束写入文档,持续迭代,避免文档无限膨胀。
6.2 支持子目录嵌套AGENTS.md
monorepo大型项目,可以在子模块目录放置嵌套的AGENTS.md。AI会自动读取当前目录距离最近的那份配置,子模块特殊规则可以写在子目录文档,根目录存放全局通用约束。
6.3 区分三类文档的阅读对象
README.md:面向人类开发者,写项目介绍、手动快速上手步骤。AGENTS.md:面向AI,存放硬性编码约束、可直接调用的工程命令。docs/**/*.md:人类和AI都可读,存放完整架构、业务流程、组件详细说明。scripts/:人和AI共用自动化脚本。
6.4 工具兼容补充方案
Cursor原生识别AGENTS.md;Gemini CLI需要修改配置指定contextFileName;Aider在配置文件增加read字段加载AGENTS.md;Claude Code优先使用软链接方式兼容。
# .aider.conf.yml示例
read: AGENTS.md
七、落地之后的实际收益
第一,消除多工具维护成本。一份AGENTS.md作为事实来源,通过软链接兼容Claude Code,不用维护多份高度相似的规则文档,修改约束只改动一处。
第二,显著降低AI代码返工。架构分层、异常处理、组件调用等硬性约束被AI读取,大量违规代码在生成阶段就被规避,减少人工修改工作量。
第三,实现AI自主闭环。AI修改代码之后,可以调用脚本完成编译构建、接口自动验证,支持夜间批量迭代任务。
第四,沉淀团队隐性知识。口头约定的编码规范、架构设计转化成可读文档,新入职开发人员和AI都能够快速熟悉项目。
第五,解决monorepo、多仓库上下文割裂问题,AI同时读取前后端、组件源码,更好完成全栈代码生成。
八、总结
AGENTS.md作为面向AI编码智能体的开放标准化导航文档,核心价值是把分散、隐性的项目工程规则转化为AI可自动读取解析的结构化信息,解决多AI工具配置碎片化、AI不理解项目架构、生成代码返工率高等现实痛点。
完整落地流程分为存量仓库改造或者新建monorepo架构、编写精简版AGENTS.md文档、配套自动化shell与Makefile脚本、引入子模块存放私有组件源码四大步骤。严格遵循“地图而非手册”的设计理念,硬性约束放在主文档,长篇业务细节拆分至docs目录。搭配服务启动脚本、接口校验工具、架构违规检测脚本,构建“AI修改代码‑自动质量检测‑接口自主验证”完整开发闭环。
对于同时使用多款AI编程助手的研发团队,AGENTS.md是低成本高收益标准化方案。前期少量的文档与脚本投入,可以长期降低AI编码沟通成本,同时沉淀团队知识库,既提升AI产出代码质量,也可以帮助新人快速上手业务项目。