Agent 默认不跨会话记忆。每轮对话结束后,LLM 不会保留上一轮的上下文信息。
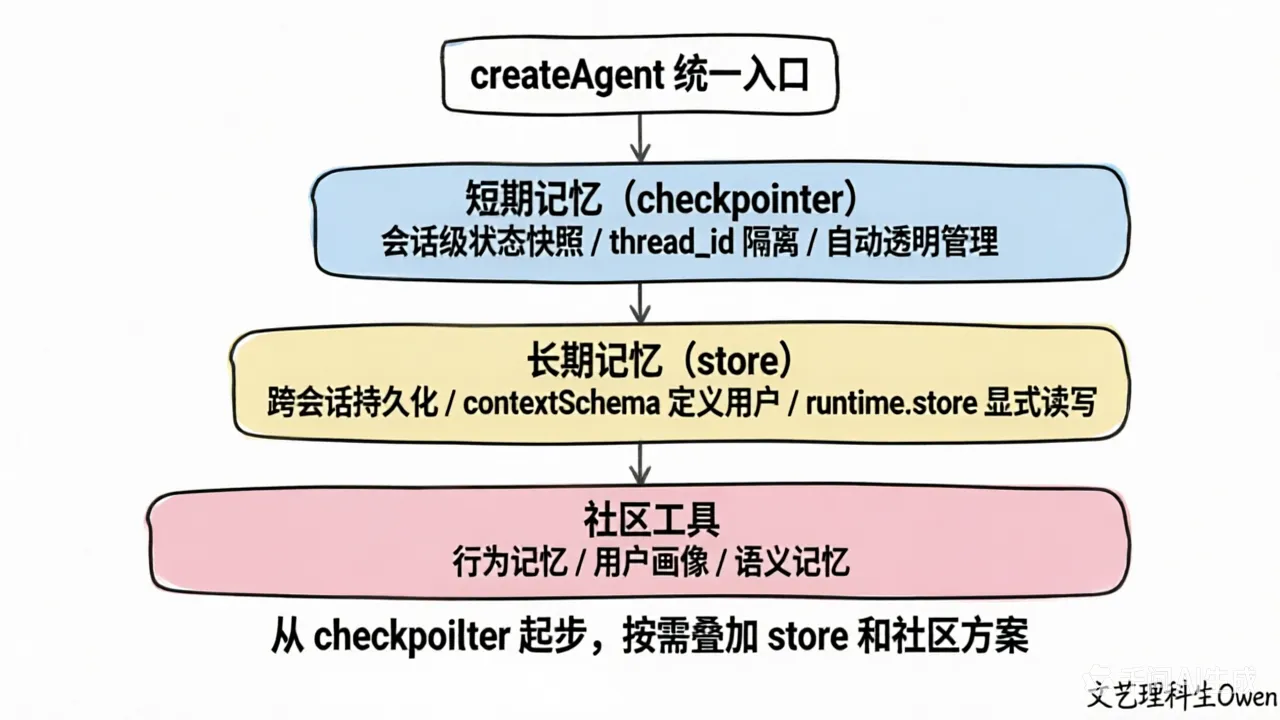
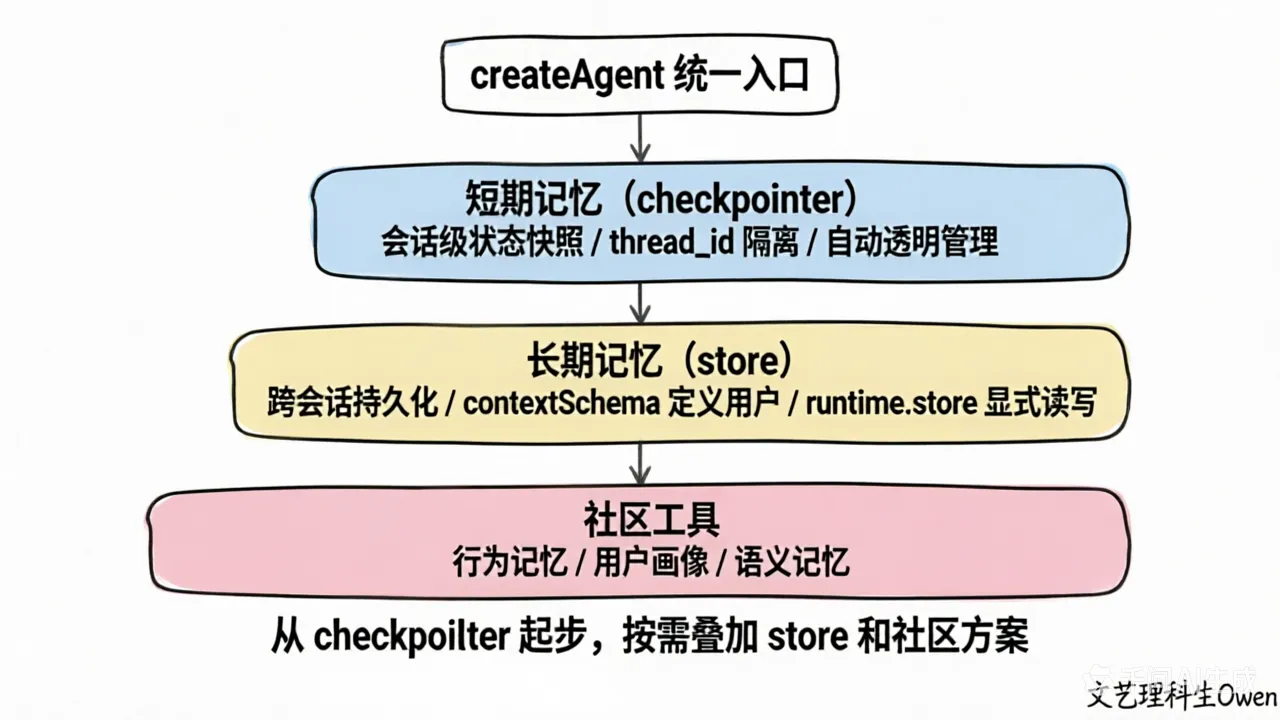
这不是 bug。Agent 的底层设计就是无状态的——每次调用都是一张白纸,LLM 只看你当前传入的消息。让 Agent 有"记忆",意味着在架构层面把状态管理补上。LangChain.js 的答案在 v1 里变得很清晰:createAgent 统一入口,把短期记忆和长期记忆收敛到同一个 API。
从技术实现的角度,可以把 Agent 的记忆需求拆成三层。会话连续性——同一轮对话别断掉,你说过的话下一句 Agent 还能引用。跨会话持久化——明天打开 Agent 它还能认出你是谁、偏好什么。行为记忆——Agent 记住哪些工具调用路径有效、哪些踩过坑,下次自动规避。
这三层正好对应 v1 记忆体系的技术栈:checkpointer 管会话连续性,store 管跨会话持久化,社区工具补充行为记忆。LangChain 的记忆体系从 v0.3 到 v1 经历了一次彻底重写,旧版 ConversationBufferMemory 已经废弃,取而代之的是基于 LCEL 和 LangGraph 的分层架构。接下来逐层展开。
短期记忆:checkpointer 让 Agent 记住"刚才说了什么"
createAgent 是 v1 引入的统一 Agent 创建入口。它的 API 签名很简洁:
createAgent({
    model, tools, systemPrompt?, checkpointer?, store?, contextSchema? })
其中 checkpointer 负责短期记忆。配置 MemorySaver 后,Agent 自动获得会话级消息持久化能力。每次调用时传入同一个 thread_id,Agent 就能在同一会话中保持上下文。
import {
    createAgent, tool } from "langchain";
import {
    MemorySaver } from "@langchain/langgraph";

const agent = createAgent({

  model: "openai:gpt-4o-mini",
  tools: [getWeather],
  systemPrompt: "你是一个友好的助手,用中文回答。",
  checkpointer: new MemorySaver(),
});

const config = {
    configurable: {
    thread_id: "session-001" } };

// 第一轮
await agent.invoke(
  {
    messages: [{
    role: "user", content: "你好!我叫小明,我在北京。" }] },
  config
);

// 第二轮 —— 自动记住上下文
const r2 = await agent.invoke(
  {
    messages: [{
    role: "user", content: "我叫什么名字?" }] },
  config
);
// → "你叫小明"
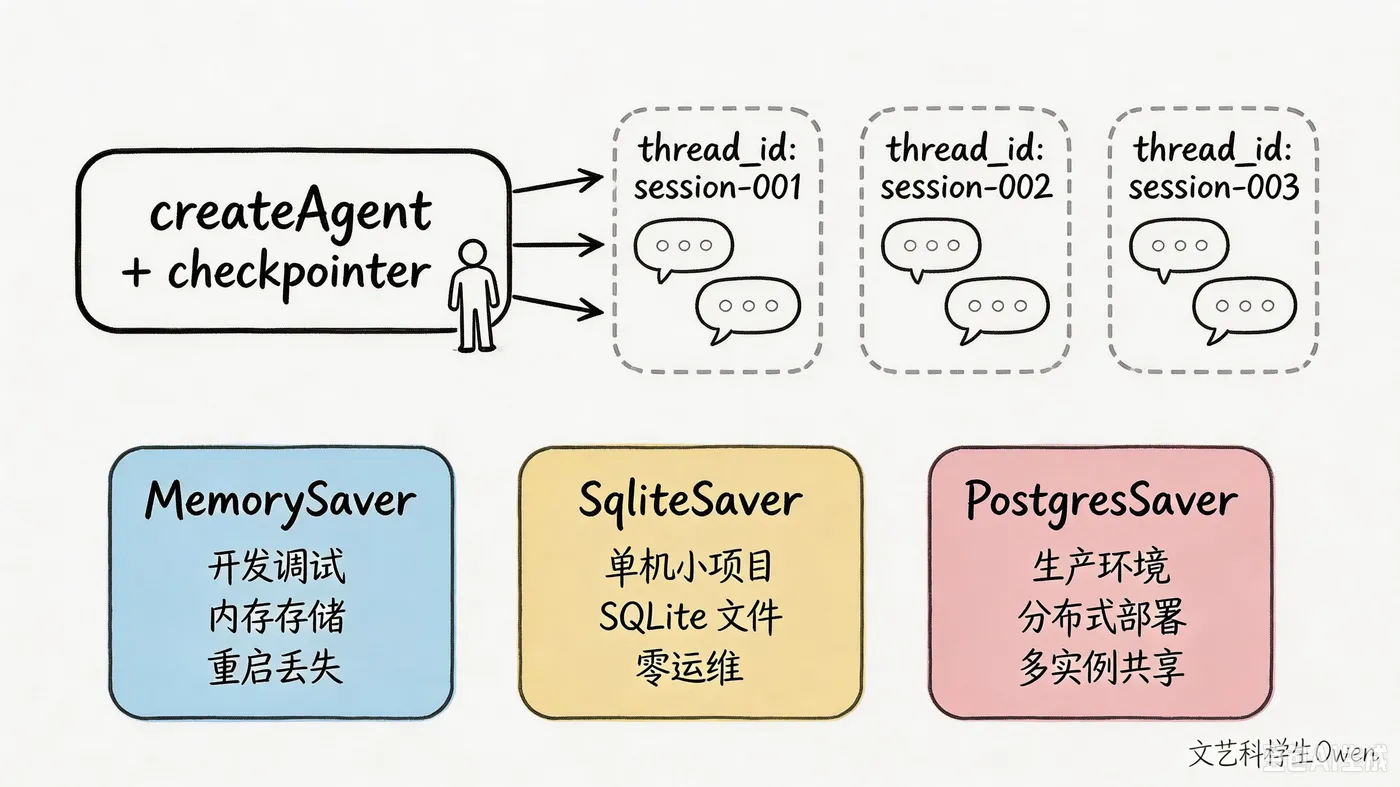
thread_id 是这里的关键。同一个 thread_id 下的所有消息共享一份状态快照;换一个 thread_id,就是全新的上下文。这种隔离机制天然支持多用户场景——每个用户分配独立的 thread_id,互不干扰。你甚至可以让同一个用户在不同话题间切换,每个话题一个 thread_id。
MemorySaver 存的是 Checkpoint——完整的状态快照,包含消息历史、执行步骤和中间变量。也正因如此,服务重启后所有数据丢失,它只适合开发调试。
需要持久化时,checkpointer 还支持另外两种后端。SqliteSaver 把快照写入本地 SQLite 文件,适合单机部署的小型项目——数据不丢,零运维成本,一个文件就能带走全部对话历史。PostgresSaver 则面向生产环境,支持分布式部署和多实例共享状态。如果你的 Agent 服务跑在 Kubernetes 上、后面挂着多个 Pod,PostgresSaver 是生产环境多实例部署的推荐方案。三种后端共享同一个 checkpointer 接口,切换只需修改初始化代码。
长期记忆:store 让 Agent 记住"你是谁"
checkpointer 解决了"刚才说了什么",但管不了"明天还能认出你"。thread_id 重启后状态丢失只是表象,更深层的问题是:checkpointer 的作用域限定在单个会话内,而用户偏好、项目背景、公司信息这些数据天然需要跨会话共享。
store 就是为这个场景设计的。它是应用级的持久化存储,配合 contextSchema 定义用户标识,工具通过 runtime.store 显式读写。与 checkpointer 的"自动透明管理"不同,store 要求开发者显式决定什么时候存、存什么、什么时候取——这给了你更多控制权,但也意味着你得想清楚数据模型。
import {
    createAgent, tool, type ToolRuntime } from "langchain";
import {
    InMemoryStore } from "@langchain/langgraph";

const store = new InMemoryStore();
const contextSchema = z.object({
    userId: z.string() });

const getUserInfo = tool(
  async (_, runtime: ToolRuntime<unknown, z.infer<typeof contextSchema>>) => {

    const userInfo = await runtime.store.get(["users"], runtime.context.userId);
    return userInfo?.value ? JSON.stringify(userInfo.value) : "未找到";
  },
  {
    name: "get_user_info", description: "根据 userId 查找用户信息", schema: z.object({
   }) }
);

const saveUserInfo = tool(
  async ({
    name, city }, runtime: ToolRuntime<unknown, z.infer<typeof contextSchema>>) => {

    await runtime.store.put(["users"], runtime.context.userId, {
    name, city });
    return "已保存";
  },
  {
    name: "save_user_info", description: "保存用户信息", schema: z.object({
    name: z.string(), city: z.string() }) }
);

const agent = createAgent({

  model: "openai:gpt-4o-mini",
  tools: [getUserInfo, saveUserInfo],
  checkpointer: new MemorySaver(),
  store,
  contextSchema,
});
contextSchema 定义了什么信息标识一个用户(这里是 userId),Agent 在每次调用时从 config 中提取上下文,工具内部通过 runtime.context 即可拿到。store 的数据键采用"命名空间 + 键"的二级结构——比如 ["users"], userId——方便按业务领域组织数据。
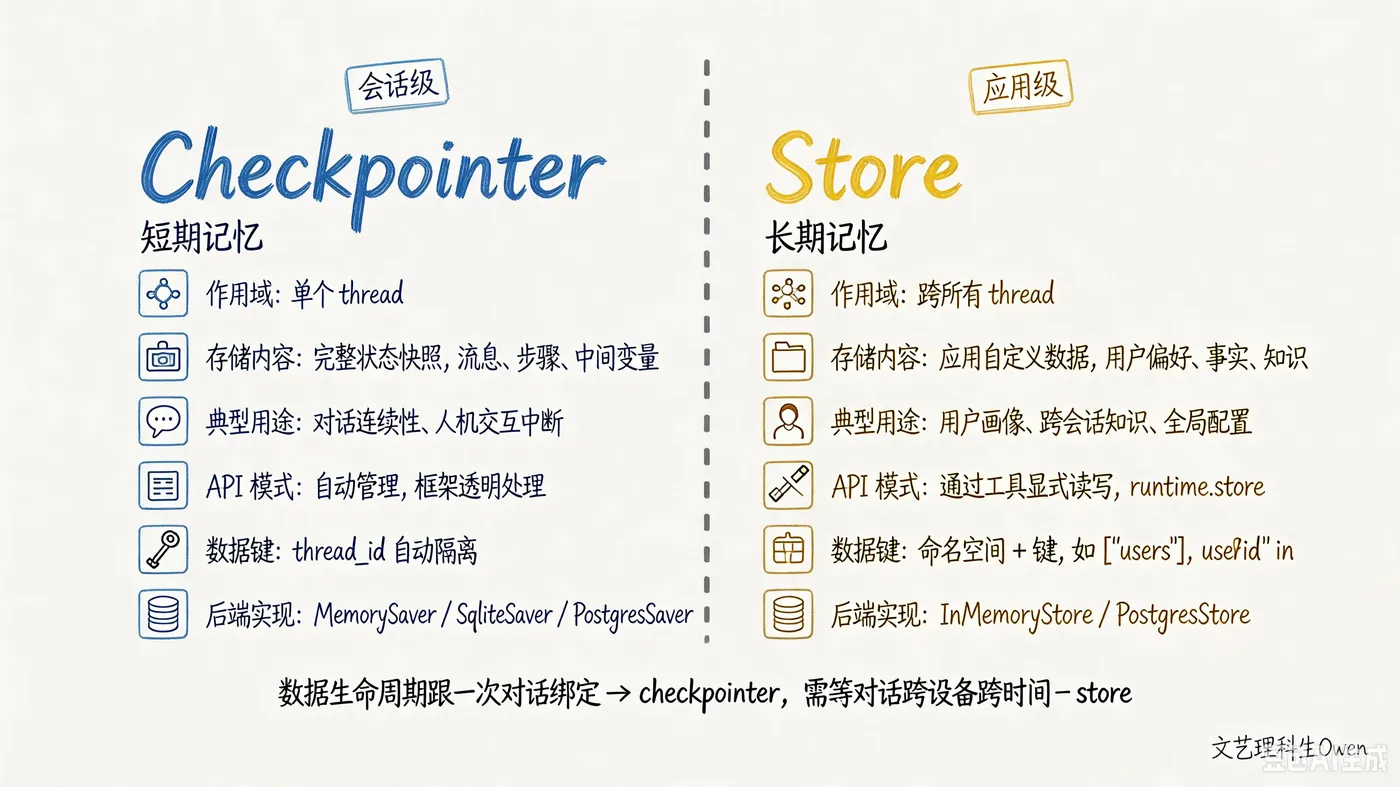
Checkpointer 和 store 的分工很明确,但初学者容易混淆。一张表说清楚:
| 维度 | Checkpointer(短期记忆) | Store(长期记忆) |
|---|---|---|
| 作用域 | 单个 thread(会话级) | 跨所有 thread(应用级) |
| 存储内容 | 完整状态快照(消息、步骤、中间变量) | 应用自定义数据(用户偏好、事实、知识) |
| 典型用途 | 对话连续性、人机交互中断 | 用户画像、跨会话知识、全局配置 |
| API 模式 | 自动管理,框架透明处理 | 通过工具显式读写(runtime.store) |
| 数据键 | thread_id 自动隔离 | 命名空间 + 键(如 ["users"], userId) |
| 后端实现 | MemorySaver / SqliteSaver / PostgresSaver | InMemoryStore / PostgresStore |
一个判断标准:如果数据生命周期跟一次对话绑定,用 checkpointer;如果数据需要跨对话、跨设备、跨时间存在,用 store。
超长对话:当上下文膨胀到 LLM 吃不消
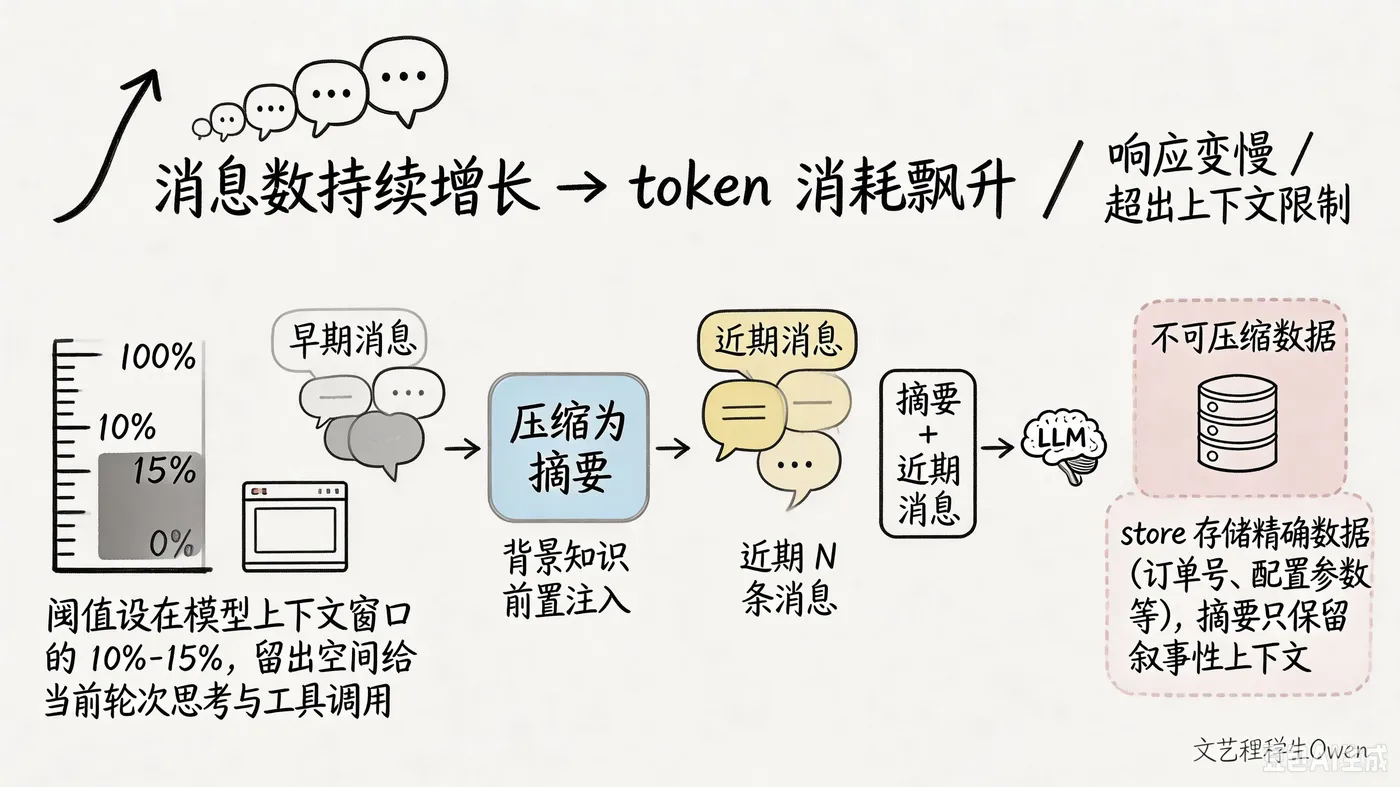
checkpointer 虽然自动记录所有历史消息,但它不会帮你做任何裁剪。一轮对话跑到几百条消息之后,上下文窗口会被塞满,响应变慢、token 消耗飙升,甚至超出模型上下文限制直接报错。对于 Coding Agent 这类需要长时间密集交互的场景,这个问题尤其突出。
这种场景下需要在 checkpointer 之上叠加一层摘要策略。核心思路是:当对话历史超过某个 token 阈值时,自动将早期消息压缩为摘要,保留近期消息的完整内容,摘要部分作为"背景知识"前置注入。具体实现上,可以在每次状态写入时检查 token 使用量,一旦超过阈值就对历史消息执行摘要压缩。保留策略通常是"近期 N 条消息 + 摘要"的组合——既保留最近对话的细节,又不会丢失早期的关键信息。
触发阈值的选择取决于你使用的模型上下文窗口。建议将阈值设在窗口的 10%-15% 以内,留出足够空间给当前轮次的思考和工具调用。
要注意的是,摘要本身会丢失信息。如果对话中涉及精确数据——比如用户报了一个订单号、一段配置参数——这些信息被压缩进摘要后可能变形。一个实用的做法是,在 store 中单独存储这类"不可压缩"的结构化数据,摘要只保留叙事性的上下文。
社区工具推荐:当内置方案不够用
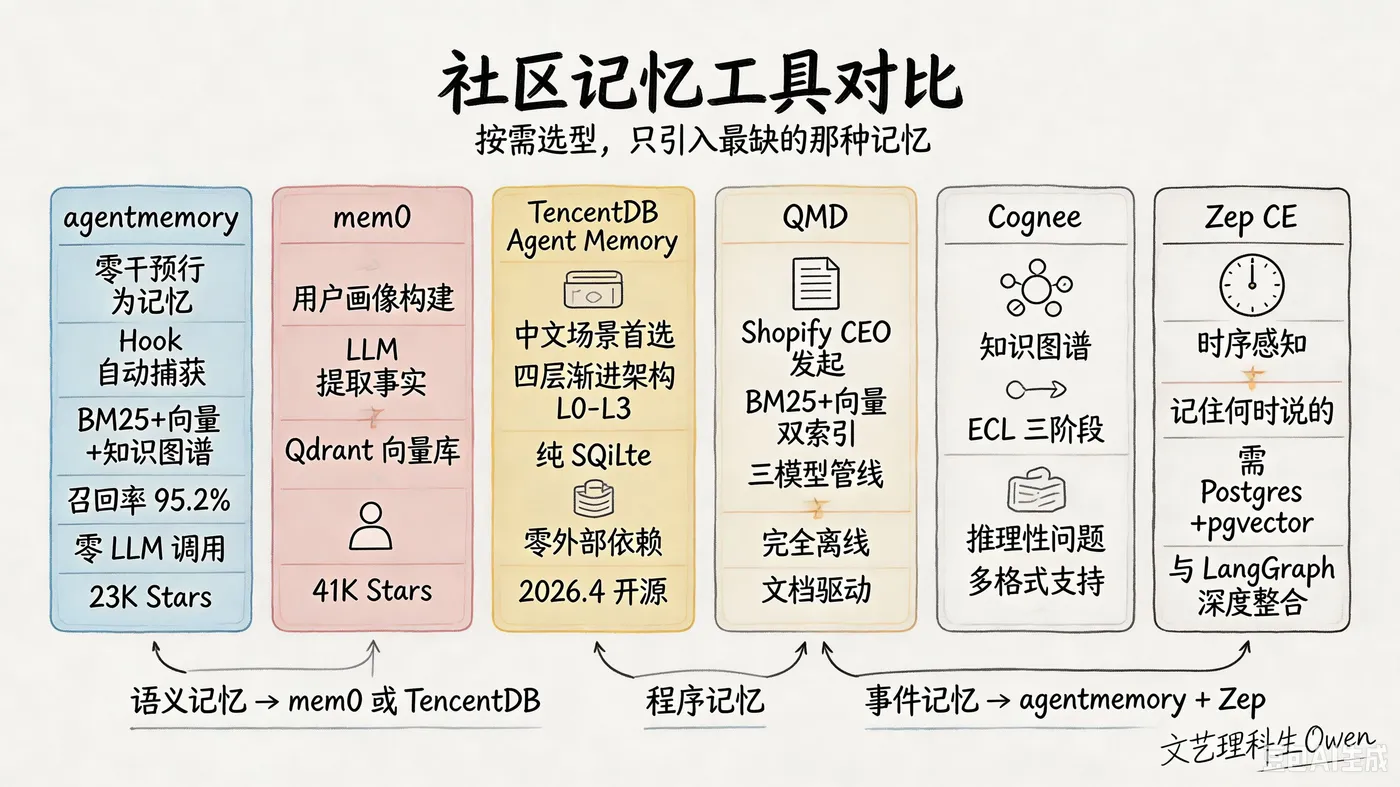
createAgent 的 checkpointer + store 组合覆盖了大部分基础记忆需求,但在行为记忆和用户画像构建这两个方向上,社区有一些更专业的轮子。
agentmemory(GitHub: rohitg00/agentmemory,MIT 协议,23,000+ Stars)是目前最推荐的 Coding Agent 行为记忆方案。它的核心思路是零干预——通过 Hook 机制自动静默捕获所有 Agent 工具调用,存入本地 SQLite。
检索时走 BM25 全文 + 向量语义 + 知识图谱遍历,经 RRF 融合排序,据项目方公布的基准测试,召回率达 95.2%,远超同类方案 mem0 的 68.5%。关键是不需要调用任何 LLM 来写入或检索记忆,这对高频 Coding Agent 场景来说能省下可观的 token 成本。通过 MCP 协议接入,一行命令即可:npx @agentmemory/mcp。零 LLM 调用意味着没有网络往返开销,记忆读写成本远低于调用 LLM 的方案。
mem0(GitHub: mem0ai/mem0,Apache 2.0,41,000+ Stars)面向 LLM 应用的用户画像构建,从对话中自动提取结构化事实。但每次写入记忆都需要调用 LLM,部署还需要 Qdrant 或 Chroma 向量数据库。如果你的场景是面向 C 端用户的聊天产品,mem0 的用户画像提取能力很对口;但 Coding Agent 场景下,agentmemory 的零 LLM 调用模式显然更经济。
TencentDB Agent Memory(GitHub: Tencent/TencentDB-Agent-Memory,Apache 2.0,2026 年 4 月开源)是中文场景的首选。它采用四层渐进式记忆架构:L0 原始对话、L1 原子记忆、L2 场景分块、L3 用户画像。纯 SQLite,零外部依赖,对中文分词和语义理解做了针对性优化,信创和私有化部署场景友好。L1 层需要调用 LLM 做记忆提取,但整体架构比 mem0 更轻量。如果你需要在国内服务器上部署、且用户交互以中文为主,TencentDB Agent Memory 是中文场景最自然的选择。
QMD 由 Shopify CEO 发起,是 OpenClaw 生态的核心工具,对 workspace 下的 Markdown 文件建立 BM25 + 向量双重索引,经 Reranker 融合排序,三模型管线(Embedding + Reranker + Query Expansion)完全离线,约 2.3GB,适合文档驱动的记忆场景。
Cognee 专注知识图谱,ECL 三阶段(Extract 识别实体 → Cognify 推断关系 → Load 写入图数据库),回答"A 和 B 有什么关系"这类推理性问题,支持 PDF、DOCX、音频、图片等多种格式。
Zep CE 的独特卖点是时序感知——不仅记住"说了什么",还记住"什么时候说的、是否已被更新覆盖",2026 年与 LangGraph 深度整合,但需要 Postgres + pgvector,部署较重。
如果对照 LangMem 官方提出的三类记忆框架(语义记忆存事实、程序记忆存行为规则、事件记忆存 Few-shot 示例),社区工具的对应关系大致是:语义记忆匹配 mem0 或 TencentDB Agent Memory,程序记忆匹配 agentmemory,事件记忆匹配 agentmemory 配合 Zep。
选型不要求全。关键在于你的 Agent 最缺哪种记忆——是记不住用户偏好,还是记不住工具调用的经验——然后只引入对应的那一款。
三层搭配:从最小启动到生产就绪
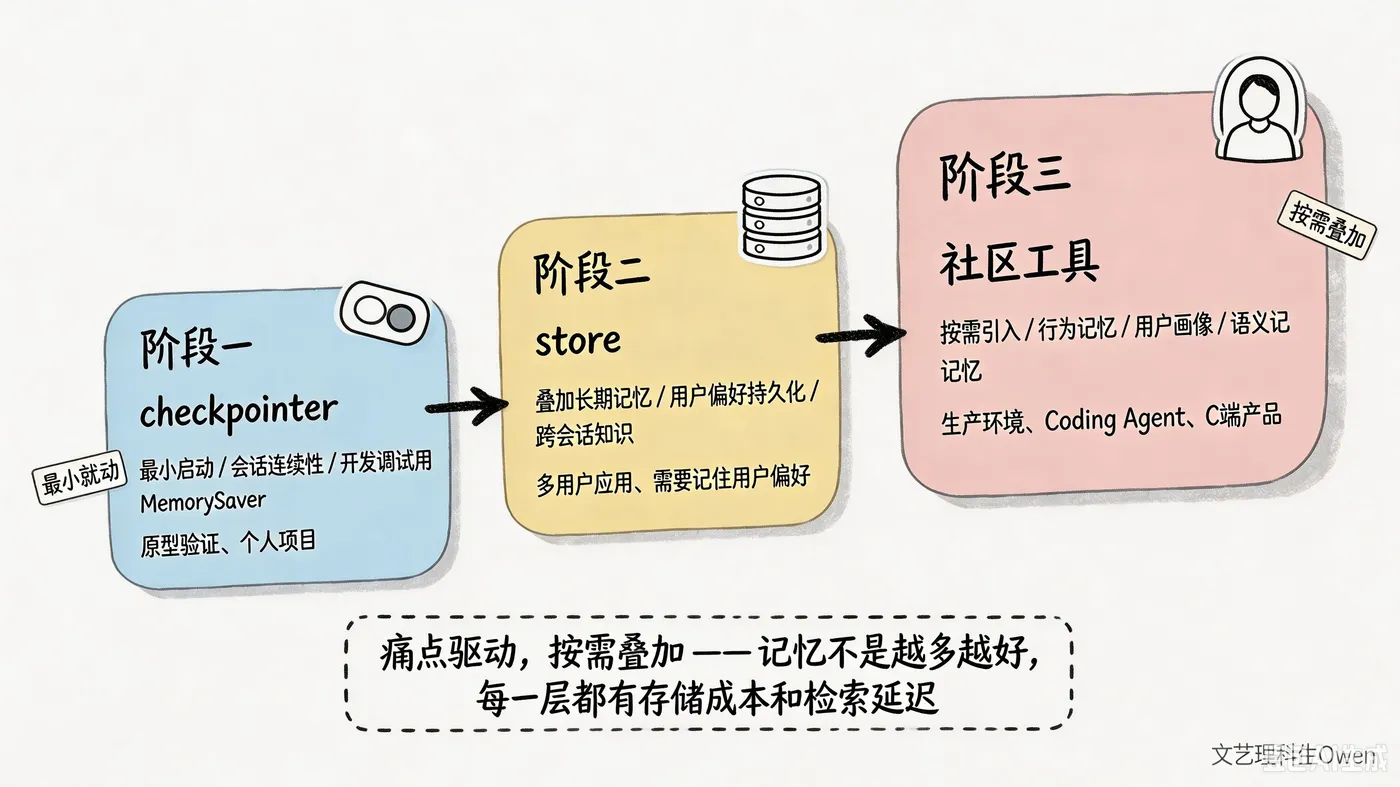
从 checkpointer 起步,按需叠加 store 和社区方案。
记忆不是越多越好。每一层记忆都有它的存储成本和检索延迟,盲目堆叠只会让 Agent 变慢、变贵、变难调试。从最小集合开始,被用户真正抱怨的痛点驱动着往上加,才是务实的策略。