文章首发于: https://feinterview.poetries.top/blog/vercel-react-best-practices
你是否也有这样的经历:页面卡了,第一反应是打开组件加一圈 useMemo、useCallback、memo(),加完用 Profiler 一测,首屏该慢还是慢。问题出在哪?出在优化的优先级排反了。
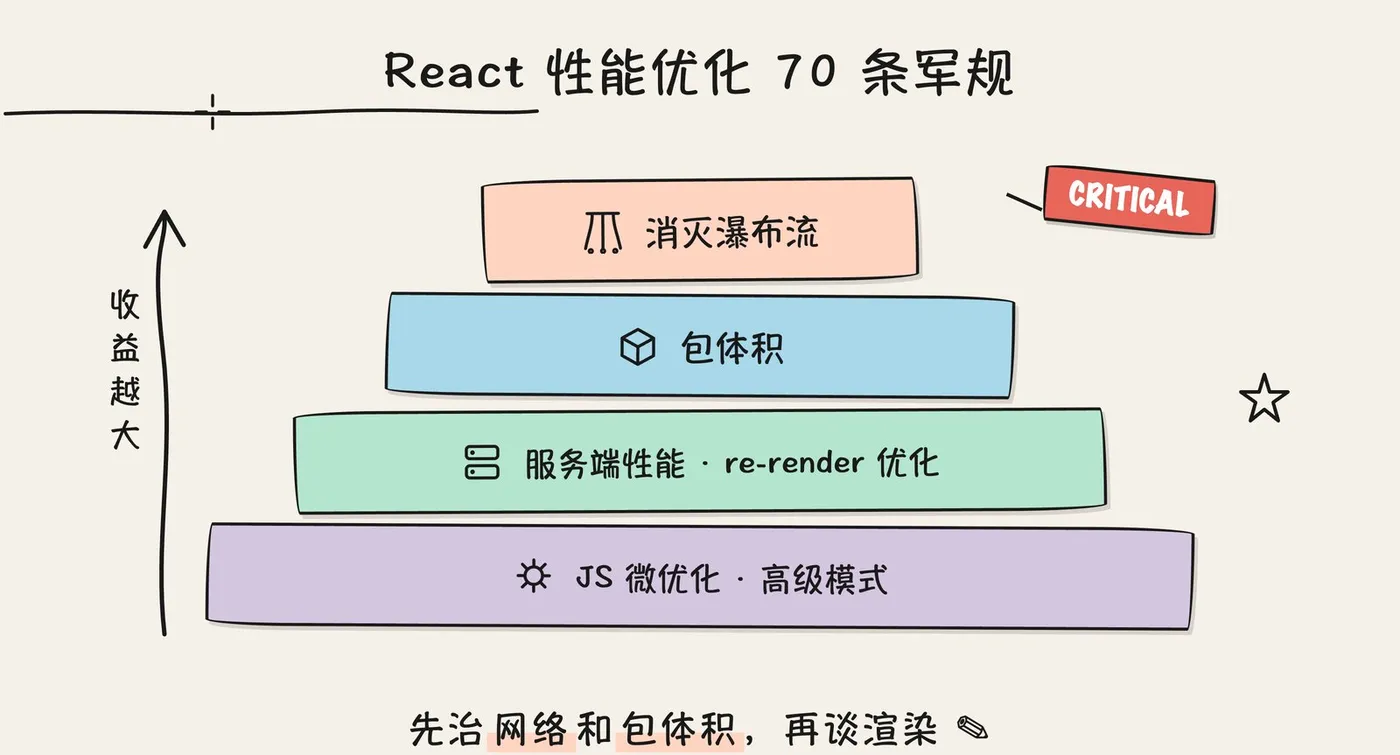
Vercel 工程团队在 2026 年初开源了一份 React Best Practices(vercel-react-best-practices),把内部沉淀的 70 条 React / Next.js 性能规则整理成机器可读的 skill,喂给 AI 编码工具做代码生成和 review 的依据,人读同样受益。这份清单最值钱的不是某条具体技巧,而是它给所有优化手段按影响力排了序:消灭请求瀑布流和砍包体积是 CRITICAL,大家最爱写的 re-render 优化只排在 MEDIUM,useMemo 的部分用法甚至被列为反模式。
我把整份规则读完,这篇文章按 ROI 从高到低精讲其中最有实战价值的部分,附原版代码对比和使用边界。
在本篇文章中,我们将从浅入深,和大家一起学习以下知识:
- 这份清单的 8 大类规则与优先级全景
- CRITICAL 级第一名:消灭请求瀑布流的 6 种手法
- CRITICAL 级第二名:包体积优化,barrel import 一条就能省 200-800ms
- HIGH 级:服务端性能,
RSC时代最容易踩的并发与序列化坑 - MEDIUM 级:re-render 优化的正确姿势,以及哪些
useMemo应该删掉 - 低优先级但常考的
JavaScript微优化速查表 - 怎么把这份规则接入你的
AI编码工作流
一、先看全景 70 条规则怎么分层
清单按影响力分 8 类,优先级从上到下递减:
| 优先级 | 类别 | 影响力 | 规则前缀 |
|---|---|---|---|
| 1 | 消灭瀑布流 | CRITICAL | async- |
| 2 | 包体积优化 | CRITICAL | bundle- |
| 3 | 服务端性能 | HIGH | server- |
| 4 | 客户端数据获取 | MEDIUM-HIGH | client- |
| 5 | re-render 优化 | MEDIUM | rerender- |
| 6 | 渲染性能 | MEDIUM | rendering- |
| 7 | JavaScript 微优化 | LOW-MEDIUM | js- |
| 8 | 高级模式 | LOW | advanced- |
这个排序背后的逻辑很硬:一次串行的网络往返是几十到几百毫秒,一次多余的 re-render 通常不到一毫秒。瀑布流每多一层就多付一次完整网络延迟,而你精心 memo 掉的那次渲染,用户根本感知不到。所以官方原话是「Waterfalls are the #1 performance killer」——先治网络和包体积,再谈渲染。
下面按这个顺序逐层拆。
二、消灭瀑布流 每一个多余的await都在烧钱
2.1 Promise.all 是及格线
最基础的一条:没有依赖关系的异步操作绝不串行。
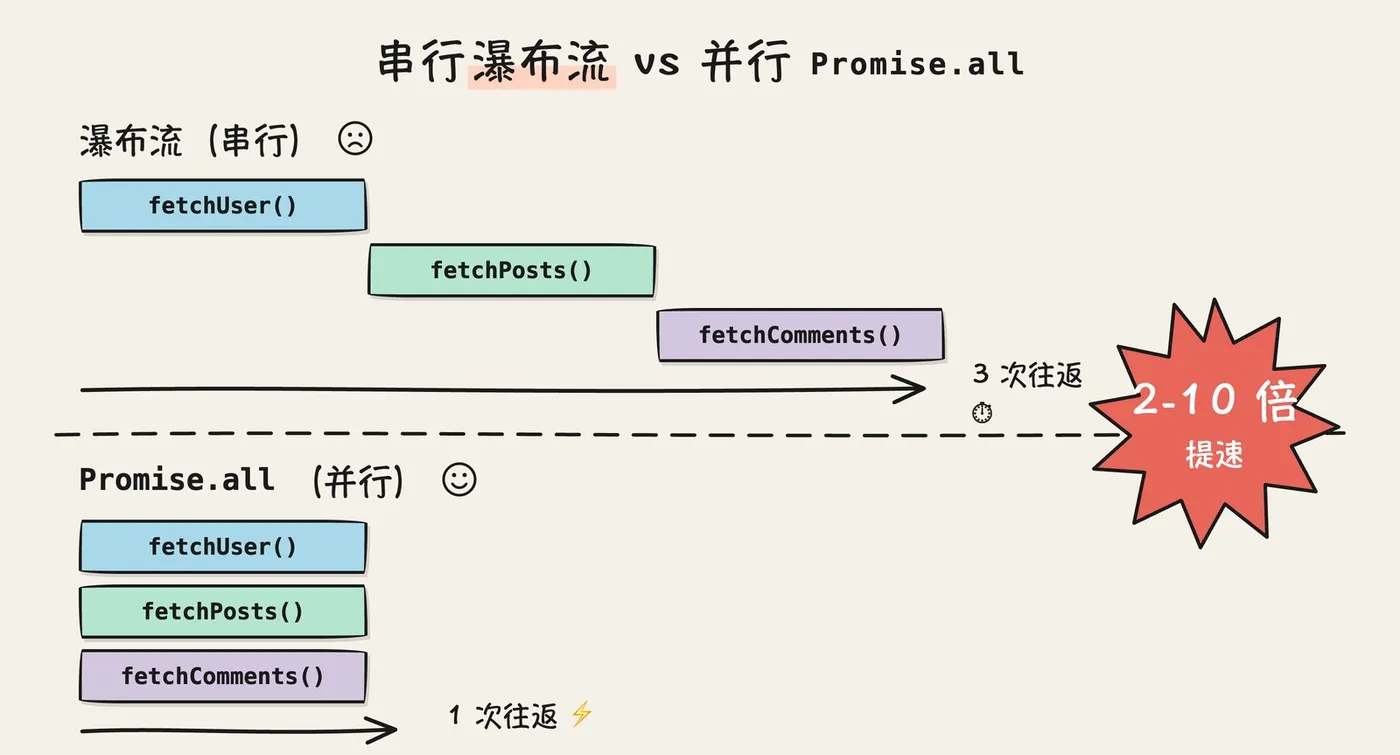
这段是反面示例,三个请求串成三次往返:
const user = await fetchUser()
const posts = await fetchPosts()
const comments = await fetchComments()
改成并行后只付一次往返的时间,官方给的量化收益是 2-10 倍:
const [user, posts, comments] = await Promise.all([
  fetchUser(),
  fetchPosts(),
  fetchComments()
])
2.2 部分依赖场景 先启动再await
真正拉开差距的是「半依赖」场景:profile 依赖 user,但 config 谁都不依赖。多数人会写成两段 Promise.all,结果 profile 白白等了 config。正确做法是先创建所有 promise,最后统一 await:
const userPromise = fetchUser()
const profilePromise = userPromise.then(user => fetchProfile(user.id))

const [user, config, profile] = await Promise.all([
  userPromise,
  fetchConfig(),
  profilePromise
])
这样 config 和整条 user → profile 链是并行的,每个任务都在依赖就绪的第一时间启动。同样的思路用在 API 路由里:auth() 和 fetchConfig() 互不依赖,就先把两个 promise 都启动,再按需 await,不要让 config 排在 auth 后面白等一轮。
2.3 defer await 把等待推进真正用到的分支
另一条容易忽视的规则:await 应该出现在用到结果的分支里,而不是函数开头。比如权限校验,如果 resource 不存在就直接返回 404,那 fetchPermissions 这次请求就完全不该发生。把 await 后移,走「资源不存在」快路径的请求一次网络开销都不用付。同理,flag && cheapCondition 这种组合条件,先判本地的 cheapCondition,为 false 就压根不去 await 远端的 flag。
2.4 Suspense 让骨架先上屏
页面级组件里 await 一把梭,整个布局都会被这次取数拖住。官方建议把取数下沉到子组件、外层包 Suspense:
function Page() {
  return (
    <div>
      <Sidebar />
      <Suspense fallback={<Skeleton />}>
        <DataDisplay />
      </Suspense>
      <Footer />
    </div>
  )
}

async function DataDisplay() {
  const data = await fetchData() // 只阻塞这一块
  return <div>{data.content}</div>
}
Sidebar 和 Footer 立即上屏,数据流式补进中间区域。注意清单里也写明了不适用场景:影响布局定位的关键数据、首屏 SEO 内容、以及快到不值得付出布局抖动代价的小请求。关于 Suspense 与并发渲染的底层机制,可以搭配我之前写的 React 18 并发机制详解 一起看。
三、包体积 一行import偷走你200-800ms
bundle- 类里最触目惊心的是 barrel import 这条。所谓 barrel 文件就是库入口那个 export * from ... 的 index.js,流行的图标库、组件库入口动辄上万个 re-export:
import { Check, X, Menu } from 'lucide-react'
// 实际加载 1583 个模块,dev 慢 ~2.8s,冷启动多付 200-800ms

import { Button, TextField } from '@mui/material'
// 实际加载 2225 个模块
你以为 tree-shaking 会救你,但清单里点破了:库被标为 external 时打包器根本不做优化;要 tree-shake 就得全量分析模块图,build 时间又爆了。解法有两个:Next.js 13.5+ 直接靠内置的 optimizePackageImports,代码不用改;其他项目走子路径直连 import Button from '@mui/material/Button'。官方给的收益是 dev 启动快 15-70%、构建快 28%、冷启动快 40%。受影响的常见库包括 lucide-react、react-icons、lodash、date-fns、rxjs 等——检查一下你的项目,大概率中招。
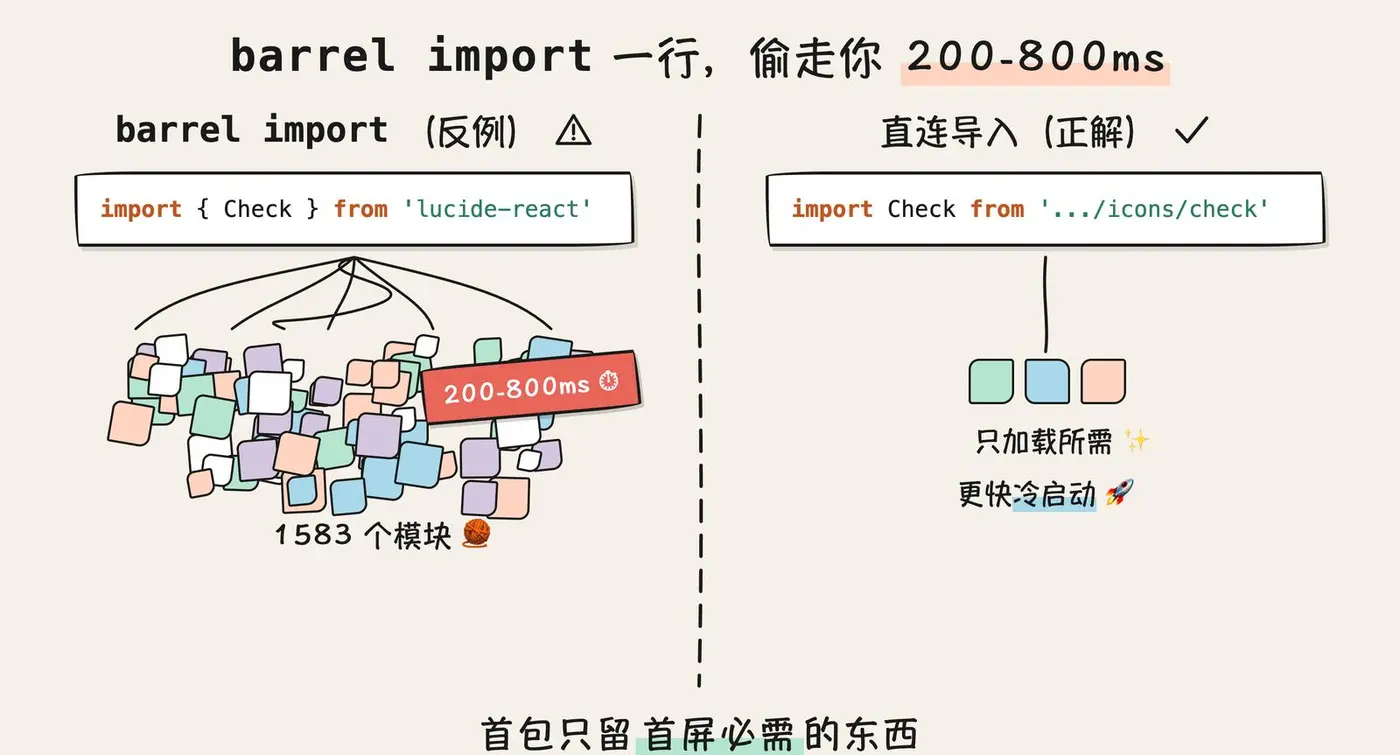
这一类还有三条高价值规则,逻辑一以贯之——首包只留首屏必需的东西:
- 重组件动态加载:
Monaco、图表库这种 300KB 起步的大件用next/dynamic按需拉,直接改善TTI和LCP - 第三方库延后:analytics、错误上报不阻塞交互,
ssr: false等 hydration 完了再加载 - 按用户意图预加载:按钮
onMouseEnter/onFocus时void import('./monaco-editor'),等用户真点开时模块已经在缓存里,体感零延迟
另外注意动态导入要保持路径静态可分析:import(SOME_MAP[key]) 这种写法打包器猜不出范围,只能把可能的文件全打进来;改成显式的 { home: () => import('./pages/home') } 映射表,产物立刻收窄。
四、服务端性能 RSC时代的新坑
server- 类 10 条规则里有三条是 Next.js App Router 项目几乎必踩的坑。
第一坑:Server Action 忘了鉴权。 "use server" 函数会被编译成公开 endpoint,middleware 和页面级守卫拦不住直接调用。所以每个 action 内部都必须自带 verifySession() + 权限校验,这条被标为 CRITICAL——它不是性能问题,是安全事故。
第二坑:模块级变量存请求数据。 服务端并发渲染时模块作用域是进程共享的,let currentUser = null 这种写法会让 A 用户的数据串到 B 用户的响应里。请求级数据一律走 props 或 React.cache(),模块级只放不可变的静态资源。
第三坑:RSC 边界序列化超载。 Server/Client 边界上所有 props 都会被序列化进 HTML,50 个字段的 user 对象只用一个 name 也全量传输。清单的建议是只传用到的字段,并且不要在服务端做 .filter() / .toSorted() 再和原数组一起传——序列化按引用去重,新引用意味着同一份数据传两遍。
取数方面还有两条组合拳值得记住。React.cache() 做请求内去重(数据库查询、鉴权这类非 fetch 的异步操作收益最大,fetch 本身 Next.js 已自动去重);跨请求就上 LRU 缓存。嵌套取数则要把依赖链塞进每个 item 自己的 promise 里:
// 反例:一个慢 chat 卡住全部 author 请求
const chats = await Promise.all(chatIds.map(id => getChat(id)))
const authors = await Promise.all(chats.map(c => getUser(c.author)))

// 正解:每个 item 独立成链,互不阻塞
const authors = await Promise.all(
  chatIds.map(id => getChat(id).then(chat => getUser(chat.author)))
)
最后是 after():日志、埋点、通知这类副作用放进 after(() => ...),响应先发出去,副作用在后台跑。这些能力在 Next.js 15 之后已经稳定,相关背景我在 Next.js 15 如何让 React 应用更快 里写过。
五、re-render优化 一半的useMemo本该删掉
到了大家最熟的领域,清单反而在泼冷水。15 条 rerender- 规则里,我认为最值得内化的是这四条。
第一条:能推导就别存状态。 fullName 能从 firstName + lastName 算出来,就直接在 render 里算,不要 useState + useEffect 同步——那会多一轮渲染还容易状态漂移。这条对应 React 官方文档著名的《You Might Not Need an Effect》。
第二条:简单表达式别包 useMemo。 这是清单里少见的「反 memo」规则:
// 反例:hook 调用 + 依赖比较的开销超过表达式本身
const isLoading = useMemo(() => {
  return user.isLoading || notifications.isLoading
}, [user.isLoading, notifications.isLoading])

// 正解:直接算
const isLoading = user.isLoading || notifications.isLoading
useMemo 本身有依赖数组比较的成本,包一个布尔运算纯属倒贴。memo 的对象应该是真正昂贵的计算,而不是所有计算。
第三条:绝不在组件内定义组件。 每次父组件 render 都会产生一个新的组件类型,React 视为不同组件直接整棵重挂载——输入框失焦、动画重放、useEffect 反复执行,全是它的症状。想少传 props 不是理由,老老实实把子组件提到模块顶层。
第四条:functional setState 换稳定回调。 setItems([...items, newItem]) 迫使 useCallback 依赖 items,回调随状态一起重建;写成 setItems(curr => [...curr, newItem]) 后依赖数组清空,回调终身稳定,还顺手消灭了 stale closure。
其余规则可以归成一句话:高频瞬时值用 useRef(鼠标坐标、interval 句柄),非紧急更新用 startTransition / useDeferredValue,交互逻辑放事件处理器而不是 effect。 值得注意的是清单在多处标注:如果项目开了 React Compiler,手动 memo / useMemo 大部分可以不写了——这也是 React 19 新特性 之后官方一直在推的方向。
六、渲染与JS微优化 速查表
rendering- 和 js- 两类偏「知道就能用」,我整理成速查表:
| 规则 | 一句话要点 |
|---|---|
content-visibility |
长列表项加 content-visibility: auto,千条消息跳过 990 条的布局绘制 |
| 条件渲染用三元 | {count && <Badge />} 在 count=0 时会渲染出字符 0,用 count > 0 ? ... : null |
| 脚本加 defer/async | Next.js 里用 next/script 的 strategy,别裸写阻塞渲染的 script 标签 |
| 资源提示 API | preconnect / preload / preinit 在 RSC 里提前建连、拉字体 |
| 主题防闪烁 | 依赖 localStorage 的 UI 用内联同步脚本在 hydration 前改 DOM,既不炸 SSR 也不闪默认值 |
| 动画包一层 div | 很多浏览器对 SVG 元素的 CSS 动画不走硬件加速,动外层 div |
| 布局抖动 | 读写分离:批量写样式再统一读 getBoundingClientRect,避免强制同步回流 |
| 重复查找上 Map | 双千级数组的 .find() 嵌套是百万次操作,先建 Map 降到两千次 |
toSorted() 代替 sort() |
sort() 原地修改会污染 props/state,React 下是隐性 bug 源 |
| min/max 别排序 | 单次遍历 O(n) 就够,sort 是 O(n log n) 纯浪费 |
| 非关键任务闲时跑 | 埋点、预取塞进 requestIdleCallback,别挤占交互主线程 |
这一类单条收益不大,但它们经常出现在 code review 和面试里,属于「便宜的好习惯」。
七、把这份清单接进AI编码工作流
这份规则从第一天起就是给 AI 用的——官方在文档开头写明「mainly for agents and LLMs」。落地方式很简单:
- 装成 skill:
Claude Code/Codex等工具把vercel-react-best-practices装进 skills 目录,写React代码时自动按规则生成,review 时按规则挑错 - 人读薄版:
SKILL.md是 70 条规则的一句话索引,通读只要十分钟;AGENTS.md是带完整代码对比的全量版,适合按需精读 - 按优先级还债:存量项目先查瀑布流(搜索连续
await)、再跑 bundle analyzer 查 barrel import 和大依赖,最后才轮到组件层的 memo 整治
我的实际体验是:把 skill 装上之后,AI 生成的取数代码默认就是「先启动 promise 再统一 await」的形态,比事后人肉 review 省力得多。
总结
Vercel 这份 React 性能优化清单最大的贡献是把「优化什么」变成了一个有明确优先级的工程问题:
- CRITICAL:消灭请求瀑布流(
Promise.all、defer await、Suspense流式)、砍首包体积(barrel import、动态加载),这两类动辄 2-10 倍收益 - HIGH:服务端注意 Server Action 鉴权、模块状态隔离、
RSC序列化最小化,React.cache+LRU做两级去重 - MEDIUM:re-render 优化讲究姿势——派生值直接算、简单表达式不 memo、组件不嵌套定义、setState 用函数式
- LOW:
JS微优化当习惯养,别当主战场
如果你只有半小时,读完本文第二、三节并检查自己项目里的串行 await 和 barrel import,就能拿走这份清单 80% 的收益;全量精读 AGENTS.md 大约需要两小时。