GLM 5.2是一款753B混合专家架构开源旗舰大模型,原生支持百万Token超长上下文、复杂代码工程、长周期自主智能体任务,完整支持本地、私有云自托管部署。自托管模式能够实现全部业务数据不出环境、企业自定义推理调度、全链路操作私有化审计,对数据安全管控有严格要求的研发、金融、政企团队具备不可替代价值。整套落地链路包含硬件分级选型、多量化权重存储配置、vLLM/SGLang双推理框架部署、长期使用成本盈亏测算四大核心模块,同时可搭配轻量应用服务器部署OpenClaw、Hermes两类主流AI智能体,结合百炼Token Plan云端订阅算力构建混合AI架构,兼顾私有化数据安全与云端灵活弹性,本文完整拆解全流程实操细节、场景区分、成本核算与接入规范。
一、GLM 5.2自托管硬件分级选型与存储配置
GLM 5.2庞大参数规模决定硬件、存储配置直接影响推理吞吐、稳定性与并发承载能力,需根据量化精度、业务并发规模匹配对应硬件集群,同时配套高速存储承载模型权重文件。
1. 不同量化方案权重存储需求
模型权重体积随量化精度大幅变化,是存储规划首要参考指标:BF16原生高精度权重约1.5TB,完整保留全部参数精度,适合极致推理质量的核心业务;FP8量化版本压缩至750GB,平衡推理精度与硬件负载,为绝大多数企业生产首选;Q4_K_M中等量化体积376GB,适合预算有限中小型团队;UD-IQ2轻量量化仅241GB,推理速度偏低,仅适合个人本地调试场景。无论哪种量化方案,服务器均需配置1TB及以上高速SSD,保障权重快速加载、KV缓存稳定读写,避免推理中断、加载超时问题。
阿里云部署AI Agent:OpenClaw/Hermes Agent全网最简单,只需两步,详情👉访问阿里云OpenClaw/Hermes一键部署专题页面了解。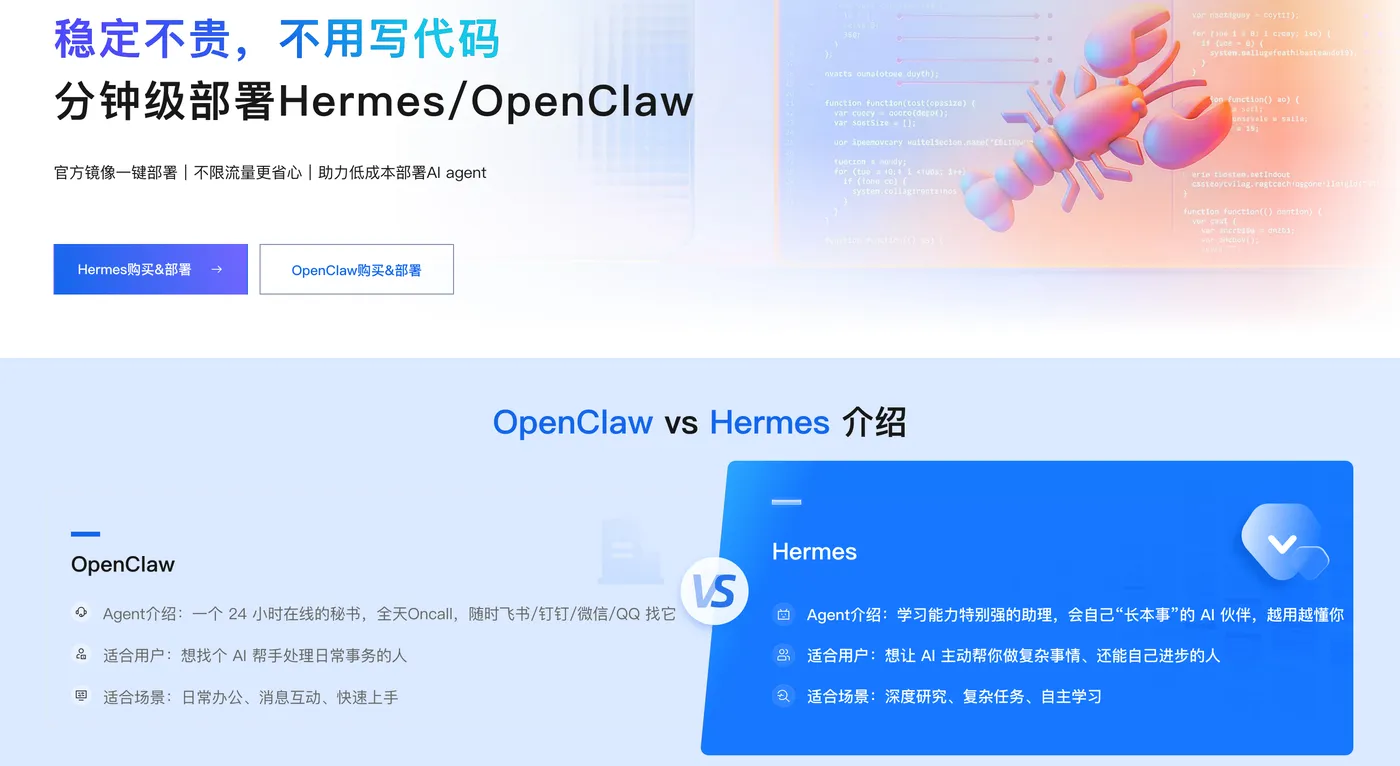
Token Plan Token 最便宜/支持多模型切换:👉访问订阅阿里云百炼Token Plan AI大模型服务 。支持多模型切换,用于多模态模型灵活调用,实现多模型、多工具、多场景下的额度共享与统一管理,兼顾灵活性、稳定性与安全性,大幅降低企业使用大模型的门槛与成本。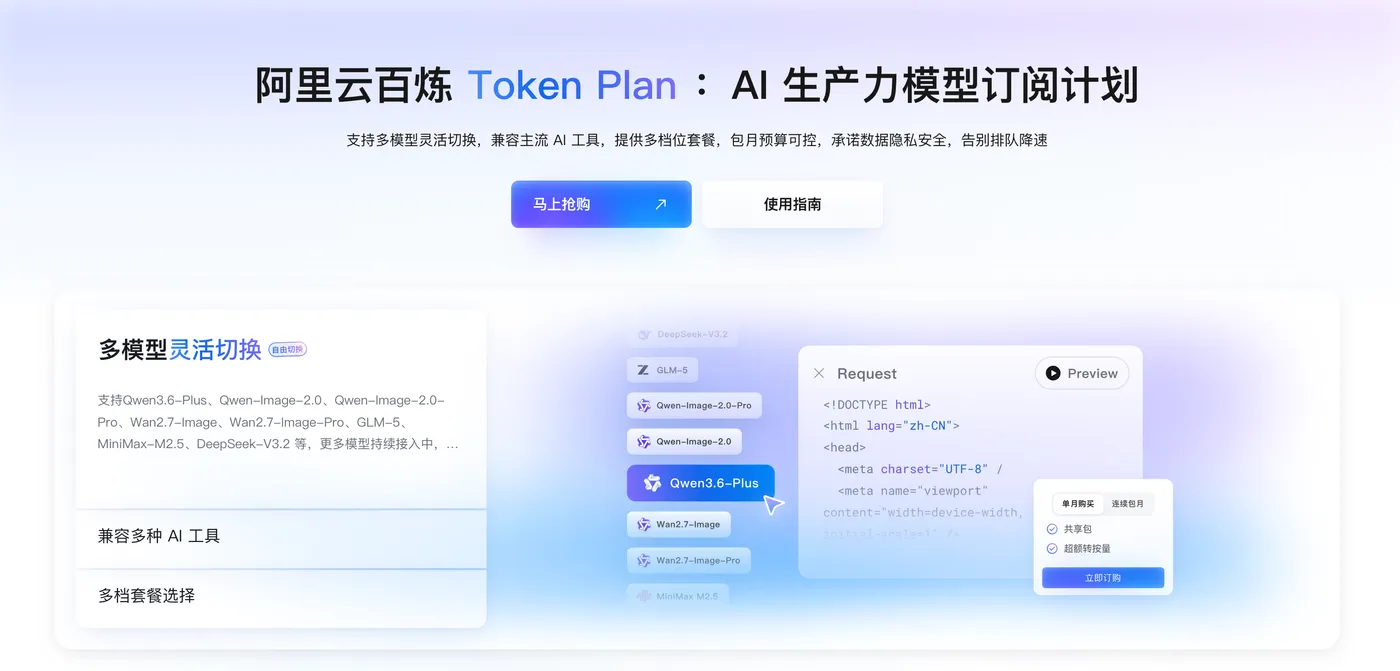
2. 三级硬件集群部署方案
第一档个人/本地调试配置:Mac Studio M3 Ultra设备,统一内存≥256GB,仅支持UD-IQ2轻量化,单轮推理速度3至9token每秒,无法承载线上并发,仅用于小规模代码测试、文档分析原型验证,不具备生产落地能力。
第二中小型企业生产集群:4×H10 80GB显卡,适配FP8、Q4_K_M量化方案,可稳定支撑百万上下文代码仓库分析、中等规模智能体自动化任务,兼顾硬件采购租赁成本与推理吞吐,是中小研发团队主流选择。主机物理内存要求不低于256GB,内网带宽10Gbps以上,保障多卡张量并行数据传输效率。
第三档大型企业高并发集群:8×H200 141GB显卡,支持BF16原生全精度推理,百万上下文长文档、多智能体并行等高负载场景无性能瓶颈,适合金融、科研机构核心业务。集群配套独立散热、供电设施,月度运维、电力成本显著高于中小型集群。
3. 通用硬件硬性约束
所有生产级自托管服务器物理内存最低标准256GB,推荐512GB,内存不足会频繁触发OOM内存溢出、服务强制重启;集群内网必须10Gbps及高速带宽,多卡并行推理时张量数据传输无延迟瓶颈;存储统一采用企业级高速SSD,禁止普通机械硬盘,防止权重加载耗时过长拖慢服务启动速度。
二、vLLM与SGLang双推理框架部署适配逻辑
两款开源推理框架均原生兼容GLM 5.2,但底层调度、缓存机制、长上下文吞吐能力存在明显区分,对应业务场景完全不同,需按需选择部署方案。
1. vLLM通用批量推理框架
vLLM主打通用对话、批量文本、批量代码扫描场景,内置成熟张量并行、前缀缓存优化机制,部署流程标准化,运维门槛更低。完整部署流程分为虚拟环境创建、依赖安装、权重拉取校验、服务启动、冒烟测试五步。先独立创建Python虚拟环境隔离依赖,安装指定版本vLLM与模型下载工具,通过官方命令拉取对应量化权重并校验存储占用;多卡集群启动时配置张量并行数量、最大上下文长度、FP8缓存格式,开放专属服务端口;调用基础对话接口返回正常结果即代表部署成功,若出现内存溢出,下调max-model-len参数降低上下文上限。该框架适合短多轮对话、批量文档摘要、批量代码审查等常规业务,运维工具生态完善,故障排查资料充足。
2. SGLang长智能体专用框架
SGLang内置RadixAttention专属缓存算法,针对百万Token超长上下文、多步骤连续智能体任务深度优化,同等硬件下吞吐相较vLLM提升三倍,完美适配Hermes、OpenClaw等需要数十步自主执行的AI智能体。部署流程与vLLM环境隔离,避免依赖冲突,启动时额外开启EAGLE推测加速模块,大幅降低单轮推理耗时;服务端口与vLLM区分开,防止端口占用冲突。面向行业报告自动生成、全网信息持续监控、大型项目分步重构、多轮深度科研分析等长链路任务,优先选择SGLang部署GLM 5.2,能够显著减少任务中断、重复推理开销。
三、OpenClaw与Hermes Agent功能、场景、部署方案完整对比
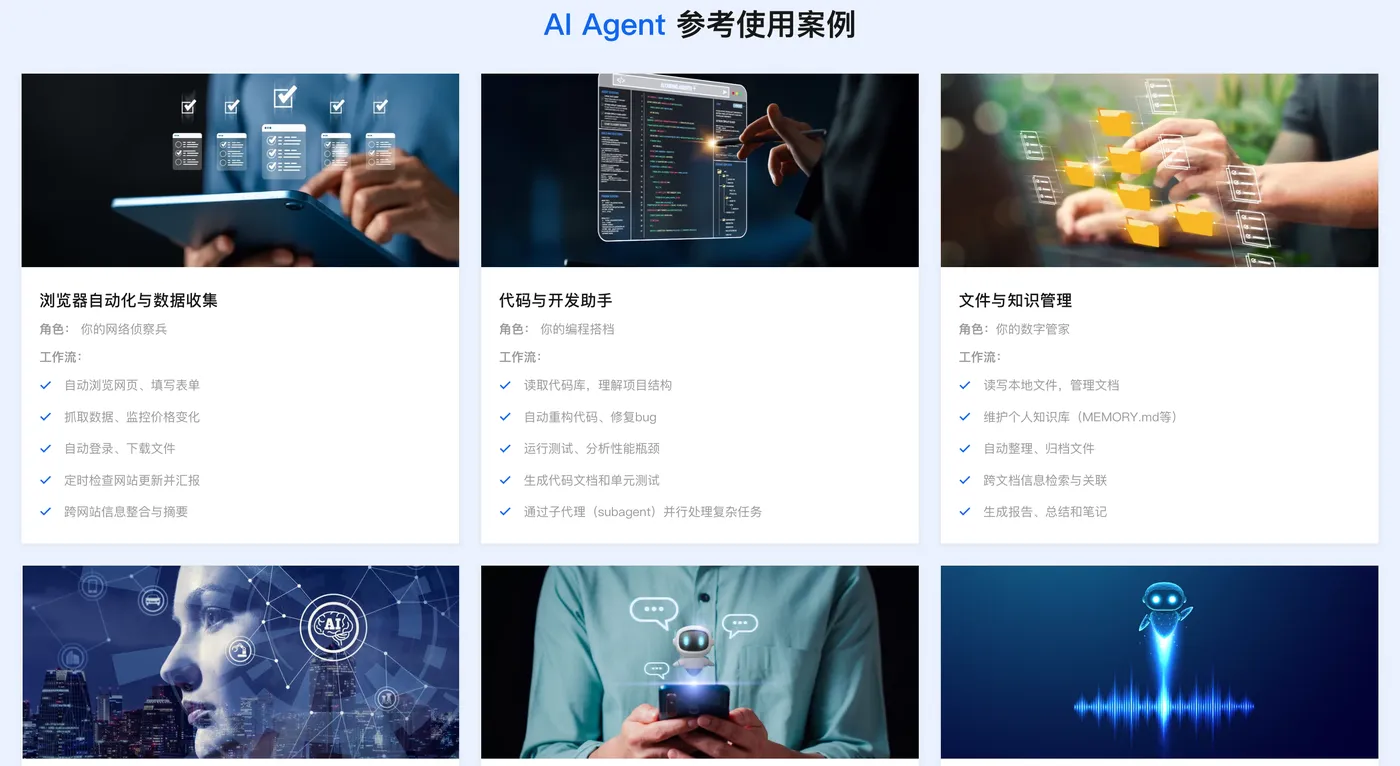
两款智能体均可通过阿里云轻量应用服务器官方应用镜像一键部署,无需手动配置运行环境,但产品定位、核心能力、适配业务存在本质差异,可单独部署也可混合分工使用。
1. OpenClaw核心定位与适用场景
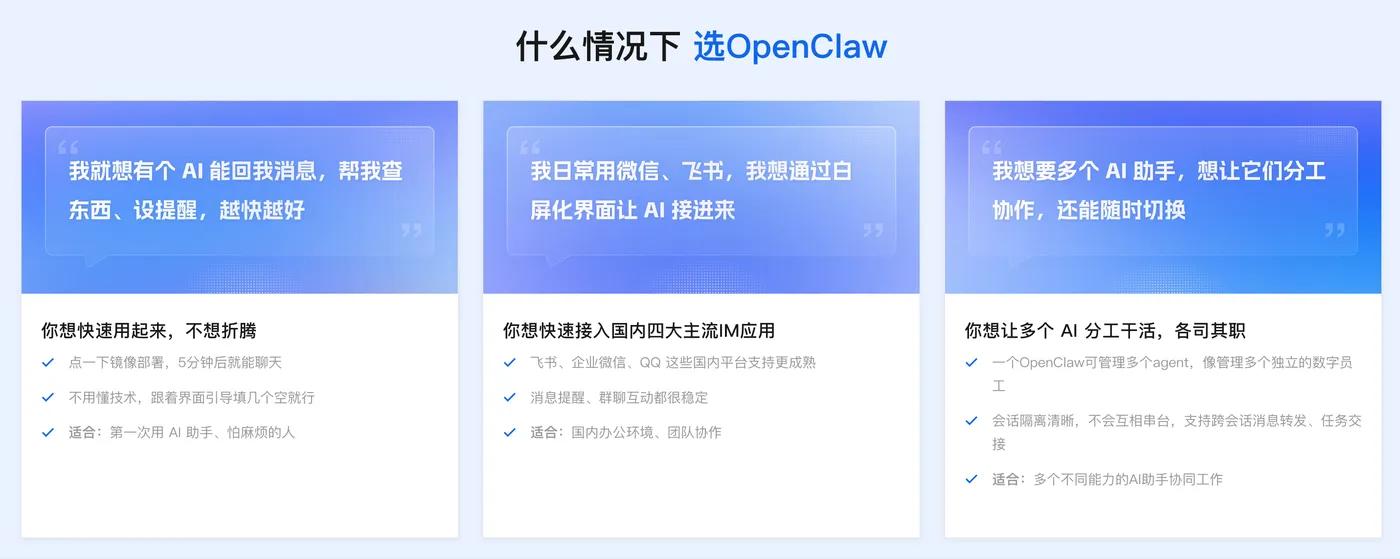
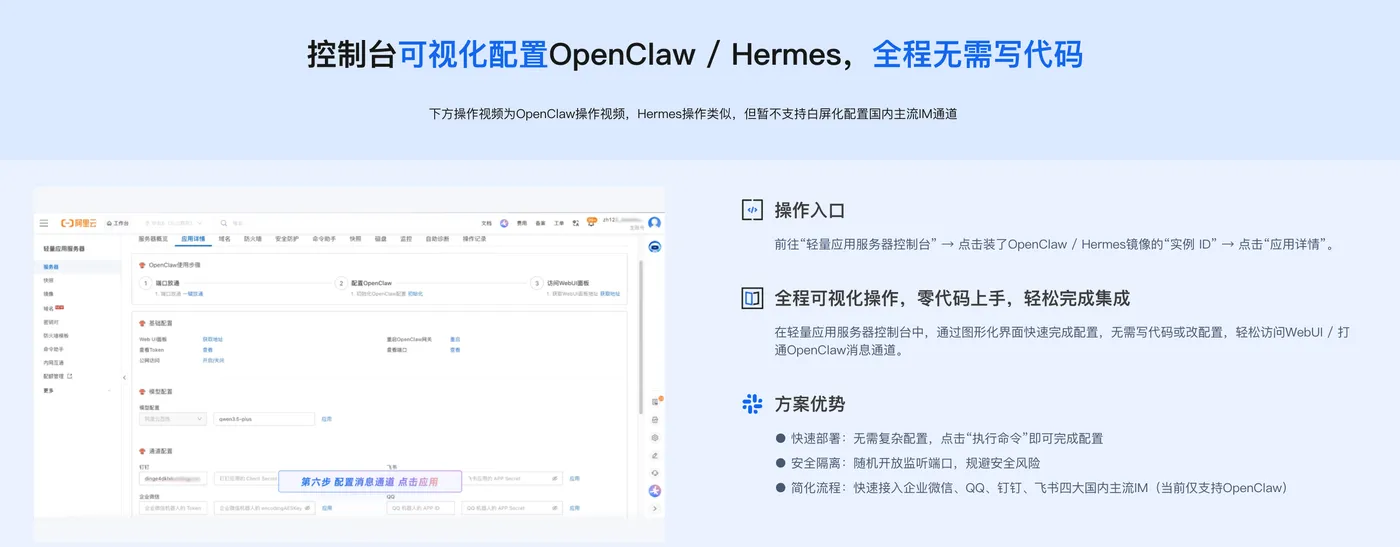
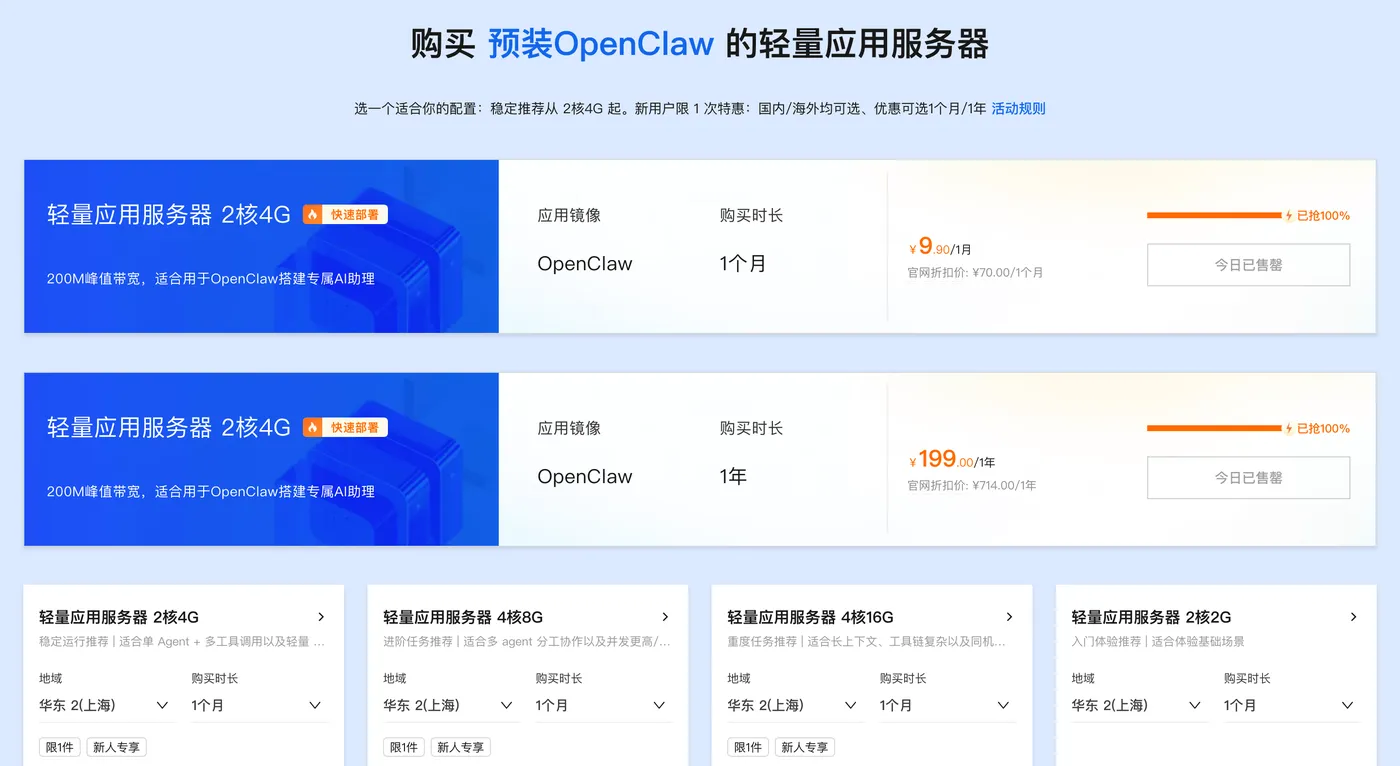
OpenClaw主打轻量化办公交互、多IM渠道稳定联动,上手门槛极低,零基础用户五分钟即可完成搭建,支持飞书、企业微信、QQ、国内主流办公通讯工具稳定接入。核心能力集中在消息自动回复、日程提醒、资料快速检索、简单问答、多AI助手分工管理,支持会话完全隔离,多个数字员工各司其职、跨会话任务交接。适合需求简单、追求快速落地的办公团队,仅需要消息自动化、轻量化信息查询,不涉及复杂多步骤深度研究任务。部署依托轻量应用服务器预装镜像,控制台全可视化图形配置,无需编写任何代码,支持一键配置消息通道、Web后台访问,新人2核4G规格即可稳定长期运行,并发多会话场景可升级4核8G、4核16G高配实例。
2. Hermes Agent核心定位与适用场景
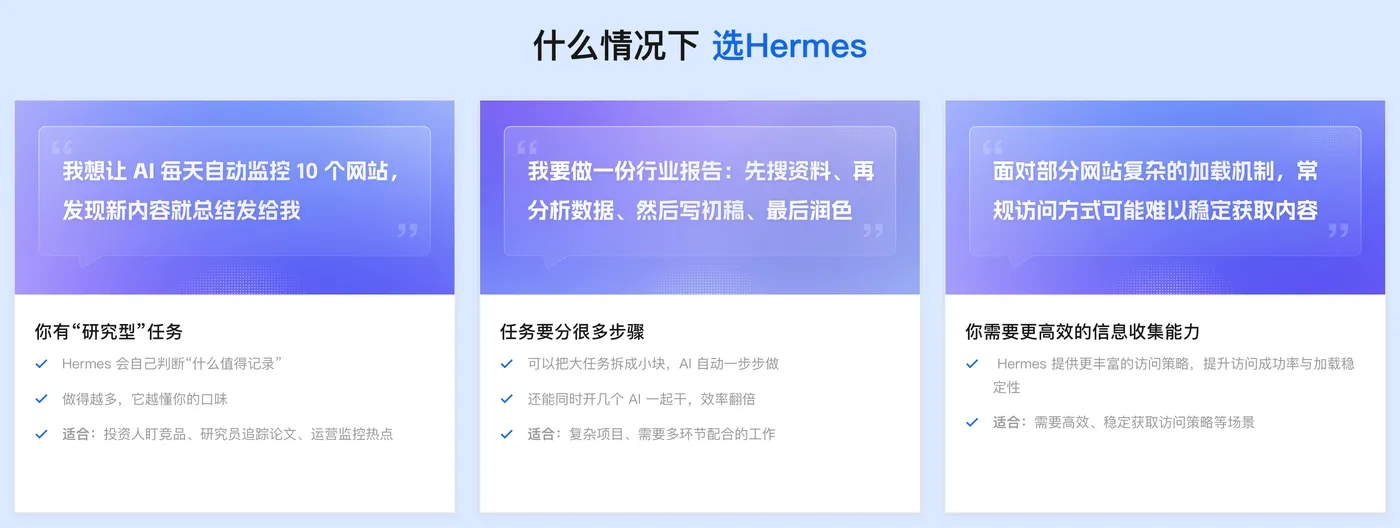
Hermes为研究型自主智能体,具备持续自主学习、长链路分步执行能力,使用频次越高任务判断精度越高,擅长多环节复合工作流。支持全网多网站定时监控、批量资料抓取、行业报告分步撰写、多层代码调试、跨平台数据整合,可自主拆分数十个子任务串行完成,同时支持多智能并行加速信息收集。对于需要长期跟踪行业动态、论文梳理、复杂工程重构、批量数据研判的研究员、运营、研发人员适配度更高。部署同样采用轻量服务器镜像,但IM可视化配置能力弱于OpenClaw,更侧重后台自动化任务运行,重度多任务场景推荐4核16G高配实例,避免内存占用过高导致进程卡顿。
3. 三种AI Agent部署模式优劣对比
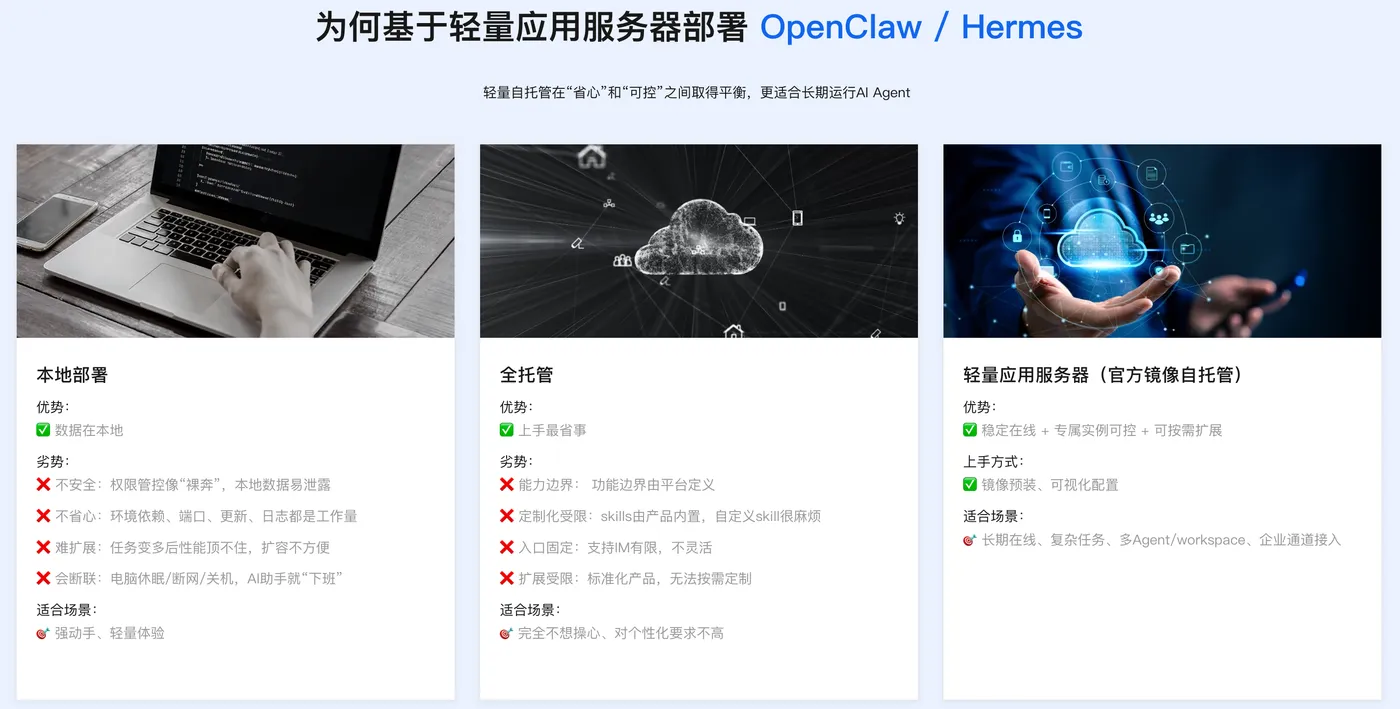
本地电脑部署:优势是数据本地留存,劣势明显,电脑休眠、断网、关机后智能体直接下线,权限管控薄弱易泄露,硬件性能不足以支撑多任务并行,仅适合临时体验。
全托管线上标准化AI服务:完全无需运维,但自定义工具、私有知识库拓展受限,内置技能固定,无法对接自托管GLM 5.2私有化模型,入口渠道单一。
阿里云轻量应用服务器镜像自托管:平衡可控性与运维难度,实例24小时稳定在线,预装完整运行环境,可视化控制台管理,支持自定义模型接口对接,可绑定百炼Token Plan云端算力或本地GLM5.2私有化推理服务,按需弹性升级硬件规格,是个人、中小团队最优长期部署方案。
4. 轻量服务器部署配置规范
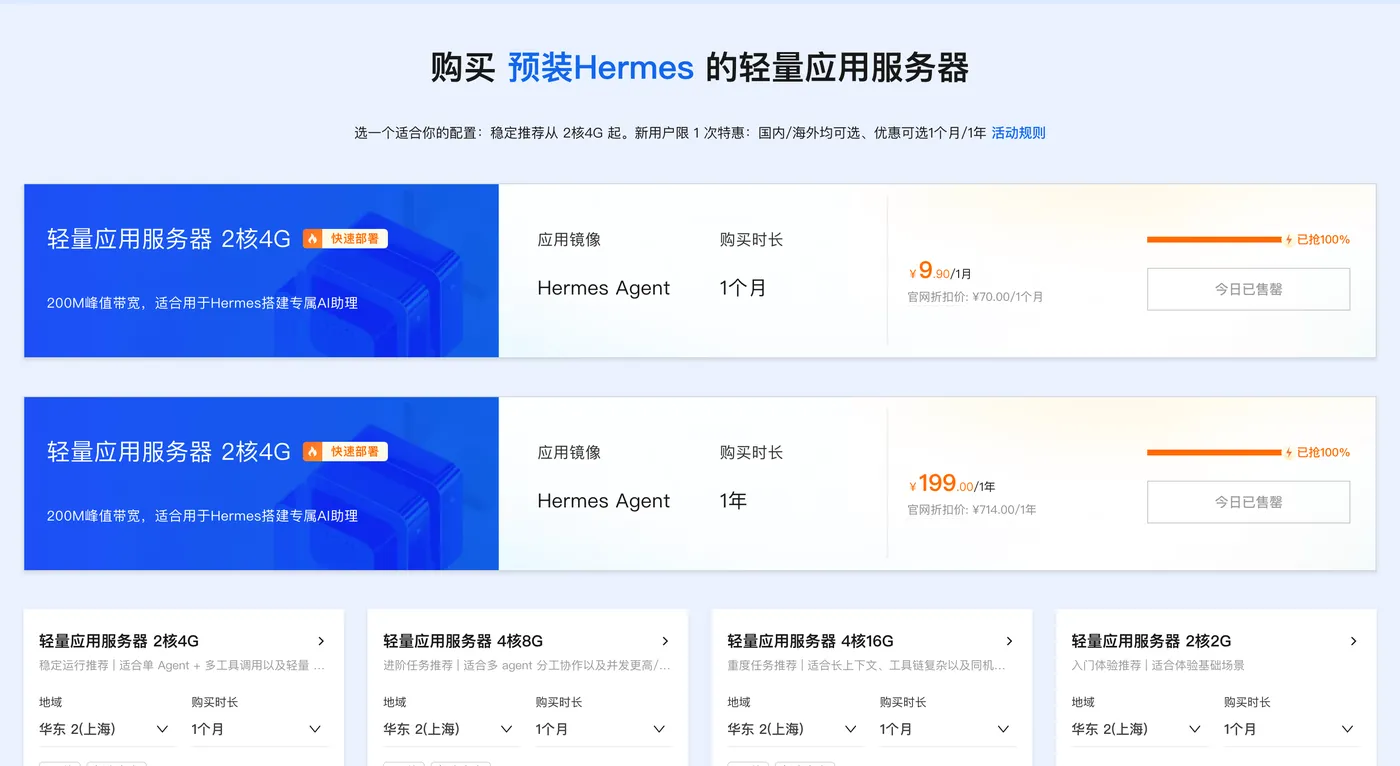
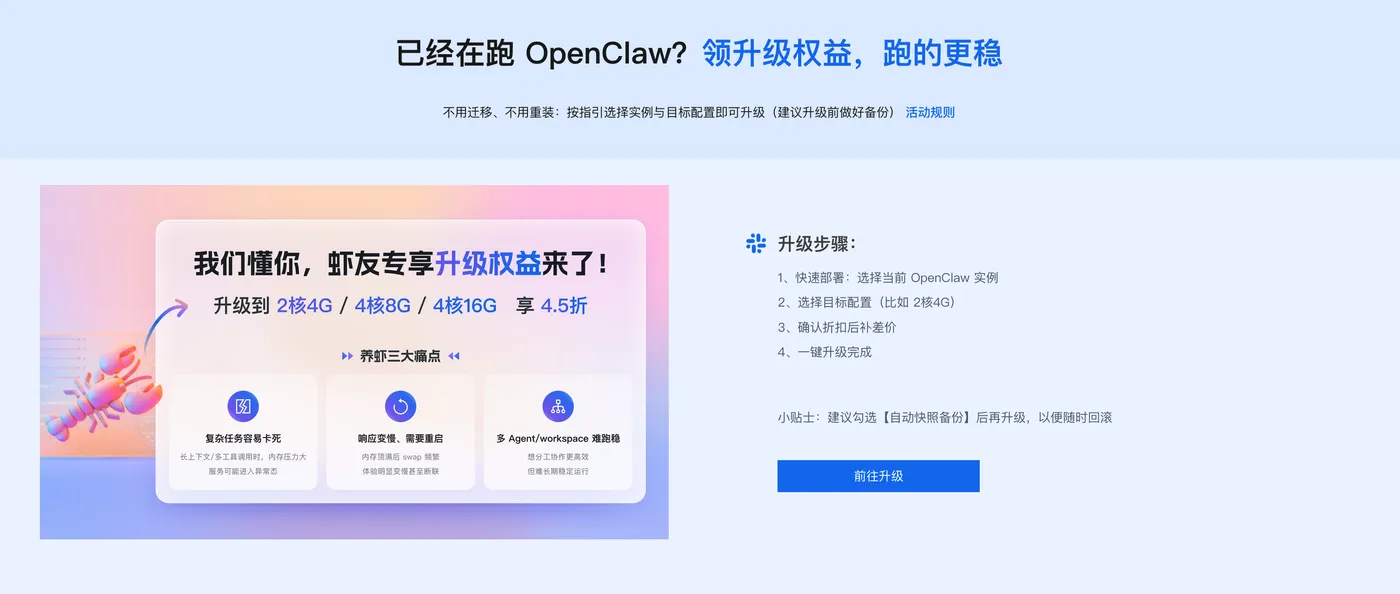
最低稳定运行规格2核4G,入门临时体验可选用2核2G;长期多智能体、长上下文任务推荐4核8G、4核16G实例。带宽统一200M峰值满足网页、IM通道访问,新用户存在月度、年度专属折扣,年度订阅综合成本更低。实例支持一键快照备份与硬件升级,升级前备份数据防止配置丢失,升级无需重装程序,后台直接调整vCPU与内存资源。
四、阿里云百炼Token Plan订阅体系、抵扣规则与智能体接入
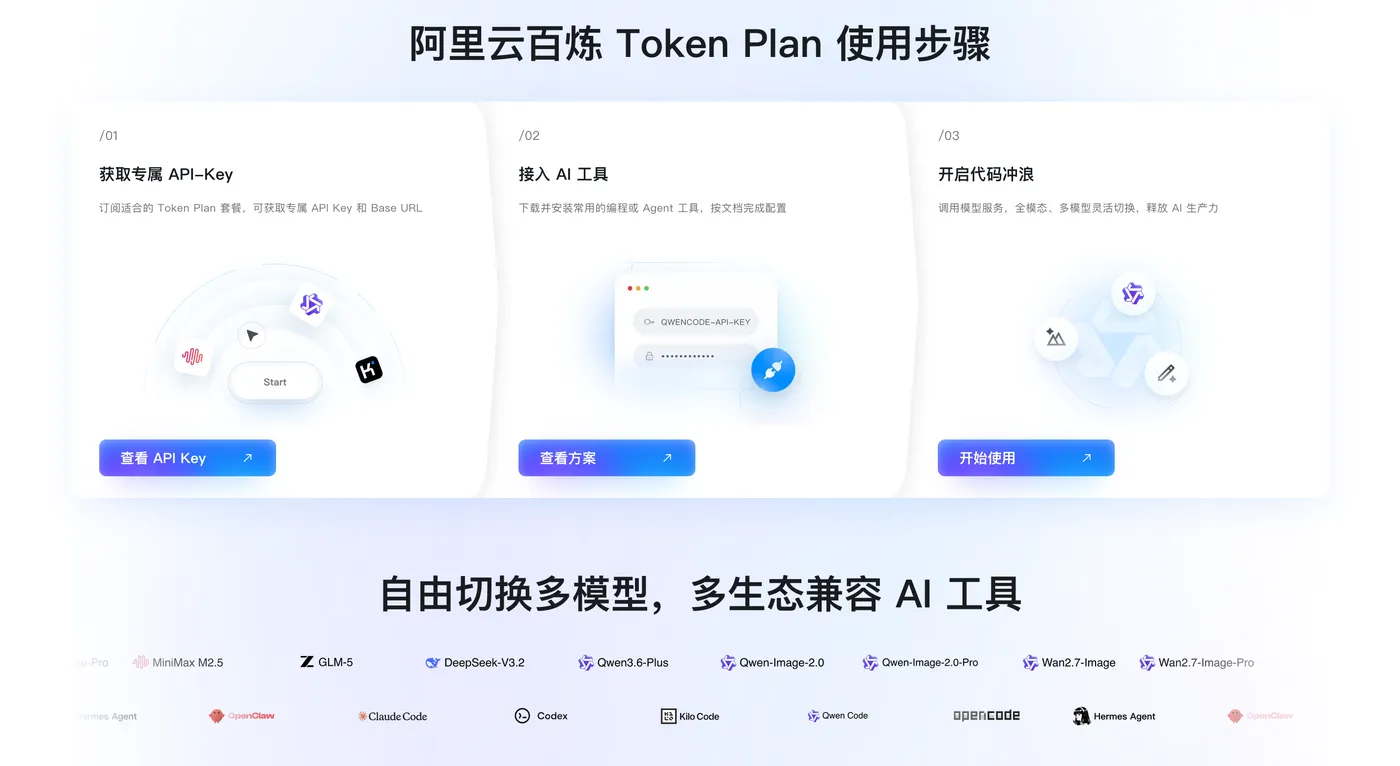
Token Plan是百炼面向团队推出统一算力订阅方案,可同时搭配OpenClaw、Hermes与各类IDE编程工具,兼容GLM5.2、通义千问、MiniMax、DeepSeek等全系列文本、图像模型,与自托管GLM5.2形成云端弹性补充。
1. 三档坐席套餐与基础权益
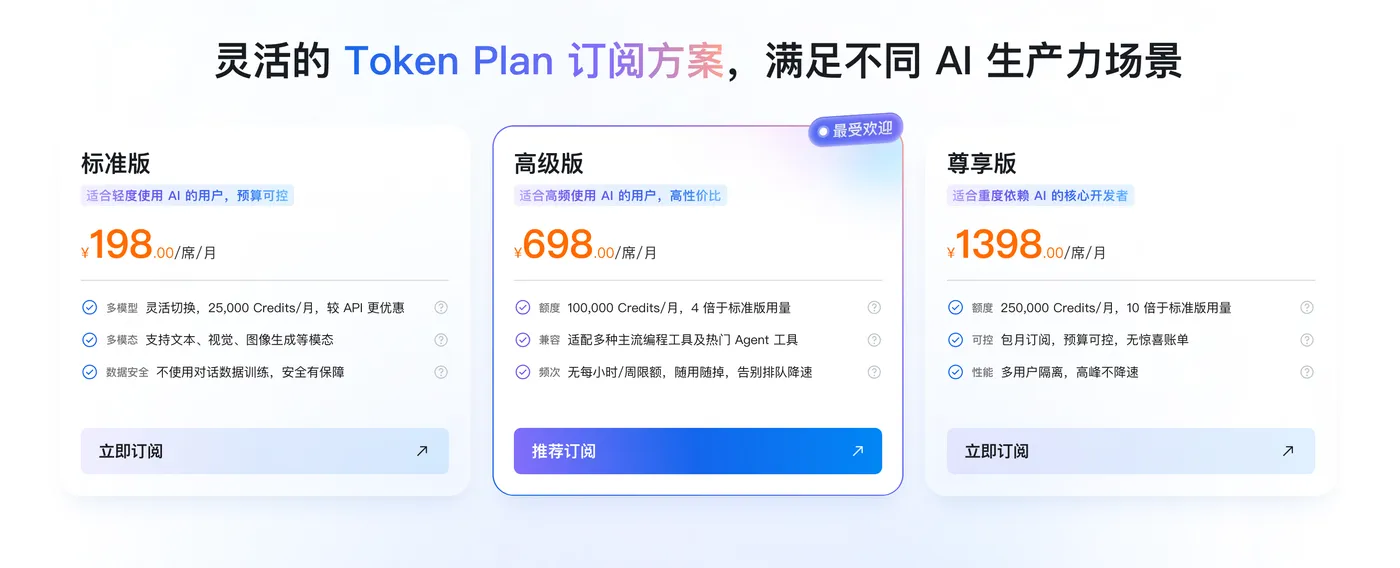
标准坐席198元/月,每月25000 Credits,适合轻度办公、日常代码调试;高级坐席698元/月,100000 Credits,适配高频编码、常规智能体自动化;尊享坐席1398元/月,250000 Credits,面向多智能体集群、百万上下文重型任务。所有坐席月度Credits当月清零不结转,额度耗尽自动暂停服务,可购买共享额度包补充算力。服务固定依托华北2地域,配套专属API Key与独立请求地址,和按量计费密钥完全隔离,不可混用。
2. Credits统一抵扣规则
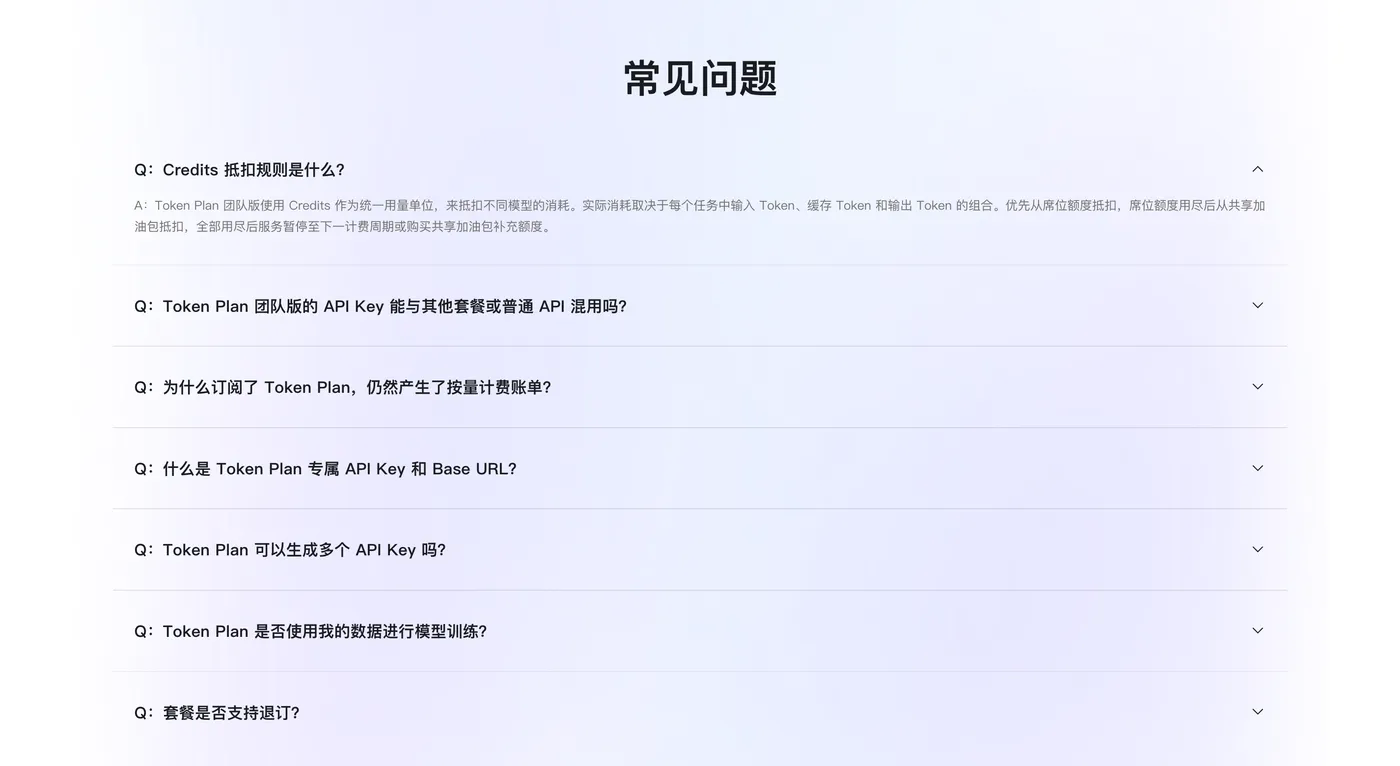
Credits作为全模型通用计量单位,消耗由输入Token、输出Token、缓存读取量共同决定,抵扣顺序固定:先消耗单坐席月度额度,用尽后自动扣除团队共享用量包,全部额度耗尽暂停模型调用,直至下月额度重置或补充资源包。控制台分坐席、分模型展示消耗明细,管理员可查看全体成员用量,设置额度超限告警,规避高额账单。套餐承诺不采集用户对话数据用于模型迭代,满足政企数据合规要求,多租户隔离架构高峰时段无排队延迟。
3. 智能体接入流程
订阅套餐后在百炼控制台生成sk-sp专属密钥,复制Base地址,在OpenClaw、Hermes后台模型配置页面填入对应参数,选定GLM、千问等可用模型即可完成绑定。一套订阅积分可在多个智能体、编程工具间通用,灵活切换模型无需额外开通计费,适合混合架构团队,本地自托管GLM处理核心涉密任务,云端Token Plan承载公开批量业务。
五、GLM5.2自托管成本盈亏测算与优化策略
自托管模式前期硬件投入较高,需结合月度调用总量测算盈亏平衡点,区分短期测试与长期规模化业务。
1. 完整成本构成
硬件成本分为一次性集群采购或按月云显卡租赁,8卡H20集群月度租赁开销数万;4卡H10集群成本减半。运维成本包含服务器巡检、故障修复、安全加固,月度固定人力开销;电力成本高算力集群功耗突出,是长期持续支出。
2. 盈亏平衡判定标准
月度模型总调用量超百万Token、日均请求3000次以上,自托管长期综合成本低于云端Token Plan订阅,具备经济价值;日均调用不足1000次的短期项目、原型测试,优先选用百炼云端订阅,避免硬件闲置浪费资金。
3. 全方位成本优化方案
- 匹配合理量化方案:非极致高精度业务选用FP8量化,平衡性能与硬件投入;预算有限中小型团队采用Q4_K_M;
- 推理缓存优化:开启vLLM、SGLang前缀缓存,大幅降低重复输入Token消耗,减少算力开销;
- 弹性扩缩容:云托管自托管集群非工作时段缩减显卡节点,降低租赁、电力成本;
- 混合分流架构:涉密核心业务本地GLM5.2自托管,公开批量文档、简单交互流量路由至百炼Token Plan云端,兼顾安全与成本。
六、混合AI架构落地选型综合建议
- 强数据合规政企、金融机构:核心业务GLM5.2私有化自托管(SGLang部署),Hermes Agent本地对接私有模型,公开对外辅助流量使用Token Plan云端算力,实现数据内外隔离;
- 普通研发、办公中小团队:放弃高成本自托管,轻量服务器部署OpenClaw,全程依托百炼Token Plan订阅,低成本快速搭建办公自动化智能体;
- 研究员、运营深度研究场景:轻量服务器部署Hermes,搭配高级坐席Token Plan,高频复杂任务按需评估自托管可行性;
4 批量代码审计、文档流水线业务:选用vLLM部署GLM5.2,批量任务本地推理,日常交互式编码搭配Coding Plan编程订阅。
全文总结
GLM 5.2开源大模型自托管方案凭借数据私有化、调度自主可控的核心优势,适配高合规企业复杂智能体、代码推理业务,硬件、量化、推理框架三层选型直接决定落地成本与性能,vLLM适配通用批量任务,SGLang专为长链路自主Agent优化。OpenClaw、Hermes两款智能体可依托阿里云轻量应用服务器一键镜像部署,前者侧重国内办公IM轻量化交互,后者擅长多步骤深度研究自动化,可根据业务需求单独或搭配使用。百炼Token Plan提供跨模型统一包月算力,作为云端弹性补充,可与本地私有化GLM形成混合架构平衡安全与开销。企业落地前可通过日均调用量测算自托管盈亏平衡点,短期低频业务优先云端订阅,长期百万级大规模推理场景部署私有集群,同时通过缓存优化、任务流量分层、硬件弹性调度持续降低整体AI算力综合支出,构建稳定、低成本、合规的全链路AI自动化体系。