数据解析陷阱:漏了追评,商家差评预警漏了 30% 的差评
系统上线后第二周,商家反馈:“昨天的 12 条差评,系统只预警了 8 条!” 排查发现,京东评论的返回结果藏着 “双字段陷阱”——主评存在comments字段,追评(追加评论)存在after_comments字段,我只解析了comments,完全漏掉了追评里的差评:比如用户买了商品 3 天后追加的 “质量差,掉漆”,系统没抓到,导致商家没及时回复,店铺动态评分掉了 0.2 分。
更坑的是,带图评论的图片 URL 藏在images的url字段里,且部分追评的images是嵌套结构,直接取值会报 KeyError;另外京东会对用户昵称脱敏(比如 “张 **”),如果直接展示会出现乱码。我连夜重写的评论解析函数,专门整合主评、追评、带图评论和情感判断:
python实例
jd.review/[测试调试]
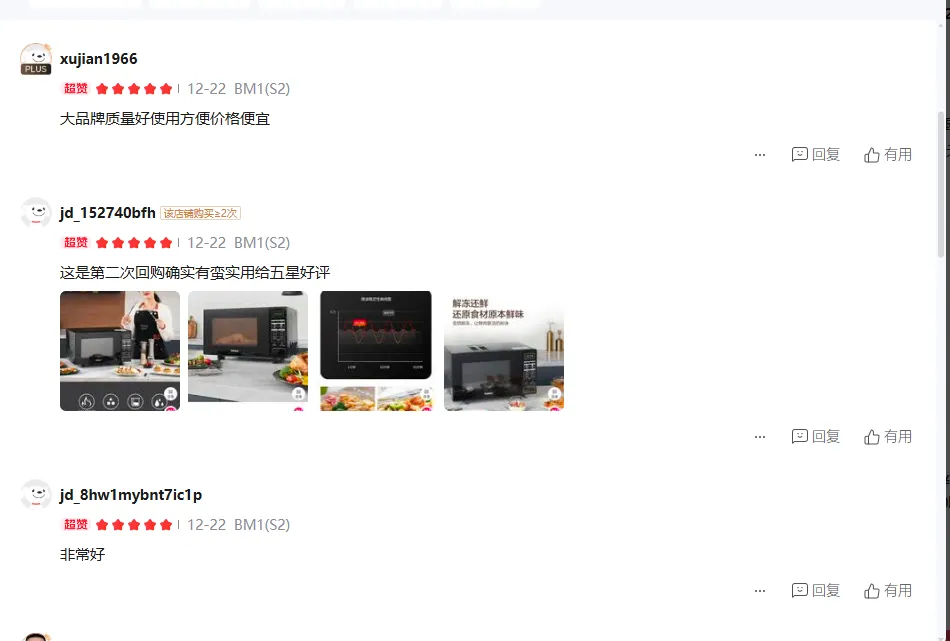
```items": {
"real_total_results": 500000,
"total_results": 500000,
"page_size": 10,
"page": "1",
"item": [
{
"rate_content": "大品牌质量好使用方便价格便宜",
"rate_date": "2025-12-22 14:10:35",
"pics": [],
"rate_id": "103553730157088578",
"guid": "T6NdPMJ0j58tdR-BW66QxXiJ",
"score": 5,
"display_user_nick": "xujian1966",
"auction_sku": "BM1(S2);",
"add_feedback": null
},
{
"rate_content": "这是第二次回购确实有蛮实用给五星好评",
"rate_date": "2025-12-22 14:04:22",
"pics": [
"jfs/t1/375305/12/20041/261755/6948df61F9fd28fd4/00a94ecaf014c703.jpg",
"jfs/t1/376768/4/18439/269304/6948df65F5fed58df/00a94ecaf00b6fbc.jpg",
"jfs/t1/379944/35/12289/321964/6948df64Fe0093753/00a94ecaf06eea35.jpg",
"jfs/t1/373946/31/20633/335073/6948df62Ff02f42fe/00a94ecaf0921005.jpg"
],
"rate_id": "103543710155619542",
"guid": "T6NdPMN0j50tdR-DXaeRxXuD",
"score": 5,
"display_user_nick": "jd_152740bfh",
"auction_sku": "BM1(S2);",
"add_feedback": null
},
{
"rate_content": "非常好",
"rate_date": "2025-12-22 12:58:29",
"pics": [],
"rate_id": "103541160162348180",
"guid": "T6NdPMN2iZotdRyEWKKQwXeB",
"score": 5,
"display_user_nick": "jd_8hw1mybnt7ic1p",
"auction_sku": "BM1(S2);",
"add_feedback": null
},
{
"rate_content": "好用的,经常回购,下次继续回购,推荐",
"rate_date": "2025-12-22 12:31:51",
"pics": [],
"rate_id": "103045080228559127",
"guid": "T6NdOcNyiJQtdhiOXqORwX2G",
"score": 5,
"display_user_nick": "扶摇公子Kiss",
"auction_sku": "BM1(S2);",
"add_feedback": null
},
运行
def parse_jd_comments(comment_data):
"""
解析京东评论:整合主评/追评、带图评论、情感判断
:param comment_data: 接口返回的评论数据
"""
all_comments = []
# 1. 处理主评(必存在)
main_comments = comment_data.get("result", {}).get("comments", [])
for main in main_comments:
    # 提取带图评论的图片URL(无图则返回空列表)
    comment_images = [img.get("url") for img in main.get("images", []) if img.get("url")]
    # 情感判断:1-2分=差评,3分=中评,4-5分=好评
    emotion = "差评" if main.get("score", 3) <=2 else "中评" if main.get("score")==3 else "好评"
    all_comments.append({
        "comment_id": main.get("id"),
        "user_nick": main.get("nickname", "匿名用户"),  # 脱敏昵称,如“李**”
        "emotion": emotion,
        "content": main.get("content", "").replace("\n", " "),  # 处理换行符
        "images": comment_images,
        "create_time": main.get("create_time"),
        "comment_type": "主评"
    })

# 2. 处理追评(部分评论无追评,需判断)
after_comments = comment_data.get("result", {}).get("after_comments", [])
for after in after_comments:
    after_images = [img.get("url") for img in after.get("images", []) if img.get("url")]
    emotion = "差评" if after.get("score", 3) <=2 else "中评" if after.get("score")==3 else "好评"
    all_comments.append({
        "comment_id": after.get("id"),
        "user_nick": after.get("nickname", "匿名用户"),
        "emotion": emotion,
        "content": after.get("content", "").replace("\n", " "),
        "images": after_images,
        "create_time": after.get("create_time"),
        "comment_type": "追评"
    })

# 按评论时间倒序排序(最新评论在前)
return sorted(all_comments, key=lambda x: x["create_time"], reverse=True)
示例调用
raw_comment = {
"result": {
"comments": [
{"id": "12345", "nickname": "张", "score": 1, "content": "质量差", "images": [{"url": "xxx.jpg"}], "create_time": "2025-12-20 10:00"}
],
"after_comments": [
{"id": "12346", "nickname": "李", "score": 1, "content": "追加:掉漆了", "images": [], "create_time": "2025-12-23 15:00"}
]
}
}
parsed_comments = parse_jd_comments(raw_comment)
print(f"共解析{len(parsed_comments)}条评论,其中{len([c for c in parsed_comments if c['emotion']=='差评'])}条差
```