
当生产环境中的容器CPU出现异常时,可能会引发上层业务出现一系列问题,比如业务请求缓慢、网页卡顿甚至崩溃等,如果没有一个有效的故障定位方法,运维人员很难从海量的告警信息中快速找到根本原因并解决问题。
1 故障场景
某个时刻,几十个电商服务同时出现大量告警,如下所示。
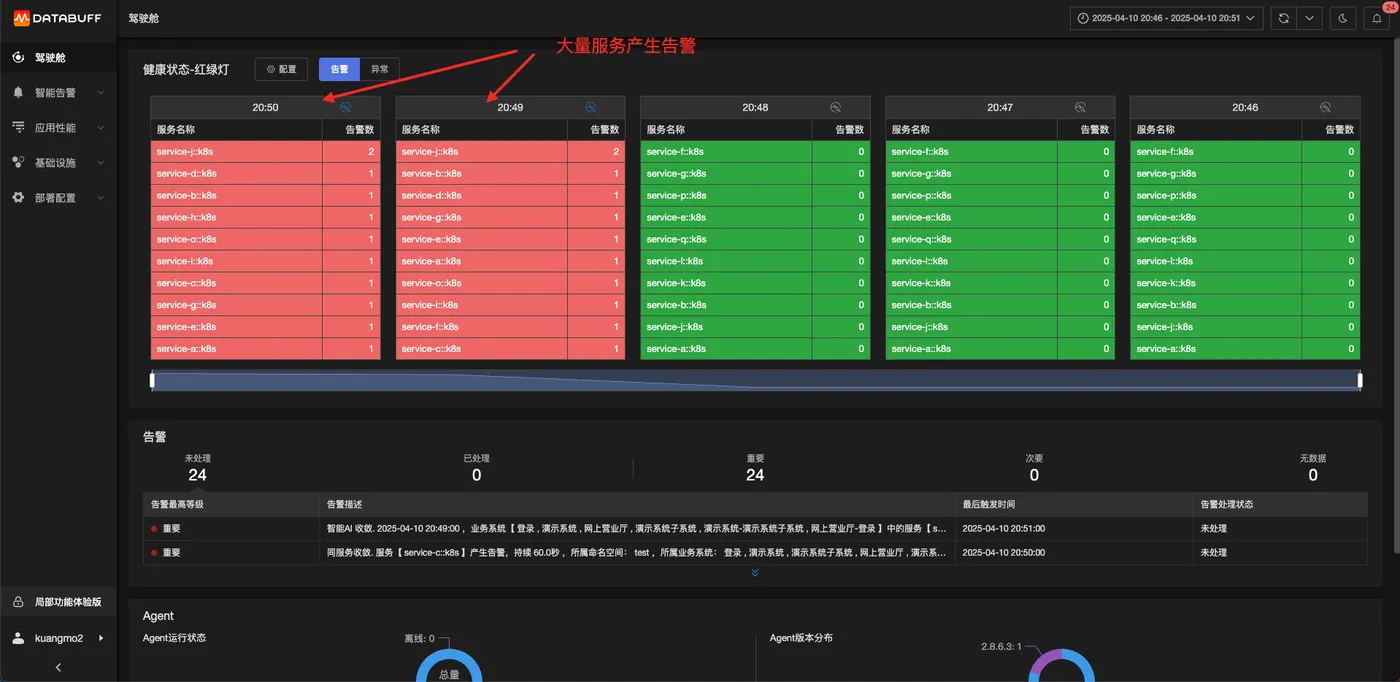
通常的方法是,从海量的告警信息中搜索有效信息,经过几十分钟时间的排查,可以拿到如下故障结论:
定界(确定故障服务节点):服务J是根因服务,影响了上游一系列的服务
定位(确定服务上的具体问题):服务J的CPU使用率非常高
但是,对于生产环境中出现的问题,几十分钟的排查时间无疑是太久了。因此,我们需要一个效率更高、更准确的方案,能够在几分钟内就能找到问题根因。
2 故障定位思路分析
下面从定界和定位两个方面进行展开,讨论如何才能更高效的实现故障定位。
2.1 定界
对该故障的定界主要有如下2个难点
如何确定是自身、访问组件、访问下游服务的问题?
如何确定是自身还是下游服务的问题?
构建实时关系拓扑
首先需要拓扑依赖,构建出实时的关系拓扑
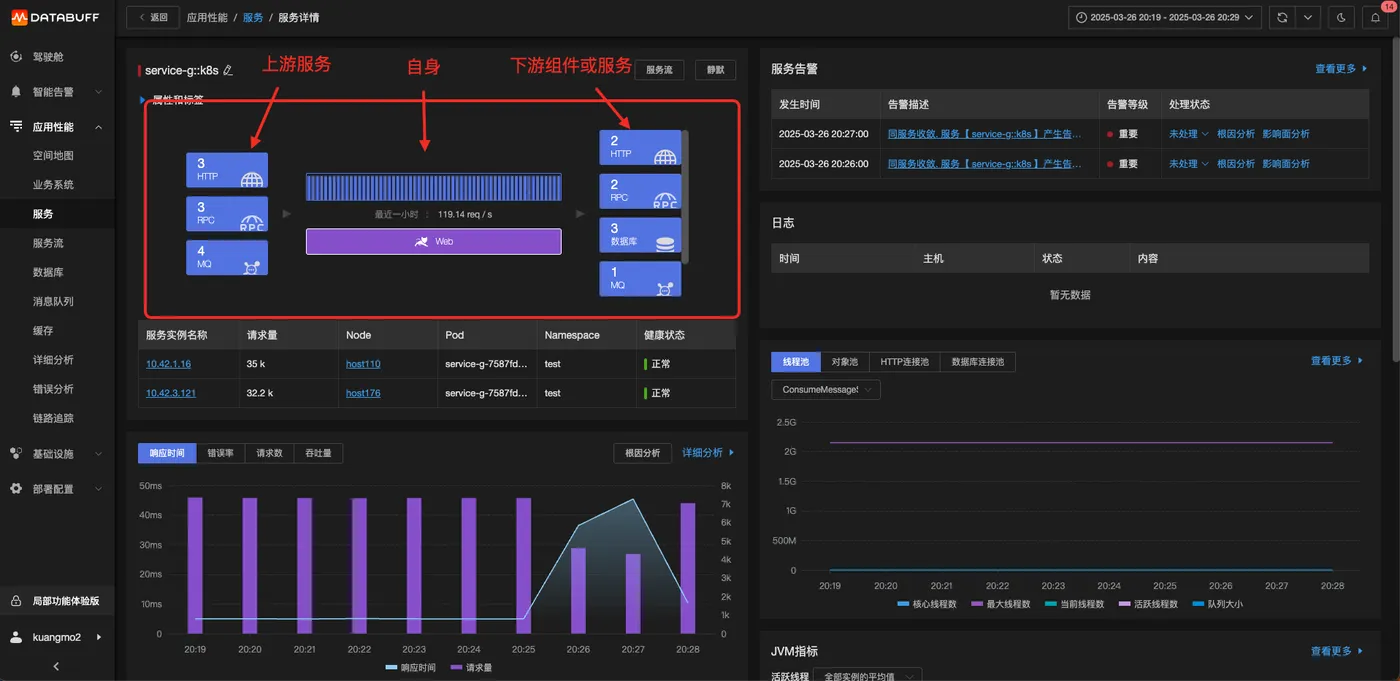
通过异常检测确定下游故障点
其次,对访问下游组件或者访问下游服务的异常或者错误进行异常检测,判断是否符合当前服务的故障范围。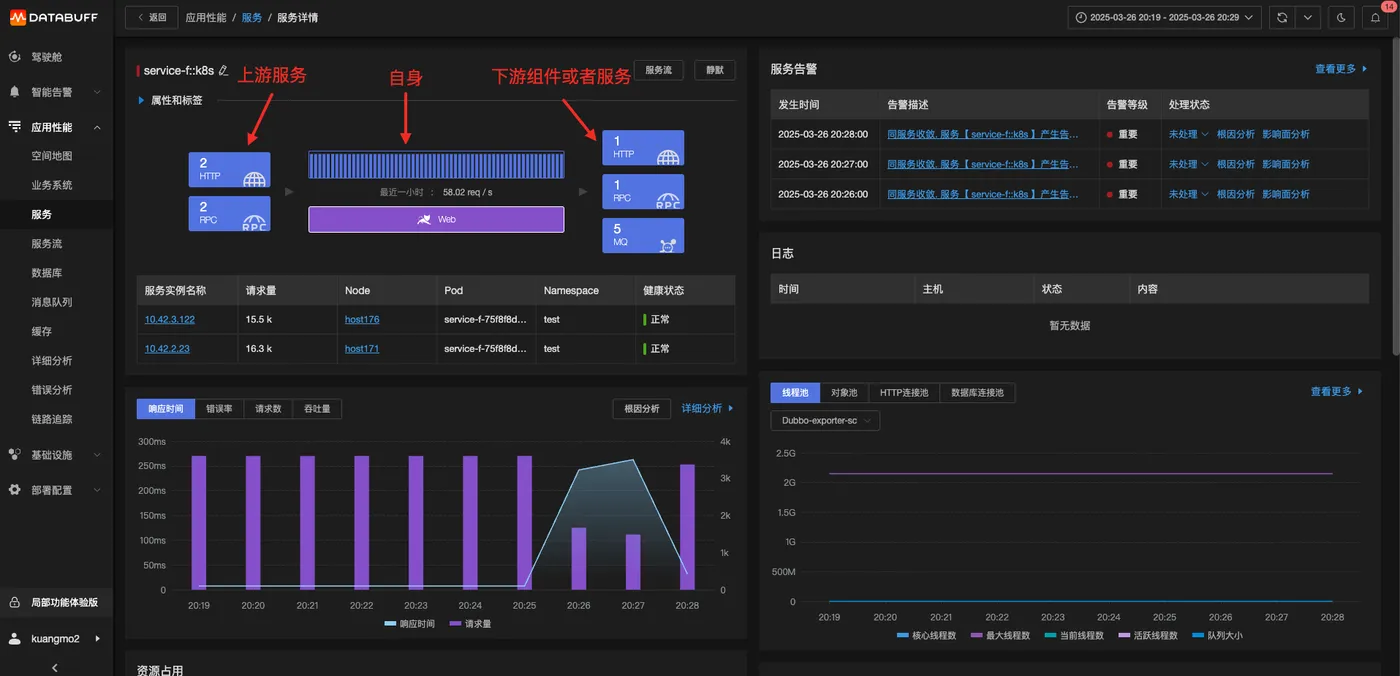
进一步定界
一旦确定是访问下游服务导致之后,有如下3种可能:
下游服务问题
网络问题
自身问题
判断方法是:客户端响应时间和服务端响应时间的基准对比。
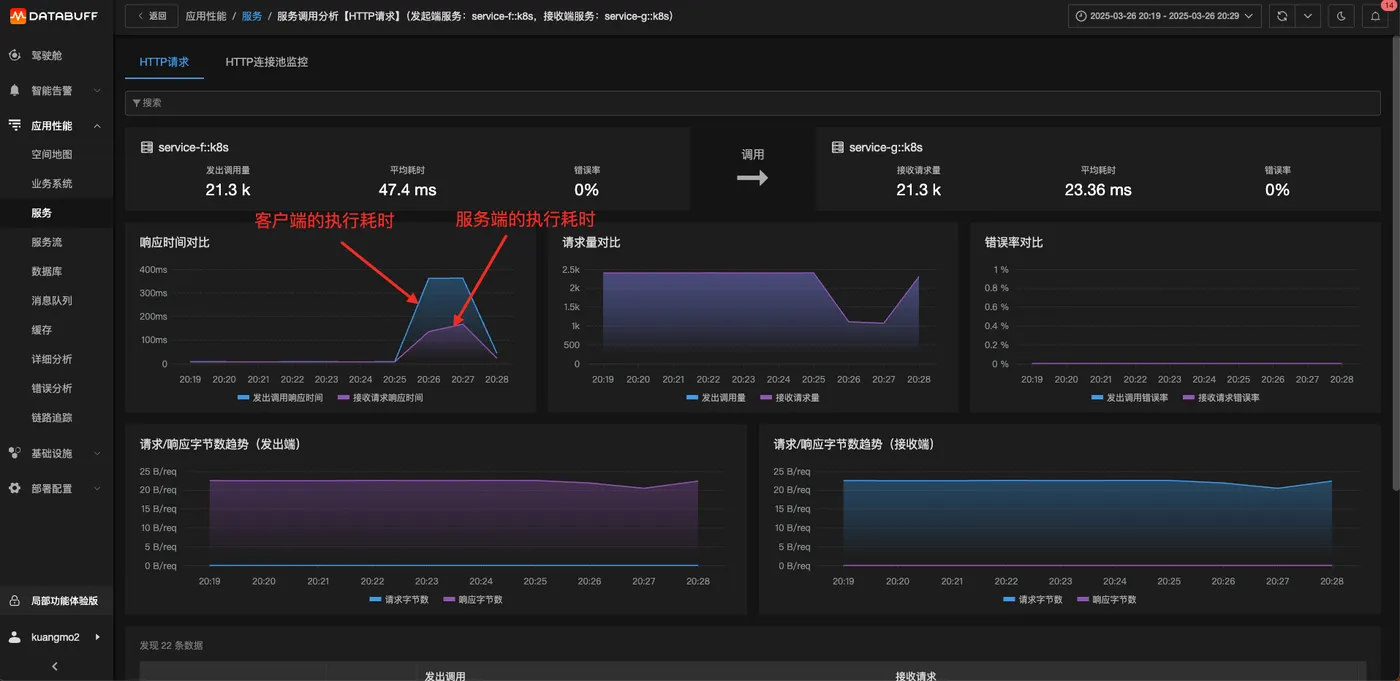
如果服务端的耗时也波动了,大概率就是服务端的问题;
如果服务端的耗时没有波动,大概率是网络问题或者客户端的问题:
通过网络丢包、重传来确定是否有网络问题;
如果GC严重则大概率是客户端问题。
2.2 定位(确定服务节点上的具体问题)
当确定了当前服务是根因服务时(即下游服务并未发现问题),我们就需要分析当前服务自身的问题。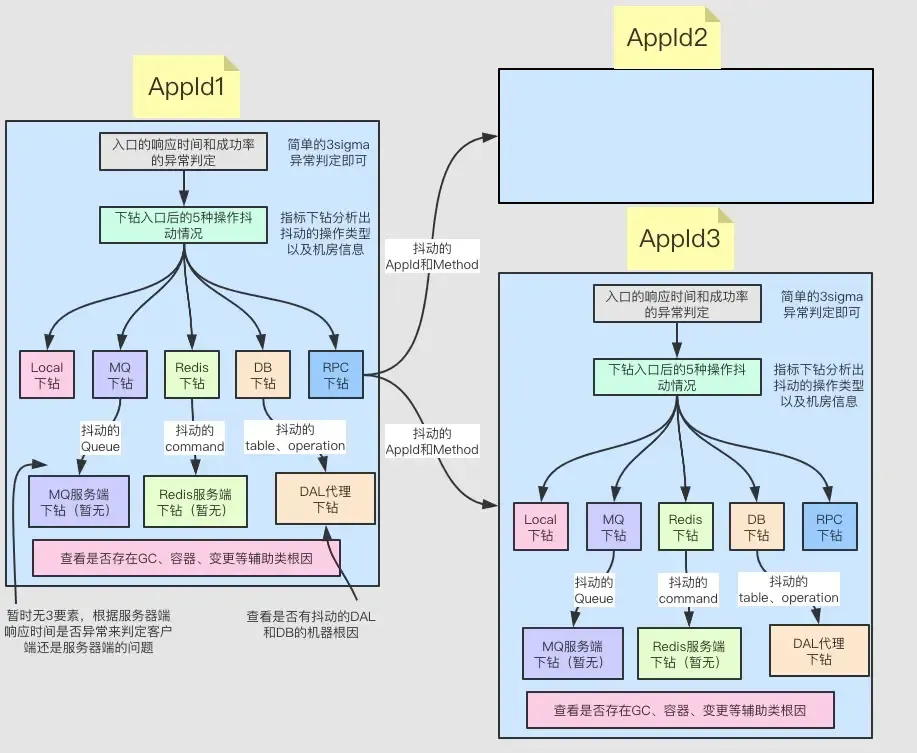
当前服务自身的问题包含如下几种类型:
GC问题
资源问题
变更问题
等等
对这几种类型的问题,我们只能一一检测,并且上述只能作为辅助因素,因为没有严谨的数据能证明GC超过XXXms跟当前故障是否一定强相关。
当我们要查看该服务或者实例的资源指标时,就涉及到非常重要的数据关联操作。
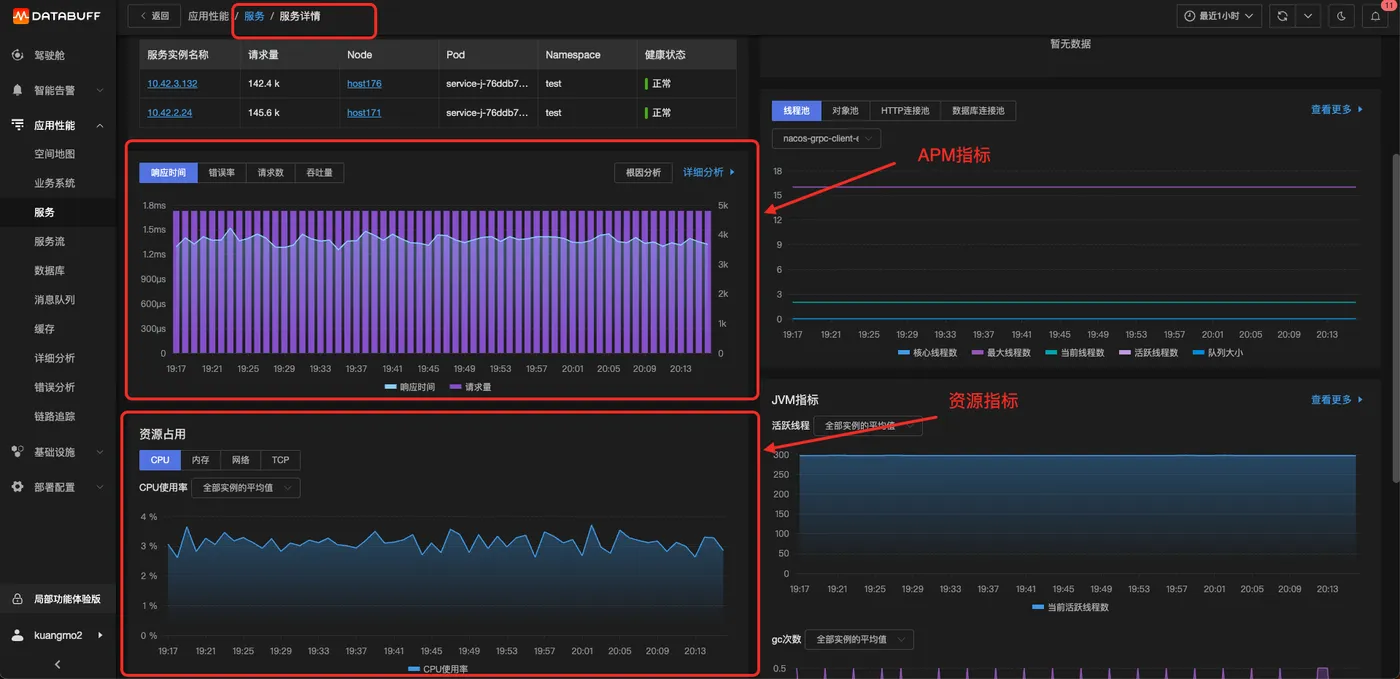
不同环境下的数据如何跟APM的服务和服务实例建立关联呢?
| 不同环境下的数据来源 | APM数据(包含serviceName、ip、pid、containerId、podName、主机host、k8s clusterId) |
|---|---|
| 主机采集的进程数据(包含主机host、pid等) | 和APM关联方案:主机host+pid |
| docker采集的容器数据 (包含主机host、containerId等) | 关联方案:主机host+containerId |
| k8s采集的container数据(包含k8s clusterId、containerId、podName等) | 关联方案:k8s clusterId+containerId |
本质上就是定义一套资源标准,将不同环境下的数据指标映射到这套标准上
- APM数据要采集足够多的关联字段,才能跟其他各种环境的资源数据进行关联
做到了上述几点,就建立起了服务实例跟各种资源指标的关联,然后就进行异常检测
CPU异常检测的难点:
异常检测为了适应各种服务的波动,通常是突变检测,即产生突变即会认为是异常,对于CPU来说,很容易被突变检测认为是异常,因此还需要一些其他的一些抗干扰的检测能力。
最低的CPU阈值:低于此则不认是异常;
波动率:比如至少波动30%才可能认为造成响应时间的波动。
同时对CPU波动度进行打分,波动度越高得分高,根因排序的优先级就高,因此同一个服务内的各个根因都要有打分机制,通过打分机制来决定到底哪个更适合作为根因
3 实战案例
接下来,我们采用故障演练的方式来验证。
我们到RootTalk Sandbox上进行上述故障场景的复现。
:::
RootTalk Sandbox是一个故障演练和定位的系统,可以进行多种故障场景的复现,目前开放注册。
地址:https://sandbox.databuff.com/
:::
3.1 故障注入
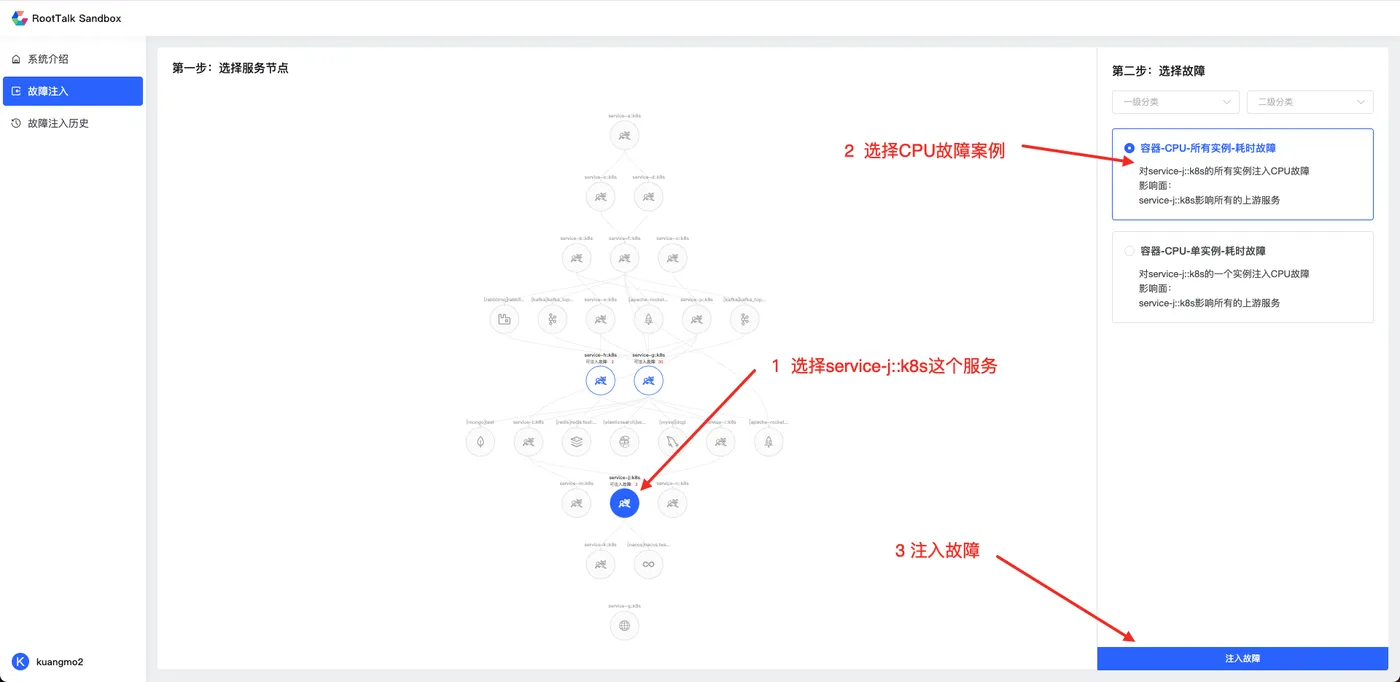
如上图所示进行操作,对拓扑图中的service-j::k8s这个服务的所有实例容器CPU满载的故障。
注入后等待2~3分钟,可直接点击跳转到Databuff的故障定位平台。
3.2 故障定位
登录Databuff后可以看到完整故障树,如下图。
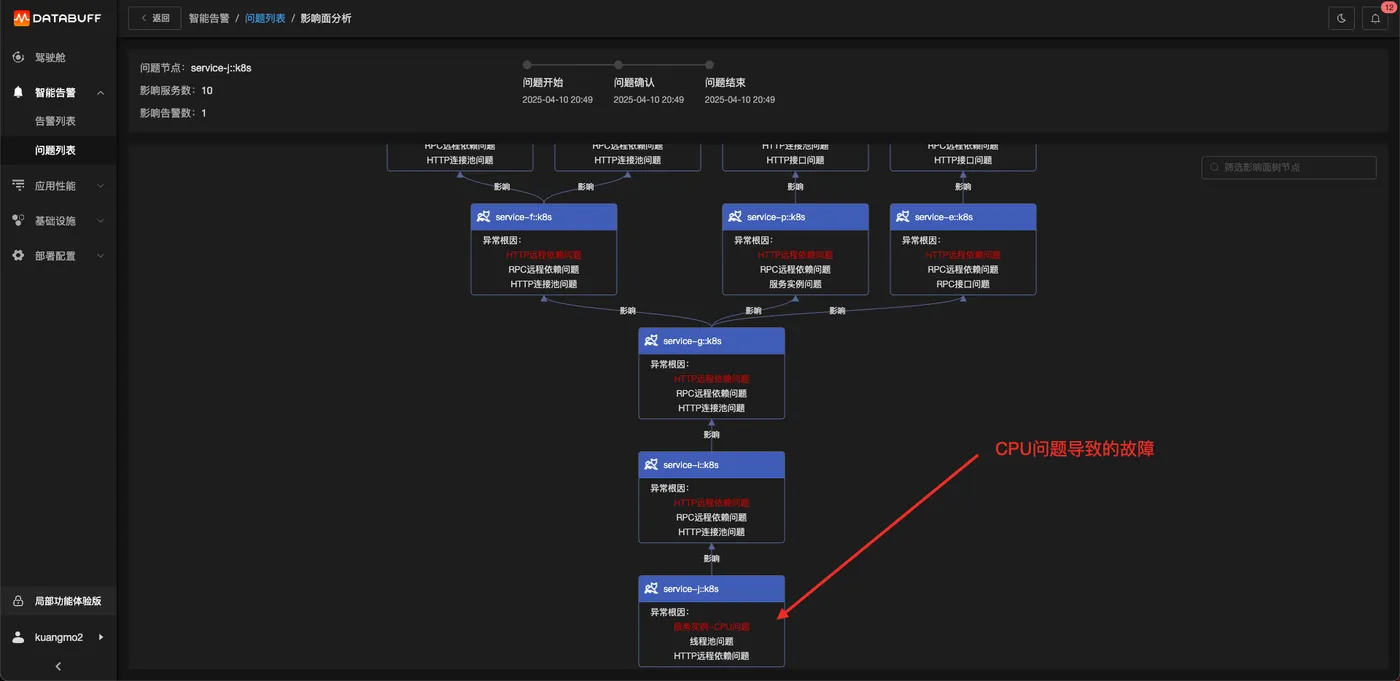
点击根因节点
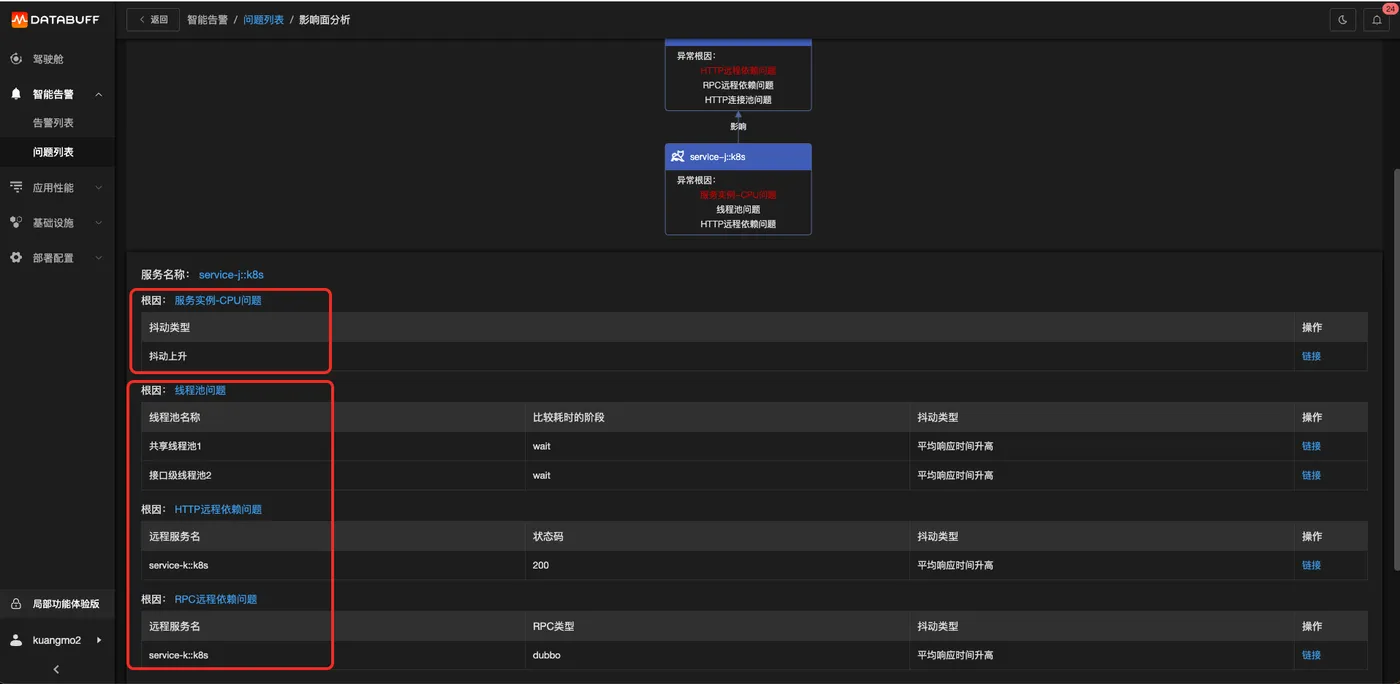
由于CPU问题会导致许多的组件访问都会出现问题,所以CPU的优先级会更高一些。
点击服务实例-CPU问题的地址链接,可以直接验证是否真的是CPU抖动上升了。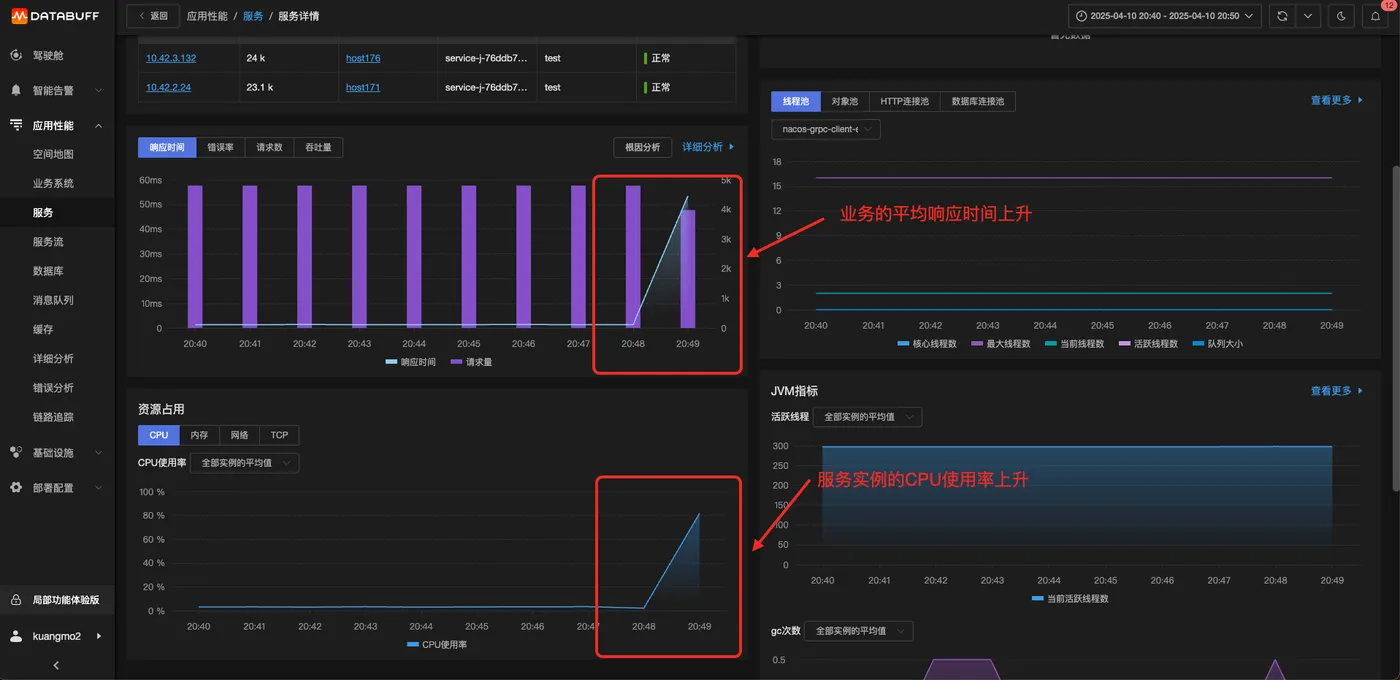
这个排查过程只需要几分钟就可完成。


