引言
本系列讲解 R语言中scRNA-seq数据分析 教程,持续更新,欢迎关注,转发!
简介
之前的分析主要关注单个细胞的状态。但在生物学中,细胞之间的通信可能同样重要,甚至更为关键。不过,细胞通信无法通过单细胞 RNA 测序(scRNA-seq)数据直接检测。通信通常依赖于受体蛋白和与之特异性结合的配体分子。如果已知配体和受体的配对关系,那么只要两种细胞共同表达这些相互作用的配体和受体,就可以推测它们之间可能存在通信。这正是目前许多工具用于研究细胞 - 细胞通信的原理。其中,由 Wellcome Sanger 研究所的 Sarah Teichmann 实验室开发的 CellPhoneDB 是最常用的工具之一。
依赖安装
在本教程的这一部分,以 DS4 数据为例,介绍如何利用单细胞 RNA 测序数据和 CellPhoneDB推断细胞类型之间的通信。
- 软件安装
conda create -n env_cellphonedb python=3.7
conda activate env_cellphonedb
pip install cellphonedb
接下来,需要为 CellPhoneDB 准备输入文件,具体包括:
- 一个 TSV 格式的表格,记录单细胞中的基因表达情况(其中行代表基因,列代表细胞)。
- 另一个 TSV 格式的表格,包含两列内容:第一列是细胞 ID(与基因表达表格中的列名一致),第二列是对应的细胞类型注释。
数据导入
现在,把数据导入 Seurat 并查看其内容。需要注意的是,细胞的注释信息已经包含在提供的元数据中了。
library(Seurat)
library(Matrix)
library(dplyr)

counts <- readMM("DS4/matrix.mtx.gz")
metadata <- read.table("DS4/metadata.tsv.gz")
features <- read.table("DS4/features.tsv.gz")[,1]
dimnames(counts) <- list(features, rownames(metadata))
seurat <- CreateSeuratObject(counts = counts, meta.data = metadata)

seurat <- NormalizeData(seurat) %>%
  FindVariableFeatures(nfeatures = 3000) %>%
  ScaleData() %>%
  RunPCA(npcs = 50) %>%
  RunUMAP(dims=1:20)

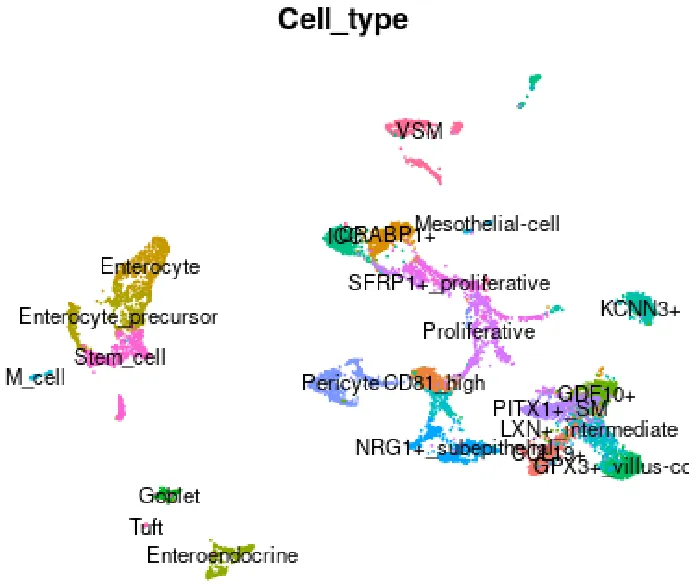
UMAPPlot(seurat_int, group.by="Cell_type", label=T) & NoAxes() & NoLegend()
生成CellPhoneDB需要的表格
expr_mat <- as.matrix(seurat@assays$RNA@data)
write.table(expr_mat, file="DS4/expr.txt", quote=F, sep="\t")
write.table(data.frame(Cell_bc = colnames(seurat), Cell_type = seurat$Cell_type),
            file="DS4/metadata.txt", row.names=F, quote=F, sep="\t")
接下来,运行CellPhoneDB
# go to the folder with the generated expr.txt and metadata.txt files
cd DS4

# make sure to activate the cellphonedb conda environment, if conda is used
conda activate env_cellphonedb

# run cellphonedb
cellphonedb method statistical_analysis --counts-data gene_name metadata.txt expr.txt
CellPhoneDB 通过随机置换细胞类型的标签(默认置换 1000 次)来评估细胞类型之间配体 - 受体相互作用的显著性。这一过程耗时较长,因此需要耐心等待。完成分析后,程序会默认生成一个名为 out 的文件夹,里面存放着 CellPhoneDB 的输出结果,通常包括以下四个文件:
deconvoluted.txtmeans.txtpvalues.txtsignificant_means.txt
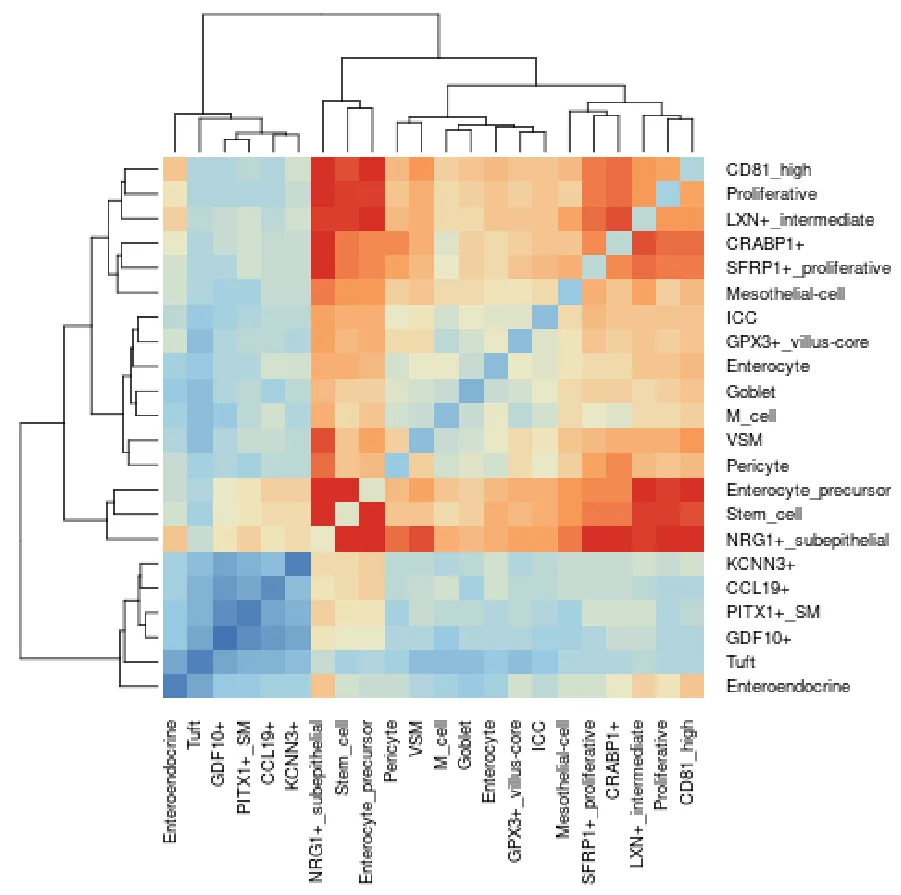
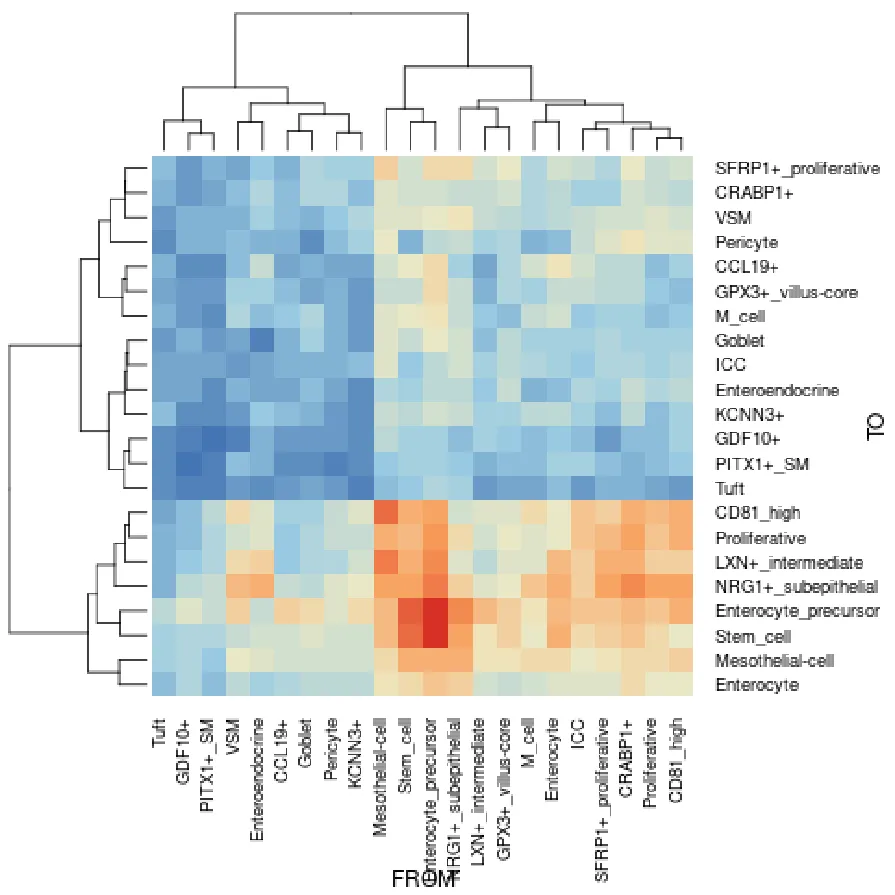
CellPhoneDB 提供了两种绘图功能(点图和热图),可以直接使用。当然,也可以用 R 语言自行绘图。以下是一个示例,展示如何绘制每两种细胞类型之间推断的相互作用对数。在这个图中,列代表分泌配体的细胞类型,而行代表接收信号的细胞类型。
library(gplots)

p <- read.csv("DS4_cellphonedb/out/pvalues.txt", header=T, sep="\t", check.names=F)
num_pairs <- colSums(p[,-(1:11)] < 0.01)
num_pairs <- data.frame(partner1 = sapply(strsplit(names(num_pairs),"\\|"),"[",1),
                        partner2 = sapply(strsplit(names(num_pairs),"\\|"),"[",2),
                        num = num_pairs)
mat_num_pairs <- sapply(sort(unique(num_pairs$partner1)), function(x)
  sapply(sort(unique(num_pairs$partner2)), function(y)
    num_pairs$num[which(num_pairs$partner1 == x & num_pairs$partner2 == y)]))

bluered_colscheme <- colorRampPalette(c("#4575B4","#9DCEE3","#EFE9C3","#FA9D59","#D73027"))
heatmap.2(mat_num_pairs + t(mat_num_pairs) - diag(diag(mat_num_pairs)),
          trace="none", scale="none", col = bluered_colscheme(30), key=F, keysize=0.8, margins = c(9,9))
还可以依据 CellPhoneDB 输出结果中的相关信息,将信号的来源细胞和目标细胞区分开来。
p <- p[p$secreted=="True" &
         ((p$receptor_a == "True" & p$receptor_b == "False") |
          (p$receptor_a == "False" & p$receptor_b == "True")),]

idx <- which(p$receptor_a == "False")
num_pairs <- colSums(p[idx,-(1:11)] < 0.05)
num_pairs <- data.frame(from = sapply(strsplit(names(num_pairs),"\\|"),"[",1),
                        to = sapply(strsplit(names(num_pairs),"\\|"),"[",2),
                        num = num_pairs)
idx <- which(p$receptor_a == "True")
num_pairs_2 <- colSums(p[idx,-(1:11)] < 0.05)
num_pairs_2 <- data.frame(from = sapply(strsplit(names(num_pairs_2),"\\|"),"[",2),
                          to = sapply(strsplit(names(num_pairs_2),"\\|"),"[",1),
                          num = num_pairs_2)
num_pairs$num <- num_pairs$num + num_pairs_2$num
mat_num_pairs <- sapply(sort(unique(num_pairs$from)), function(x)
  sapply(sort(unique(num_pairs$to)), function(y)
    num_pairs$num[which(num_pairs$from == x & num_pairs$to == y)]))

bluered_colscheme <- colorRampPalette(c("#4575B4","#9DCEE3","#EFE9C3","#FA9D59","#D73027"))
heatmap.2(mat_num_pairs,
          trace="none", scale="none", col = bluered_colscheme(30), key=F, keysize=0.8, margins = c(9,9),
          xlab="FROM", ylab="TO")
COMUNET
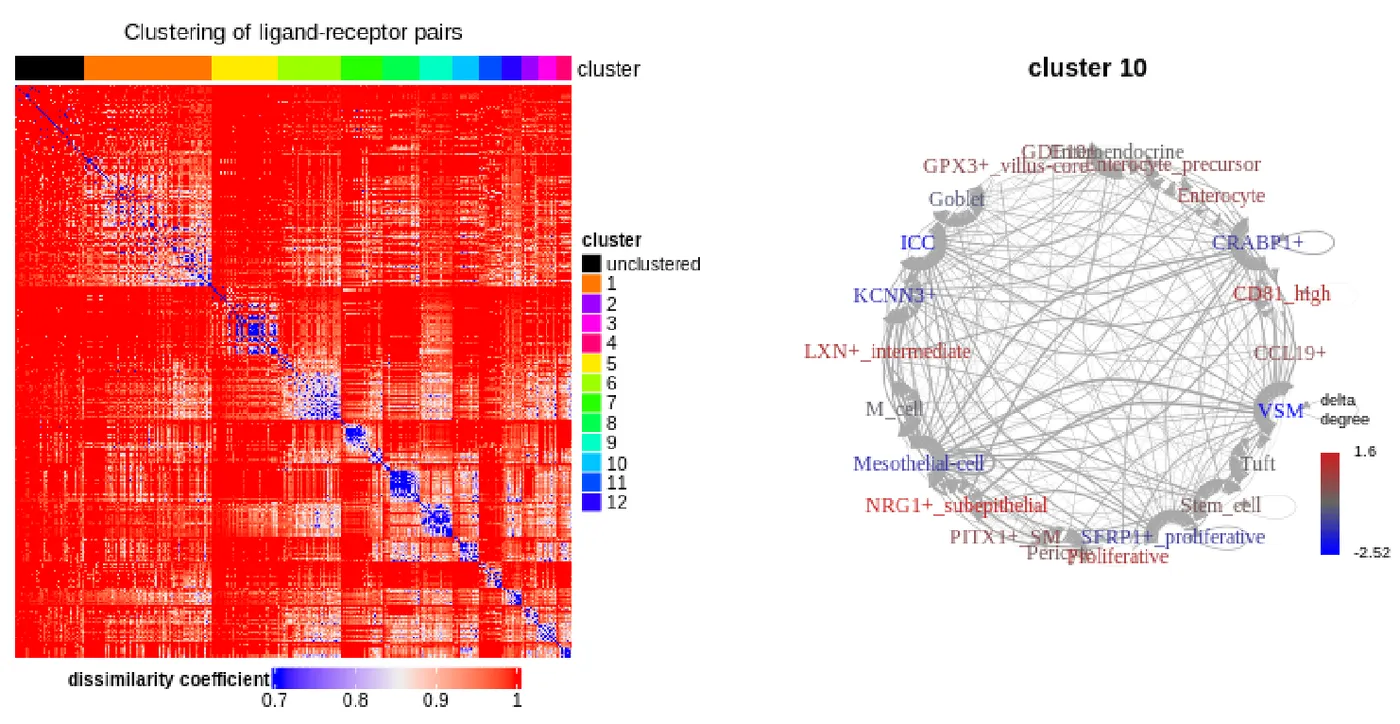
除了 CellPhoneDB 的基本分析结果之外,还可以借助其他工具进一步挖掘更多信息。这里介绍一个名为 COMUNET 的工具,它是由慕尼黑亥姆霍兹研究中心的 Antonio Scialdone 实验室开发的 R 包。该工具能够基于 CellPhoneDB 的输出结果,提供更深入的统计分析,例如对细胞间通信进行聚类分析等。
接下来,继续在 R 环境中进行操作。
# install COMUNET
devtools::install_github("ScialdoneLab/COMUNET/COMUNET")
# You may fail to install COMUNET with the error of SMDTools being missing and cannot be installed.
# This is because SMDTools has been removed from the CRAN repository.
# In that case, one can install the package from its archive, as following
install.packages("R.utils")
install.packages("https://cran.r-project.org/src/contrib/Archive/SDMTools/SDMTools_1.1-221.2.tar.gz")
devtools::install_github("ScialdoneLab/COMUNET/COMUNET")

library(COMUNET)
# read CellPhoneDB complex and gene info
complex_input <- read.csv("https://raw.githubusercontent.com/Teichlab/cellphonedb-data/master/data/complex_input.csv")
complex_input$complex_name <- gsub("_", " ", complex_input$complex_name)
gene_input <- read.csv("https://raw.githubusercontent.com/Teichlab/cellphonedb-data/master/data/gene_input.csv")

# read CellPhoneDB output
CellPhoneDB_output <- read.csv("out/significant_means.txt", sep = "\t", check.names = F)
CellPhoneDB_output <- CellPhoneDB_output[!duplicated(CellPhoneDB_output$interacting_pair),]
rownames(CellPhoneDB_output) <- CellPhoneDB_output$interacting_pair
CellPhoneDB_output$receptor_a <- CellPhoneDB_output$receptor_a == "True"
CellPhoneDB_output$receptor_b <- CellPhoneDB_output$receptor_b == "True"

# Convert to COMUNET format
interactions <- convert_CellPhoneDB_output(CellPhoneDB_output = CellPhoneDB_output,
                                           complex_input = complex_input,
                                           gene_input = gene_input)

# Run communication clusters analysis
lrp_clusters <- lrp_clustering(weight_array = interactions$weight_array,
                               ligand_receptor_pair_df = interactions$ligand_receptor_pair_df,
                               nodes = interactions$nodes)

# Do heatmap
plot_cluster_heatmap(dissim_matrix = lrp_clusters$dissim_matrix,
                    lrp_clusters = lrp_clusters$clusters)

# Plot the communication mode of cluster 10 pairs as an example
cluster <- "cluster 10"
plot_communication_graph(LRP = cluster,
                         weight_array = lrp_clusters$weight_array_by_cluster[,,cluster],
                         ligand_receptor_pair_df = interactions$ligand_receptor_pair_df,
                         nodes = interactions$nodes,
                         is_cluster = T)