RAG入门:理解检索增强生成模型的基本原理

简介: 【10月更文挑战第21天】作为一名长期从事自然语言处理(NLP)研究的技术人员,我一直在关注各种新兴技术的发展趋势。其中,检索增强生成(Retrieval-Augmented Generation, RAG)模型引起了我的特别兴趣。RAG技术结合了检索系统和生成模型的优点,旨在解决传统生成模型在处理长文本理解和生成时所面临的挑战。本文将从个人的角度出发,介绍RAG的基本概念、工作原理及其相对于传统生成模型的优势,并探讨一些基本的实现方法。

作为一名长期从事自然语言处理(NLP)研究的技术人员,我一直在关注各种新兴技术的发展趋势。其中,检索增强生成(Retrieval-Augmented Generation, RAG)模型引起了我的特别兴趣。RAG技术结合了检索系统和生成模型的优点,旨在解决传统生成模型在处理长文本理解和生成时所面临的挑战。本文将从个人的角度出发,介绍RAG的基本概念、工作原理及其相对于传统生成模型的优势,并探讨一些基本的实现方法。
1111.png

RAG的概念

RAG模型是一种结合了检索技术和生成技术的新型模型。它通过在生成过程中引入外部知识来源,增强了模型的理解和生成能力。相比于传统的生成模型,RAG能够在生成过程中利用外部数据集中的信息,从而生成更准确、更详细的内容。

RAG的工作原理

传统生成模型的局限性

在传统的生成模型中,如Transformer等,模型完全依赖于其内部参数来生成文本。这意味着,模型的生成能力受限于训练数据的多样性和丰富程度。当涉及到特定领域或需要大量背景知识的情况时,传统模型往往表现不佳。

引入外部知识

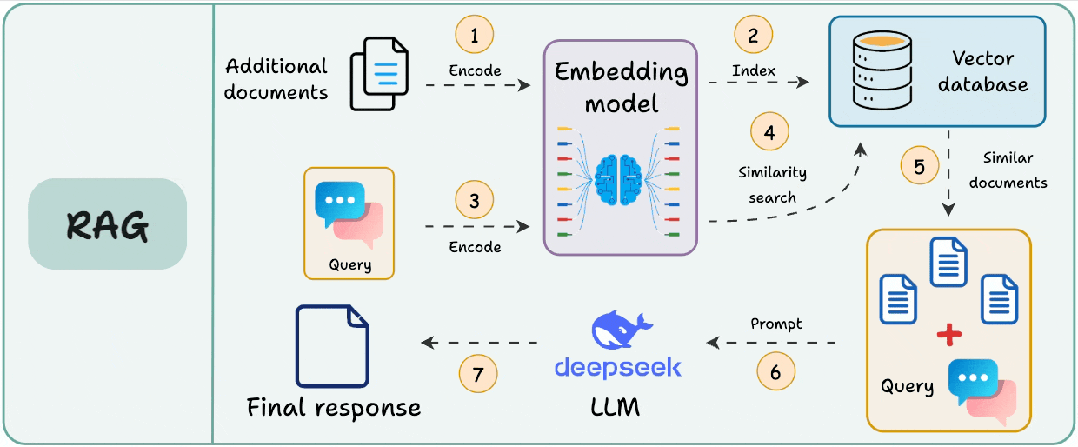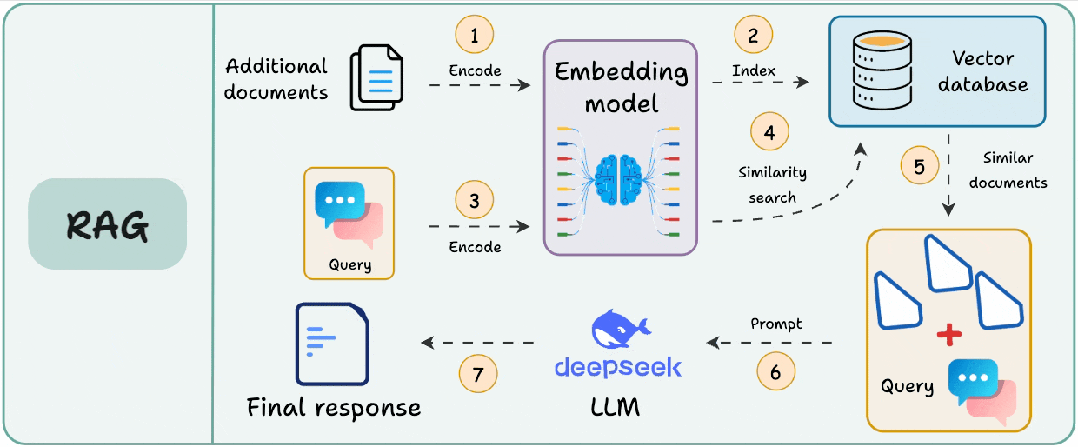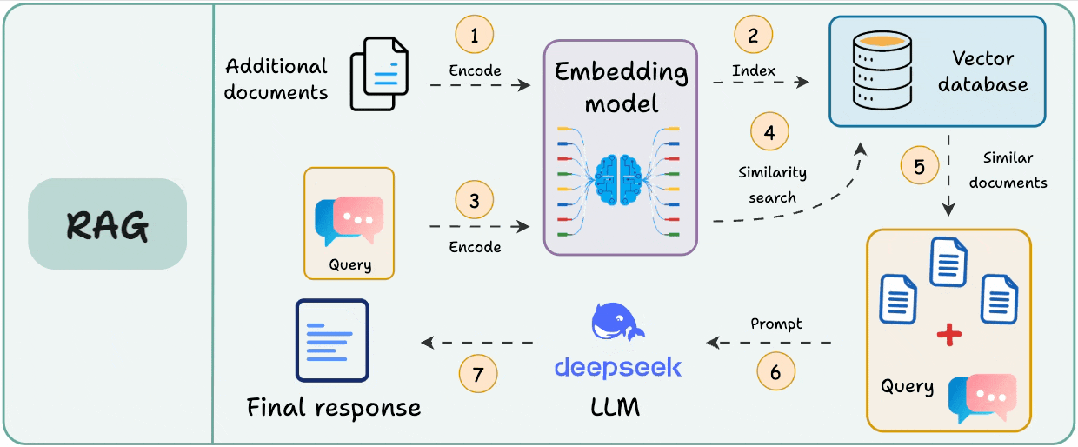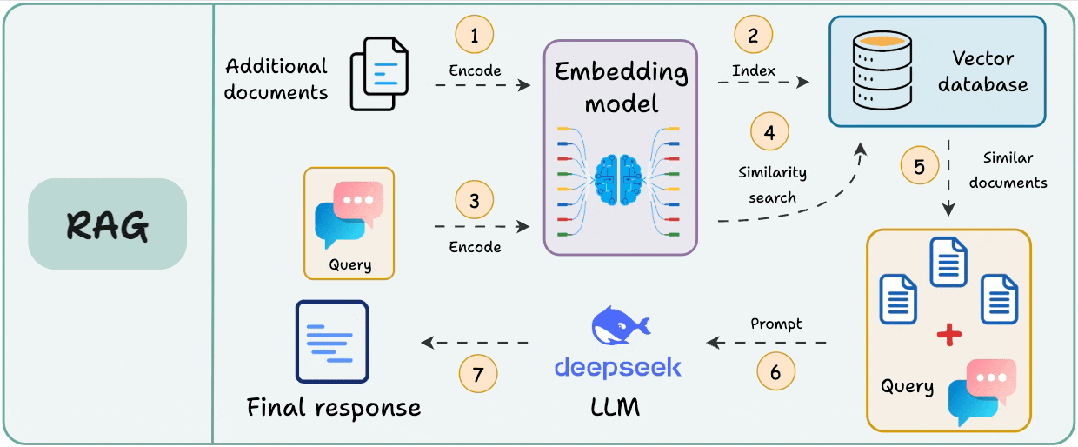
RAG模型通过引入外部知识来弥补这一不足。在生成过程中,模型会首先根据输入查询检索相关的文档或片段,然后利用检索到的信息来辅助生成。这样一来,即使模型本身没有见过相关数据,也可以通过检索来获取必要的上下文信息,从而生成更为准确的内容。

检索与生成的结合

在RAG模型中,检索与生成是紧密相连的两个步骤。首先,模型会对输入进行编码,并将编码后的向量用于检索。检索阶段的目标是从外部知识库中找到最相关的文档或片段。然后,这些检索到的信息会被整合进解码阶段,以帮助生成更高质量的文本。

RAG相较于传统生成模型的优势

更好的信息利用

通过引入外部知识库,RAG模型能够更好地利用信息,尤其是在处理长文本或需要专业知识的场景下。

更高的生成质量

由于RAG可以访问外部知识库,因此它生成的文本通常比仅依赖内部参数的传统模型更具信息量,更加准确。

更强的泛化能力

RAG模型在未见过的数据上表现更好,因为它们可以从外部知识库中获取相关信息,从而增强了模型的泛化能力。

实现RAG的基本方法

构建检索索引

构建一个有效的检索索引是实现RAG模型的第一步。索引应该包含大量的文档或片段,这些文档需要经过预处理,以便于检索。通常,我们会使用词嵌入技术来将文档转换为向量形式,然后使用诸如Faiss这样的库来建立索引。

import faiss
import numpy as np

# 假设doc_vectors是一个文档向量列表
dim = len(doc_vectors[0])
index = faiss.IndexFlatL2(dim)
index.add(np.array(doc_vectors))

选择检索策略

在检索阶段,我们需要选择合适的检索策略。常见的策略包括基于向量相似度的检索、基于关键词匹配的检索等。根据应用场景的不同,选择不同的检索策略可以获得更好的效果。

query_vector = model.encode_query(query)
top_k = index.search(query_vector, k=5)

实验结果分析

在实现RAG模型后,我们应该对其性能进行评估。可以通过比较RAG模型与传统生成模型在相同任务上的表现来评估其效果。此外,还可以通过人工评估生成文本的质量,以及模型在不同数据集上的泛化能力来进一步验证RAG的有效性。

结语

RAG技术为自然语言生成领域带来了新的可能性,它通过结合检索和生成两种技术的优势,使得生成的文本更加准确、详细。作为一名技术人员,我对RAG模型的发展充满期待,并希望通过本文的介绍,能够帮助初次接触RAG技术的读者们更好地理解和掌握这一前沿技术。未来,随着技术的不断进步,相信RAG将在更多领域发挥重要作用。

目录
相关文章
|
9月前
|
XML 算法 安全
详解RAG五种分块策略,技术原理、优劣对比与场景选型之道
RAG通过检索与生成结合,提升大模型在企业场景中的准确性与可控性。分块策略是其核心,直接影响检索效率与回答质量。本文系统解析固定大小、语义、递归、基于结构和LLM的五种分块方法,对比优缺点及适用场景,并探讨RAG在知识关联、多模态理解等方面的前沿挑战与优化路径。
591 0
详解RAG五种分块策略,技术原理、优劣对比与场景选型之道
|
存储 安全 编译器
【C++ 17 新功能 std::visit 】深入解析 C++17 中的 std::visit:从原理到实践
1860 1
|
11月前
|
人工智能 IDE Java
AI Coding实践:CodeFuse + prompt 从系分到代码
在蚂蚁国际信贷业务系统建设过程中,技术团队始终面临双重考验:一方面需应对日益加速的需求迭代周期,满足严苛的代码质量规范与金融安全合规要求;另一方面,跨地域研发团队的协同效率与代码标准统一性,在传统开发模式下逐渐显现瓶颈。为突破效率制约、提升交付质量,我们积极探索人工智能辅助代码生成技术(AI Coding)的应用实践。本文基于蚂蚁国际信贷技术团队近期的实际项目经验,梳理AI辅助开发在金融级系统快速迭代场景中的实施要点并分享阶段性实践心得。
2250 25
AI Coding实践:CodeFuse + prompt 从系分到代码
|
6月前
|
人工智能 数据挖掘 API
科研效率提升10倍!OpenClaw(Clawdbot)零技术部署+阿里云百炼API配置+集成科研Skill全家桶,论文/课题成稿全自动!
对科研人而言,80%的时间都消耗在文献检索、综述整理、数据清洗等重复劳动上,真正用于创新思考的时间不足20%。OpenClaw(原Clawdbot)的出现彻底改变了这一现状——它并非传统的聊天AI,而是能主动“动手干活”的科研自动化平台,搭配ClawHub上5700+科研专属Skill,可实现文献检索、综述撰写、课题申报、数据分析、论文成稿的全流程自动化,让科研人从“搬砖工”升级为“监工”,效率提升5-20倍。
3577 3
|
7月前
|
存储 自然语言处理 数据库
技术选型困惑:祝福生成该选微调还是RAG
祝福生成场景更适配微调而非RAG:微调可固化统一风格、提升内容可控性、实现毫秒级响应、降低部署成本;而RAG依赖检索,易致风格飘忽、延迟高、维护复杂。知识稳定的祝福场景,微调是更优解。
|
8月前
|
数据采集 SQL 敏捷开发
2026年企业数据系统建设方案全解析:从规划到落地的选型指南
2026年,企业数据跃升为战略核心。本文深度解析瓴羊Dataphin——集统一建模、智能开发、全链路治理、资产服务化与合规内嵌于一体的AI时代数据中台引擎,提供从规划到落地的端到端选型与实施指南。(239字)
|
存储 数据库
RAG分块技术全景图:5大策略解剖与千万级生产环境验证
本文深入解析RAG系统中的五大文本分块策略,包括固定尺寸、语义、递归、结构和LLM分块,探讨其工程实现与优化方案,帮助提升知识检索精度与LLM生成效果。
1738 1