1 背景
之前在专栏中讲过“不推荐使用属性拷贝工具”,推荐直接定义转换类和方法使用 IDEA 插件自动填充 get / set 函数。
不推荐的主要理由是:
有些属性拷贝工具性能有点差 有些属性拷贝工具有“BUG” 使用属性拷贝工具容易存在一些隐患(后面例子会讲到)
基于 Spring Boot + MyBatis Plus + Vue & Element 实现的后台管理系统 + 用户小程序,支持 RBAC 动态权限、多租户、数据权限、工作流、三方登录、支付、短信、商城等功能
2 示例
首先公司内部就遇到过 commons 包的 BeanUtils 进行属性拷贝性能较差的真实案例,然后该同事换成了 Spring 的 BeanUtils 性能好了很多,感兴趣大家可以使用性能测试框架或者基准测试框架去对比,这里就不对比了。
接下来我们看 Spring 的 BeanUtils 的属性拷贝会存在啥问题:
import lombok.Data;
import java.util.List;
@Data
public class A {
    private String name;
    private List<Integer> ids;
}
@Data
public class B {
    private String name;
    private List<String> ids;
}
import org.springframework.beans.BeanUtils;
        import java.util.Arrays;
public class BeanUtilDemo {
    public static void main(String[] args) {
        A first = new A();
        first.setName("demo");
        first.setIds(Arrays.asList(1, 2, 3));
        B second = new B();
        BeanUtils.copyProperties(first, second);
        for (String each : second.getIds()) {// 类型转换异常
            System.out.println(each);
        }
    }
}
大家运行上述示例时,会发生类型转换异常。
打断点可以看到,属性拷贝之后 B 类型的 second 对象中 ids 仍然为 Integer 类型:
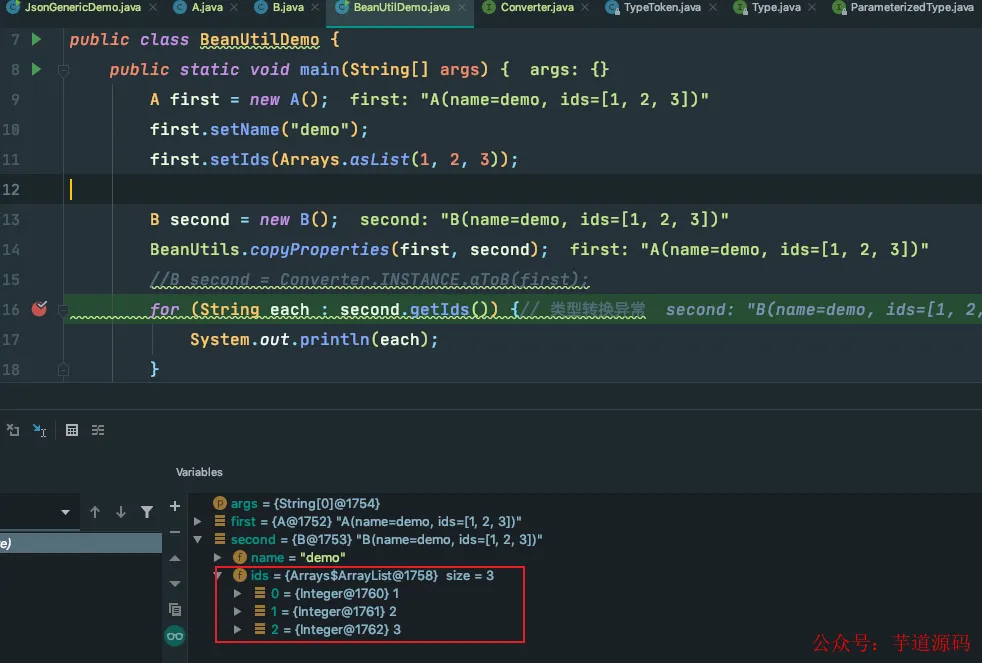
如果不转换为字符串,直接进行打印,并不会报错。
使用CGlib 在不定义Converter 的情况下也会遇到类似问题:
import org.easymock.cglib.beans.BeanCopier;
import java.util.Arrays;
public class BeanUtilDemo {
    public static void main(String[] args) {
        A first = new A();
        first.setName("demo");
        first.setIds(Arrays.asList(1, 2, 3));
        B second = new B();
        final BeanCopier beanCopier = BeanCopier.create(A.class, B.class, false);
        beanCopier.copy(first,second,null);
        for (String each : second.getIds()) {// 类型转换异常
            System.out.println(each);
        }
    }
}
同样,问题在运行时才暴露出来。
接下来我们看下 mapstruct:
import org.mapstruct.Mapper;
import org.mapstruct.factory.Mappers;
@Mapper
public interface Converter {
    Converter INSTANCE = Mappers.getMapper(Converter.class);
    B aToB(A car);
}
import java.util.Arrays;
public class BeanUtilDemo {
    public static void main(String[] args) {
        A first = new A();
        first.setName("demo");
        first.setIds(Arrays.asList(1, 2, 3));
        B second = Converter.INSTANCE.aToB(first);
        for (String each : second.getIds()) {// 正常
            System.out.println(each);
        }
    }
}
可以成功的将 A 中 List<Integer> 转为 B 中的 List<String> 类型。
我们看下编译生成的 Converter 实现类:
import java.util.ArrayList;
import java.util.List;
import javax.annotation.Generated;
import org.springframework.stereotype.Component;
@Generated(
        value = "org.mapstruct.ap.MappingProcessor",
        comments = "version: 1.3.1.Final, compiler: javac, environment: Java 1.8.0_202 (Oracle Corporation)"
)
@Component
public class ConverterImpl implements Converter {
    @Override
    public B aToB(A car) {
        if ( car == null ) {
            return null;
        }
        B b = new B();
        b.setName( car.getName() );
        b.setIds( integerListToStringList( car.getIds() ) );
        return b;
    }
    protected List<String> integerListToStringList(List<Integer> list) {
        if ( list == null ) {
            return null;
        }
        List<String> list1 = new ArrayList<String>( list.size() );
        for ( Integer integer : list ) {
            list1.add( String.valueOf( integer ) );
        }
        return list1;
    }
}
自动帮我们进行了转换,我们可能没有意识到类型并不一致。
如果我们在 A 类中添加一个 String number 属性,在 B 类中添加一个 Long number 属性,使用 mapstruect 当 number 设置为非数字类型时就会报 .NumberFormatException。
@Override
public B aToB(A car) {
        if ( car == null ) {
        return null;
        }
        B b = new B();
        b.setName( car.getName() );
        if ( car.getNumber() != null ) { // 问题出在这里
        b.setNumber( Long.parseLong( car.getNumber() ) );
        }
        b.setIds( integerListToStringList( car.getIds() ) );
        return b;
        }
使用 cglib 默认则不会映射 number 属性,B 中的 number 为 null。
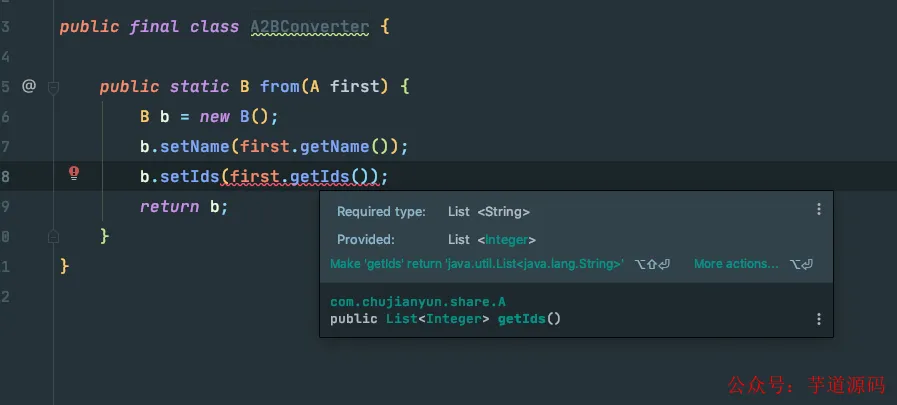
如果手动定义转换器,使用 IDEA 插件(如 generateO2O)自动转换:
public final class A2BConverter {
    public static B from(A first) {
        B b = new B();
        b.setName(first.getName());
        b.setIds(first.getIds());
        return b;
    }
}
在编码阶段就可以非常明确地发现这个问题:
基于 Spring Cloud Alibaba + Gateway + Nacos + RocketMQ + Vue & Element 实现的后台管理系统 + 用户小程序,支持 RBAC 动态权限、多租户、数据权限、工作流、三方登录、支付、短信、商城等功能
3 结论
由于 Java 的泛型其实是编译期检查,编译后泛型擦除,导致运行时 List<Integer> 和 List<String> 都是 List 类型,可以正常赋值。这就导致在使用很多属性映射工具时,编译时不容易明显的错误。
mapstruct 自定义了注解处理器,在编译阶段可以读取映射双方的泛型类型,进而进行映射。但是这种映射也很可怕,有时候我们由于粗心等原因定义错了类型,自动帮助我们进行了转换,会带了很多副作用。
之前对各种属性映射工具的性能进行了简单的对比,结果如下:
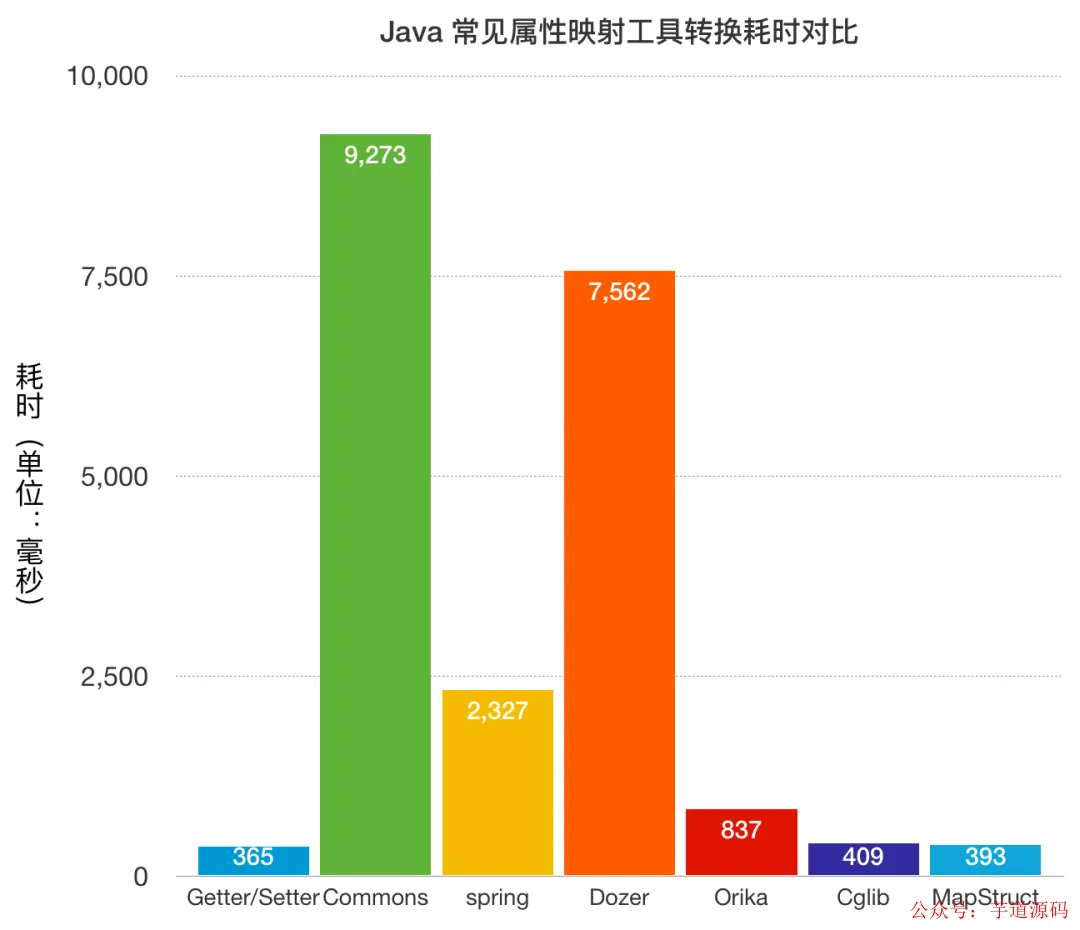
因此慎用属性转换工具,如果可能建议自定义转换类,使用IDEA插件自动填充,效率也挺高, A 或 B 中任何属性类型不匹配,甚至删除一个属性,编译阶段即可报错,而且直接调用 get set 的效率也是非常高的。