
摘要:已有 Yahoo Finance / yfinance 股票原型,准备换数据源时,怎样判断历史图表还能不能继续用?这篇结合AAPL五个交易日的公开历史表与接口返回,拆清价格调整、日期缺失和显示精度的差别,解释为什么收盘价相同仍不足以确认上线。附两张图、完整Python对照工具和功能验收表,帮助负责交付行情产品的人把问题分配到具体步骤。
给股票看板换数据源,最难交代的往往是历史图表为什么变了。原来能用的功能,接到新数据后,哪些可以保留,哪些需要重新验证?
这次核对AAPL的五个历史交易日,Yahoo官方历史页的收盘展示数值与TickDB接口返回相同,但原版对照工具仍要求先确认口径。11月4日的开盘值还出现了半美分尾差,让“看起来对上了”多了一层需要解释的条件。
如果你负责把金融应用原型推向上线,需要的是一套能和开发者共同执行的判断方法:先确认两份数据在说同一件事,再找出记录缺失与数值差异,最后落实到每项功能的处理决定。文末工具负责把记录列清楚,数据定义与上线决定仍由实际核对来支撑。
1. 最容易踩的坑:关闭自动调整,也未必拿到不复权价格
假设旧脚本里有这样一个设置:
auto_adjust=False
看到 False,很容易理解成“没有做价格调整”。接入新 API 时,再选一个“不复权”选项,似乎就能直接比较。
这里恰好藏着一个关键差别。
按 yfinance 的价格调整文档,auto_adjust=False 返回的开盘、最高、最低、收盘价,仍是 Yahoo 已做过拆股调整的序列;这四列合称 OHLC。其中的 Adj Close 还包含分红调整。设为 True 时,OHLC 也会随调整后价格作相应处理。
所以,关闭自动调整这个选项名称,并不能让它自动等同于另一套接口里的“不复权”。
为什么这值得产品负责人关心?因为历史图表展示的是同一条价格序列。只要调整基础变了,图形、区间涨跌幅,以及依赖价格计算的结果,就需要重新检查。两个字段都叫 close,只说明名字相同。
一个有用的验收选样是跨越公司行动的区间。Apple 在2020年公告4拆1,安排8月31日起按拆股调整基础交易。如果产品需要展示这段历史,就应把相应区间放入测试。只看没有跨越拆股的近期样本,未必能发现这个问题。
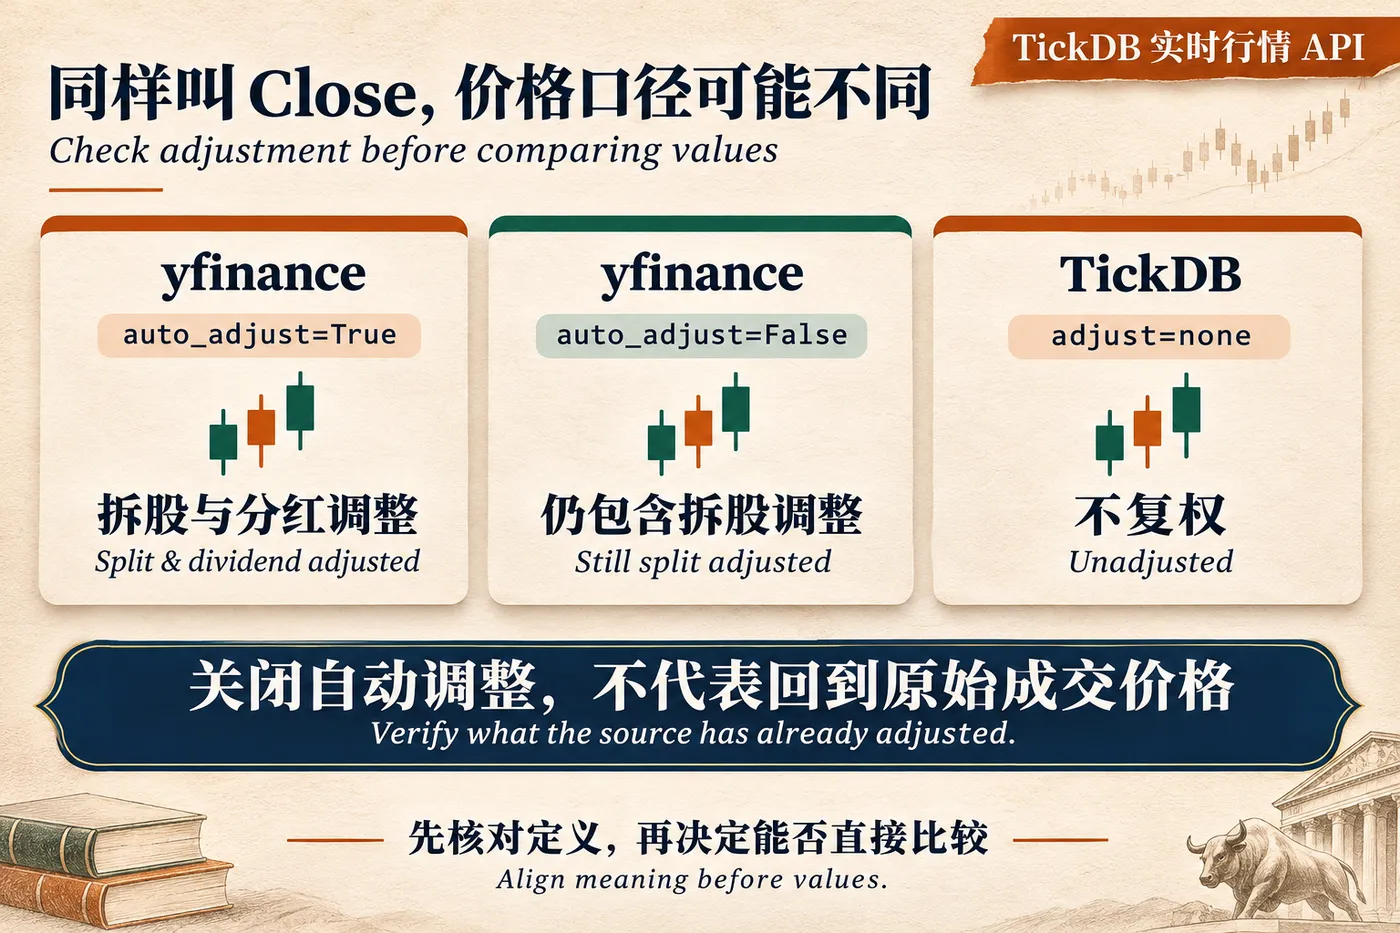
图1:AI概念示意,解释价格调整定义。图中K线形状不是真实行情,也不是两套数据源的对比结果。
迁移前,最好把旧脚本的这些信息一并留下:
- 实际运行的 yfinance 版本,以及
auto_adjust设置。 - 有没有启用
repair,导出后是否又做过修复、填充或删行。 - 实际取回的日期范围。yfinance 的
end是排他边界,不能把输入的结束日直接当成最后一条记录的日期。 - 是否包含盘前盘后,时间和交易日期按什么规则解释。
这些信息应从自己的代码与导出记录中找,今天文档里的默认值不能倒推旧脚本当时的行为。
2. 两边都是3行,为什么仍然可能漏数据?
看一个很小的例子。下面全部是合成软件测试数据,DEMO_A 不是证券,日期和价格都为测试而设,没有使用 Yahoo 或 TickDB 行情。
旧表有1月5日、6日、8日;新表有1月5日、7日、8日。两边都是3行。
如果只核对行数,检查就结束了。如果只比较两边都有的日期,6日和7日又会被跳过。真正需要的,是把两张表按证券身份与交易日期放在一起,保留所有未匹配记录。
再加上一份独立的“预期记录清单”,要求这个测试覆盖1月5日至9日,结果会变成:
| 日期 | 旧表 | 新表 | 需要处理的事 |
|---|---|---|---|
| 1月5日 | 有 | 有,数值相同 | 继续检查对应功能 |
| 1月6日 | 有 | 没有 | 查新侧原始记录、筛选和日期处理 |
| 1月7日 | 没有 | 有 | 查旧侧是否漏取或过滤 |
| 1月8日 | 收盘11 | 收盘11.05 | 查清0.05差异来自哪里 |
| 1月9日 | 没有 | 没有 | 先核对预期清单,再调查共同缺失 |
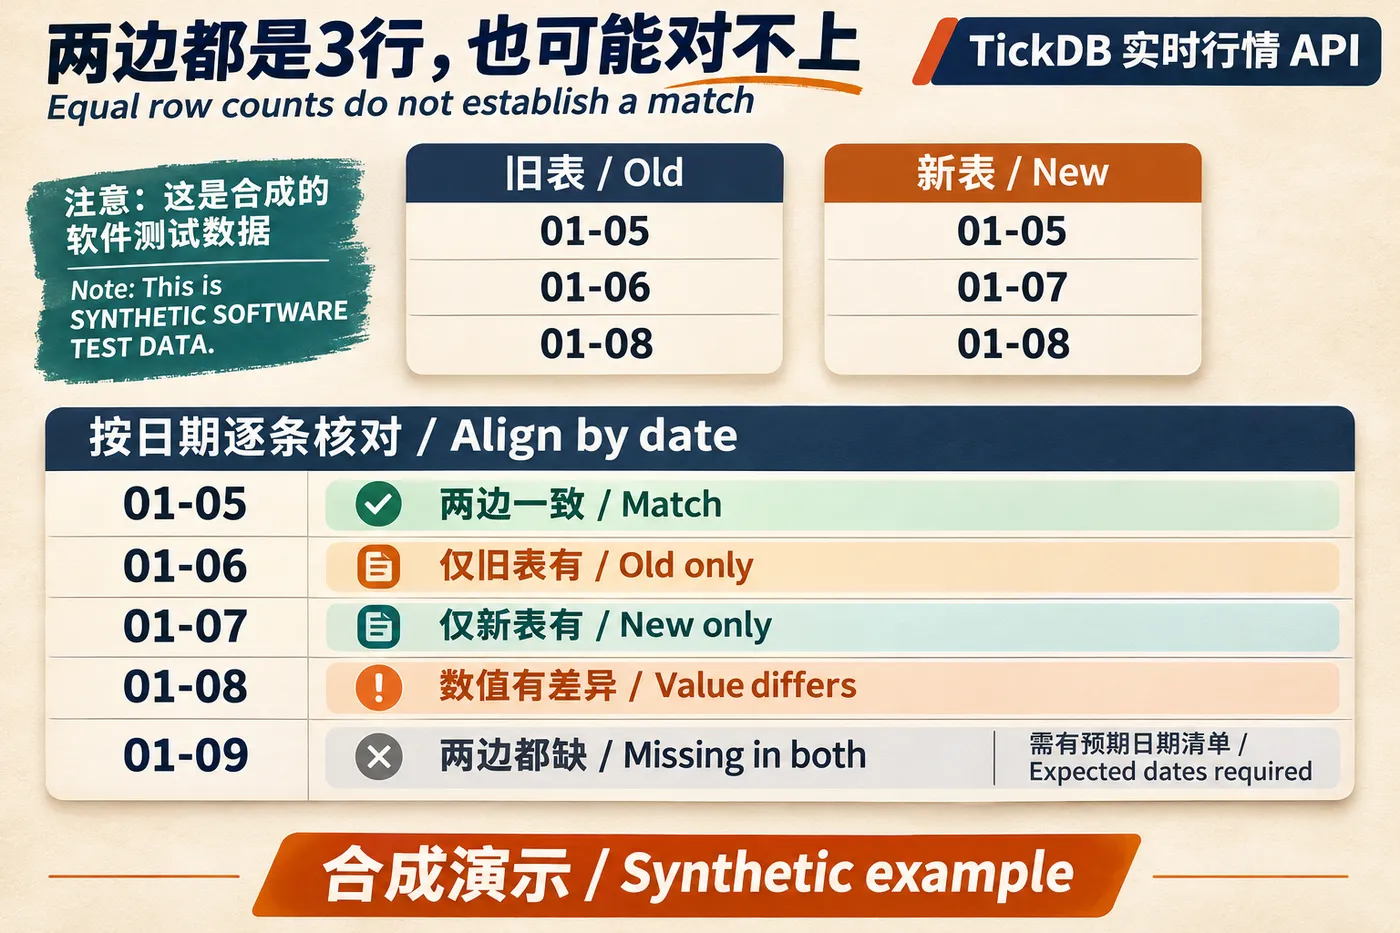
图2:AI概念示意,对应上述合成测试。实际工具输出包含CSV、JSON和浏览器可打开的对照页。
这个例子里有两个容易忽略的地方。
两边都没有的记录,需要第三份依据才能找出来。 只拿旧、新两张表互相检查,无法知道它们共同漏掉了什么。真实项目里的预期清单,应由交易日安排、产品覆盖要求和个股状态共同确定,不能简单地把工作日都当成应有记录。
查出价格差异,还没有查出原因。 11与11.05不同,可能需要核对调整设置、字段定义或处理过程。直接设一个“相差1%以内算通过”的阈值,会把尚未解释的问题藏起来。
工具还会先检查重复记录。相同股票、相同日期出现多行时,应查明为什么重复,避免错误地把一行匹配成多行。
3. 数据含义没对齐,先别算谁更准确
上面的价格比较还有一个前提:两份数据在比较同一种东西。
至少要把周期、币别、交易阶段、价格调整基础和交易日期的定义对应起来。比如一边是日线,另一边是分钟线;一边已经调整拆股,另一边是不复权,算出的差值并不能直接回答数据质量问题。
文末工具会先检查这些条件。条件未知、不同,或尚未经人工核对时,匹配到的记录会标成 NOT_COMPARABLE,含义就是“目前不能比较数值”。日期覆盖仍然可以看,价格差值先不计算。
其中的 comparability_id 用来记录双方共同对应的那份可比性确认依据。它不是某家服务商的参数,也不会自动验证价格公式;填写相同文字之前,需要实际核对双方定义与处理过程。
这里尤其要避免一个动作:为了让工具通过,把两份配置都改成相同标签。设置记录应描述数据实际是什么;如果两边基础不同,需要先核实、转换或调整验收范围,再重新比较。
这份工具只处理日线OHLC。实时报价还涉及最近成交、买卖报价等价格对象,以及行情事件时间和交易阶段;不同时间取得的两个快照,不能直接按日线方法判定价格对错。
4. 看一次真实核对:收盘价相同,开盘却差了半分钱
这次选 AAPL 的2026年11月2—6日,核对两个实际来源:Yahoo 官方历史页的展示值,以及 TickDB REST 返回的日线。Yahoo 数据来自搜索工具读取到的官方历史页快照;当前环境直接访问其查询接口超时,因此没有把这次操作写成 yfinance 导出或两侧API同时取样。
TickDB提供股票行情数据,本例用它取得候选新侧的历史K线。请求在2026年11月12日00:00北京时间完成,使用 interval=1d、adjust=none,HTTP 200、业务 code=0。返回的20根日线全部保留,本次选择其中五个已经过去的交易日期。
下表保留来源各自的显示位数,单位为美元:
| 日期 | Yahoo开盘展示值 | TickDB开盘原值 | Yahoo收盘展示值 | TickDB收盘原值 |
|---|---|---|---|---|
| 11月2日 | 342.67 | 342.67 | 338.32 | 338.32 |
| 11月3日 | 325.58 | 325.58 | 331.90 | 331.9 |
| 11月4日 | 341.57 | 341.565 | 349.51 | 349.51 |
| 11月5日 | 353.89 | 353.89 | 344.17 | 344.17 |
| 11月6日 | 338.73 | 338.73 | 342.37 | 342.37 |
五个日期标签都有记录,收盘展示数值相同。11月4日的开盘价却值得停下来看看:一侧为 341.57,另一侧为 341.565,相差 0.005 美元,也就是半美分。
此时就给供应商判对错,依据还不够。我们看到了显示位数不同,尚未确认底层精度、价格处理和聚合规则。
如果应用选择把价格显示到两位小数,可以单独规定舍入策略。例如:
from decimal import Decimal, ROUND_HALF_UP

raw_open = "341.565"
display_open = Decimal(raw_open).quantize(Decimal("0.01"), rounding=ROUND_HALF_UP)
print(display_open)  # 341.57
这段代码展示的是应用自己的显示选择,并没有确认 Yahoo 内部采用同一种舍入方法。存储和计算仍保留原值,显示相同也不能代替价格口径确认。
为什么程序仍然停在“不可比”?
这次把真实输入交给文末的原版工具,结果是:
NOT_COMPARABLE: 5
ALIGN_METADATA_BEFORE_VALUES
HUMAN_REVIEW_REQUIRED
还缺的依据很具体:Yahoo历史页对价格有拆股调整说明,TickDB本例选择不复权;交易阶段与日线聚合日期的共同定义尚未确认,也没有还原原脚本的实际导出设置。
程序根据这些未确认或不同的条件暂停数值判断。它没有从价格自动推导哪套数据更准确,也没有因为收盘价接近就批准切换。
产品团队现在可以先把原值、显示小数位、舍入方式和来源标签分开处理;历史序列的迁移继续等待口径确认。这个案例形成的是一项清楚的处理决定,尚未执行生产页面切换。
需要查接口字段、参数和调用示例,可以参考 [官方API文档仓库]。本文的离线比较工具完整附在文末,先用合成演示理解输出,再放入自己的授权导出。
5. 查出差异后,怎样决定能不能上线?
回到前面的合成例子:一条相同、一条仅旧侧有、一条仅新侧有、一条价格不同,还有一条共同缺失。
此时的决定应是继续核对。接下来的工作已经很具体:
| 发现 | 下一步 | 对上线范围的影响 |
|---|---|---|
| 日期只出现在一边 | 核对原始记录、提取范围、过滤与日期转换,必要时重取 | 历史图表暂不通过完整性验收 |
| 对应日期价格不同 | 保留原值与差异列,调查价格调整和处理过程 | 原因查清前,不用任意阈值消掉问题 |
| 应有日期两边都没有 | 先复核预期清单,再查共同缺口 | 不把两源一致当成历史完整 |
| 文件比较完成 | 在测试页面检查图表、时间标签和缺失显示 | 继续功能验收 |
把“是否更换数据源”拆成“哪些功能可以切换”,会更容易推进。先选一个边界清楚的功能,保留旧路径,写清停止与回退条件,再扩大范围。这个做法借鉴了 Google SRE 的有限范围验证思路与 AWS 的渐进替换方法,小型应用可以从简单的切换配置开始。
下面这张表可以直接拿去和开发者沟通:
| 功能 | 要验收什么 | 结果与未解决项 | 决定及负责人 |
|---|---|---|---|
| 自选报价 | 证券身份、价格对象、行情时间、失败后的显示 | 待填 | 待填 |
| 历史图表 | 交易日期、OHLC、调整基础、最后一根K线状态 | 待填 | 待填 |
| 客户展示 | 实际使用场景与数据使用条件是否匹配 | 待填 | 待填 |
| 切换与回退 | 触发条件、来源标签、回退后的页面状态 | 待填 | 待填 |
数据对齐只是其中一项。即使样本里没有差异,持续更新、实际展示用途和回退也需要单独验收。
6. 把工具跑起来,先看自己的差异清单
完整代码放在文末。保存为 compare_migration.py,使用 Python 3.10 或更新版本即可运行,无需安装第三方库。
程序在本地读取文件,不联网、不需要密钥,也不会修改输入CSV。
先运行合成演示:
python3 compare_migration.py --demo --out compare_runs
终端会给出输出目录,打开其中的 comparison_view.html 就能看到对照页。另两个结果文件分别用于继续处理和留档:
row_comparison.csv:逐条查看旧新收盘价、缺失、重复与各价格列的差值。comparison_report.json:查看可比条件、输入文件摘要、分类数量和处理结论。
演示结果包含5类记录,各1条,对应第2节的表格,结论为 REVIEW_RECORD_DIFFERENCES。这次合成演示已实际运行;它检验工具的处理逻辑,不是供应商准确率测试。
换成自己的旧新CSV
先分别整理两份导出文件,使用单层表头:
symbol,trade_date,open,high,low,close
trade_date 使用含义已确认的 YYYY-MM-DD 交易日期。不要直接把一个尚未解释的UTC时间截成日期。symbol_map 用于把两边不同写法映射到同一证券身份,整理后的文件与原始导出分别保留。
再分别准备 old.meta.json 和 new.meta.json。下面是待填写结构,未知项会阻止数值比较:
{

  "source": "填写实际来源与版本",
  "interval": "1d",
  "currency": "unknown",
  "session": "unknown",
  "adjustment_basis": "unknown",
  "date_basis": "unknown",
  "comparability_id": "unknown",
  "semantics_reviewed": false,
  "symbol_map": {

    "AAPL": "AAPL.US"
  }
}
两份元信息分别描述各自文件。只有实际核对之后,才把 semantics_reviewed 设为 true。代码示例中的映射也要按自己的证券身份填写。
如果已经整理出预期记录清单,保存为 expected.csv,表头如下。清单中的证券代码使用映射后的统一写法:
symbol,trade_date
随后运行:
python3 compare_migration.py --old old.csv --new new.csv --old-meta old.meta.json --new-meta new.meta.json --expected expected.csv --out compare_runs
没有预期清单时,可以去掉 --expected expected.csv。程序会标记该项未检查,仍可找出两边已有记录中的单侧缺失与差异。
三个使用问题
还没有旧导出,从哪里开始?
先保留现有脚本、实际参数和一小段有权使用的导出。选择产品确实需要保留的一个功能与相应数据范围,再取得候选新样本;无需为了迁移演示下载整个市场。
工具报不可比或发现缺口,怎么办?
先看报告里的可比条件与记录状态。含义未知就查定义,日期缺失就查原文件和提取逻辑,重复就查证券与日期键。修正原因或重新提取后,另存新文件再运行,原文件保留以便追溯。
后续还想把实时报价也换过来,能继续用吗?
TickDB的报价快照可以作为那一步的输入,但应另设实时功能验收:价格对象是什么、行情时间对应何时、更新是否持续、失败怎样显示。文中的日线比较器不承担实时推送、断线恢复或生产切换。
下一次与开发者讨论时,可以先带着一份旧导出、一份候选新样本和这张验收表。把问题缩小到“这项功能还缺哪条依据”,比只讨论哪家API更好,更容易形成明确的下一步。
本轮真实案例与仓库核对:2026年11月12日;原方法资料核对:2026年11月11日。核心依据为 yfinance 的价格调整、下载参数与价格修复文档,以及 Apple 拆股公告;记录对齐与渐进验证方法参考 pandas、NYSE、Google SRE 和 AWS 的一手资料。图示与演示数据均为概念或合成测试,真实取样范围已在对应段落说明。
附:完整可运行代码
将下列代码完整保存为 compare_migration.py。工具会保留差异,要求人工解释;即使样本完全一致,输出也不会自动批准上线。
#!/usr/bin/env python3
"""Offline daily-OHLC comparison. Python 3.10+, standard library only.

--demo generates clearly labelled synthetic fixtures, never market observations.
No downloads, orders, automatic adjustment, fill-forward, or production cutover.
"""
import argparse
import csv
import hashlib
import html
import json
from collections import defaultdict
from datetime import date, datetime, timezone
from decimal import Decimal, InvalidOperation
from pathlib import Path

FIELDS = ("open", "high", "low", "close")
GATES = ("interval", "currency", "session", "adjustment_basis", "date_basis", "comparability_id")


def csv_write(path, rows, fields):
    with path.open("w", encoding="utf-8-sig", newline="") as f:
        writer = csv.DictWriter(f, fieldnames=fields)
        writer.writeheader()
        writer.writerows(rows)


def read_rows(path, mapping=None, expected=False):
    groups, issues = defaultdict(list), []
    with path.open(encoding="utf-8-sig", newline="") as f:
        reader = csv.DictReader(f)
        required = {
   "symbol", "trade_date"} | (set() if expected else set(FIELDS))
        if not required.issubset(reader.fieldnames or []):
            raise ValueError(f"{path.name}: requires {sorted(required)}; flatten multi-level exports first")
        for line, row in enumerate(reader, 2):
            symbol = (row.get("symbol") or "").strip()
            day = (row.get("trade_date") or "").strip()
            try:
                if not symbol or date.fromisoformat(day).isoformat() != day:
                    raise ValueError()
            except ValueError:
                issues.append({
   "line": line, "reason": "invalid_symbol_or_ISO_date"})
                continue
            symbol = (mapping or {
   }).get(symbol, symbol)
            if not isinstance(symbol, str) or not symbol.strip():
                issues.append({
   "line": line, "reason": "invalid_symbol_mapping"})
                continue
            groups[(symbol.strip(), day)].append(row)
    return groups, issues


def prices(row):
    try:
        values = [Decimal(row[k]) for k in FIELDS]
        if any(not n.is_finite() or n <= 0 for n in values):
            return None
        o, h, l, c = values
        return values if h >= max(o, l, c) and l <= min(o, h, c) else None
    except (KeyError, InvalidOperation, TypeError, ValueError):
        return None


def compare(old_path, new_path, old_meta, new_meta, expected_path=None):
    problems = []
    for field in GATES:
        a, b = old_meta.get(field), new_meta.get(field)
        unknown = lambda v: not isinstance(v, str) or v.strip().lower() in ("", "unknown", "unconfirmed")
        if unknown(a) or unknown(b) or a != b:
            problems.append(f"{field}: unknown_or_different")
    if old_meta.get("interval") != "1d" or new_meta.get("interval") != "1d":
        problems.append("interval: this_example_accepts_daily_bars_only")
    if old_meta.get("semantics_reviewed") is not True or new_meta.get("semantics_reviewed") is not True:
        problems.append("semantics_reviewed: human_confirmation_required")
    old, old_issues = read_rows(old_path, old_meta.get("symbol_map"))
    new, new_issues = read_rows(new_path, new_meta.get("symbol_map"))
    expected, expected_issues = read_rows(expected_path, expected=True) if expected_path else ({
   }, [])
    rows = []
    keys = sorted(set(old) | set(new) | set(expected))
    for key in keys:
        a, b = old.get(key, []), new.get(key, [])
        changes = ""
        if len(a) > 1 or len(b) > 1 or len(expected.get(key, [])) > 1:
            status = "DUPLICATE_KEY"
        elif not a and not b:
            status = "MISSING_BOTH"
        elif not a:
            status = "NEW_ONLY"
        elif not b:
            status = "OLD_ONLY"
        elif problems:
            status = "NOT_COMPARABLE"
        elif prices(a[0]) is None or prices(b[0]) is None:
            status = "INVALID_OHLC"
        else:
            av, bv = prices(a[0]), prices(b[0])
            changes = ";".join(f"{f}:{y-x}" for f, x, y in zip(FIELDS, av, bv) if x != y)
            status = "VALUE_DIFFERENCE" if changes else "EXACT_MATCH"
        rows.append({
   "symbol": key[0], "trade_date": key[1], "status": status,
                     "old_rows": len(a), "new_rows": len(b), "new_minus_old": changes,
                     "old_close": a[0].get("close", "") if len(a) == 1 else "",
                     "new_close": b[0].get("close", "") if len(b) == 1 else "",
                     "expected_key": key in expected if expected_path else "NOT_CHECKED"})
    counts = {
   s: sum(r["status"] == s for r in rows) for s in sorted({
   r["status"] for r in rows})}
    input_errors = {
   "old": old_issues, "new": new_issues, "expected": expected_issues}
    if any(input_errors.values()) or counts.get("DUPLICATE_KEY"):
        conclusion = "FIX_INPUT_KEYS"
    elif problems:
        conclusion = "ALIGN_METADATA_BEFORE_VALUES"
    elif any(r["status"] != "EXACT_MATCH" for r in rows) or (expected_path and set(old) != set(expected)):
        conclusion = "REVIEW_RECORD_DIFFERENCES"
    elif not rows:
        conclusion = "NO_RECORDS_TO_COMPARE"
    else:
        conclusion = "NO_DIFFERENCES_IN_THIS_SAMPLE"
    return rows, {
   "comparability_issues": problems, "input_errors": input_errors,
                  "counts": counts, "conclusion": conclusion,
                  "expected_dates_check": "PROVIDED" if expected_path else "NOT_CHECKED",
                  "old_unique_keys": len(old), "new_unique_keys": len(new),
                  "old_source": old_meta.get("source"), "new_source": new_meta.get("source"),
                  "data_kind": "SYNTHETIC_NOT_MARKET_DATA" if any(
                      m.get("data_kind") == "SYNTHETIC_NOT_MARKET_DATA" for m in (old_meta, new_meta)) else "USER_DECLARED_INPUTS",
                  "deployment_signoff": "HUMAN_REVIEW_REQUIRED",
                  "note": "Exact decimal equality is a comparison result, not an accuracy or migration approval."}


def demo_files(folder):
    """All values are invented software-test data for DEMO_A, not a security."""
    base = {
   "symbol": "DEMO_A", "open": "10", "high": "12", "low": "9", "close": "11"}
    old = [dict(base, trade_date=f"2026-01-{d:02}") for d in (5, 6, 8)]
    new = [dict(base, trade_date=f"2026-01-{d:02}") for d in (5, 7, 8)]
    new[-1]["close"] = "11.05"
    meta = dict(source="SYNTHETIC_DEMO", interval="1d", currency="USD",
                session="regular", adjustment_basis="split_adjusted",
                date_basis="exchange_local_trade_date", semantics_reviewed=True,
                comparability_id="SYNTHETIC_TEST_BASIS_ONLY",
                symbol_map={
   }, data_kind="SYNTHETIC_NOT_MARKET_DATA")
    for name, data in (("old", old), ("new", new)):
        csv_write(folder / f"{name}.csv", data, ["symbol", "trade_date", *FIELDS])
        (folder / f"{name}.json").write_text(json.dumps(meta, indent=2))
    expected = [{
   "symbol": "DEMO_A", "trade_date": f"2026-01-{d:02}"} for d in range(5, 10)]
    csv_write(folder / "expected.csv", expected, ["symbol", "trade_date"])


def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument("--demo", action="store_true")
    for name in ("old", "new", "old-meta", "new-meta", "expected"):
        parser.add_argument("--" + name, type=Path)
    parser.add_argument("--out", type=Path, default=Path("comparison_runs"))
    args = parser.parse_args()
    folder = args.out / datetime.now(timezone.utc).strftime("%Y%m%dT%H%M%S%fZ")
    folder.mkdir(parents=True, exist_ok=False)
    if args.demo:
        demo_files(folder)
        args.old, args.new = folder / "old.csv", folder / "new.csv"
        args.old_meta, args.new_meta = folder / "old.json", folder / "new.json"
        args.expected = folder / "expected.csv"
    if not all((args.old, args.new, args.old_meta, args.new_meta)):
        parser.error("Use --demo or supply --old, --new, --old-meta and --new-meta")
    old_meta = json.loads(args.old_meta.read_text(encoding="utf-8"))
    new_meta = json.loads(args.new_meta.read_text(encoding="utf-8"))
    rows, summary = compare(args.old, args.new, old_meta, new_meta, args.expected)
    summary["mode"] = "SYNTHETIC_DEMO" if args.demo else "USER_SUPPLIED_FILES"
    summary["created_at_utc"] = datetime.now(timezone.utc).isoformat()
    summary["inputs"] = {
   n: str(getattr(args, n)) for n in ("old", "new", "old_meta", "new_meta", "expected")}
    summary["declared_metadata"] = {
   "old": old_meta, "new": new_meta}
    summary["input_sha256"] = {
   n: hashlib.sha256(getattr(args, n).read_bytes()).hexdigest()
                               for n in ("old", "new", "old_meta", "new_meta", "expected") if getattr(args, n)}
    csv_write(folder / "row_comparison.csv", rows,
              ["symbol", "trade_date", "status", "old_rows", "new_rows", "old_close", "new_close", "new_minus_old", "expected_key"])
    (folder / "comparison_report.json").write_text(json.dumps(summary, ensure_ascii=False, indent=2), encoding="utf-8")
    columns = ("symbol", "trade_date", "old_close", "new_close", "status", "new_minus_old")
    header = "".join(f"<th>{html.escape(c)}</th>" for c in columns)
    body = "".join("<tr>" + "".join(f"<td>{html.escape(str(r[c]))}</td>" for c in columns) + "</tr>" for r in rows)
    view = ("<!doctype html><html lang='en'><meta charset='utf-8'><meta name='viewport' content='width=device-width'>"
            "<title>Migration comparison</title><style>body{max-width:1000px;margin:40px auto;padding:0 20px;"
            "font:17px system-ui;background:#f8f4eb;color:#123349}table{border-collapse:collapse;width:100%}"
            "th,td{padding:12px;border-bottom:1px solid #ccd3d6;text-align:left}pre{white-space:pre-wrap}"
            ".label{padding:14px;background:#fae2b9;border-radius:8px}</style>"
            "<h1>迁移对齐结果 / Migration comparison</h1><p class='label'>"
            + html.escape(summary["data_kind"]) + " — demonstration or user-supplied input; not a production approval.</p>"
            + "<p>" + html.escape(summary["conclusion"]) + "</p><table><thead><tr>" + header
            + "</tr></thead><tbody>" + body + "</tbody></table><h2>Settings requiring review</h2><pre>"
            + html.escape(json.dumps(summary["comparability_issues"], ensure_ascii=False, indent=2))
            + "</pre><p>HUMAN_REVIEW_REQUIRED. Missing values stay missing. Differences require investigation.</p></html>")
    (folder / "comparison_view.html").write_text(view, encoding="utf-8")
    print(json.dumps({
   "output": str(folder), "mode": summary["mode"], "counts": summary["counts"],
                      "conclusion": summary["conclusion"], "deployment_signoff": summary["deployment_signoff"]}))


if __name__ == "__main__":
    main()
