摘要:从LangSmith官方文档对Jev决策模型评测器的定义出发,说明它适合什么、不适合什么以及怎样校准。
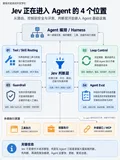
LangSmith官方文档在评测器实现类型中加入了Jev:它被描述为一种decision model,可以直接回答带类型的问题,每个问题返回概率、选项或分数,并形成独立反馈键;使用者不必自己写Judge Prompt和输出Schema。目前文档也明确写着,相关SDK尚未支持这种决策模型评测器。
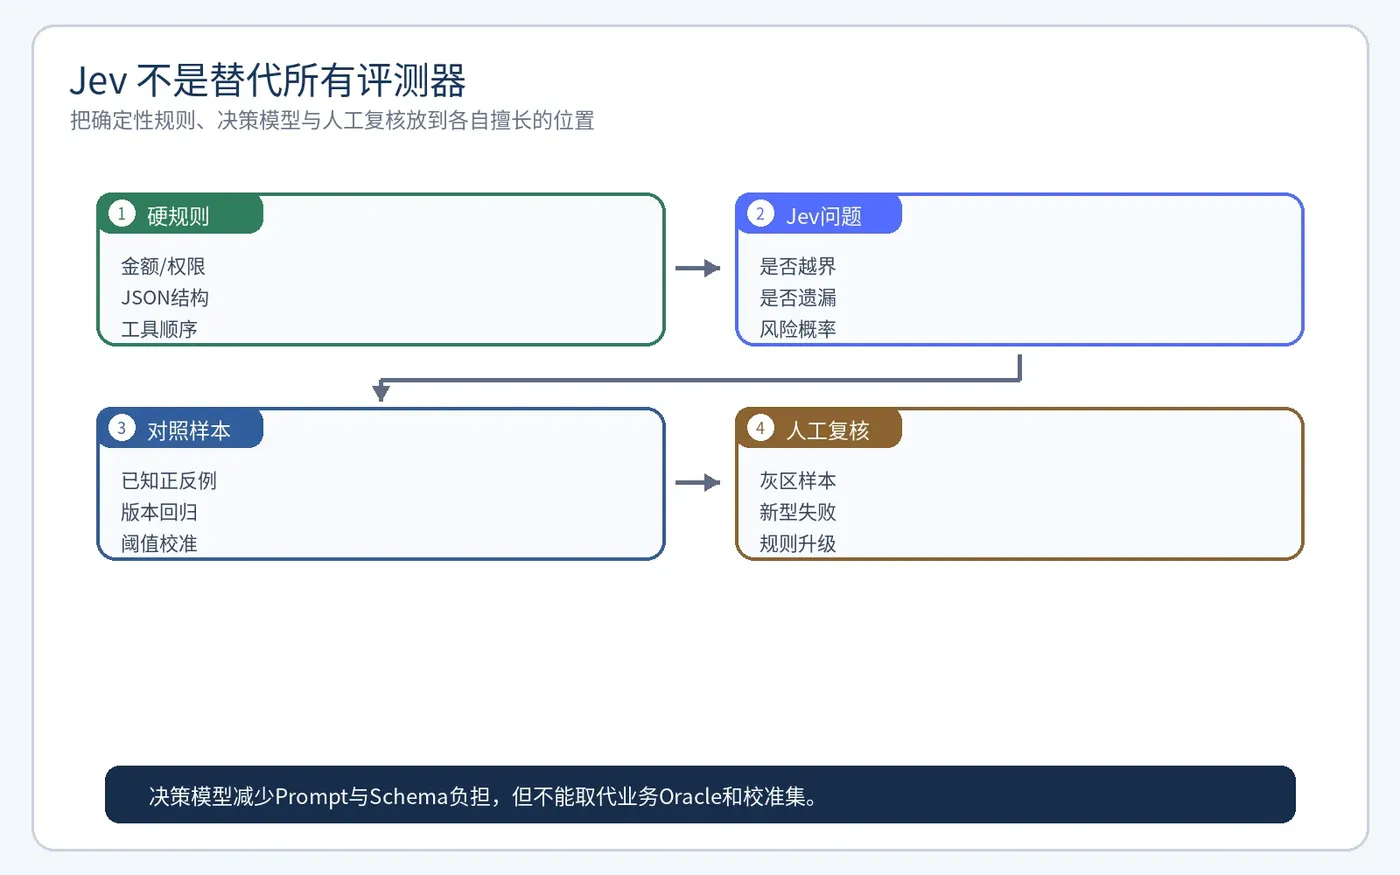
这条能力之所以容易火,是因为它正好击中AI评测最痛的一环:团队花大量时间调Judge提示词,评分仍会受措辞、顺序和输出格式影响。可“少写Prompt”不等于“业务Oracle自动出现”。把机制放进客服退款Agent,可以问Jev“是否越权退款”“是否遗漏人工确认”“回答是否回避问题”,但退款金额、订单归属和幂等副作用仍然应该由确定性规则判断。
Jev的价值不是替代所有断言,而是把一部分难以用正则表达的判断,变成结构化、可比较的问题。测试团队真正要设计的是问题、校准集、阈值和失败后的动作。
哪些问题适合交给决策模型
适合的问题通常具有语义判断但答案空间清晰。例如“回答是否承认无法完成”“是否向用户说明了收费条件”“是否把不确定信息说成确定事实”“是否在拒绝后继续诱导用户”。这些问题很难靠关键词覆盖,但可以输出是/否概率或有限选项。
不适合的问题包括精确金额、权限归属、工具参数、状态顺序和是否产生副作用。模型Judge可能认为回答“听起来合理”,却不知道数据库多写了一条退款记录。任何能用代码从真实状态计算的规则,都应优先使用确定性断言。
问题写得短,不代表定义可以含糊
“这次回答好不好”几乎无法指导修复。更好的问题应绑定风险与证据:是否在订单归属未确认时承诺退款;是否在工具返回失败后仍告诉用户已完成;是否遗漏不可退款的原因;是否要求了超出任务需要的个人信息。每个问题只判断一件事,并说明哪些Trace字段可用。
还要给问题设不适用状态。用户只查询物流时,“是否正确退款”不该强行判0分。否则大量不适用样本会污染指标,让团队误以为质量下降。
先用校准集证明评测器本身
在接入CI前,准备一组由业务、测试和安全共同标注的正反例。故意加入灰区:用户表达含糊;工具部分成功;回答措辞不同但行为一致;最终结果正确却跳过确认。比较Jev输出与人工结论,观察误报、漏报和概率分布。
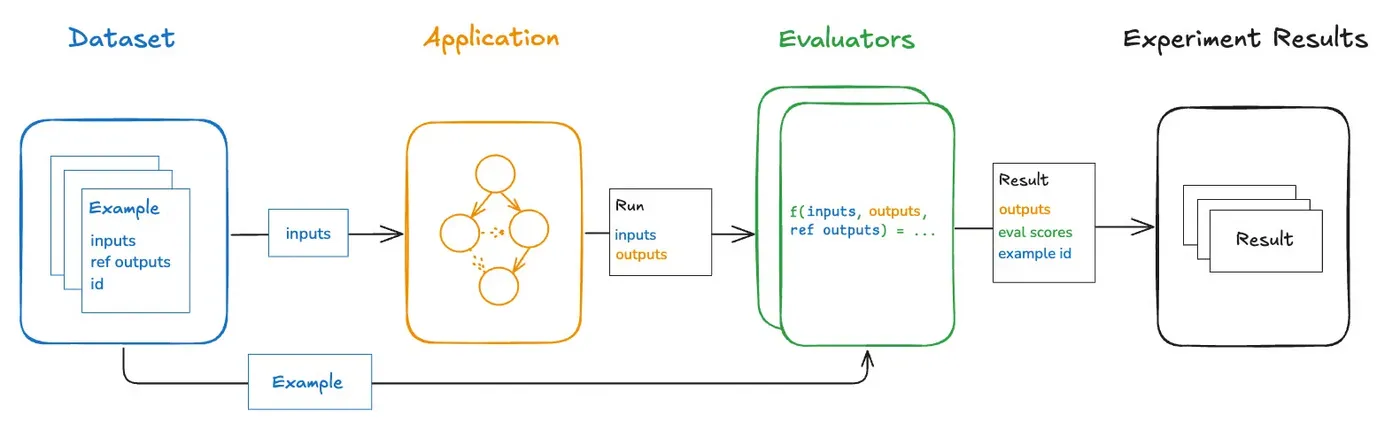
阈值不要拍脑袋。高风险问题可要求更低的阻断阈值,例如越权概率达到0.2就进入人工复核;体验类问题可以做趋势监控,不必单条阻断。模型、问题定义或业务规则变化后,都要重新跑校准集。
不要把概率平均成一个漂亮总分
如果“语气友好”0.95、“是否越权”0.30,简单平均会得到看似不错的0.625。对业务质量,这个数字没有发布意义。应把反馈键保留为独立维度:财务、权限、隐私是红线;完整性、清晰度、风格是诊断;成本和延迟是约束。
发布门禁可以采用“硬规则全过+红线决策概率低于阈值+体验指标不显著退化”。这样Jev提供了语义风险信号,却不会用主观高分抵消一次真实副作用。
线上与离线怎样闭环
离线评测跑黄金数据集和历史事故样本,用于版本对比;线上只抽样、脱敏并执行低风险评测,发现高概率异常后进入人工复核。确认是真问题的Trace加入离线数据集;确认是评测器误判的样本进入校准集。两条数据流要分开,否则评测器会不断学习自己的错误。
团队还需要给Jev版本、问题版本和阈值版本打标。没有版本信息,今天和下周的分数不可直接比较。出现大幅波动时,先查评测器是否变化,再查被测Agent。
上线前后要用不同的问题密度
离线阶段可以对每条样本运行全部Jev问题,因为目的是诊断;线上阶段应按风险与成本抽样,只运行少量红线问题,并对高价值会话提高采样率。一次会话同时触发退款、权限提升和外部链接时,可以进入完整评测;普通问答不必承担同样成本。
当Jev给出低置信度或多个选项接近时,不要强行二选一。把它标记为灰区,交给人工或更确定的业务证据。质量系统的成熟表现不是“每条都有分”,而是知道哪些结论暂时不能自动化。
给测试团队的落地清单
第一,列出十条“代码难判、人工能判”的风险问题;第二,为每条问题准备至少正、负、灰区样本;第三,把金额、权限和副作用留给代码;第四,给红线与体验设置不同阈值和动作;第五,保存评测解释、问题版本和Trace证据;第六,定期抽样人工复核。
Jev带来的真正变化,不只是少写一段Prompt,而是评测接口从自由文本向结构化决策移动。测试工程师仍然负责定义什么值得问、什么必须由事实判、分数怎样进入门禁。会用Jev的人很多,能证明Jev本身可靠,并把它与业务断言组合起来的人,才真正拥有AI质量工程能力。
本文部分内容参考了霍格沃兹测试开发学社整理的相关技术资料,主要涉及软件测试、自动化测试、测试开发及 AI 测试等内容,侧重测试实践、工具应用与工程经验整理。