
2026-08-05模型发布
Qwen-Image-3.0-Pro 上线千问AI平台,支持复杂图文排版、精细渲染与图像编辑
一、概览
Qwen-Image-3.0-Pro 现已上线千问AI平台——面向开发者与 AI Agent 的模型服务平台。作为第三代 Qwen-Image 图像生成模型,Qwen-Image-3.0-Pro 同时支持文生图和图像编辑,围绕「内容丰实、细节真实、知识厚实」三个方向升级:可接收最高 4.5K Tokens 的复杂指令,在单张图中组织多层级、多区域内容;支持约 10 px 小字、公式和真实材质渲染;支持 12 种语言、20 余种字体,以及网页、游戏、直播等界面生成。
从报纸、试卷、论文页面和分镜,到人像摄影、产品质感、知识信息图与多语言设计稿,Qwen-Image-3.0-Pro 可将复杂内容组织、精细视觉呈现和图像编辑纳入同一工作流,为内容创作、设计、教育、电商和应用界面生产提供更完整的图像能力。
二、模型详情
1. Qwen-Image-3.0-Pro:面向复杂视觉内容生产的图像模型
模型名称 / 版本号:Qwen-Image-3.0-Pro(qwen-image-3.0-pro)
能力定位:支持文生图和图像编辑,可根据长指令生成包含复杂版面、精细文字、真实细节和专业知识的图像,也可结合参考图完成重绘、增删、批注和视觉信息重组。
2. 核心参数
| 参数 | 说明 |
|---|---|
| 模型标识 | qwen-image-3.0-pro |
| 任务类型 | 文生图、图生图 / 图像编辑 |
| 输入模态 | 文本、图像;图像编辑支持 1–3 张参考图 |
| 输出模态 | 图像,PNG 格式 |
| 指令长度 | 最高 4.5K Tokens |
| 输出尺寸 | 总像素范围为 512 × 512 至 2,048 × 2,048;未指定尺寸时可由模型推荐 |
| 单次输出 | 最多生成 6 张图像 |
| 文字渲染 | 支持约 10 px 小字、12 种语言、20 余种字体 |
| 提示词增强 | prompt_extend 默认开启;支持 direct,文生图还可使用 agent 模式 |
| 可控参数 | 支持反向提示词、随机种子和水印控制 |
| 在线体验 | 已支持 |
| API 调用 | 已提供 DashScope HTTP API、Python SDK 和 Java SDK 调用方式 |
模型价格及最新调用限制请查看 Qwen-Image-3.0-Pro 模型详情页。
三、模型能力
1. 内容丰实
复杂版面:一张图容纳多层内容
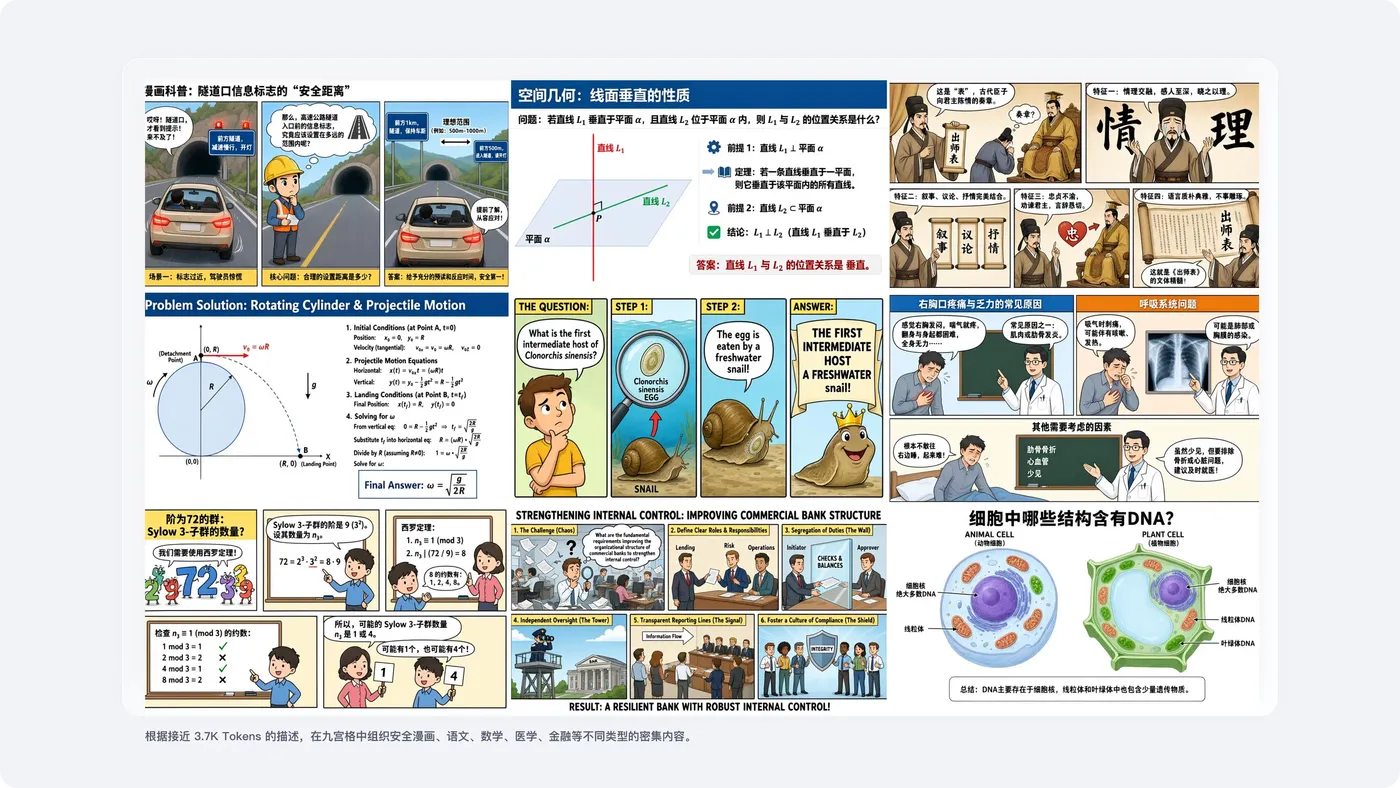
Qwen-Image-3.0-Pro 可在同一张图中安排标题、正文、图表、示意图、公式和注释等不同元素,并保持分区关系和阅读顺序。最高 4.5K Tokens 的指令容量使模型能够处理试卷、报纸、菜单、故事板和演示页等信息密度较高的任务。
画中画与界面纵深
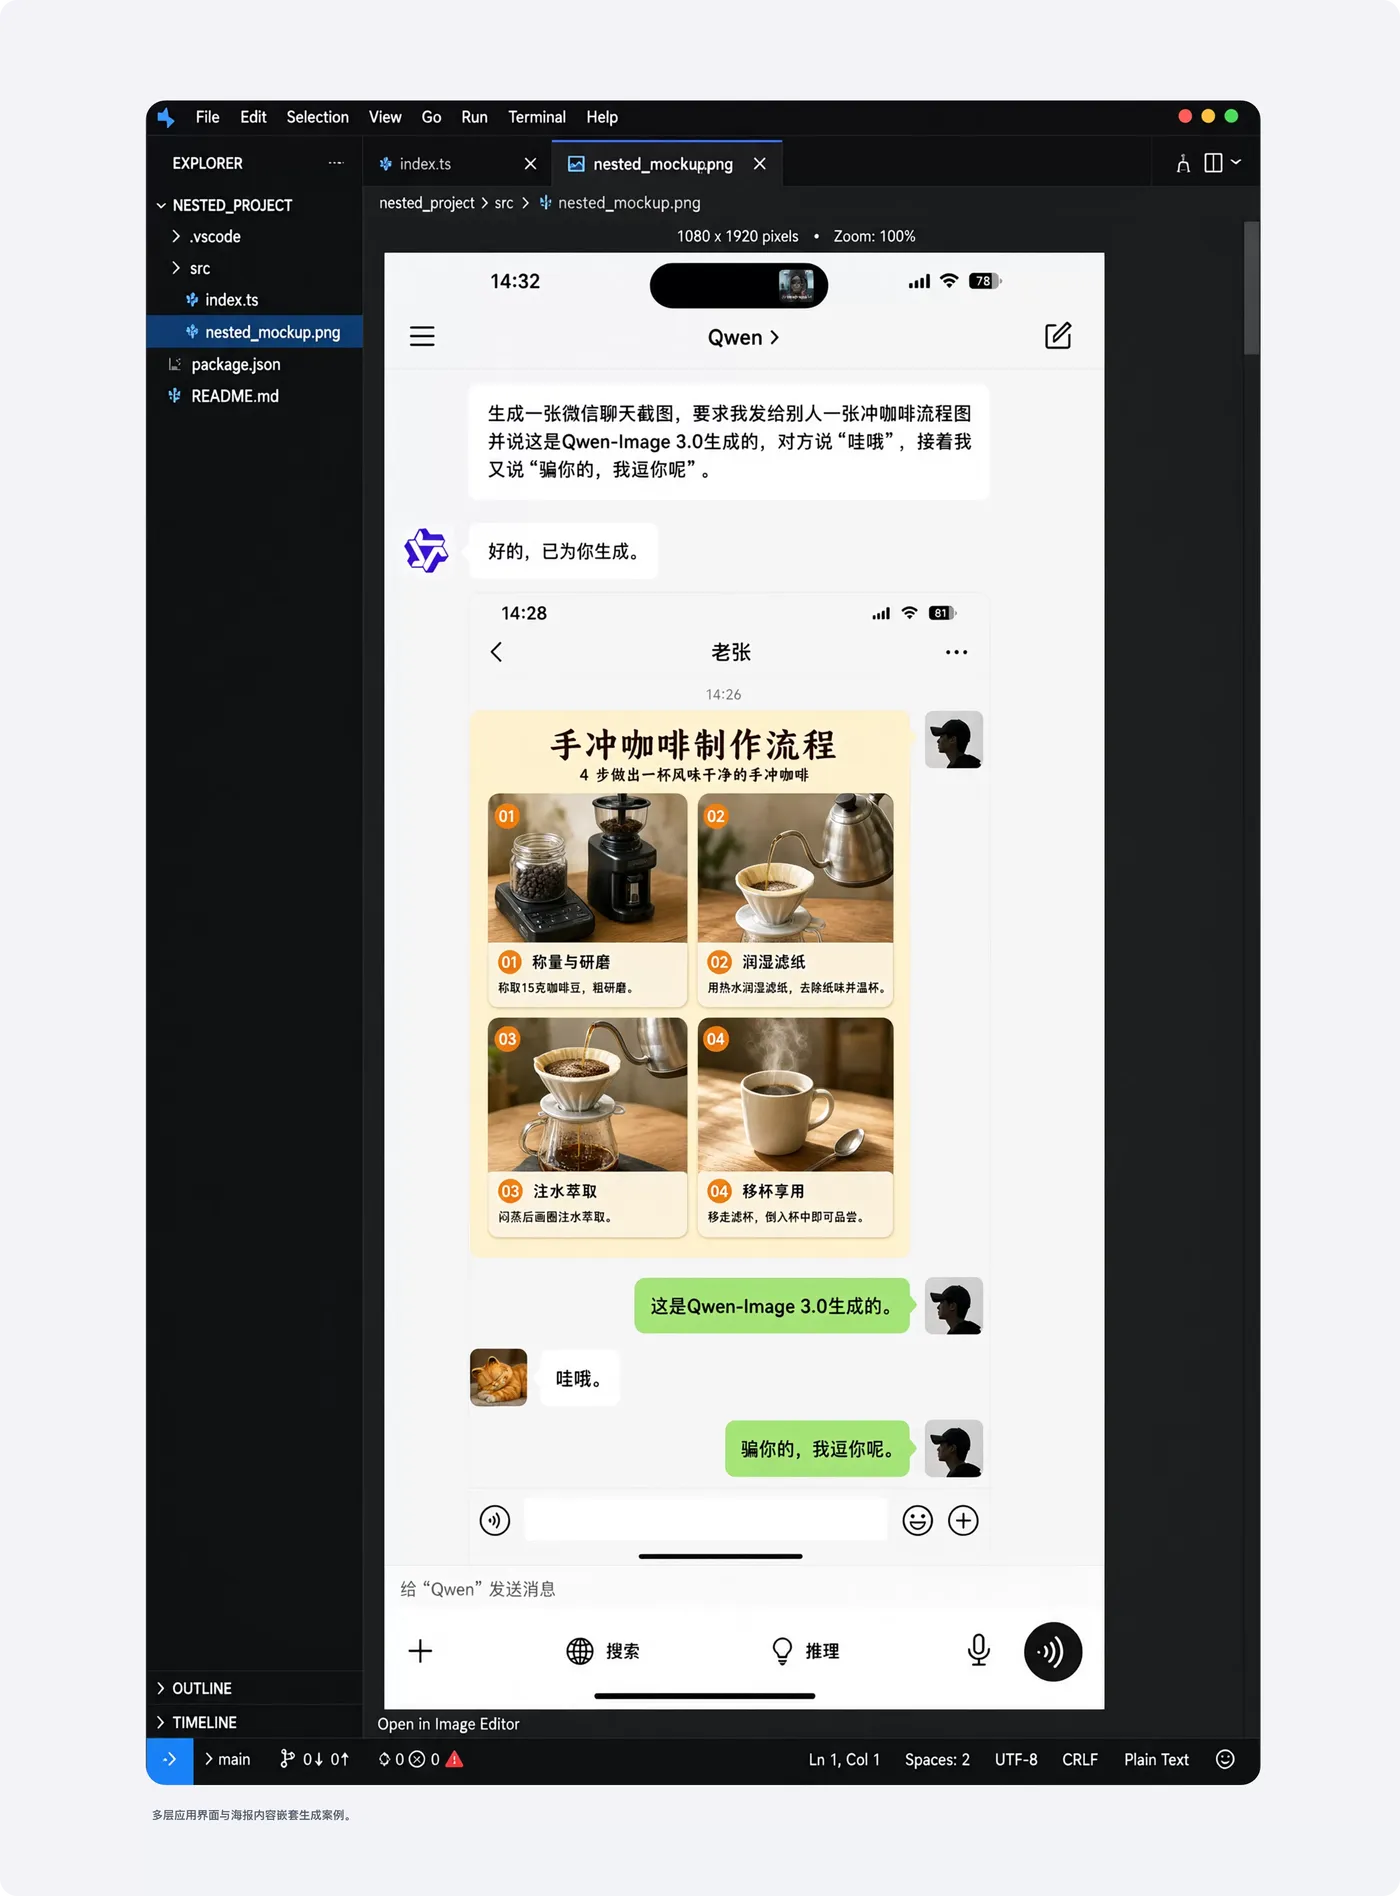
模型支持多层嵌套的画中画内容,可在同一画面中保持设备、应用窗口、对话界面和海报等层级关系。复杂信息不再只依赖平铺布局,也可以沿视觉纵深逐层展开。
分镜与连续视觉叙事
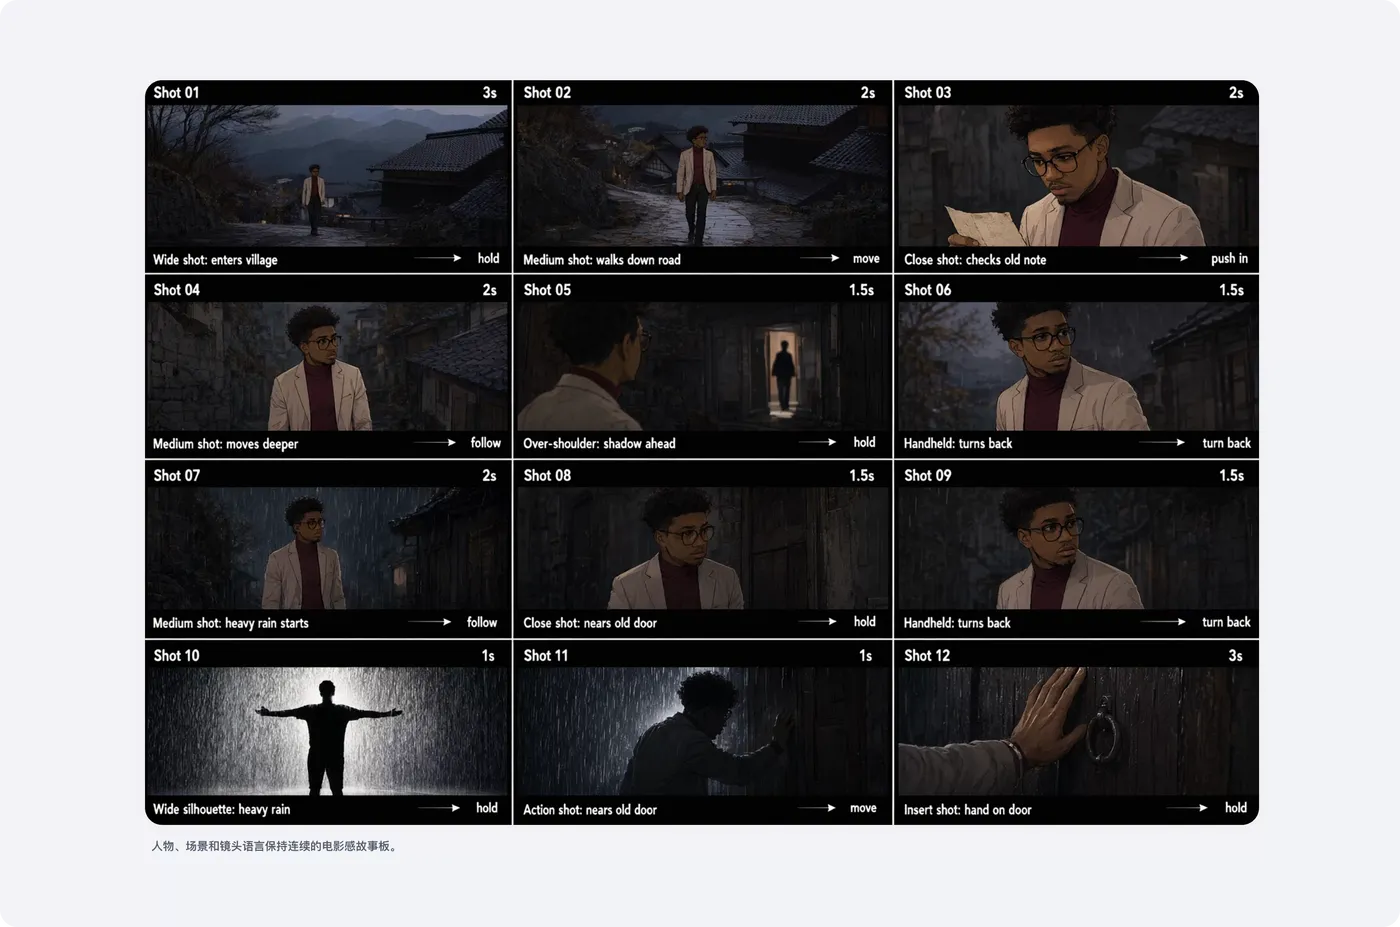
对于短剧、广告和脚本可视化任务,模型可在统一画幅中组织多个镜头,保持人物、场景、光线和叙事节奏的连续性,便于从文字脚本快速形成可讨论的故事板。
延伸阅读:查看复杂内容与版面生成的完整案例
2. 细节真实
小字、公式与纸张排版
Qwen-Image-3.0-Pro 强化了小字号文字、公式、栏线和纸张版面的稳定呈现,可用于信息图、学术页面、报纸和说明文档等需要同时保证信息密度与可读性的场景。
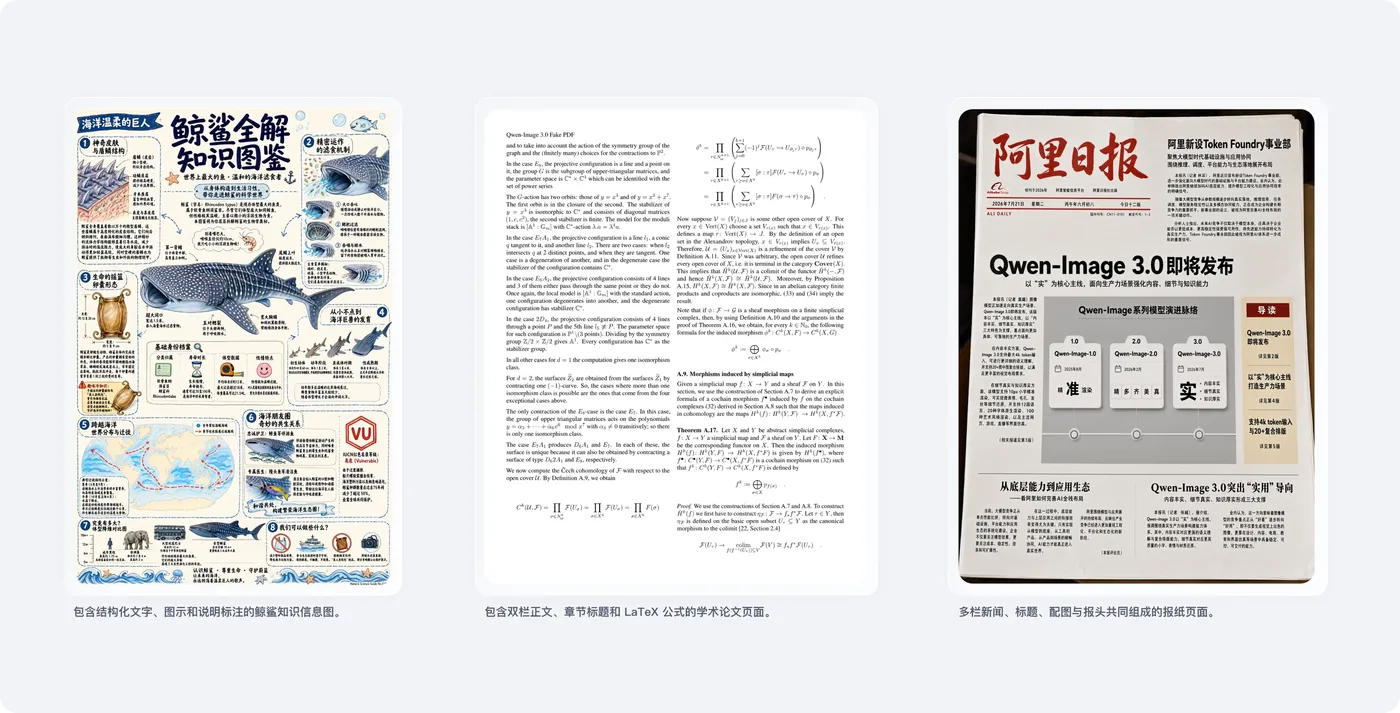
人像与材质
模型对皮肤、发丝、织物、光影和景深等微观细节进行更细致的还原,可生成更接近真实摄影的人像与场景,同时保持画面中的招牌文字、花束和背景层次。
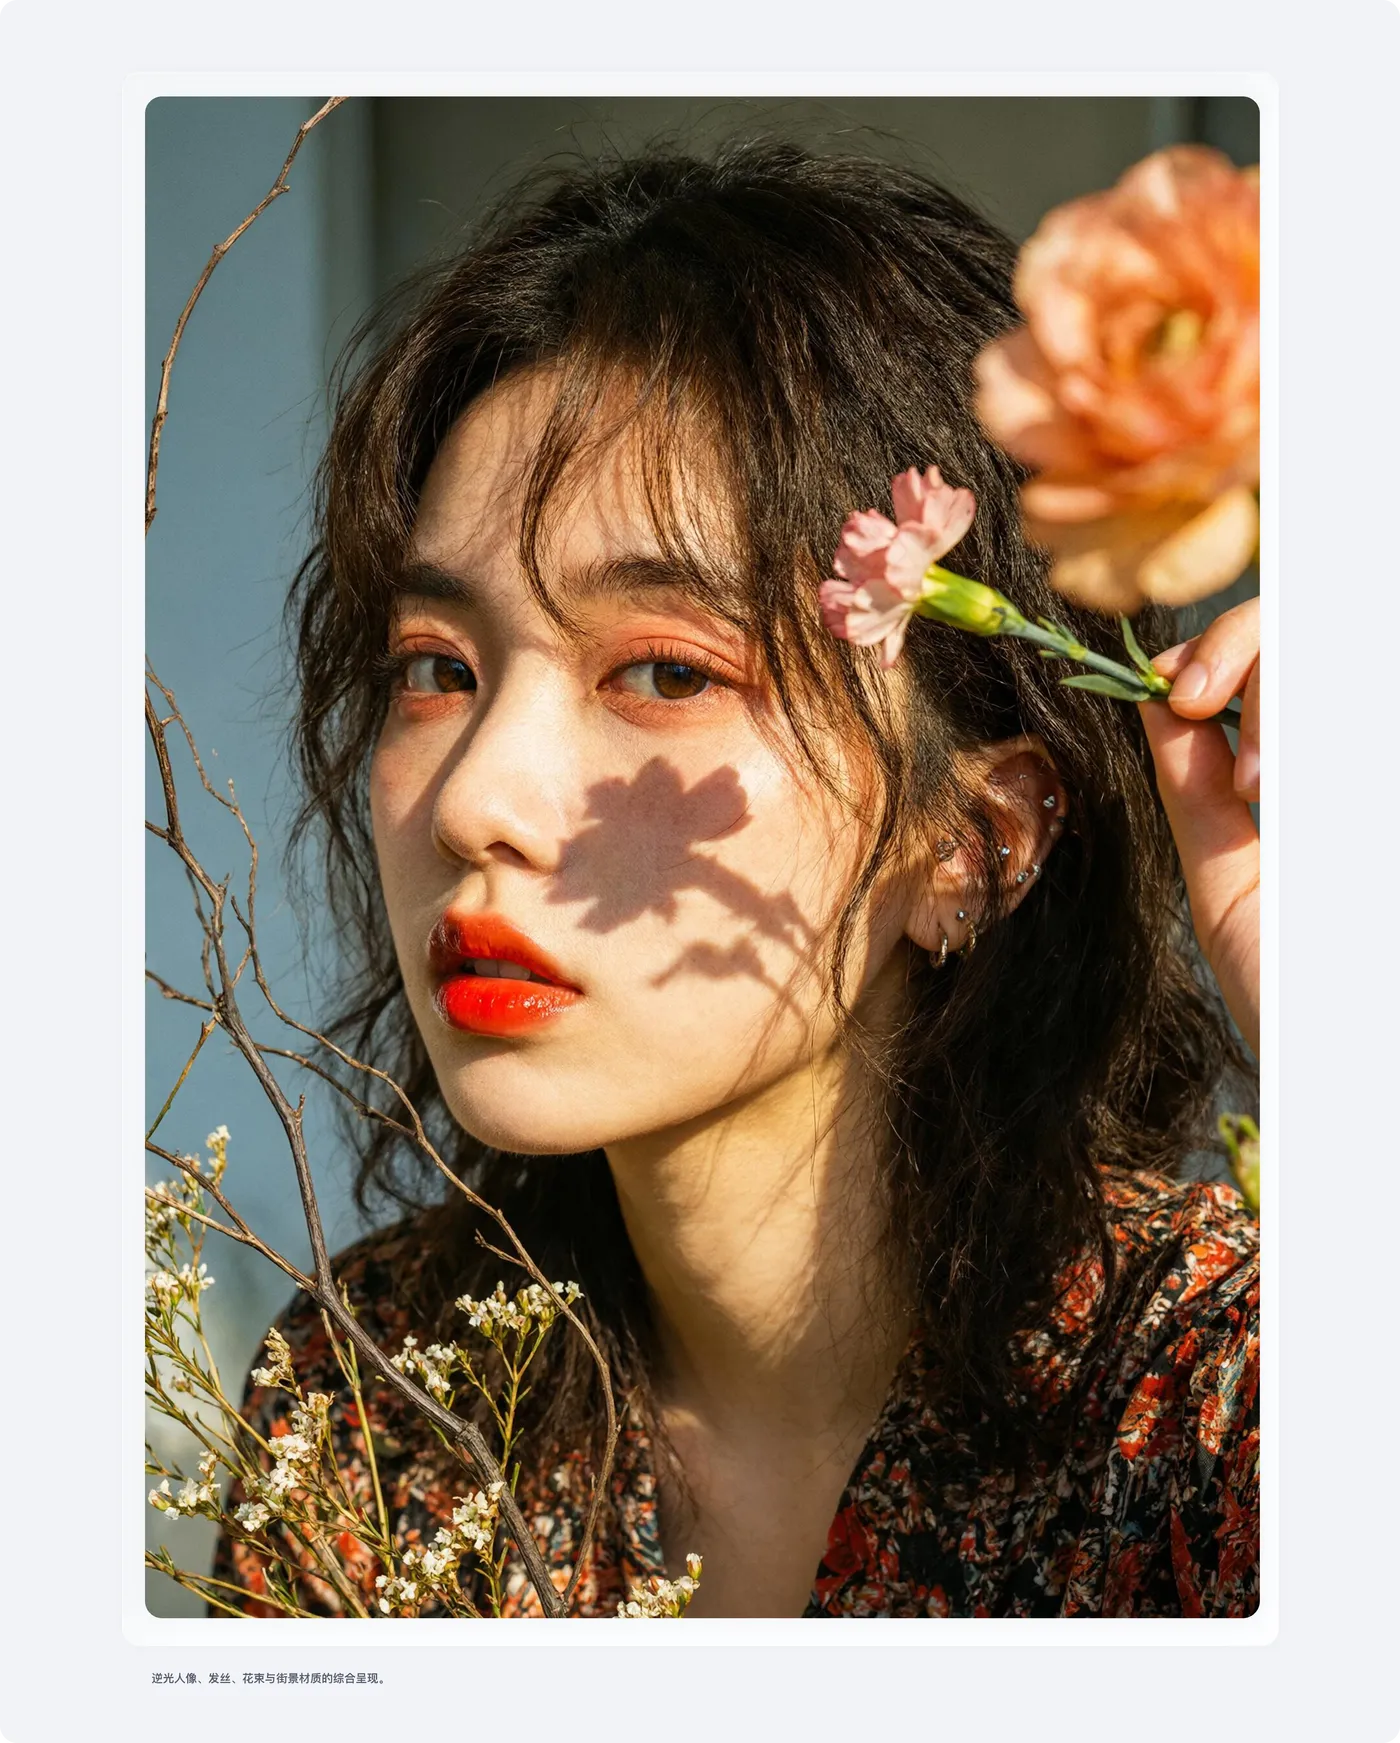
图像编辑与手写批注
在图像编辑任务中,Qwen-Image-3.0-Pro 可在保留原始版面与主体结构的基础上,根据指令增加手写批注、重点标记或局部内容,为教材处理、内容审阅和视觉修改提供更直接的编辑方式。
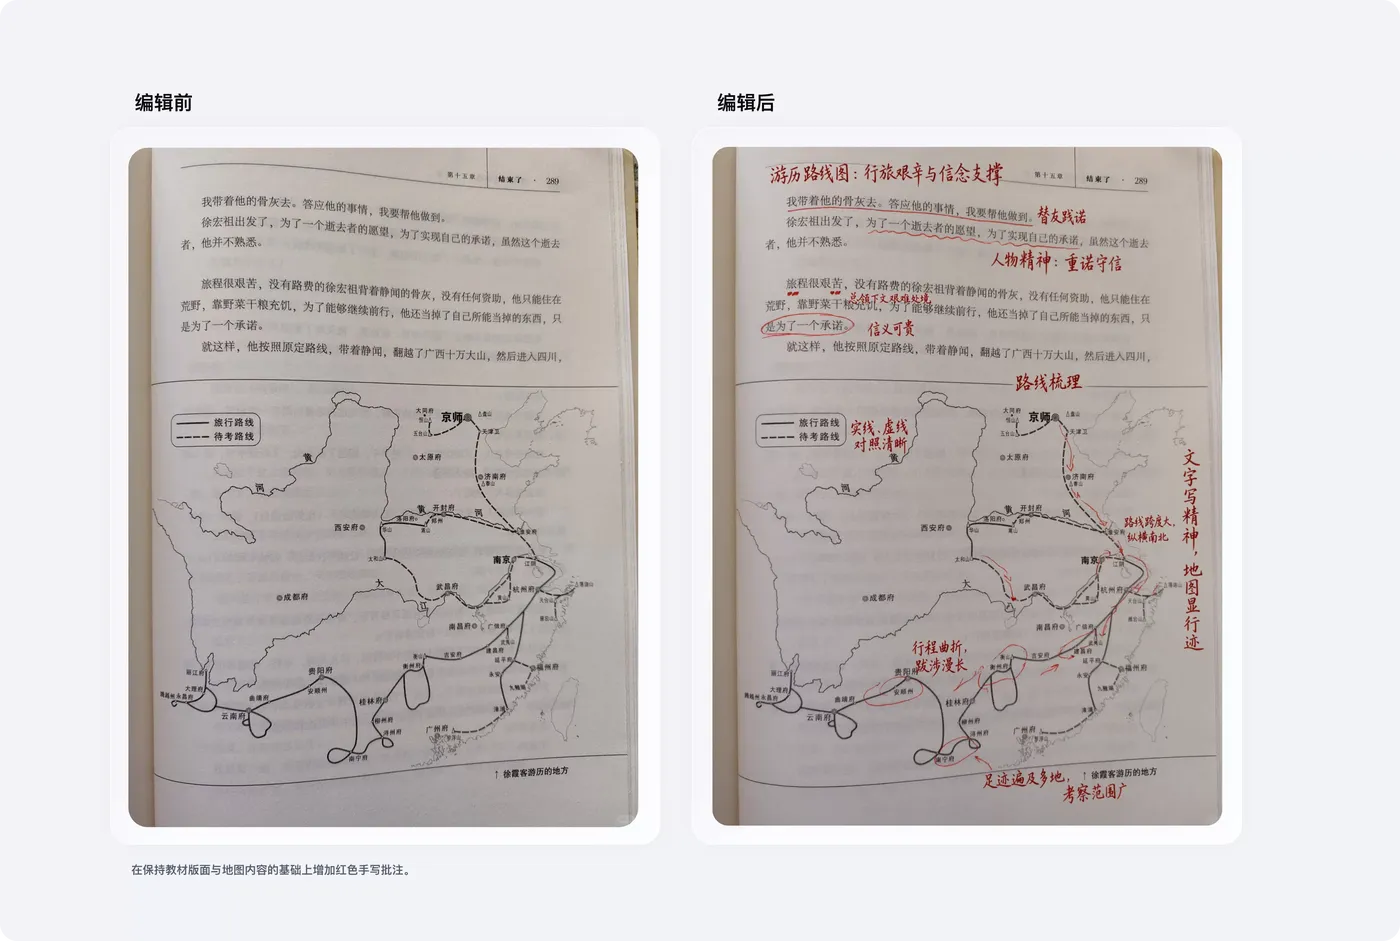
延伸阅读:查看真实细节与图像编辑的完整案例
3. 知识厚实
多语言与多字体
Qwen-Image-3.0-Pro 支持 12 种语言和 20 余种字体,可在不同语言的海报、杂志、宣传页和界面中完成原生文字渲染。发布案例覆盖日语、韩语、西班牙语等语言,适合多地区内容生产和本地化设计。
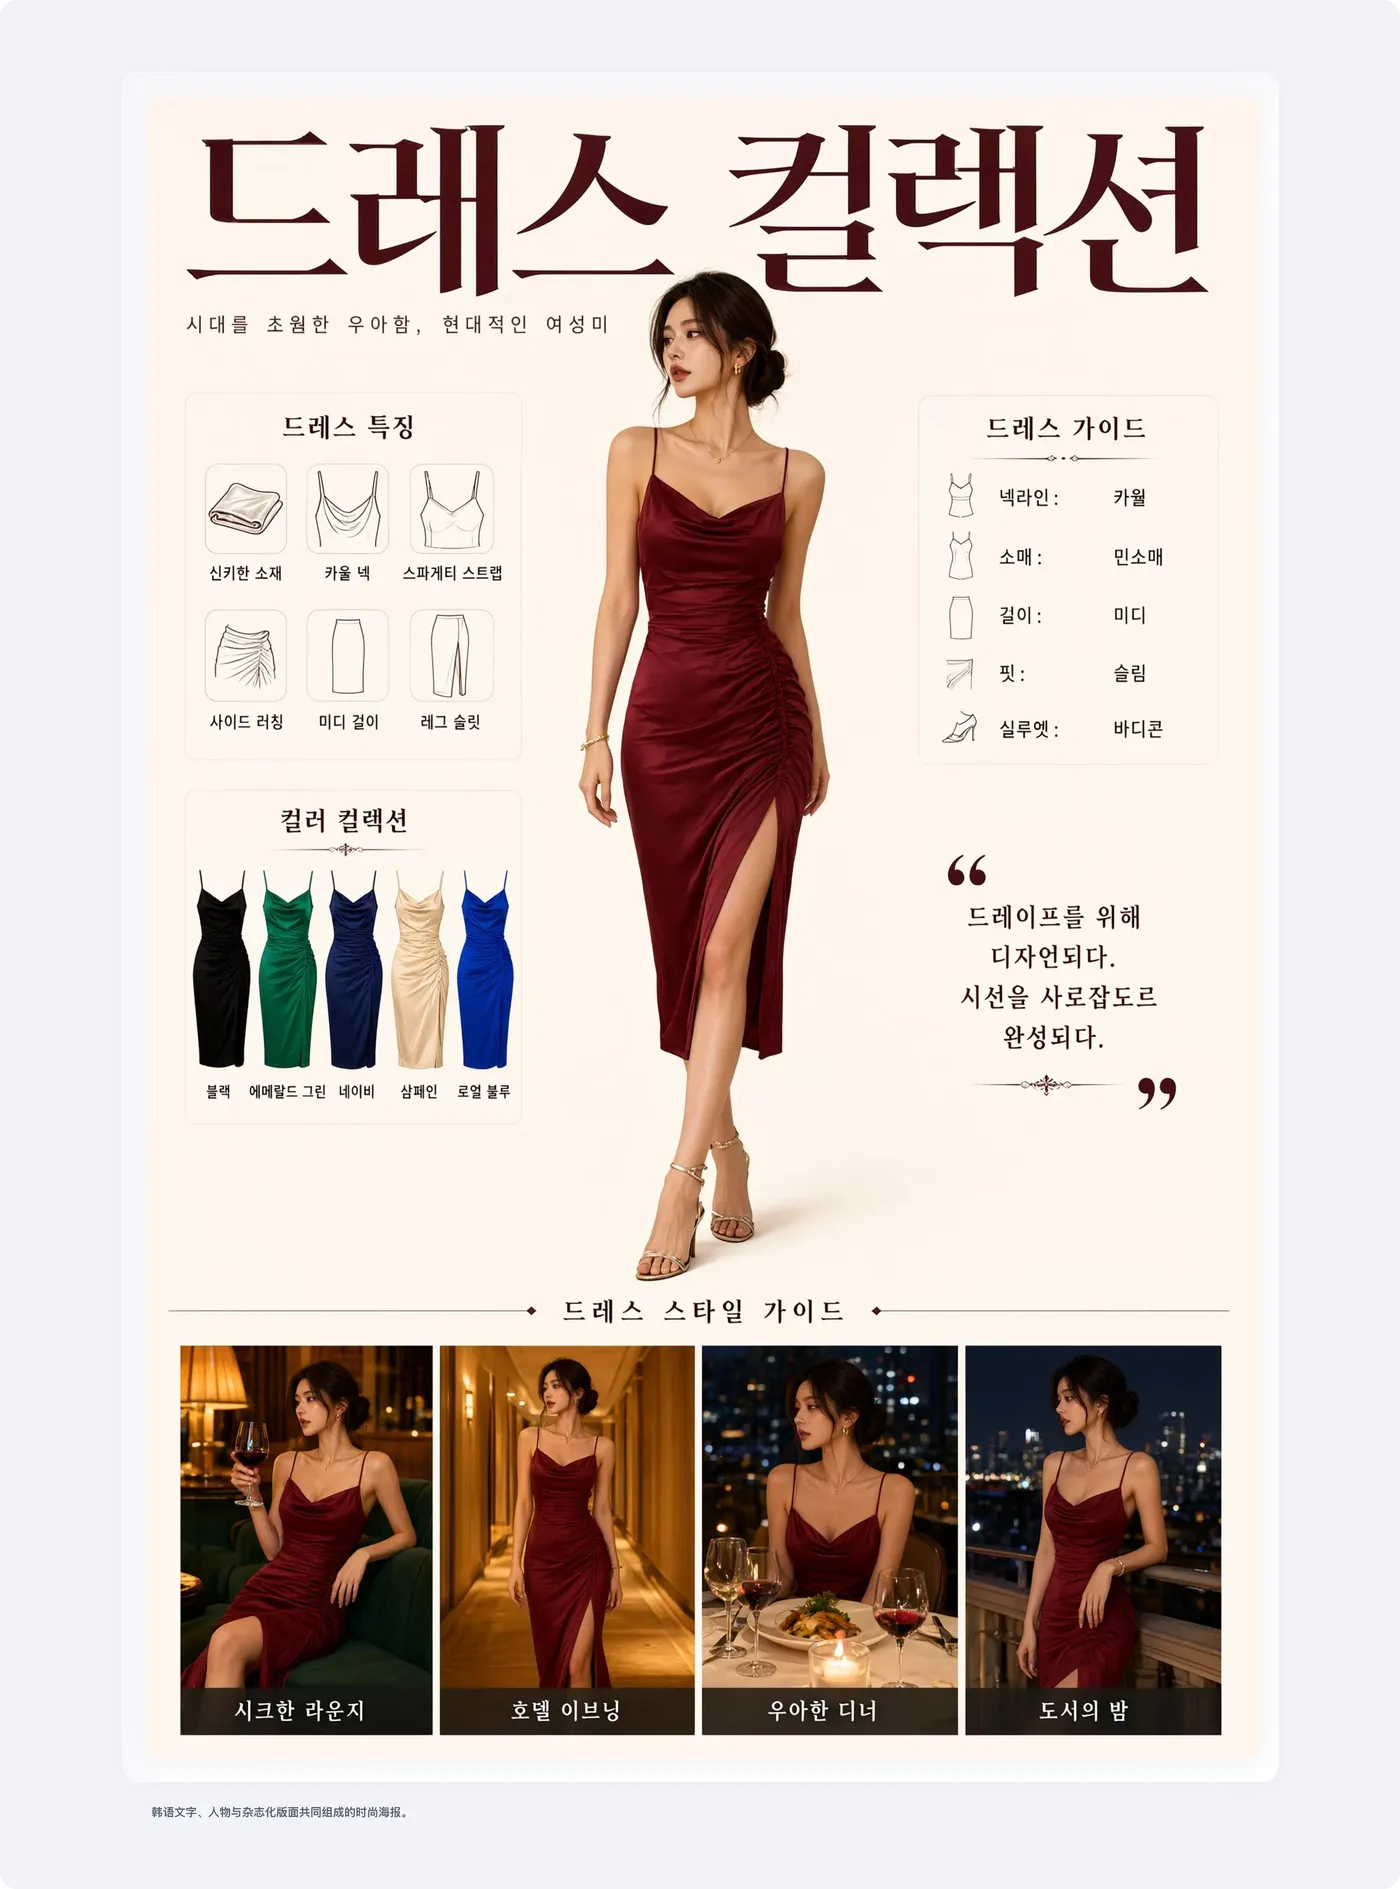
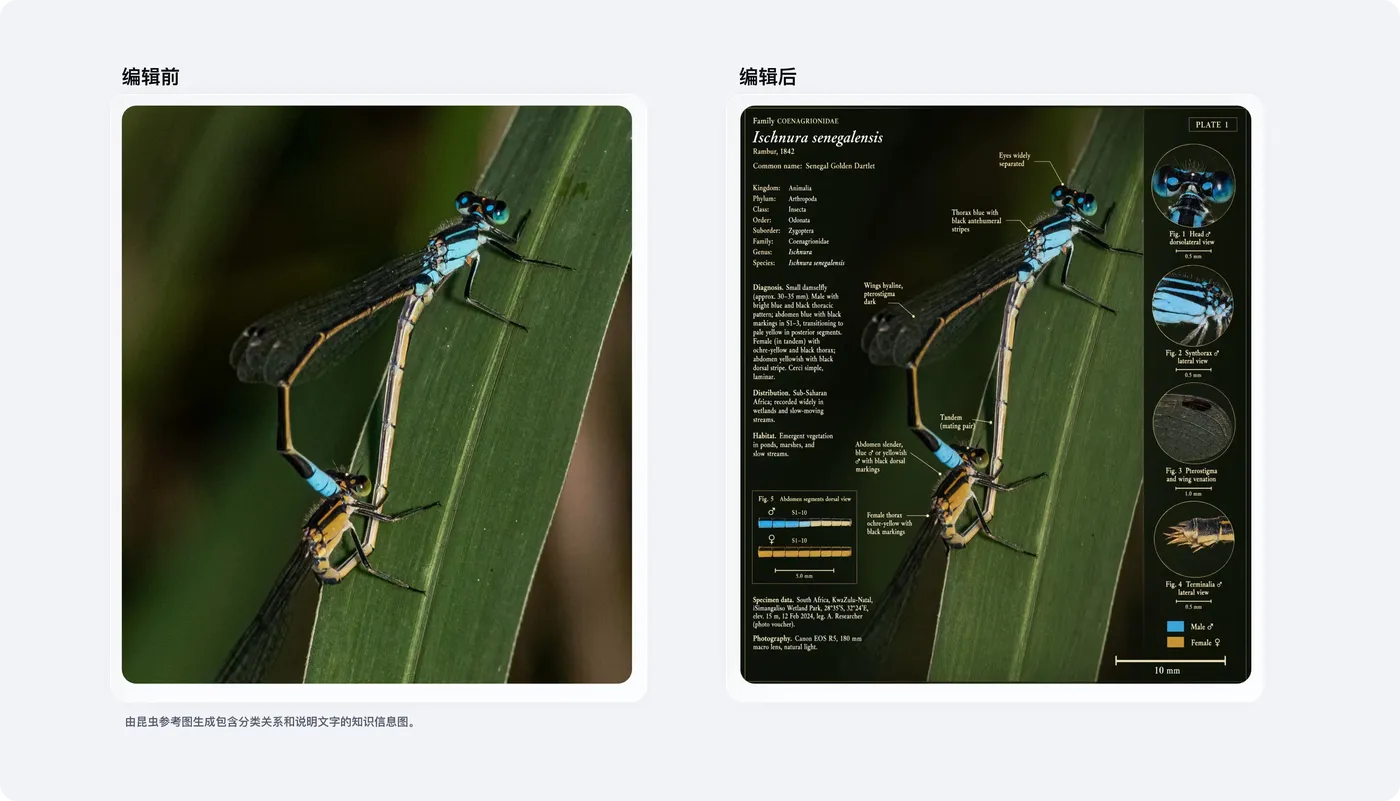
从参考图到知识信息图
模型可结合输入图像与外部知识,将单一主体扩展为包含分类、结构、特征和说明文字的专业信息图。生成过程不仅改变视觉样式,也会重新组织知识结构和版面层级。
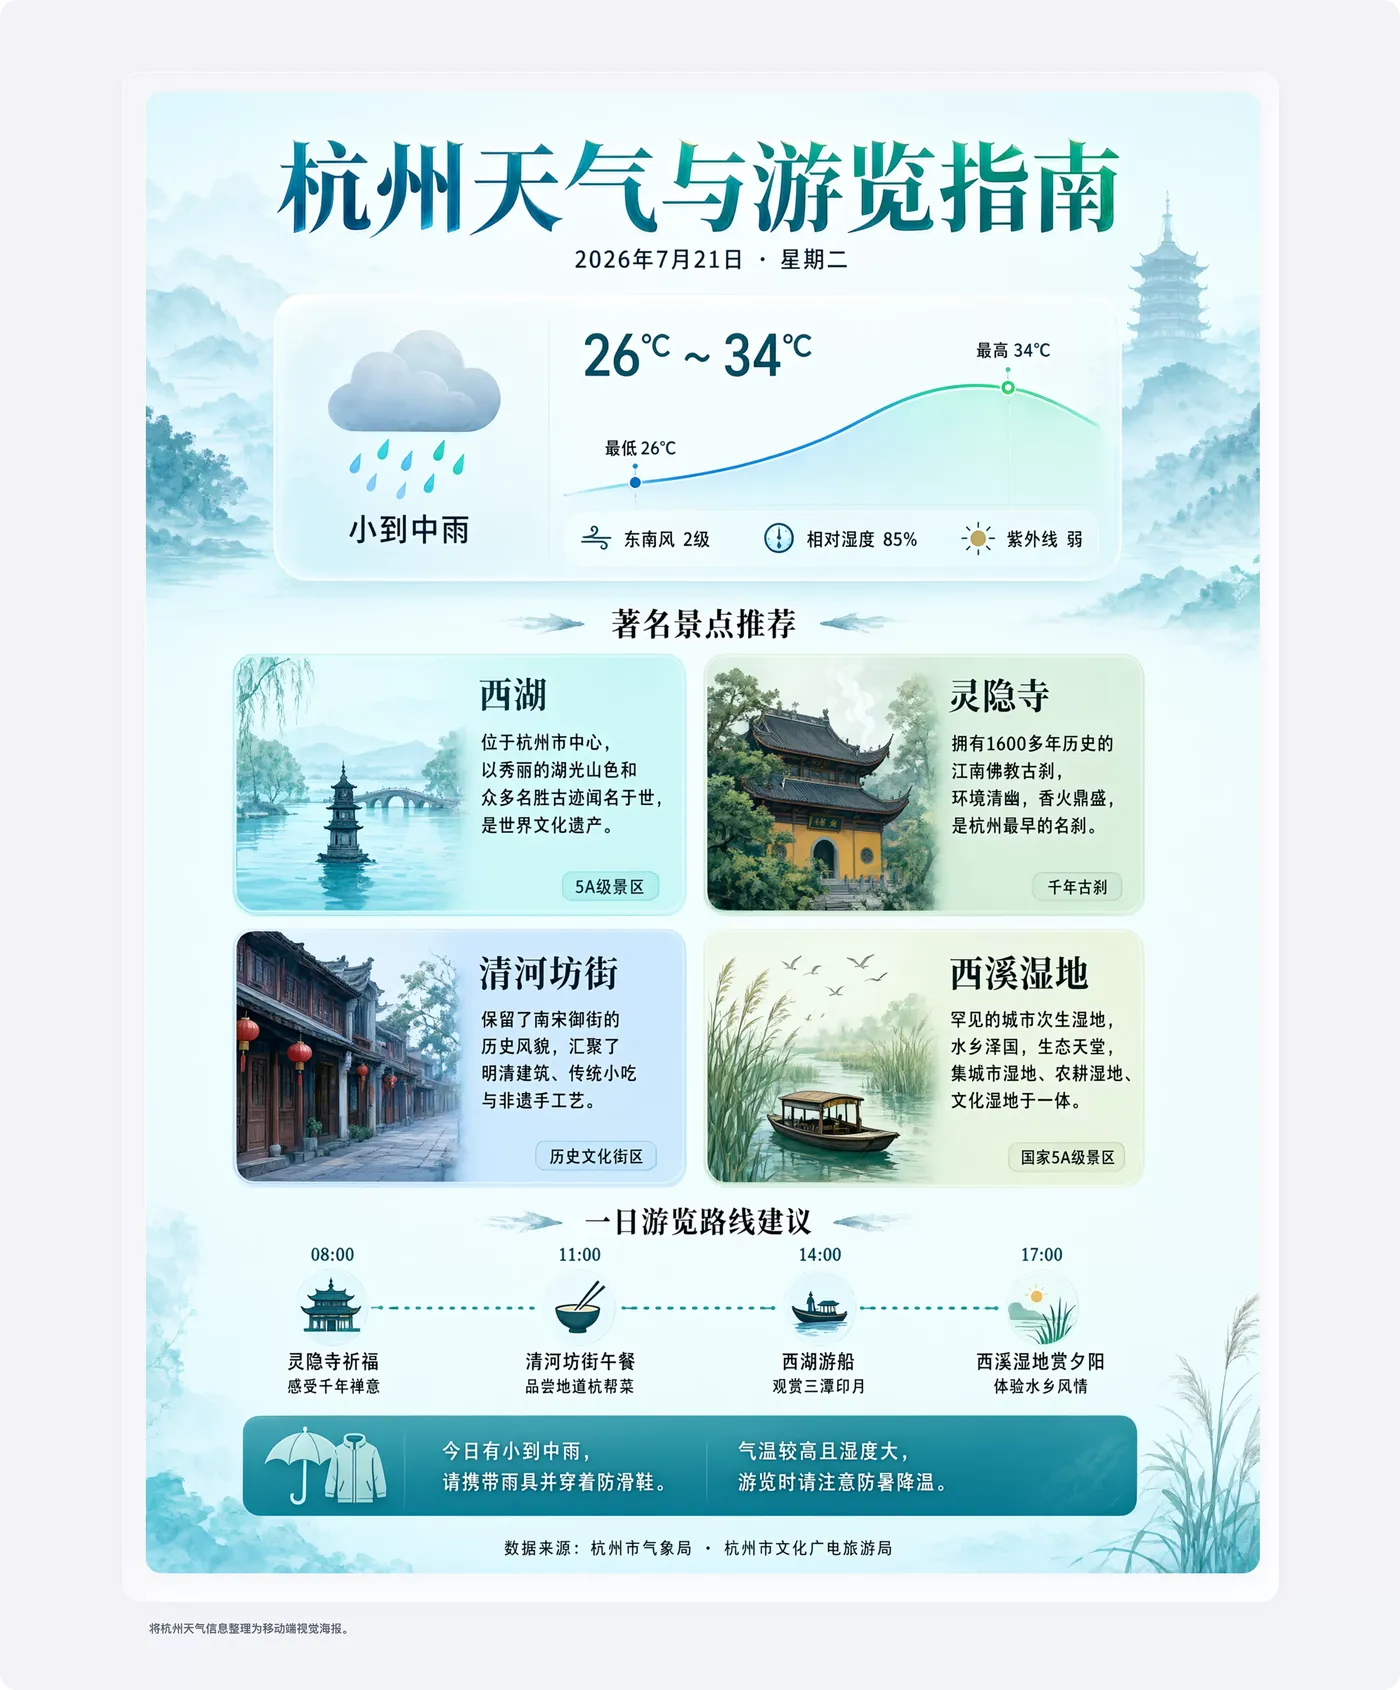
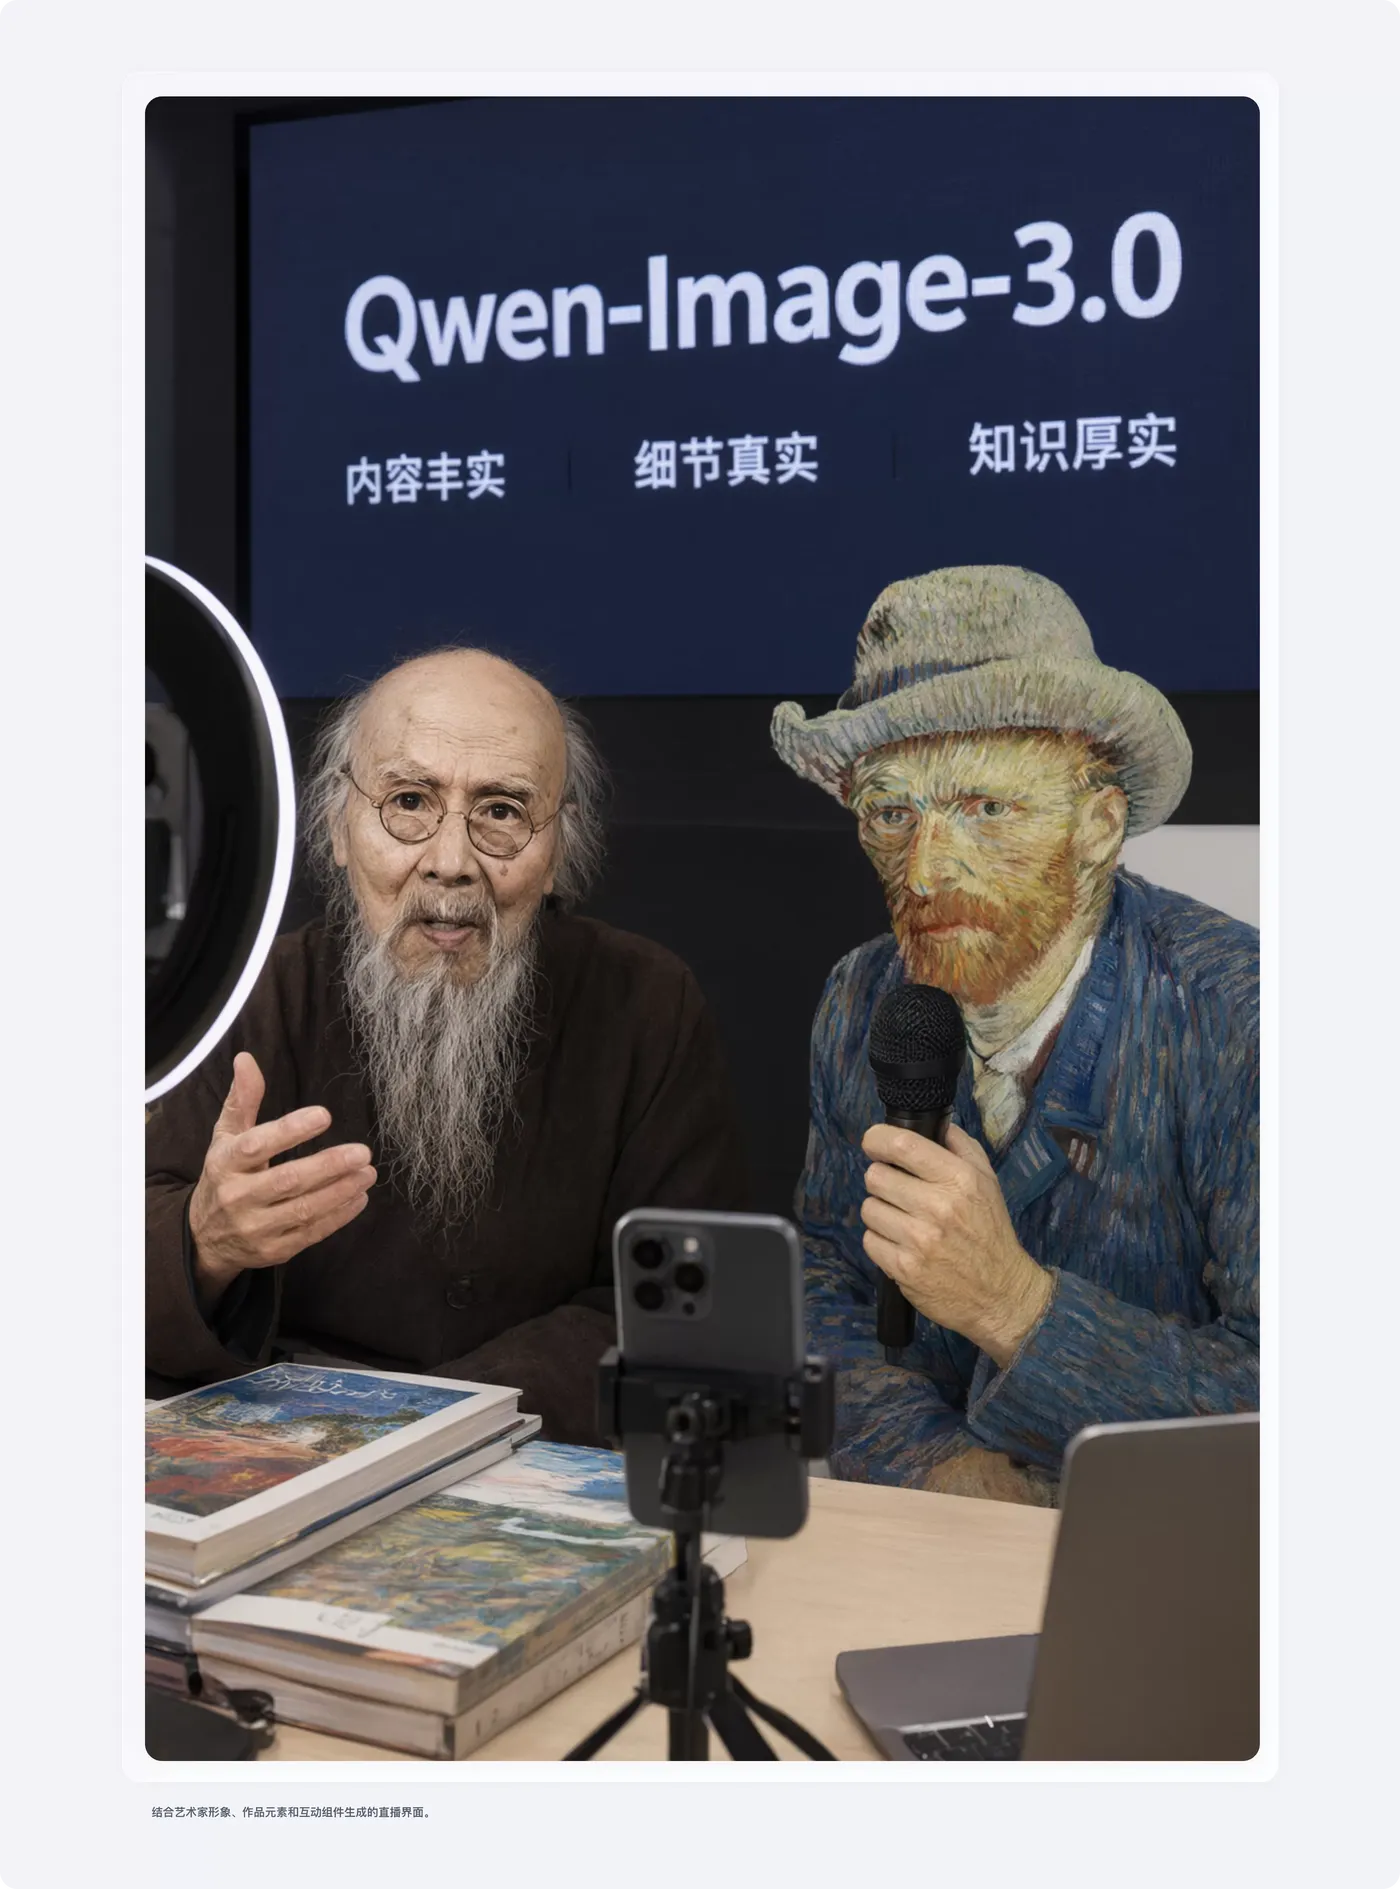
联网信息与主题化生成
在接入联网信息后,模型可将天气等实时数据组织为完整视觉页面;也可结合艺术家、作品风格和直播界面知识,生成具有明确主题、人物关系和平台元素的内容。
延伸阅读:查看多语言、知识与界面生成的完整案例
四、开发接入
1. 通过 DashScope API 调用
Qwen-Image-3.0-Pro 使用 DashScope 多模态生成接口。调用时需传入模型标识 qwen-image-3.0-pro,并在请求头中配置 API Key。以下为精简的文生图示例:
01curl --location 'https://dashscope.aliyuncs.com/api/v1/services/aigc/multimodal-generation/generation' \\

02  --header 'Content-Type: application/json' \\

03  --header "Authorization: Bearer $DASHSCOPE\_API\_KEY" \\

04  --data '{


05    "model": "qwen-image-3.0-pro",

06    "input": {


07      "messages": \[

08        {


09          "role": "user",

10          "content": \[

11            {


12              "text": "生成一张竖版城市报刊亭人像摄影:午后逆光,一名年轻女性手捧橙粉色玫瑰,背景招牌写有 Il Messaggero,呈现自然发丝、花瓣和胶片颗粒质感。"

13            }

14          \]

15        }

16      \]

17    },

18    "parameters": {


19      "prompt\_extend": true

20    }

21  }'
完整的 API Key 获取方式、请求示例与响应结构可查看 模型 API Reference。
2. 文生图与图像编辑
- 文生图:在
content中传入文本描述,适合海报、信息图、UI、摄影和分镜等从零生成任务。 - 图像编辑:在同一条用户消息中传入 1–3 张参考图及编辑指令,可完成局部修改、内容增删、风格调整、批注和多图融合。
- 复杂指令:长指令可描述版面分区、文字内容、元素位置、材质、光线和镜头关系;
prompt_extend默认开启,可使用direct模式,文生图还支持更精细的agent模式。
3. 关键调用说明
- 输出尺寸的总像素范围为 512 × 512 至 2,048 × 2,048;未传入尺寸时,可由模型根据内容推荐。
- 单次请求最多生成 6 张图像,输出格式为 PNG。
- 参考图支持公网 URL 或 Base64 输入,格式包括 JPG、JPEG、PNG、BMP、TIFF、WEBP 和 GIF,单张不超过 10 MB。
- 可通过反向提示词、随机种子和水印参数进一步控制生成结果。
- 对可读文字、固定版面或参考图编辑要求较高时,建议在提示词中明确文字内容、区域位置、层级关系和需要保留的元素。
- 更完整的请求参数、图像输入方式和响应结构可查看 图像生成与编辑 API 文档。
五、立即体验
Qwen-Image-3.0-Pro:模型详情 | 立即体验 | API Reference
Qwen-Image-3.0-Pro 现已在千问AI平台开放在线体验与 API 调用,欢迎使用。
